
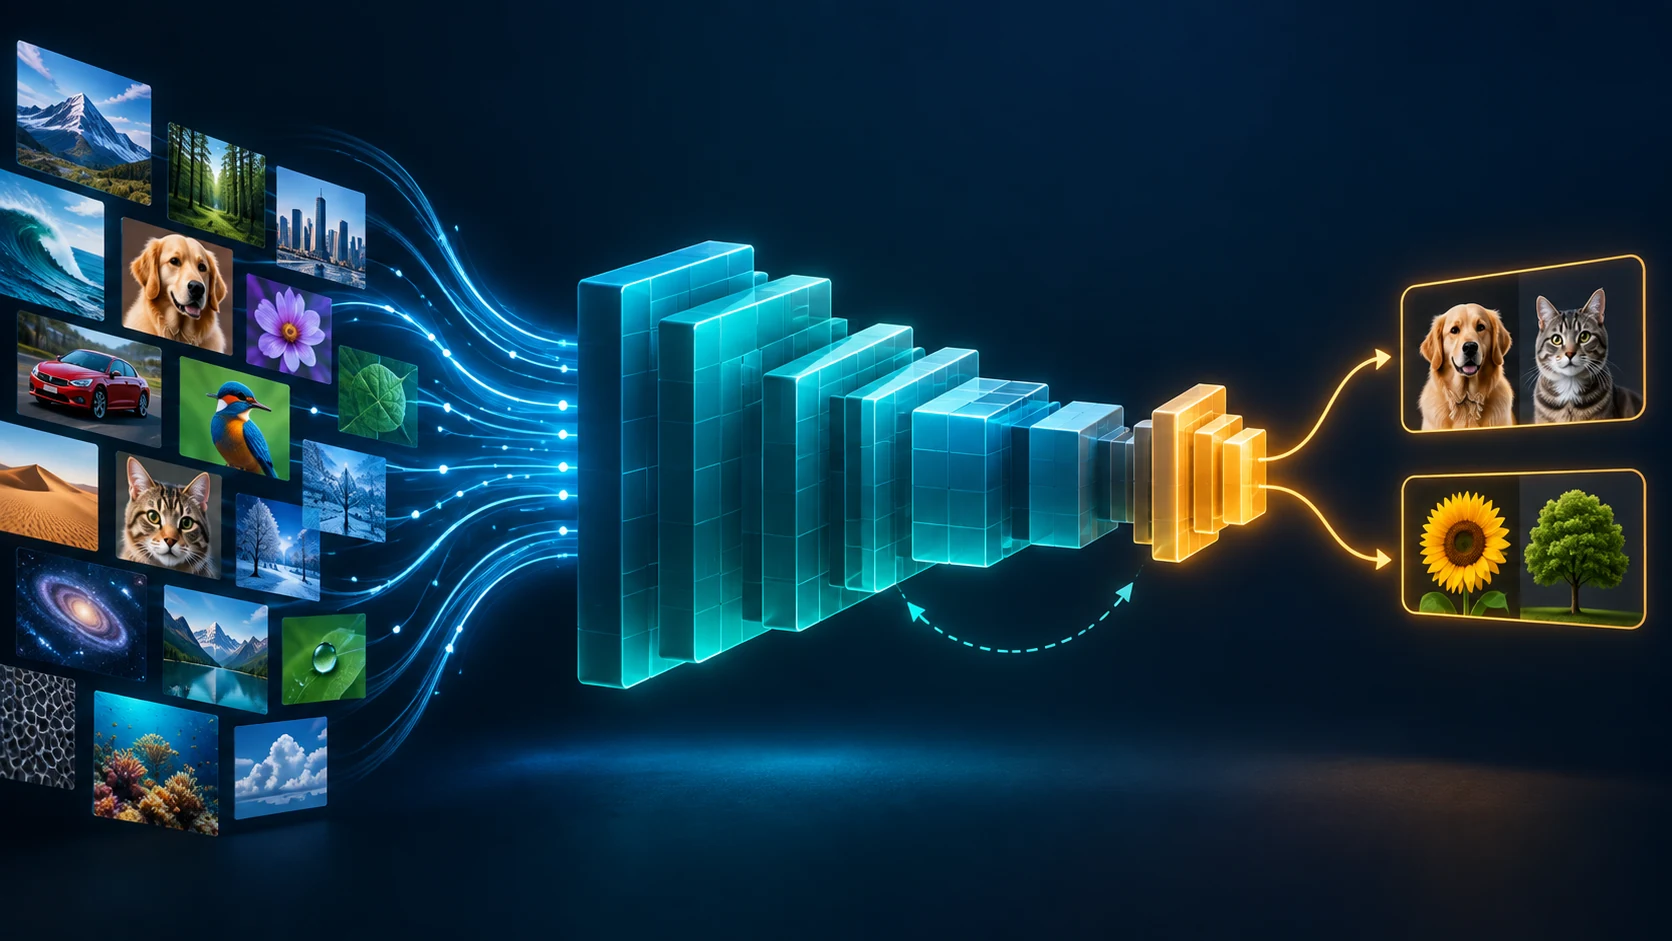
O aprendizado por transferência começa com um modelo treinado em uma tarefa ou conjunto de dados e o adapta a outra tarefa. Em vez de aprender cada característica a partir de pesos aleatórios, a equipe pode reutilizar uma representação pré-treinada. Isso pode ajudar quando há poucos exemplos rotulados, mas o benefício depende da relação entre as tarefas de origem e destino. Não existe uma redução fixa na quantidade de dados que sirva para todos os projetos.
Duas abordagens comuns. Na extração de características, a base pré-treinada fica congelada e apenas uma nova camada de saída é treinada com dados da tarefa de destino. No ajuste fino, primeiro se estabelece uma camada de saída funcional e depois algumas camadas pré-treinadas também são atualizadas. O tutorial de imagens do TensorFlow demonstra essa ordem e alerta que atualizar toda a base imediatamente com uma camada nova e aleatória pode danificar características úteis. O PyTorch também compara os dois métodos em um pequeno conjunto de imagens. Modelos de linguagem partem da mesma ideia de pesos pré-treinados, mas têm estrutura e detalhes de treinamento diferentes.
Como medir o benefício. Defina a tarefa e um conjunto de teste separado antes de escolher o modelo. Com a mesma divisão dos dados, compare uma referência simples, a extração com a base congelada e um ajuste fino cuidadoso. Registre qualidade, custo de treinamento e inferência e tipos de erro. Se os dados de destino forem muito diferentes dos dados de pré-treinamento, verifique se as características transferidas ajudam ou prejudicam. Um resultado de tutorial não garante desempenho em imagens médicas, câmeras industriais ou documentos jurídicos.
Quando pode falhar. Transferência negativa é a queda de desempenho na tarefa de destino causada pelo conhecimento de origem. Mudanças de domínio, rótulos incompatíveis, pré-processamento inadequado, sobreajuste em poucos dados ou ajuste fino agressivo podem contribuir. Mantenha um conjunto de validação e não conclua sucesso apenas pela precisão de treinamento.
Quanto dado rotulado pode economizar? Não há um fator universal de dez ou cem. A necessidade depende do modelo de origem, da semelhança das tarefas, da qualidade exigida e do método de avaliação. Meça uma curva de aprendizado nos seus dados de destino.
Fontes: tutorial TensorFlow, tutorial PyTorch, guia Hugging Face, pesquisa sobre transferência negativa.