
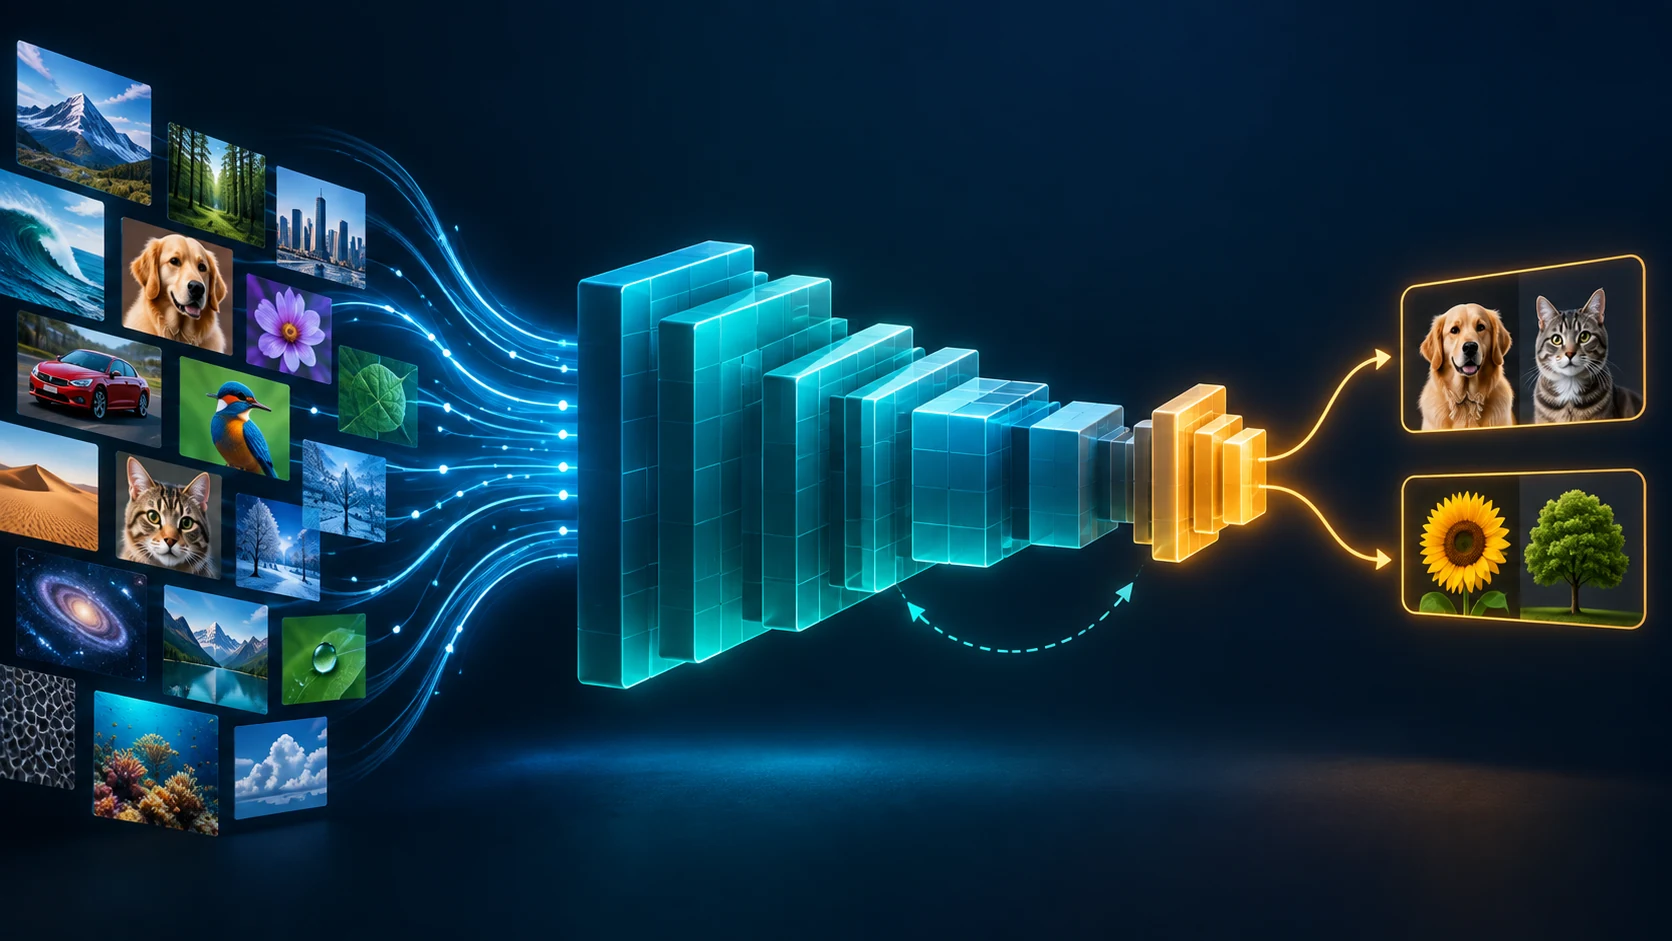
Il transfer learning parte da un modello già addestrato su un compito o un insieme di dati e lo adatta a un nuovo obiettivo. Si possono riutilizzare rappresentazioni apprese invece di imparare ogni caratteristica da pesi casuali. Questo può aiutare quando i dati etichettati sono pochi, ma il beneficio dipende dal rapporto tra il compito di origine e quello di destinazione. Non esiste una riduzione fissa dei dati valida per ogni progetto.
Due approcci comuni. Nell’estrazione di caratteristiche si congelano i livelli preaddestrati e si allena una nuova testa di uscita sui dati di destinazione. Nel fine-tuning si costruisce prima una testa funzionante e poi si aggiornano anche alcuni livelli preaddestrati. Il tutorial di TensorFlow per le immagini mostra questa sequenza e avverte che aggiornare subito l’intero modello insieme a una testa inizializzata a caso può danneggiare caratteristiche utili. Il tutorial PyTorch confronta i due metodi su un piccolo insieme di immagini. Anche i modelli linguistici partono da pesi preaddestrati, pur con struttura e addestramento diversi.
Una valutazione corretta. Definisci il compito e un insieme di test separato prima di scegliere il modello. Con la stessa suddivisione dei dati confronta una base semplice, le caratteristiche congelate e un fine-tuning accurato. Registra qualità, costo di addestramento e inferenza e tipi di errore. Se i dati di destinazione sono molto diversi da quelli di preaddestramento, controlla se le caratteristiche trasferite aiutano o peggiorano il risultato. Un esempio didattico non promette prestazioni su immagini mediche, telecamere industriali o documenti legali.
Quando può fallire. Il trasferimento negativo si verifica quando le conoscenze iniziali riducono le prestazioni sul nuovo compito. Differenze di dominio, etichette inadatte, preelaborazione non coerente, sovradattamento e fine-tuning troppo aggressivo sono possibili cause. Conserva dati di validazione e non giudicare il successo dalla sola accuratezza in addestramento.
Quanti dati etichettati si risparmiano? Non c’è un fattore universale di dieci o cento. Il fabbisogno dipende dal modello, dalla somiglianza dei compiti, dalla qualità richiesta e dalla valutazione. Una curva di apprendimento sui propri dati di destinazione è una prova migliore di un moltiplicatore generico.
Fonti: tutorial TensorFlow, tutorial PyTorch, guida Hugging Face, studio sul trasferimento negativo.