
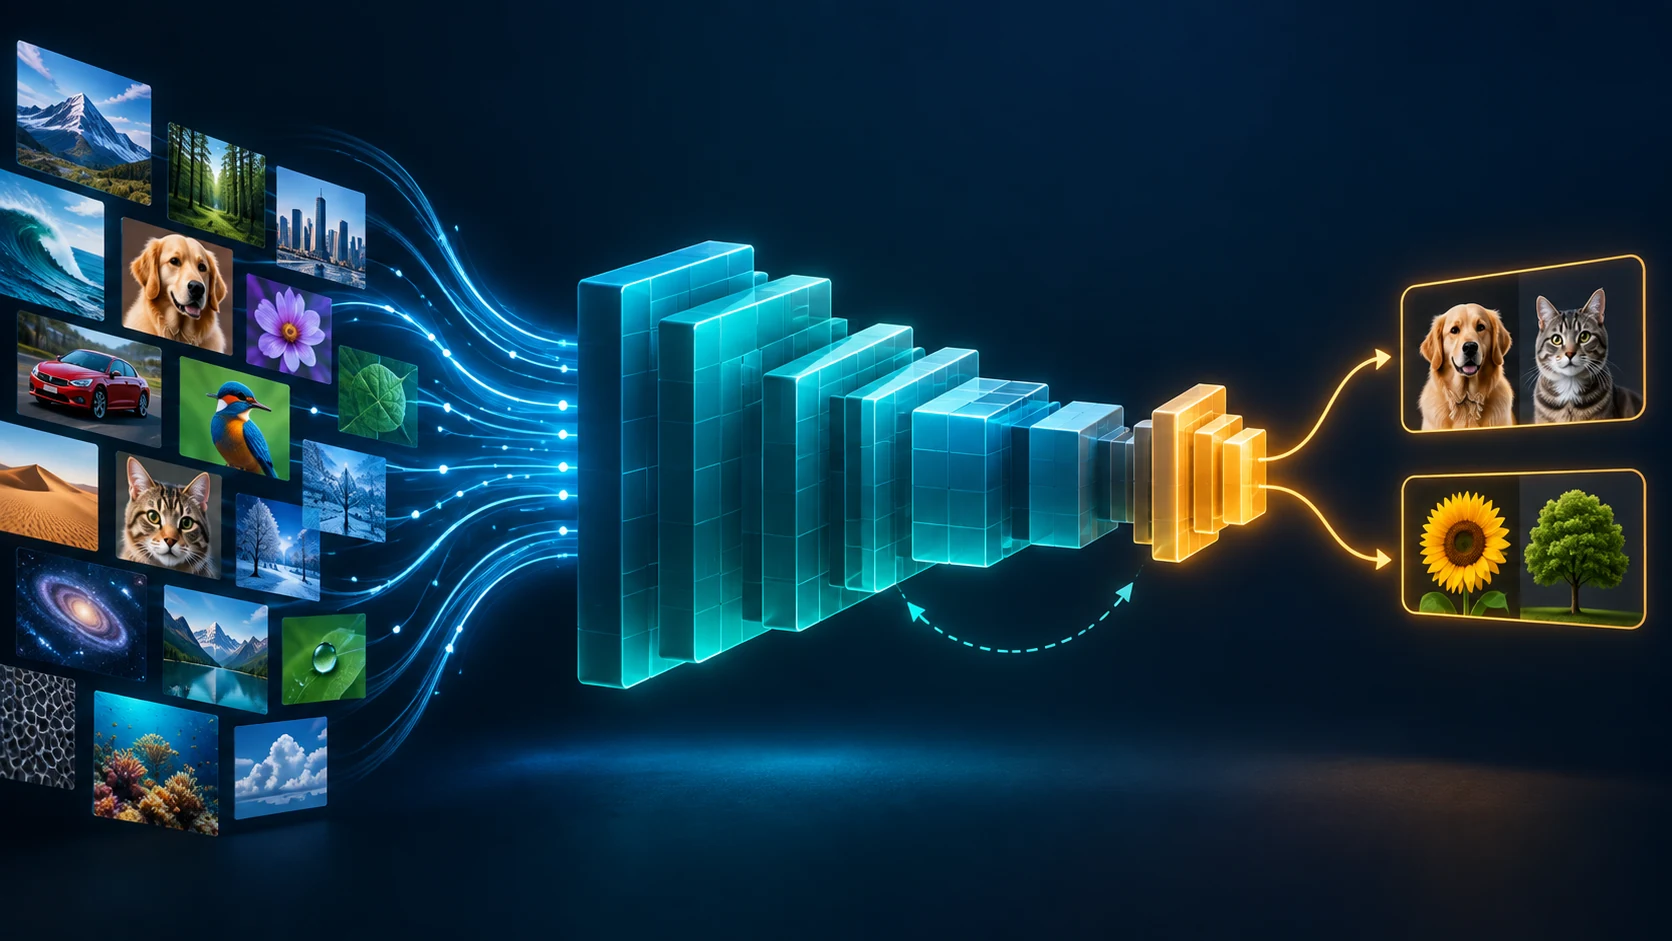
転移学習では、ある課題やデータで学習したモデルを別の課題に適応させます。最初からすべての特徴を学ぶ代わりに、学習済みの表現を再利用できます。ラベル付きデータが限られるときに役立つ場合がありますが、効果は元の課題と新しい課題の近さによって変わります。必要なデータが必ず何分の一になるという共通の倍率はありません。
二つの方法。 特徴抽出では事前学習したバックボーンを凍結し、新しい課題用の出力層だけを学習します。ファインチューニングでは、まず出力層を機能させ、その後で一部の事前学習層も更新します。TensorFlow の画像チュートリアルはこの順序を示し、無作為に初期化した出力層と全層を最初から一緒に大きく更新すると、有用な特徴を損なう可能性があると説明しています。PyTorch も小さな画像データで両方法を比較しています。言語モデルでも学習済みの重みを活用しますが、構造や訓練方法は異なります。
効果をどう確かめるか。 対象課題と独立したテストセットを決め、同じデータ分割で単純な基準モデル、凍結した特徴抽出、慎重な微調整を比較します。精度だけでなく、訓練と推論のコスト、失敗例も記録します。元データと対象データが大きく違う場合、移した特徴が助けになるか害になるかを検証してください。教材用データセットの結果を医療画像や工場の映像、法律文書の成果保証にはできません。
負の転移。 元の知識によって対象課題の性能が下がることがあります。領域やラベルのずれ、前処理の不一致、小さなデータでの過学習、強すぎる微調整が原因になり得ます。検証セットを残し、訓練時の精度だけで成功と判断しないでください。
ラベル付きデータはどれだけ減らせるか。 一律に10倍や100倍節約できるとは言えません。元モデル、課題の近さ、求める品質、評価方法によって変わります。対象データで学習曲線を作り、実測値から判断します。
出典:TensorFlow チュートリアル、PyTorch チュートリアル、Hugging Face ガイド、負の転移の研究。