
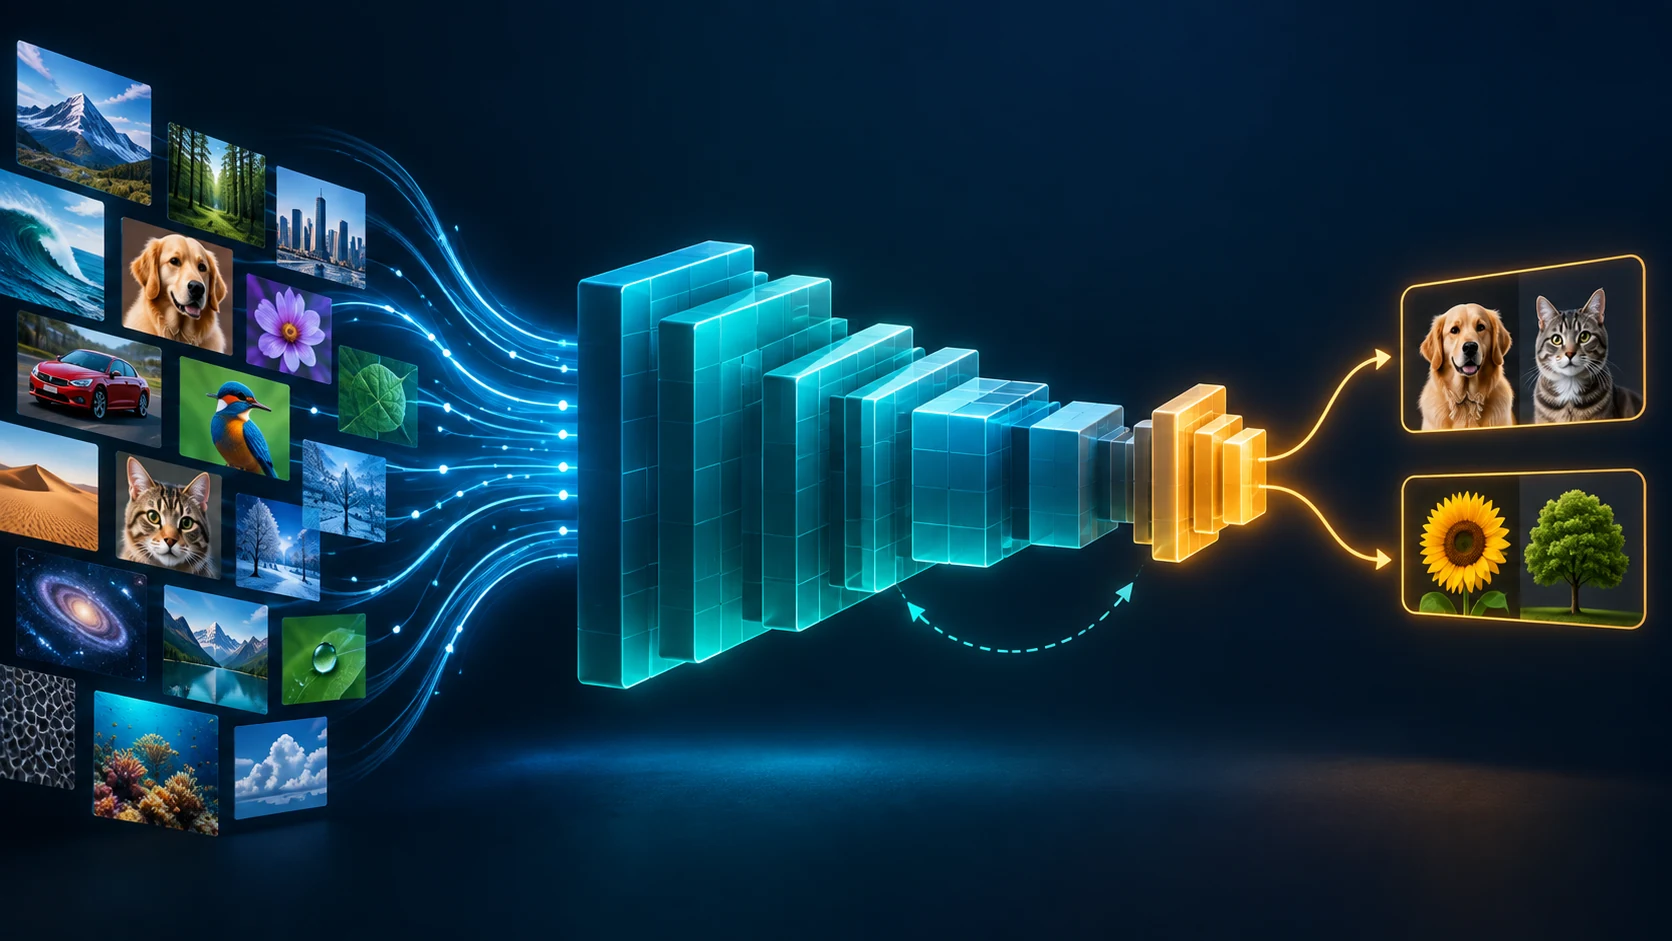
전이 학습은 한 과제나 데이터셋에서 학습한 모델을 다른 과제에 맞게 조정하는 방법입니다. 무작위 가중치에서 모든 특징을 다시 배우는 대신 사전 학습된 표현을 활용합니다. 레이블이 붙은 데이터가 적을 때 도움이 될 수 있지만, 원래 과제와 목표 과제의 관계에 따라 효과가 달라집니다. 모든 프로젝트에 적용되는 데이터 절감 배수는 없습니다.
두 가지 기본 방법. 특징 추출은 사전 학습된 백본을 고정하고 목표 과제를 위한 새 출력층만 학습합니다. 미세 조정은 작동하는 출력층을 먼저 만든 다음 일부 사전 학습된 층도 함께 업데이트합니다. TensorFlow 이미지 튜토리얼은 이 순서를 보여 주며, 무작위로 초기화한 출력층과 전체 백본을 처음부터 크게 업데이트하면 유용한 특징이 손상될 수 있다고 경고합니다. PyTorch도 작은 이미지 데이터셋에서 두 방법을 비교합니다. 언어 모델 역시 사전 학습 가중치에서 시작하지만 구조와 학습 세부 사항은 다릅니다.
효과를 검증하는 방법. 목표 과제와 별도의 테스트 세트를 먼저 정하고, 동일한 데이터 분할로 간단한 기준 모델, 고정 특징 추출, 신중한 미세 조정을 비교합니다. 품질뿐 아니라 학습 비용, 추론 비용, 오류 유형도 기록합니다. 목표 데이터가 사전 학습 데이터와 크게 다르면 옮겨 온 특징이 실제로 도움이 되는지 확인해야 합니다. 튜토리얼의 결과가 의료 영상, 공장 카메라, 법률 문서 작업의 성능을 보장하지는 않습니다.
부정적 전이의 위험. 원래 과제에서 얻은 지식이 목표 과제의 성능을 낮출 수도 있습니다. 도메인 차이, 맞지 않는 레이블 체계, 전처리 불일치, 작은 목표 데이터의 과적합이나 과도한 미세 조정이 원인이 될 수 있습니다. 검증 세트를 유지하고 훈련 정확도만으로 성공을 판단하지 마세요.
레이블 데이터를 얼마나 줄일 수 있나요? 모두에게 적용되는 10배 또는 100배라는 수치는 없습니다. 원본 모델, 과제의 유사성, 목표 품질, 평가 방법에 따라 달라집니다. 실제 목표 데이터로 학습 곡선을 측정해 판단하세요.
출처: TensorFlow 튜토리얼, PyTorch 튜토리얼, Hugging Face 가이드, 부정적 전이 연구.