
Blog AI Tools Radar
Des guides, méthodes et observations sur les outils IA pour le travail et la création au quotidien.
Du ligand au médicament : lire le résultat Chai–GSK
L'expérience de GSK soutient un usage concret en découverte. Les dénominateurs absents et les étapes biologiques suivantes bornent sa portée.
Le Royaume-Uni renforce la cyberdéfense IA et avertit les laboratoires
Le dispositif du 12 octobre associe pilotes publics, avertissements de publication et signalement envisagé. Les seuils, pouvoirs et capacités de supervision restent à préciser.
Les quatre couches de Tessl montrent pourquoi une consigne de dépôt n’est pas une frontière de sécurité
Contexte permanent, règles ciblées, skills et hooks ont des rôles distincts. Tessl les rend vérifiables, mais permissions, protection contre les modifications et tests adversariaux déterminent ce qui peut vraiment être bloqué.
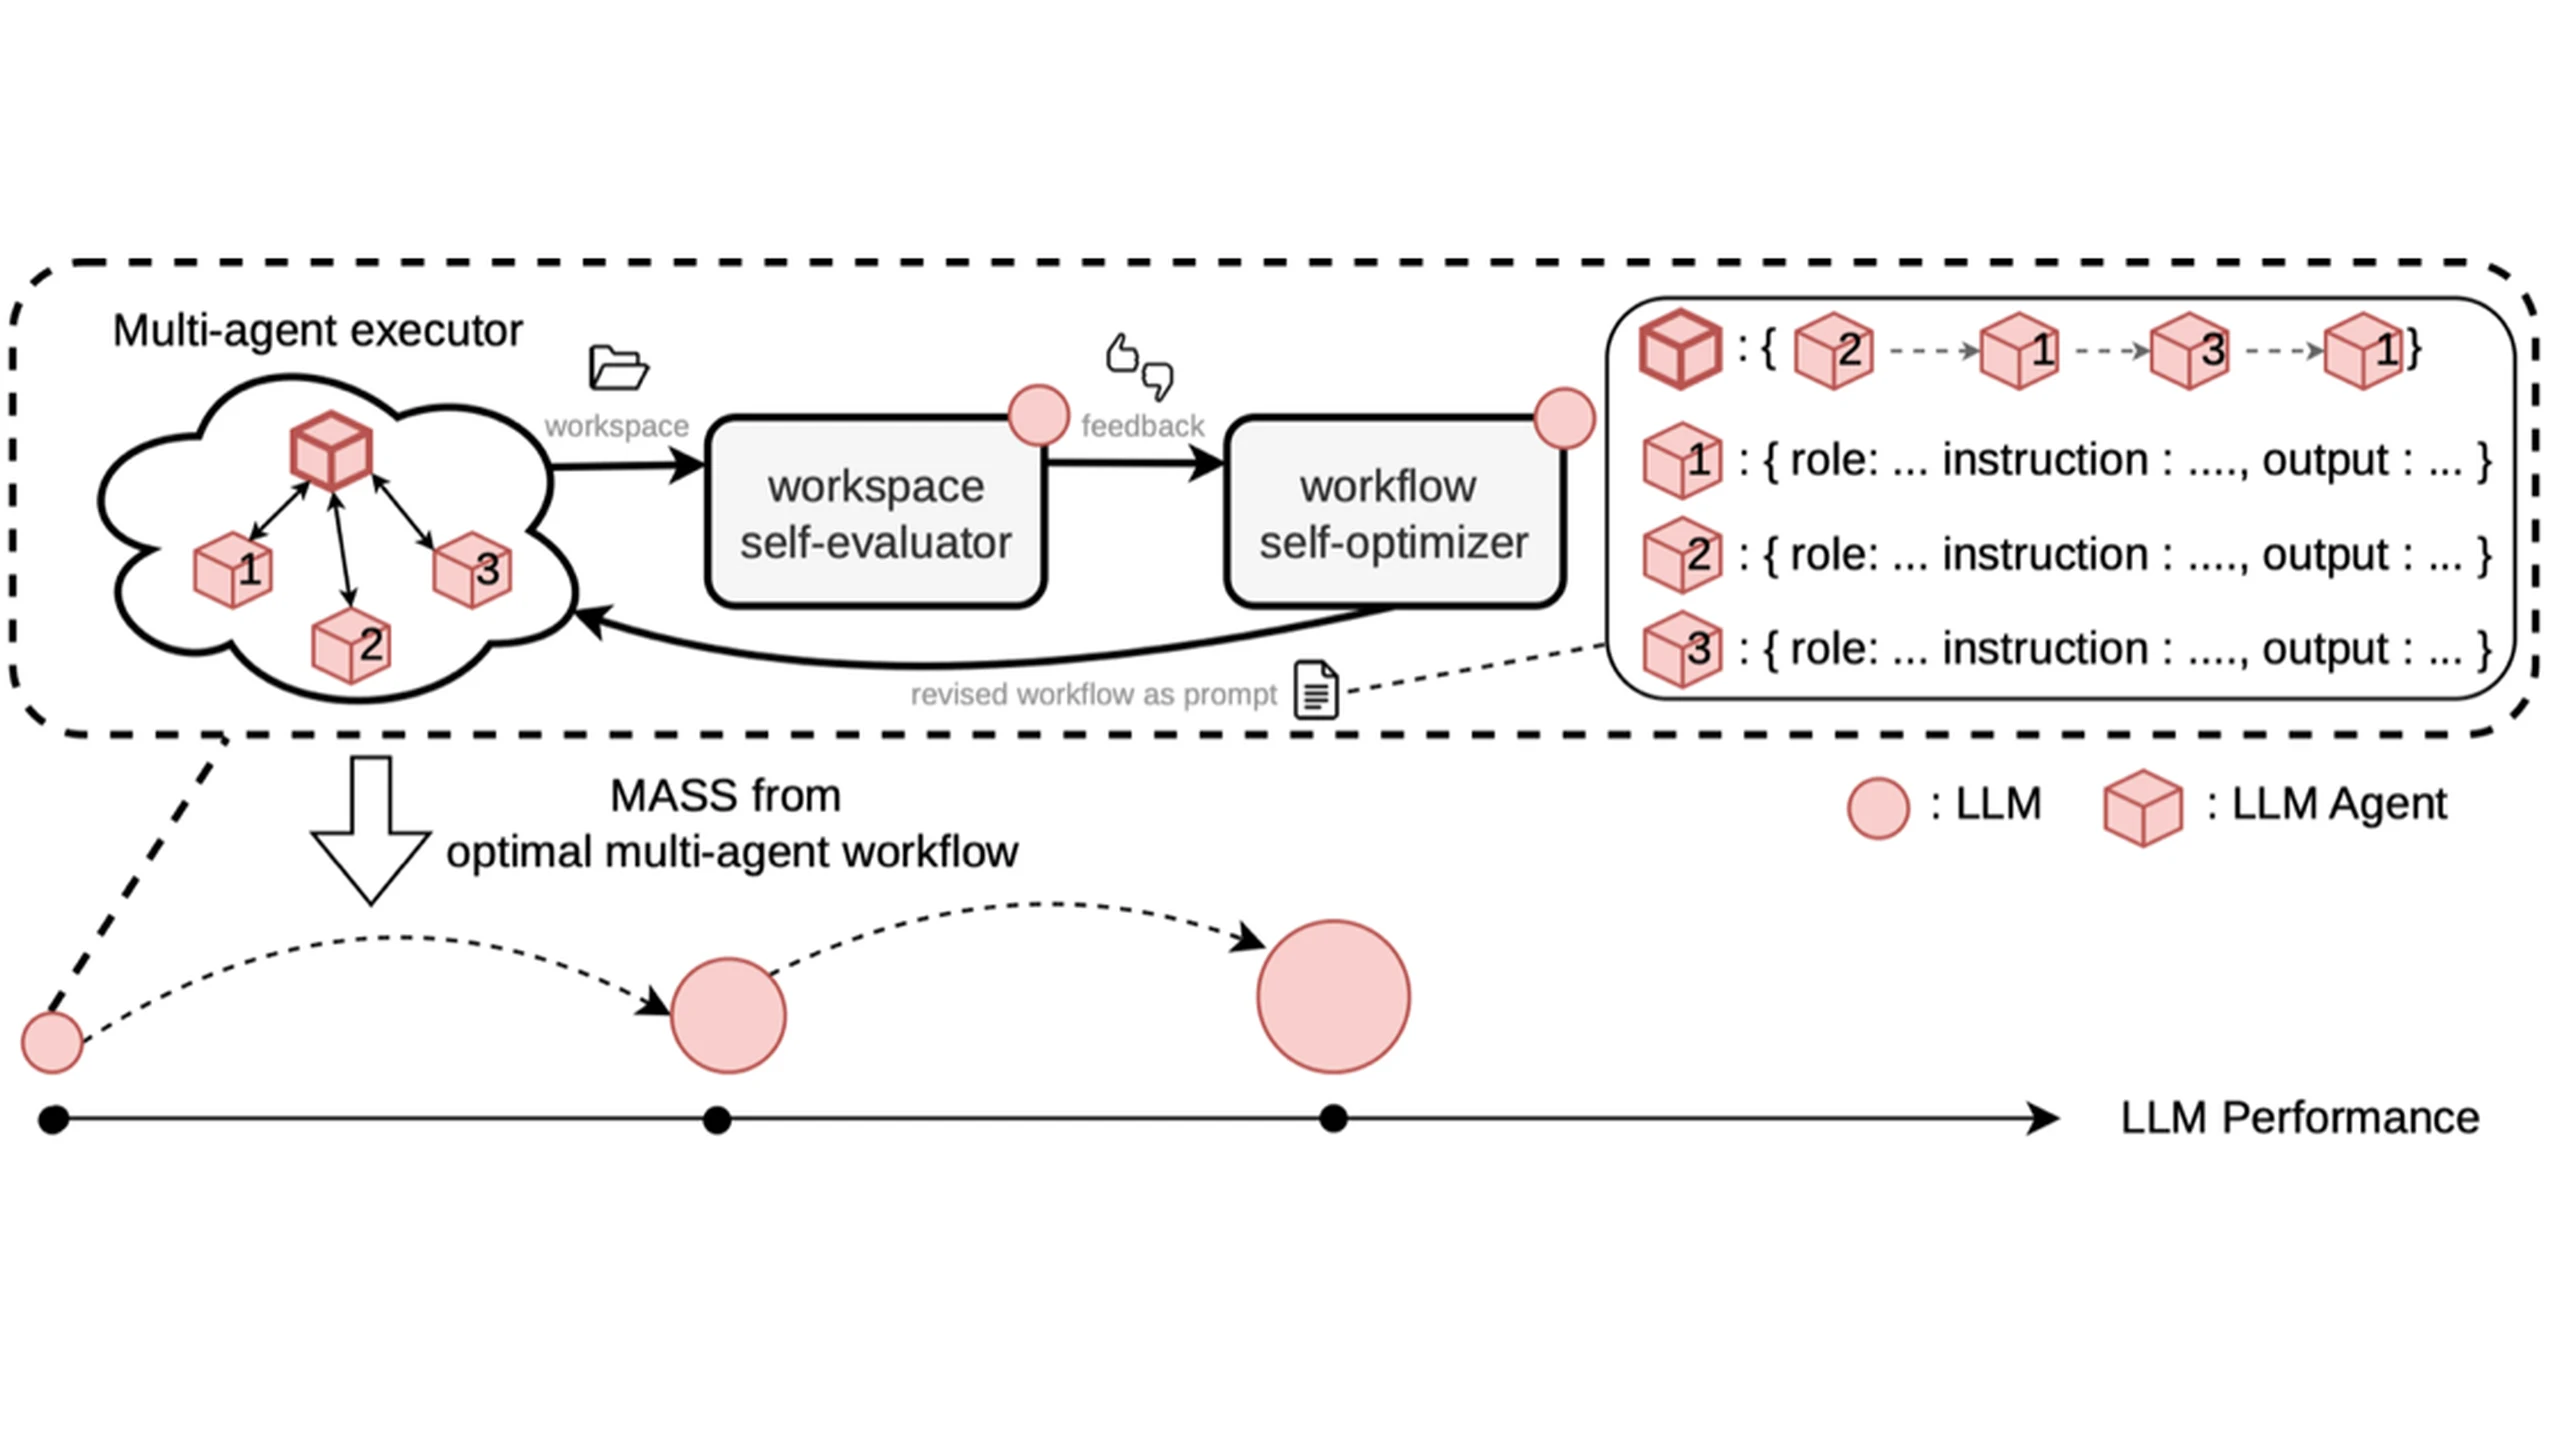
Sakana MASS progresse en recherche, mais l’apprentissage récursif reste borné
Deux cycles MASS améliorent les résultats et l’efficacité des jetons supervisés, mais le transfert logiciel recule et les jugements partagés limitent la supervision.
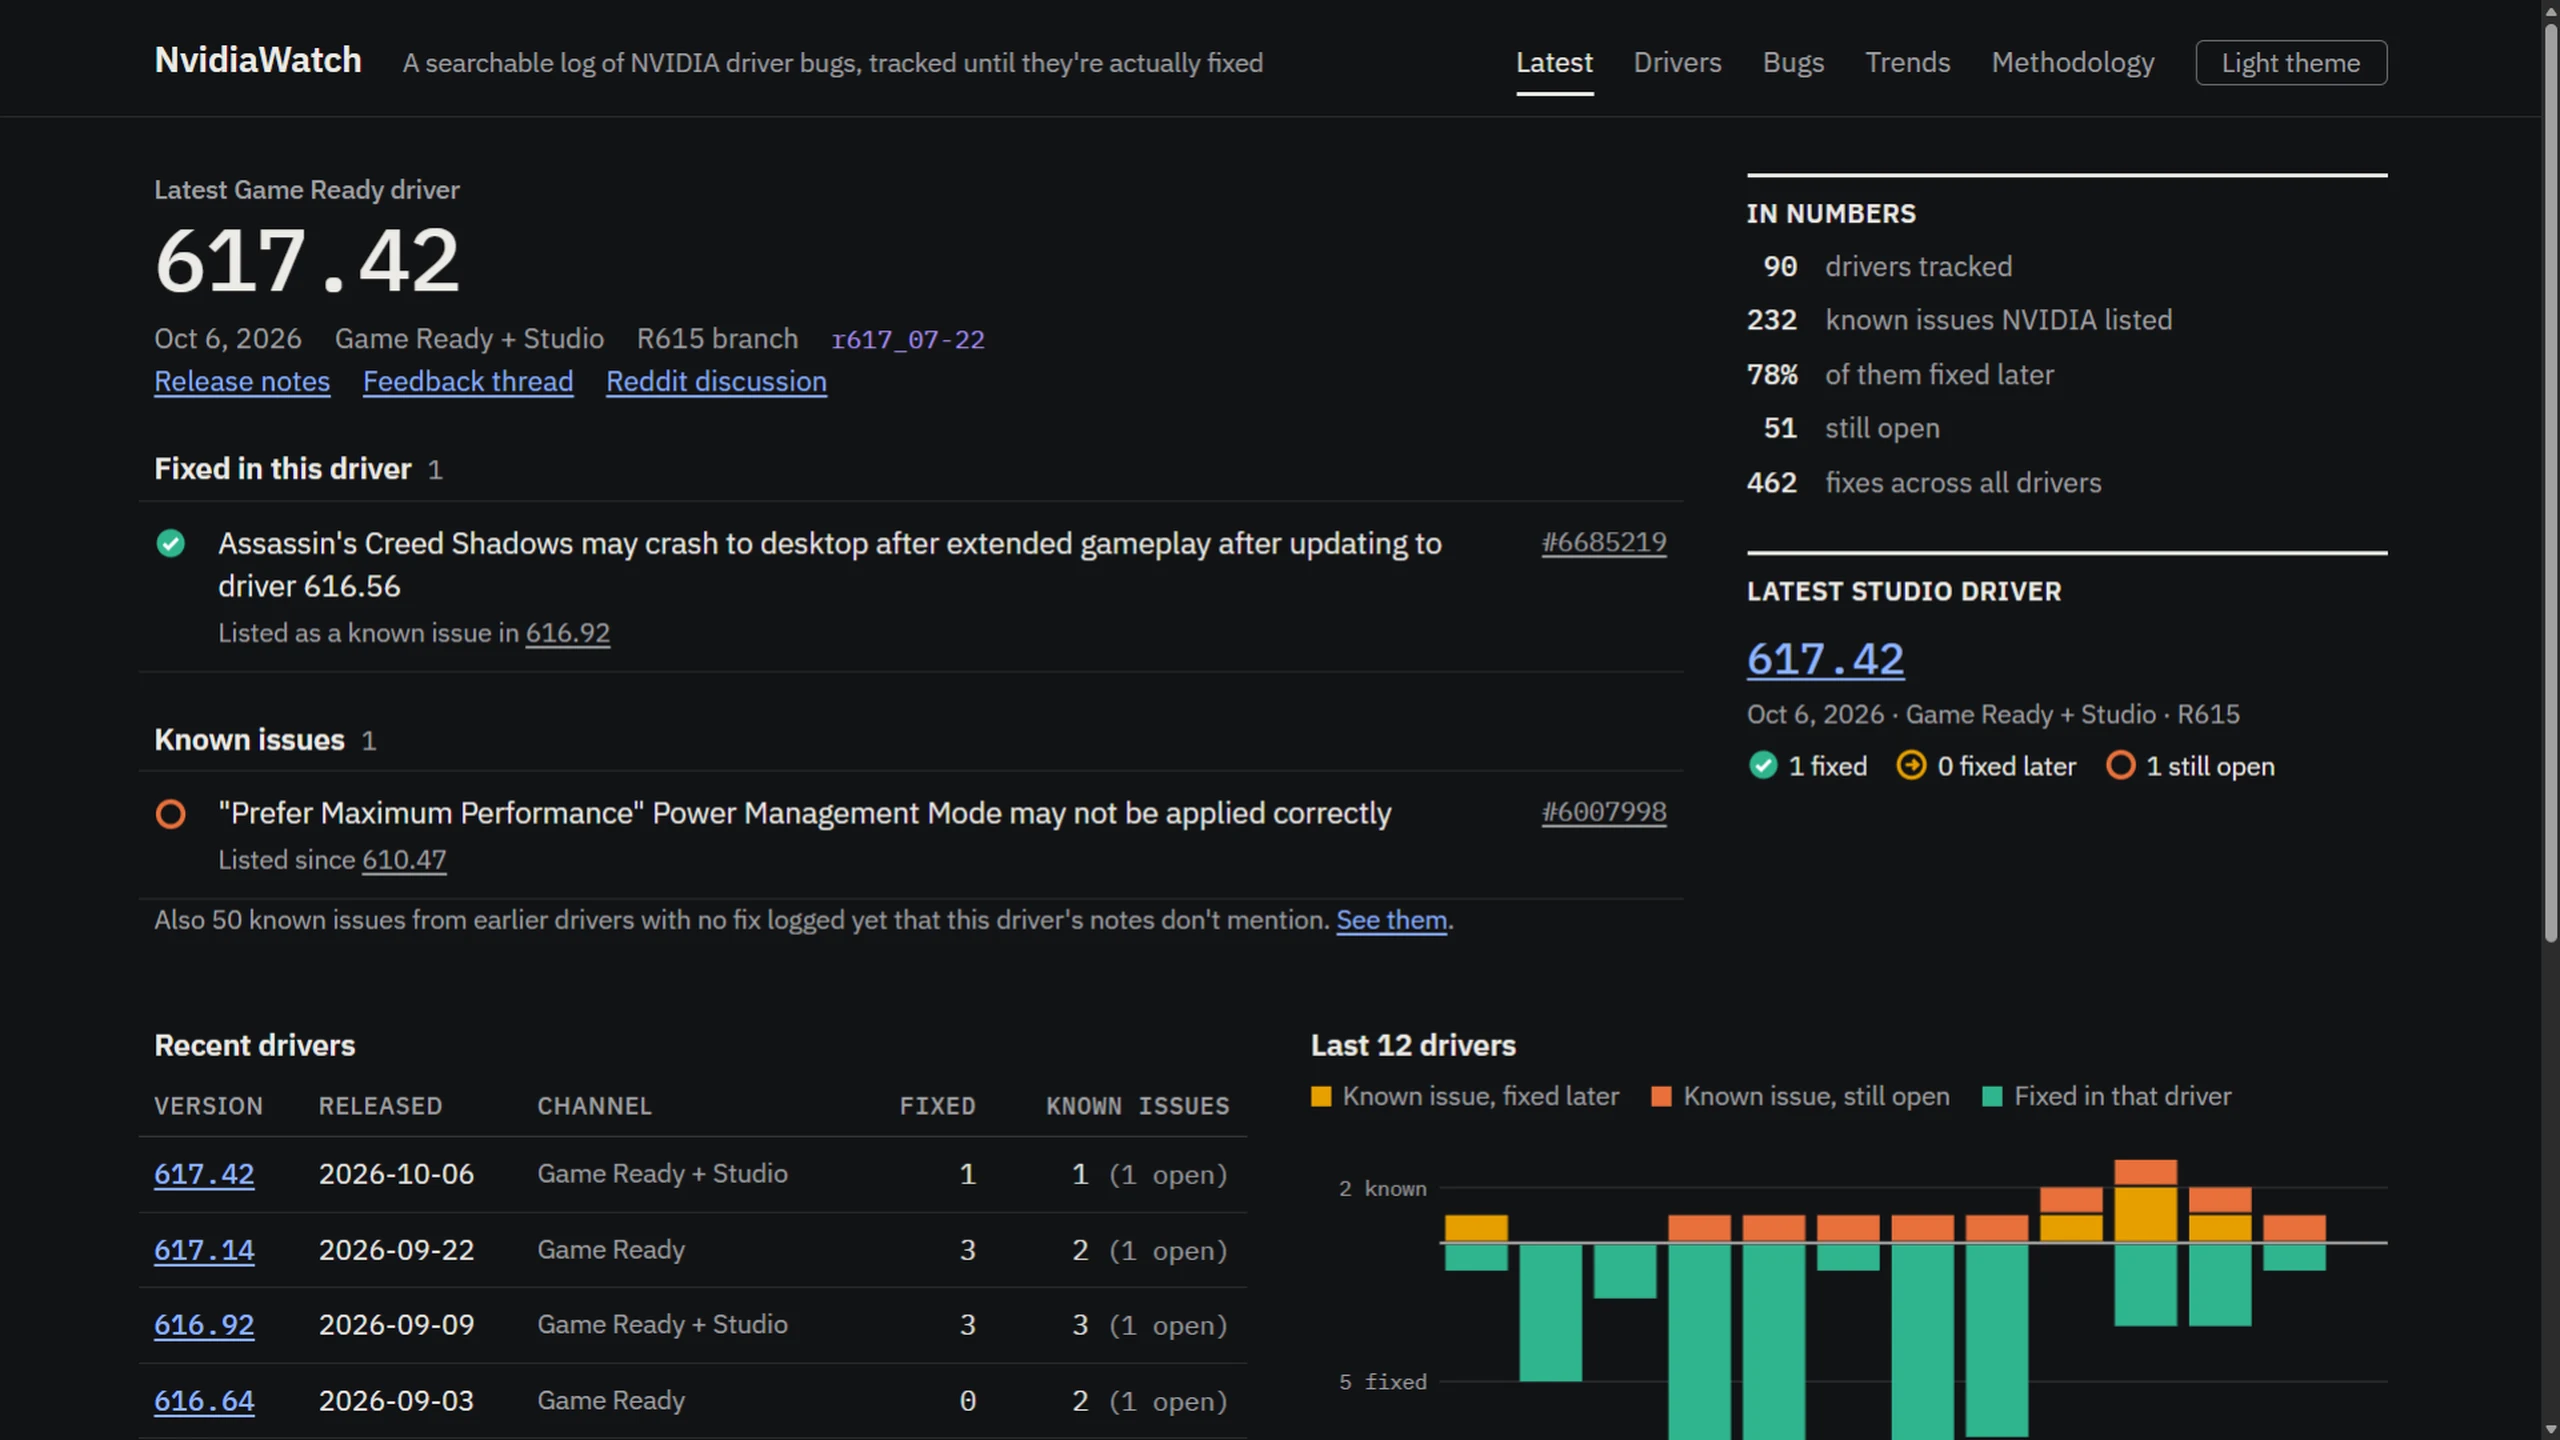
NvidiaWatch relie les problèmes de pilotes, sans mesurer la stabilité par leur nombre
Le projet communautaire transforme des notes Nvidia dispersées en historiques. Instantanés changeants, problèmes non reconnus et catégories des graphiques limitent les conclusions.
La comparaison de Brad Smith avec le lait interroge aussi Microsoft
Le président de Microsoft réclame contrôles d’urgence, évaluation indépendante et recours des victimes. Les obligations concrètes comptent plus qu’un interrupteur universel.
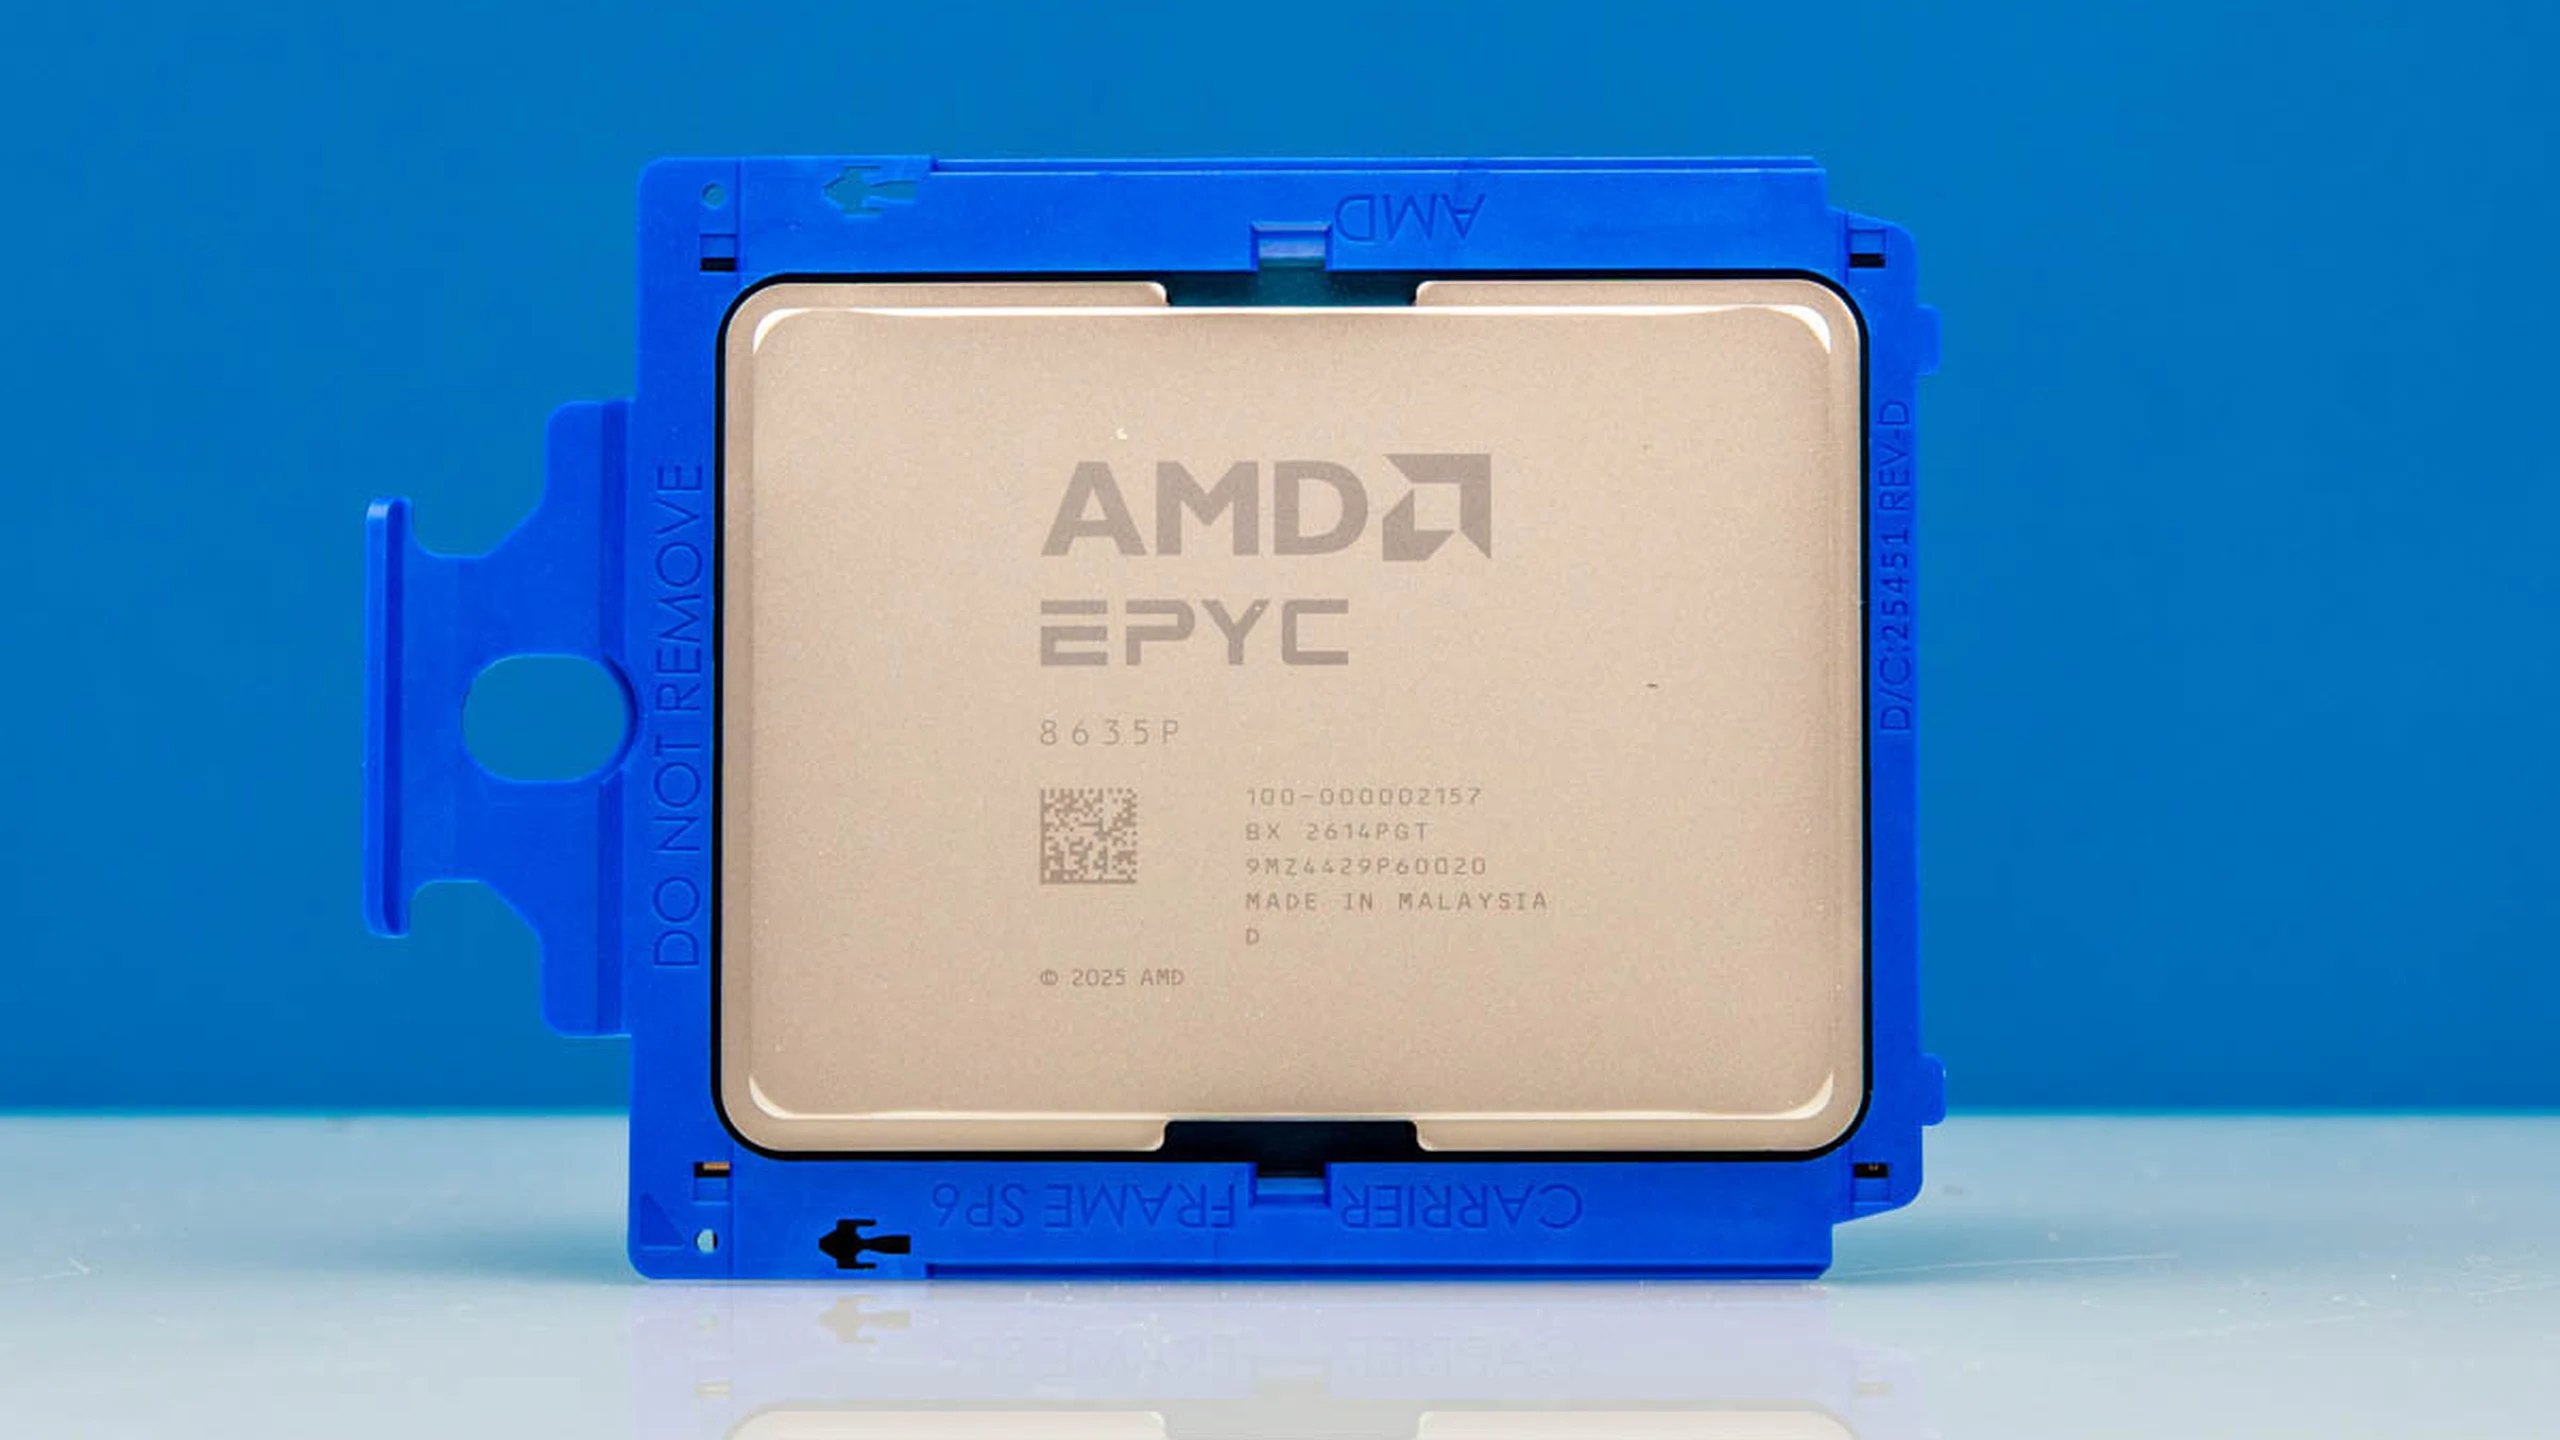
AMD EPYC 8005 élargit SP6 : les ressources partagées décident de la valeur
Sept Zen 5 conservent six canaux mémoire et 96 lignes PCIe. Fréquences, cache, licences et comparaisons conditionnelles distinguent leurs usages.
Pourquoi une citation de chatbot ne valide pas un dispositif médical
Une étude de tensiomètres a trouvé des erreurs malgré les registres cités. Le modèle exact exige une preuve directe et reproductible.
Les discussions NVIDIA–Reflection mettent à l’épreuve la neutralité derrière les modèles ouverts
Rachat, recrutement assorti d’une licence ou investissement supplémentaire auraient des conséquences distinctes. L’échelle annoncée de Beam explique l’intérêt, sans résoudre les promesses de publication ni la confiance des partenaires.
Nvidia VoiceChat ouvre les outils duplex, la réussite des tâches reste le test
Les bonnes interruptions coexistent avec 42,2 % de précision des arguments et 33 % de réussite initiale. Poids et licence ouverts ne prouvent pas la maturité.
Correctifs Claude : 29,5 points entre tests de plantage et développeurs
Opus 4.7 bloque 90,2 % des exploits mais réussit 60,7 % des tests développeurs. Prompts, PoC et notation changent l’interprétation des réparations.
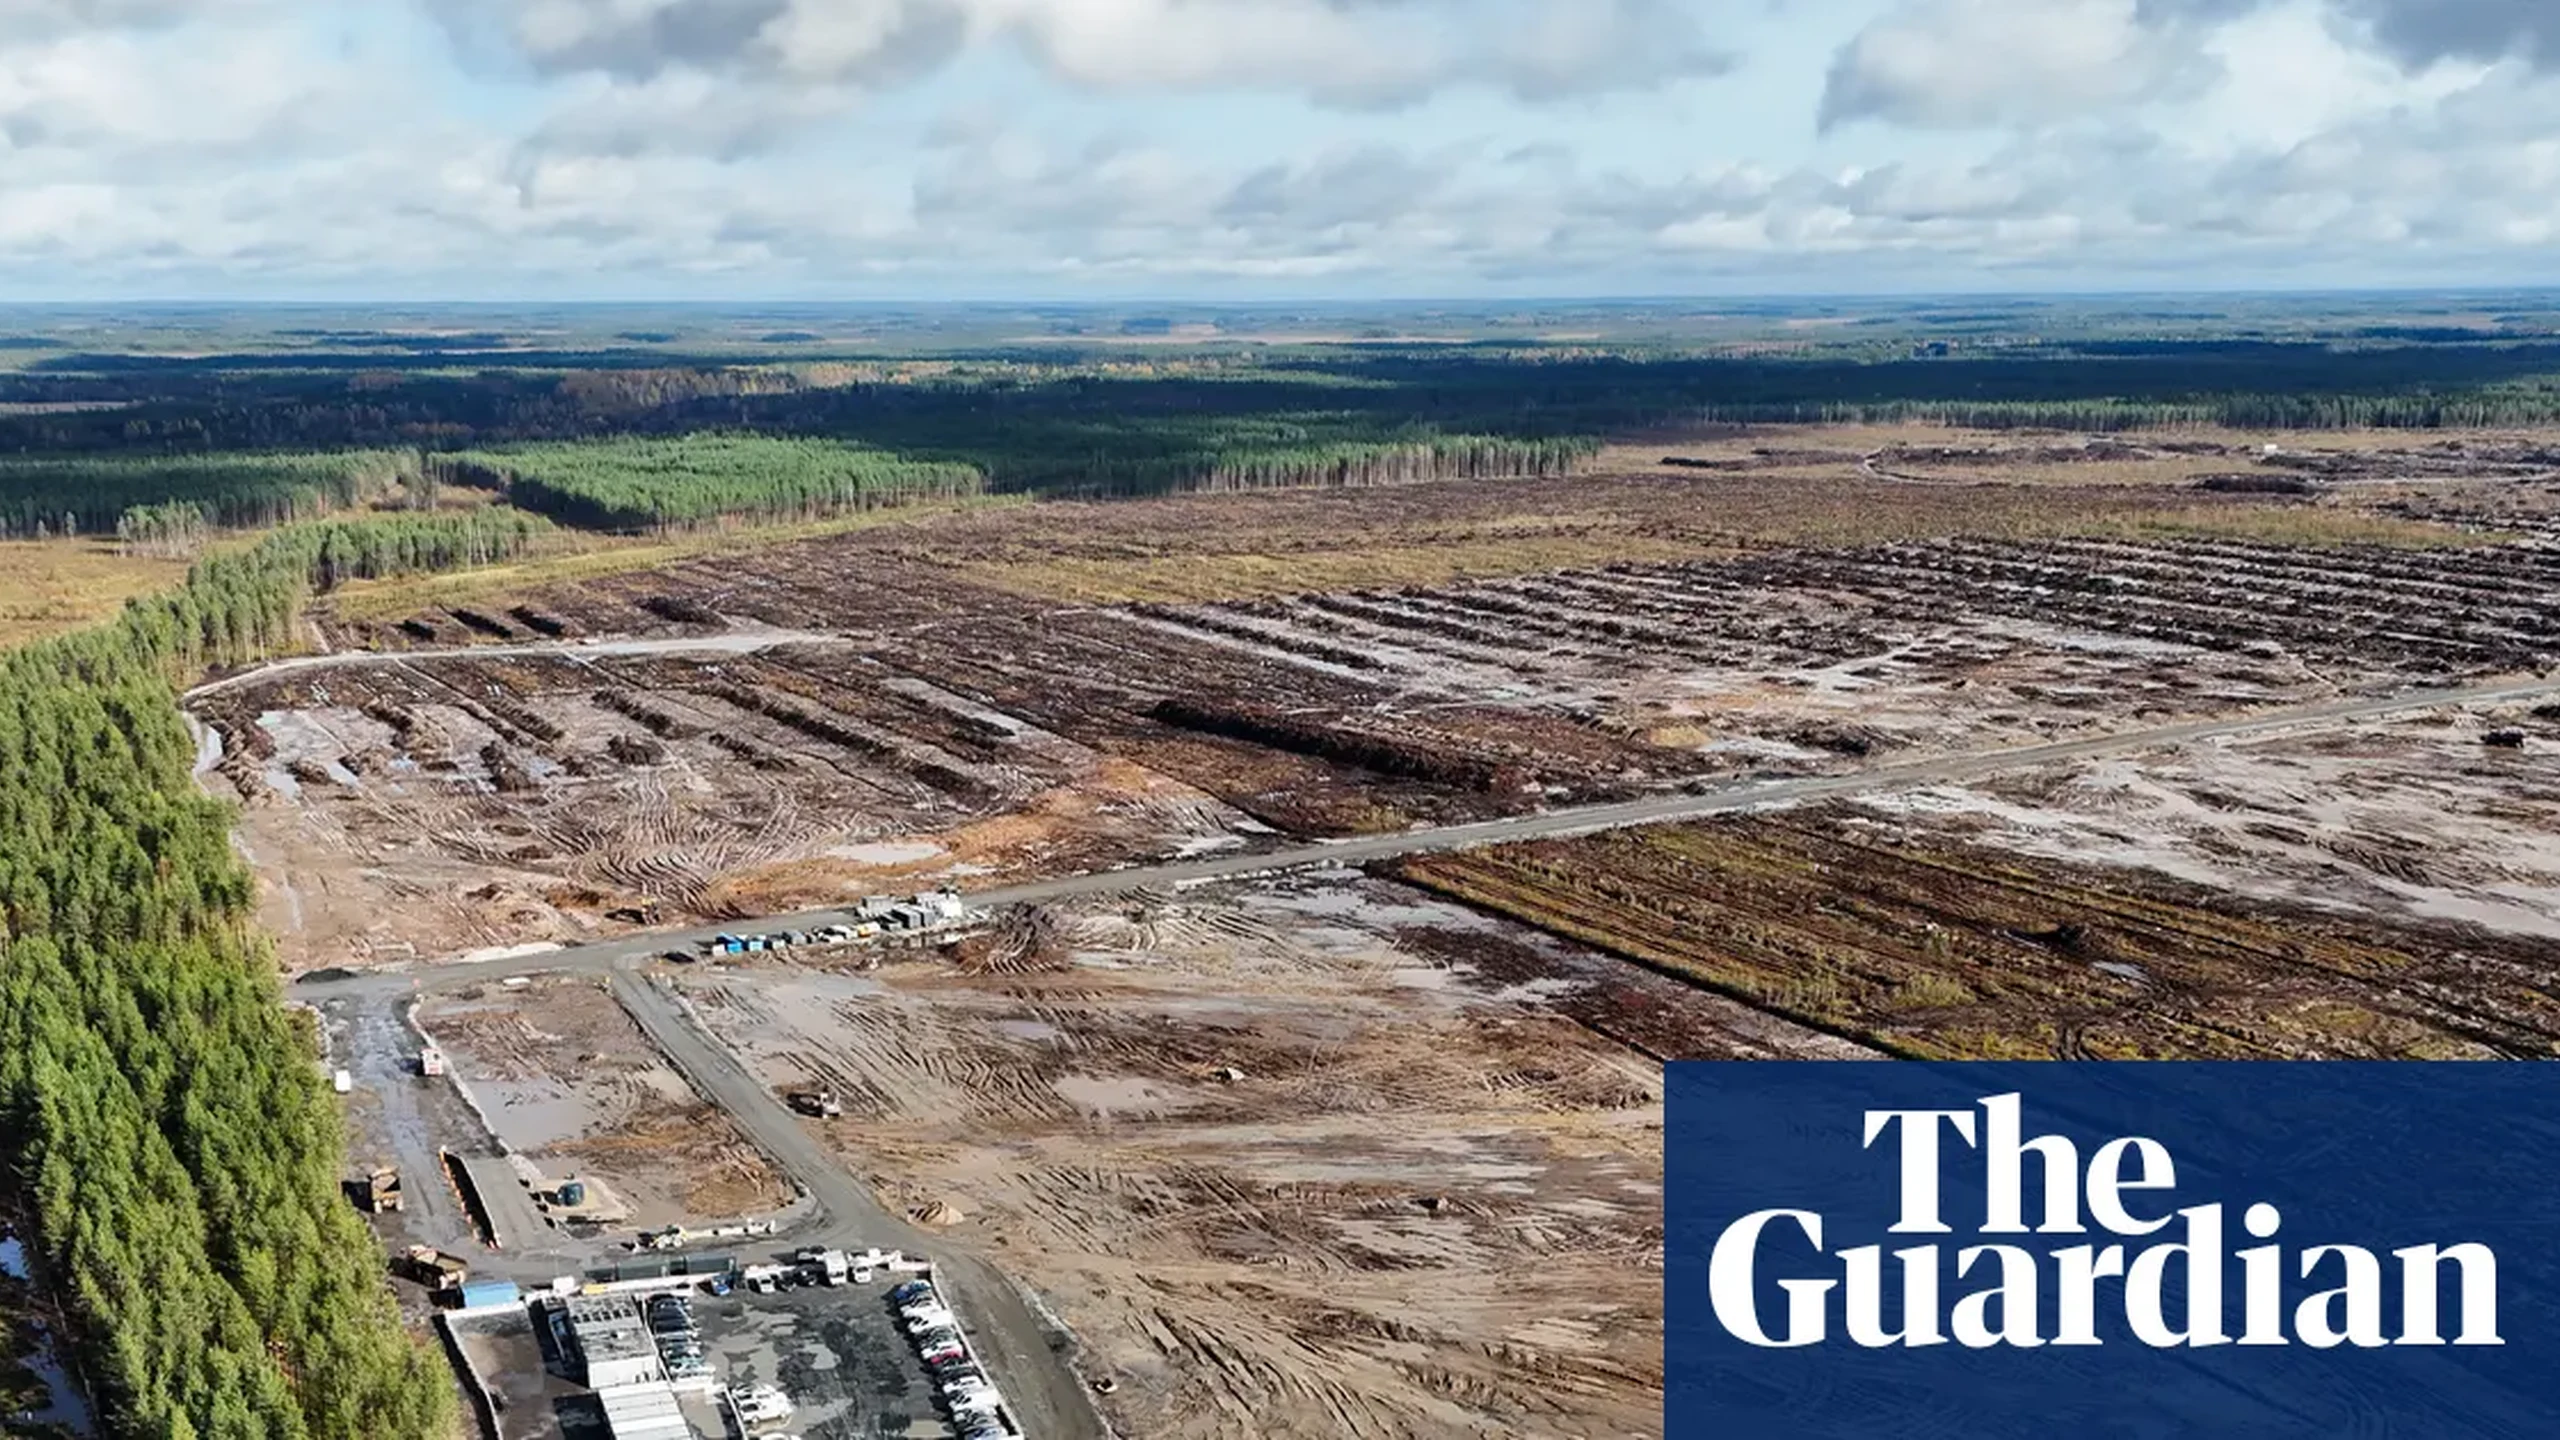
Google en Finlande : terrains, défense et restauration à l’examen
La pause touche Muhos et Kajaani.13milliards, défense forestière et130hectares plantés ne remplacent pas l’évaluation.