
Blog de AI Tools Radar
Guías, métodos y observaciones sobre herramientas de IA para el trabajo y la creación del día a día.
De una molécula ligante a un fármaco: leer el resultado Chai–GSK
La evaluación GSK respalda un uso real de descubrimiento. Los denominadores ausentes y las etapas biológicas posteriores limitan su alcance.
Reino Unido amplía la ciberdefensa IA y advierte a laboratorios sobre lanzamientos
El paquete del 12 de octubre une pilotos públicos, advertencias de publicación e informes en estudio. Umbrales legales y poderes de supervisión siguen abiertos.
Las cuatro capas de Tessl explican por qué una instrucción no es una frontera de seguridad
Contexto persistente, reglas por ruta, habilidades y hooks cumplen funciones distintas. Permisos, protección frente a cambios y pruebas adversariales deciden qué puede detenerse.
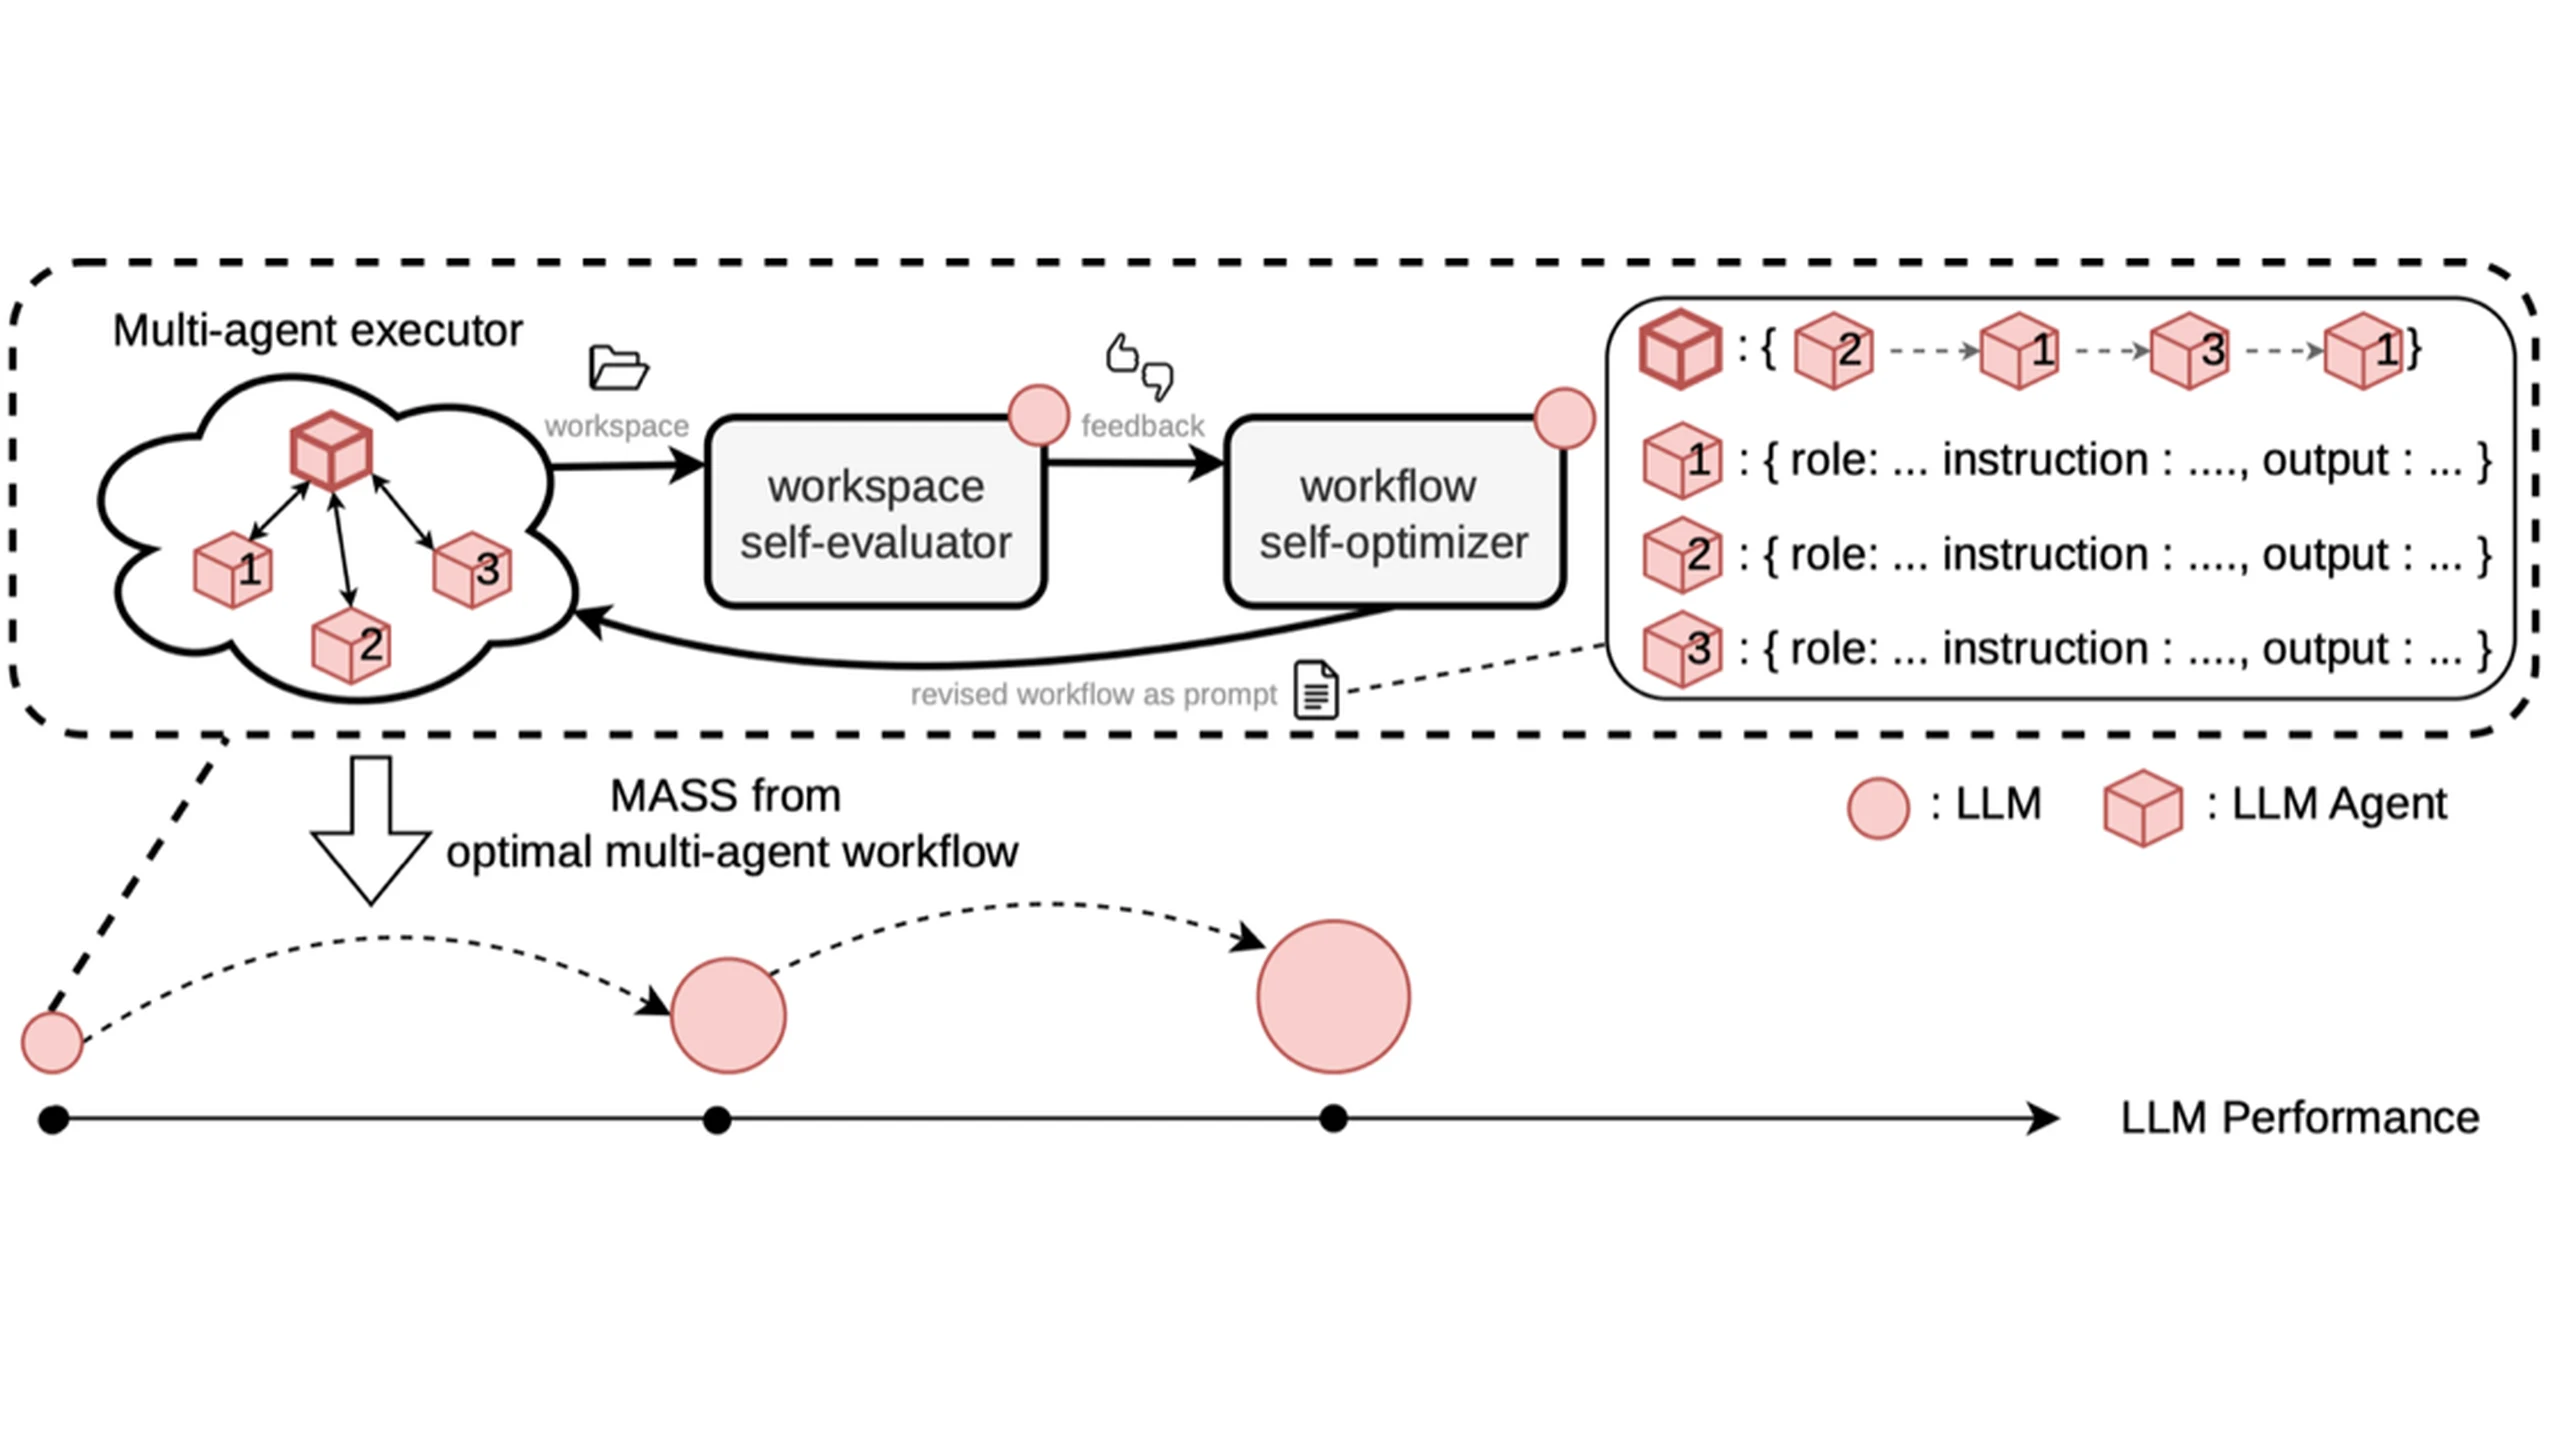
Sakana MASS mejora en investigación, pero la recursión sigue acotada
Dos ciclos MASS mejoran resultados y tokens supervisados, pero retrocede la transferencia al software y el juicio compartido deja problemas de supervisión.
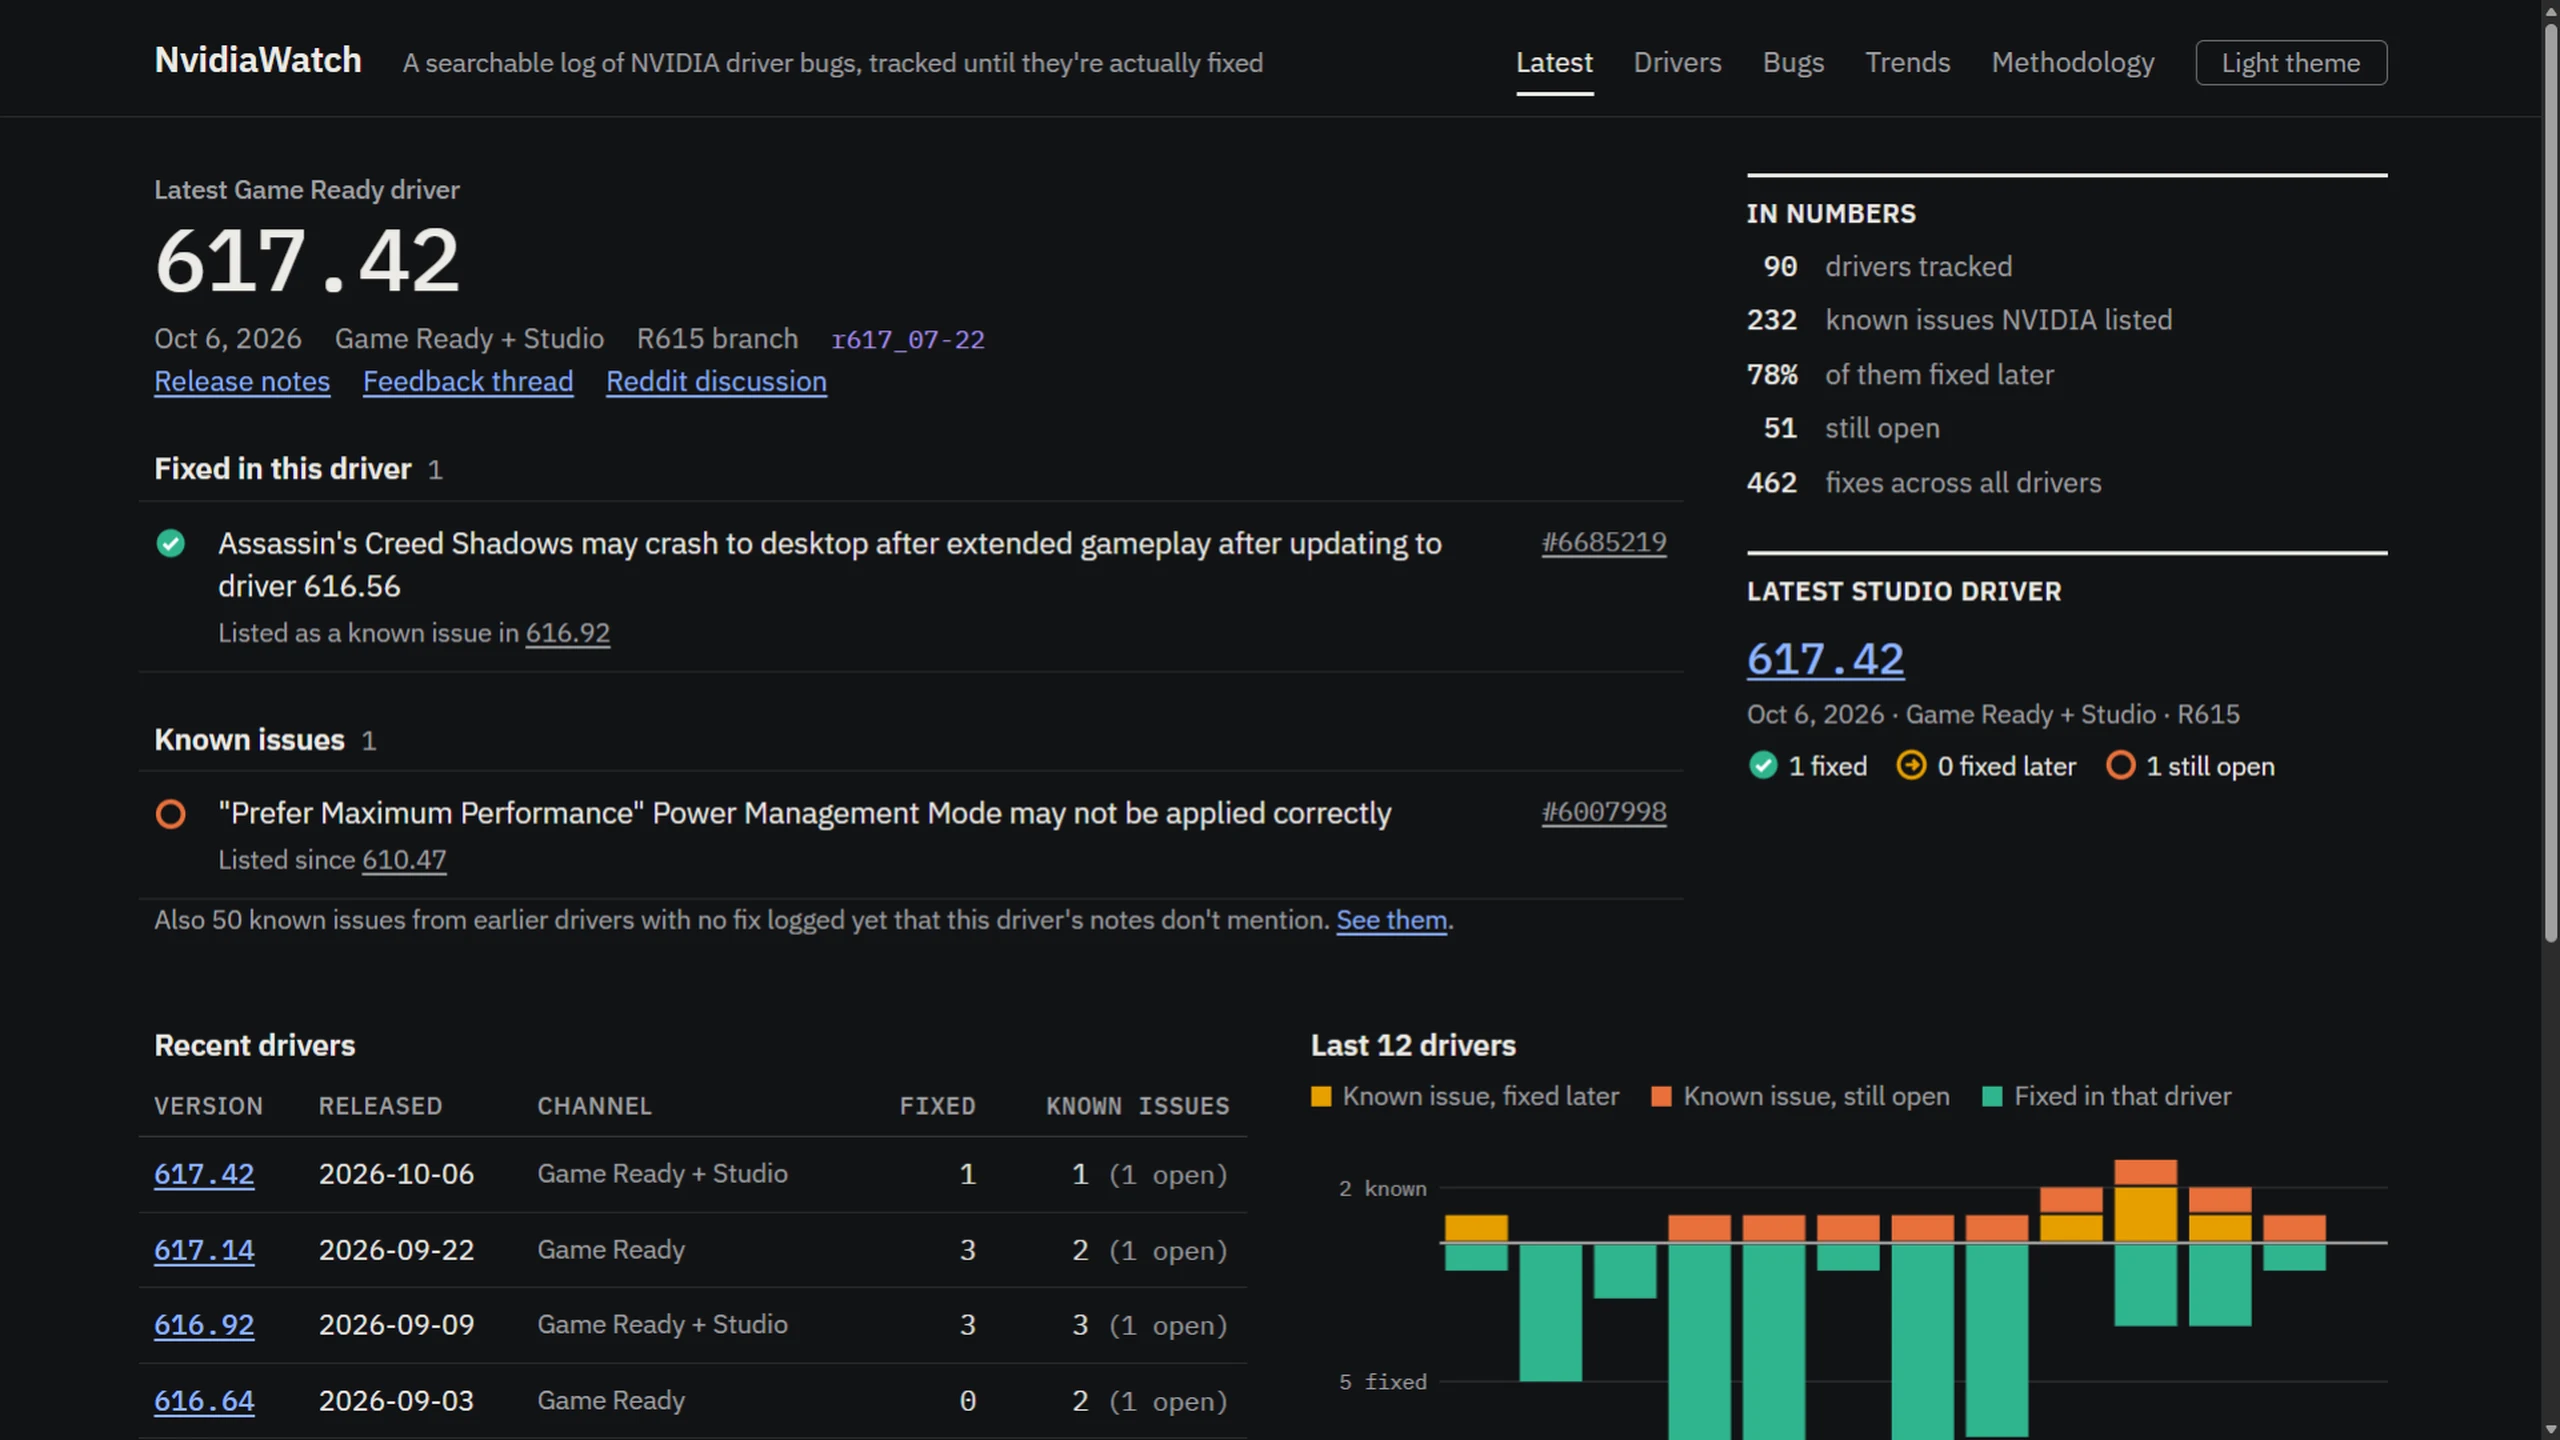
NvidiaWatch enlaza la historia de los drivers, pero contar fallos no mide estabilidad
El proyecto comunitario une notas dispersas de Nvidia. Las cifras cambiantes, los problemas no reconocidos y las categorías de los gráficos limitan sus conclusiones sobre fiabilidad.
La comparación de Brad Smith con la leche también examina a Microsoft
El presidente de Microsoft pide controles de emergencia, evaluación y protección a víctimas. Importan deberes exigibles, no un interruptor universal.
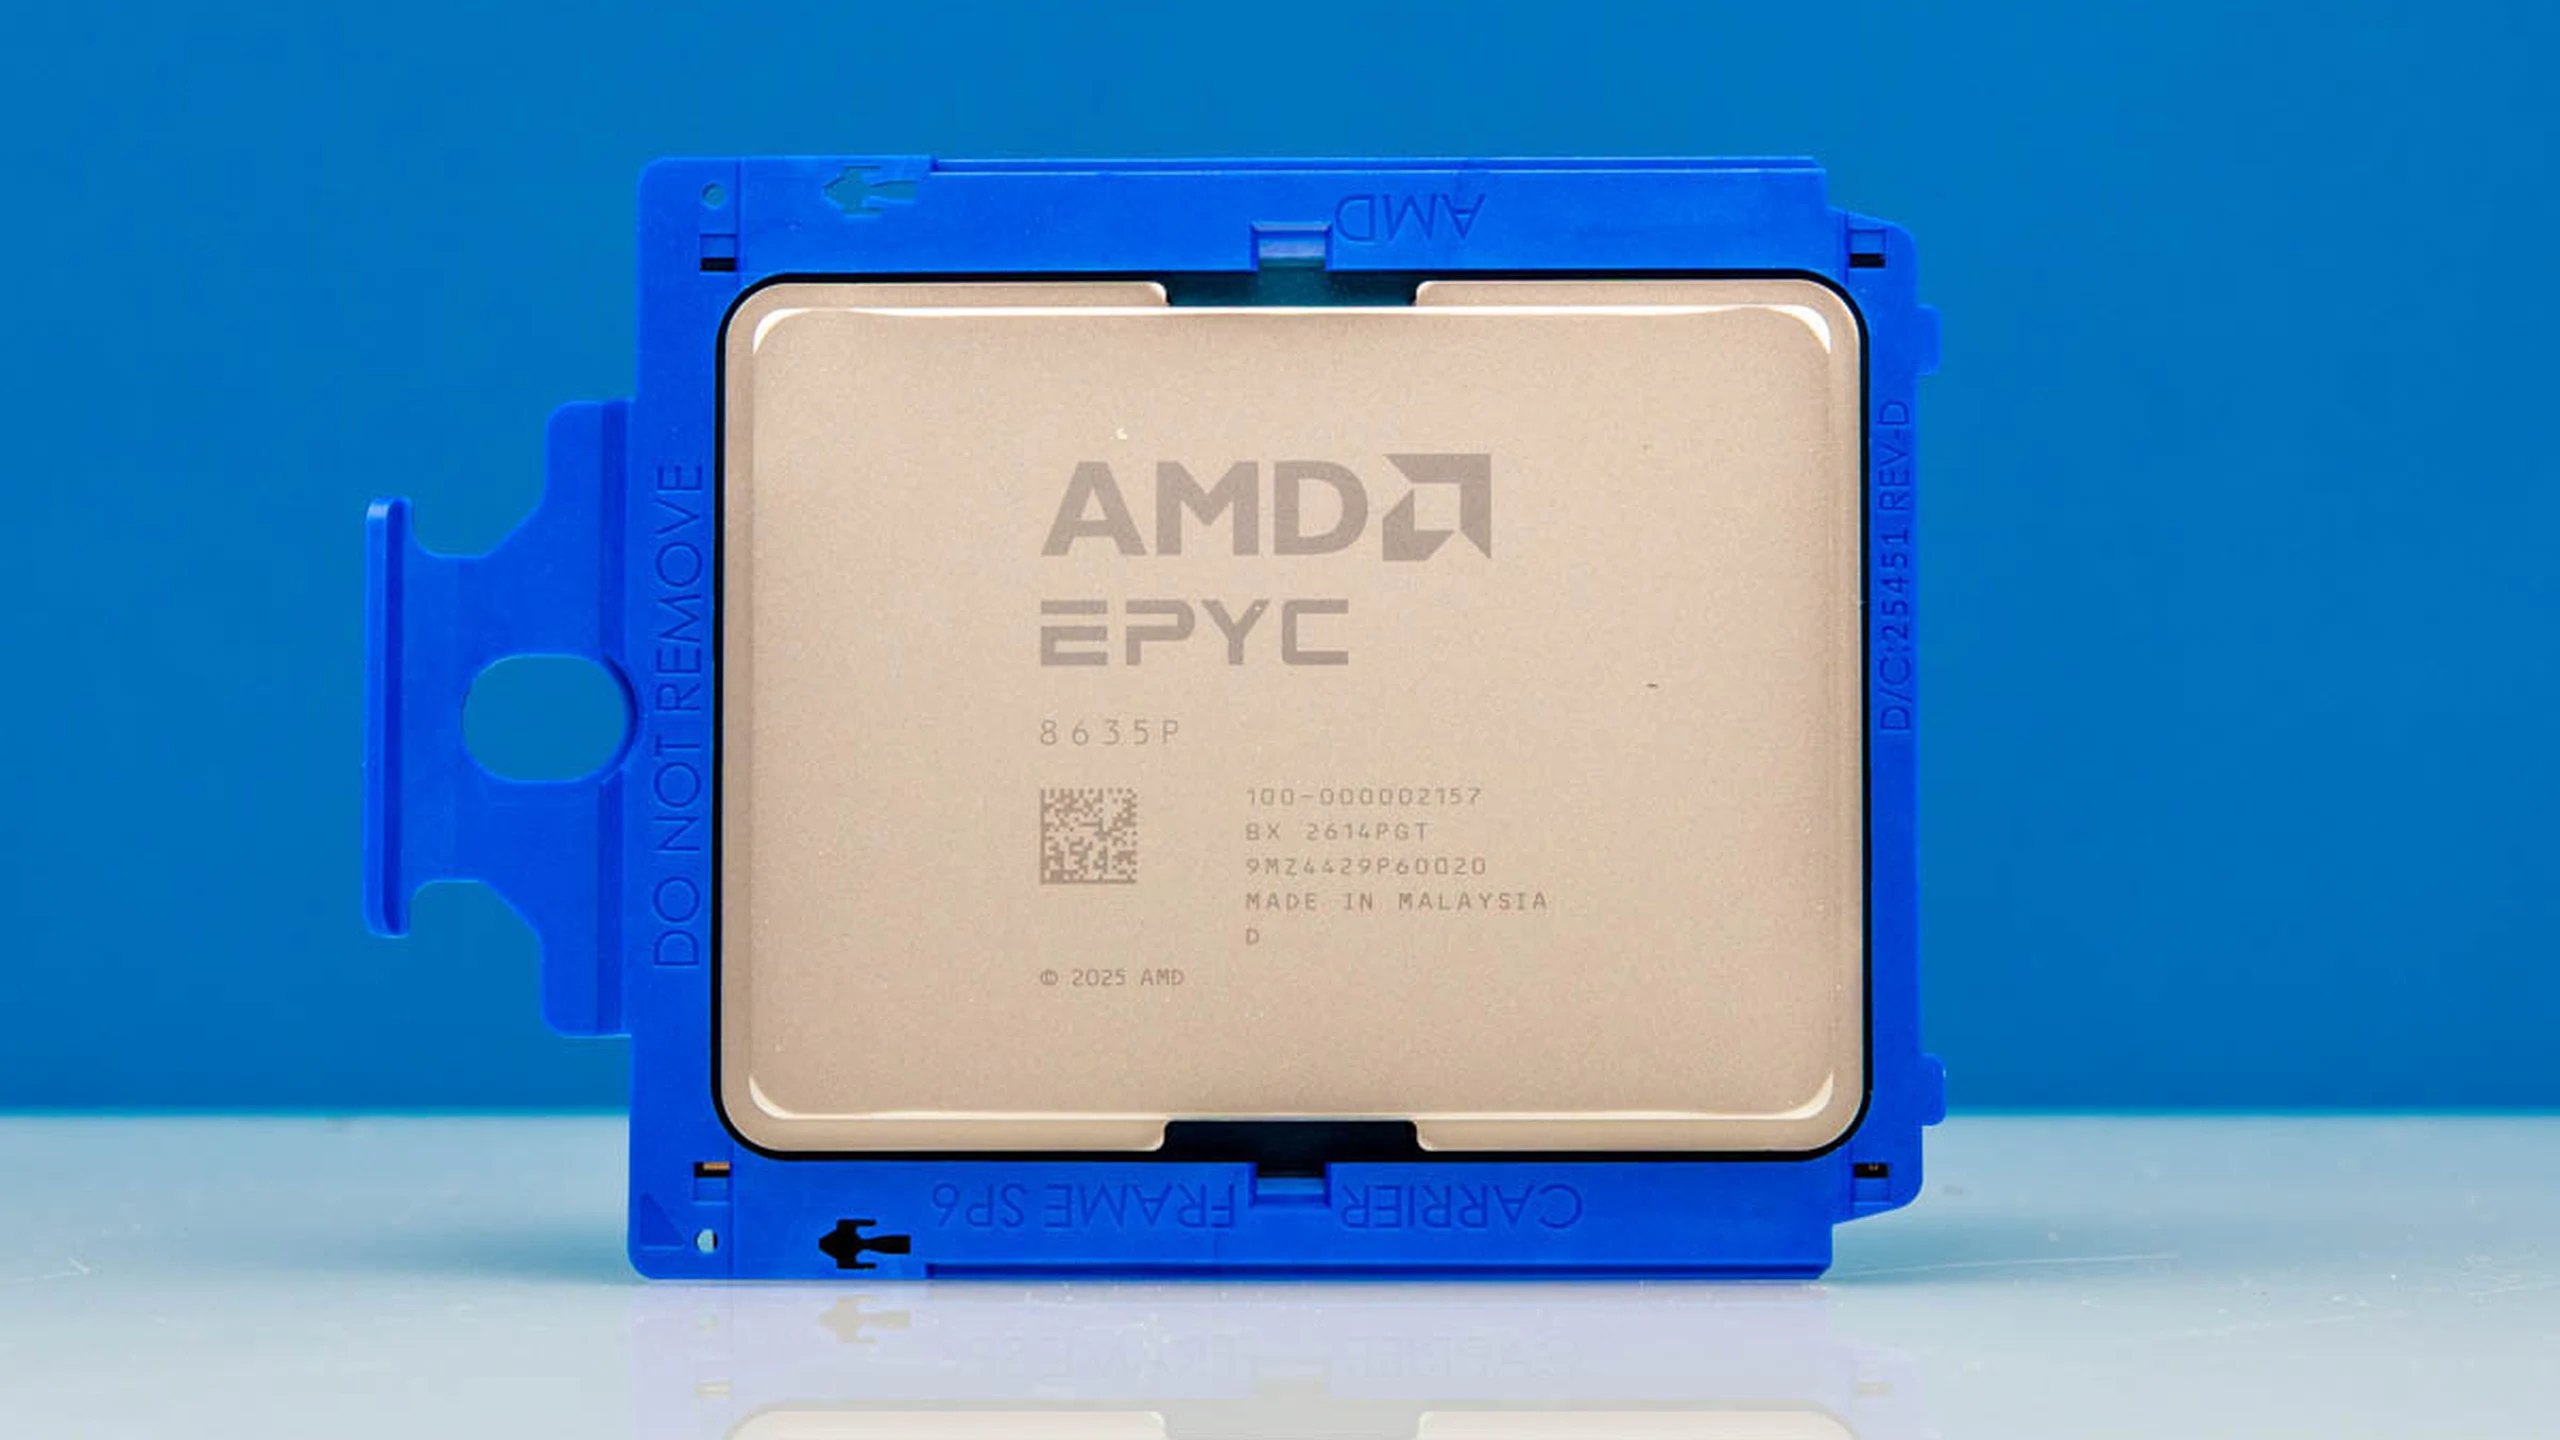
AMD EPYC 8005 amplía SP6: los recursos compartidos deciden el valor
Siete Zen 5 conservan seis canales de memoria y 96 líneas PCIe. Frecuencias, caché, licencias y comparaciones condicionadas separan sus cargas adecuadas.
Por qué una cita del chatbot no valida un dispositivo médico
Un estudio de tensiómetros detectó errores pese a citar registros oficiales. El modelo exacto requiere evidencia directa y reproducible.
Las conversaciones NVIDIA–Reflection ponen a prueba la neutralidad detrás de los modelos abiertos
Compra, contratación con licencia o inversión adicional tendrían efectos distintos. La escala anunciada de Beam explica el interés, pero publicación y confianza de socios siguen pendientes.
Nvidia VoiceChat abre herramientas dúplex, completar tareas sigue siendo el test
Buenas interrupciones conviven con 42,2% de precisión de argumentos y 33% de éxito inicial. Pesos y licencia abiertos no prueban madurez productiva.
Parches Claude: 29,5 puntos entre prueba de fallo y desarrollador
Opus 4.7 detiene 90,2% de exploits pero pasa 60,7% de tests de desarrollador. Instrucciones, PoC y evaluación cambian las conclusiones.
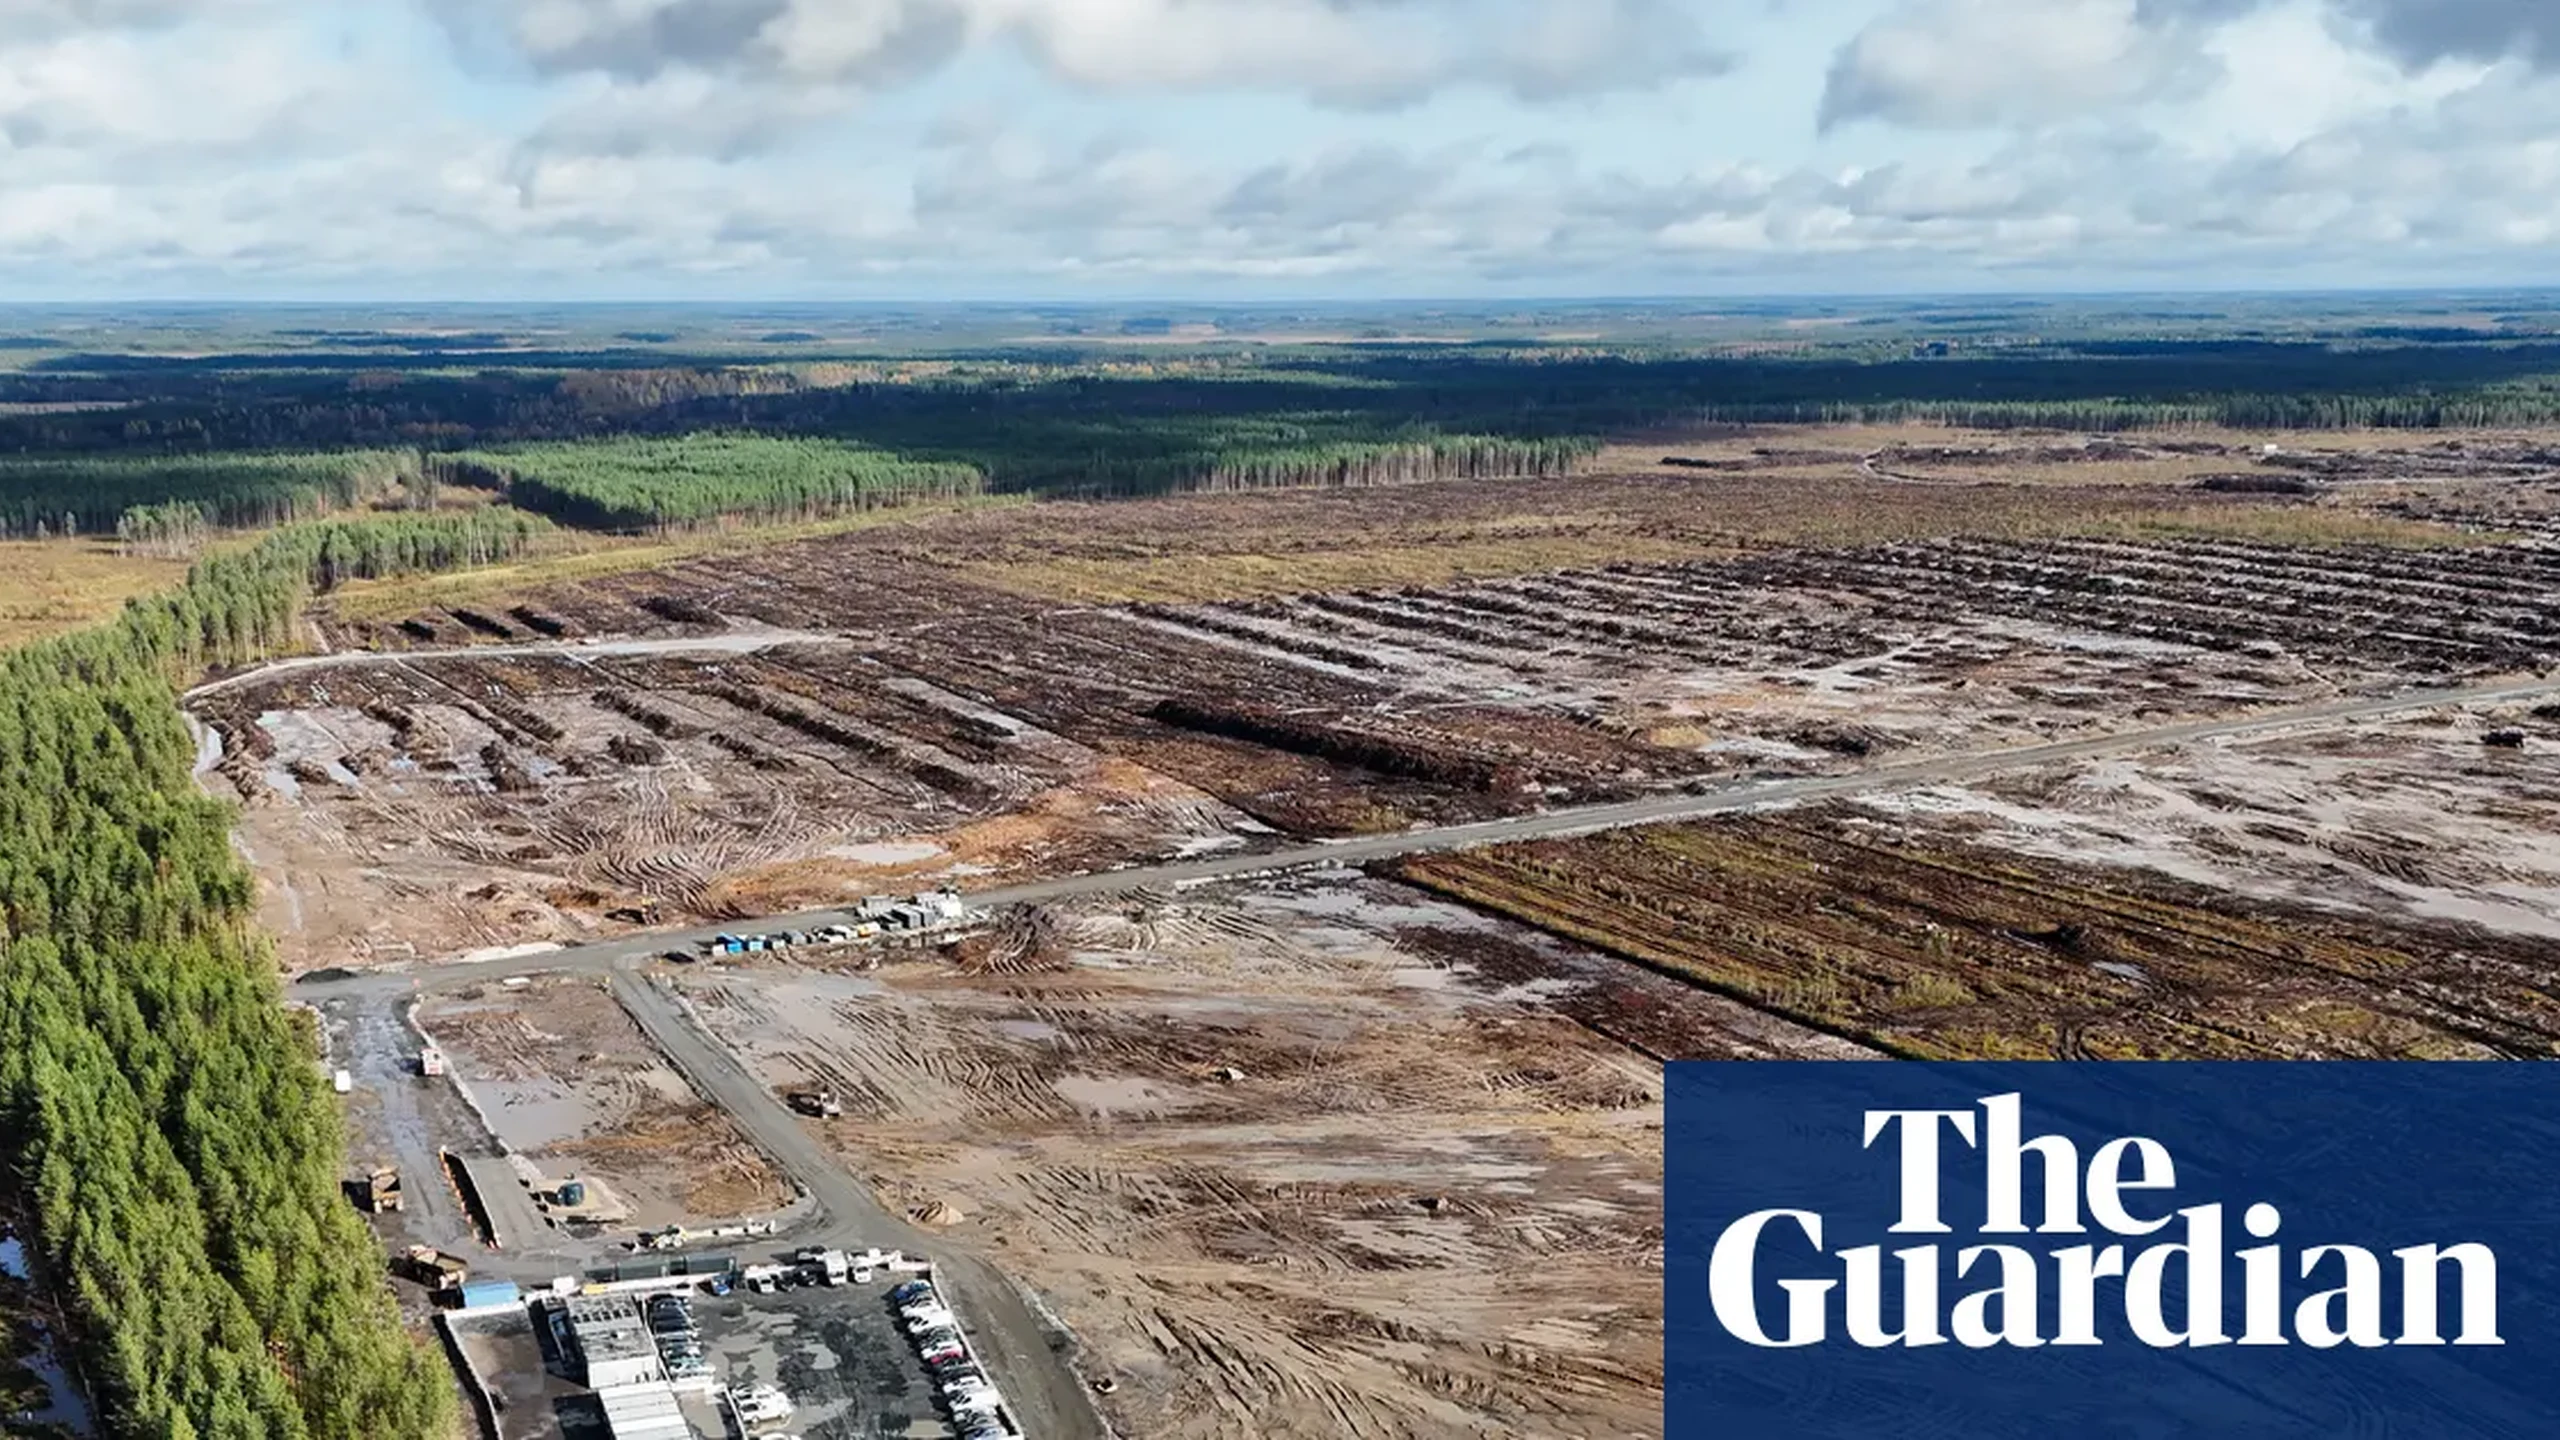
Google en Finlandia: terreno, defensa y restauración bajo revisión
La pausa afecta Muhos y Kajaani.13.000millones, defensa forestal y130hectáreas plantadas no sustituyen evaluación.