
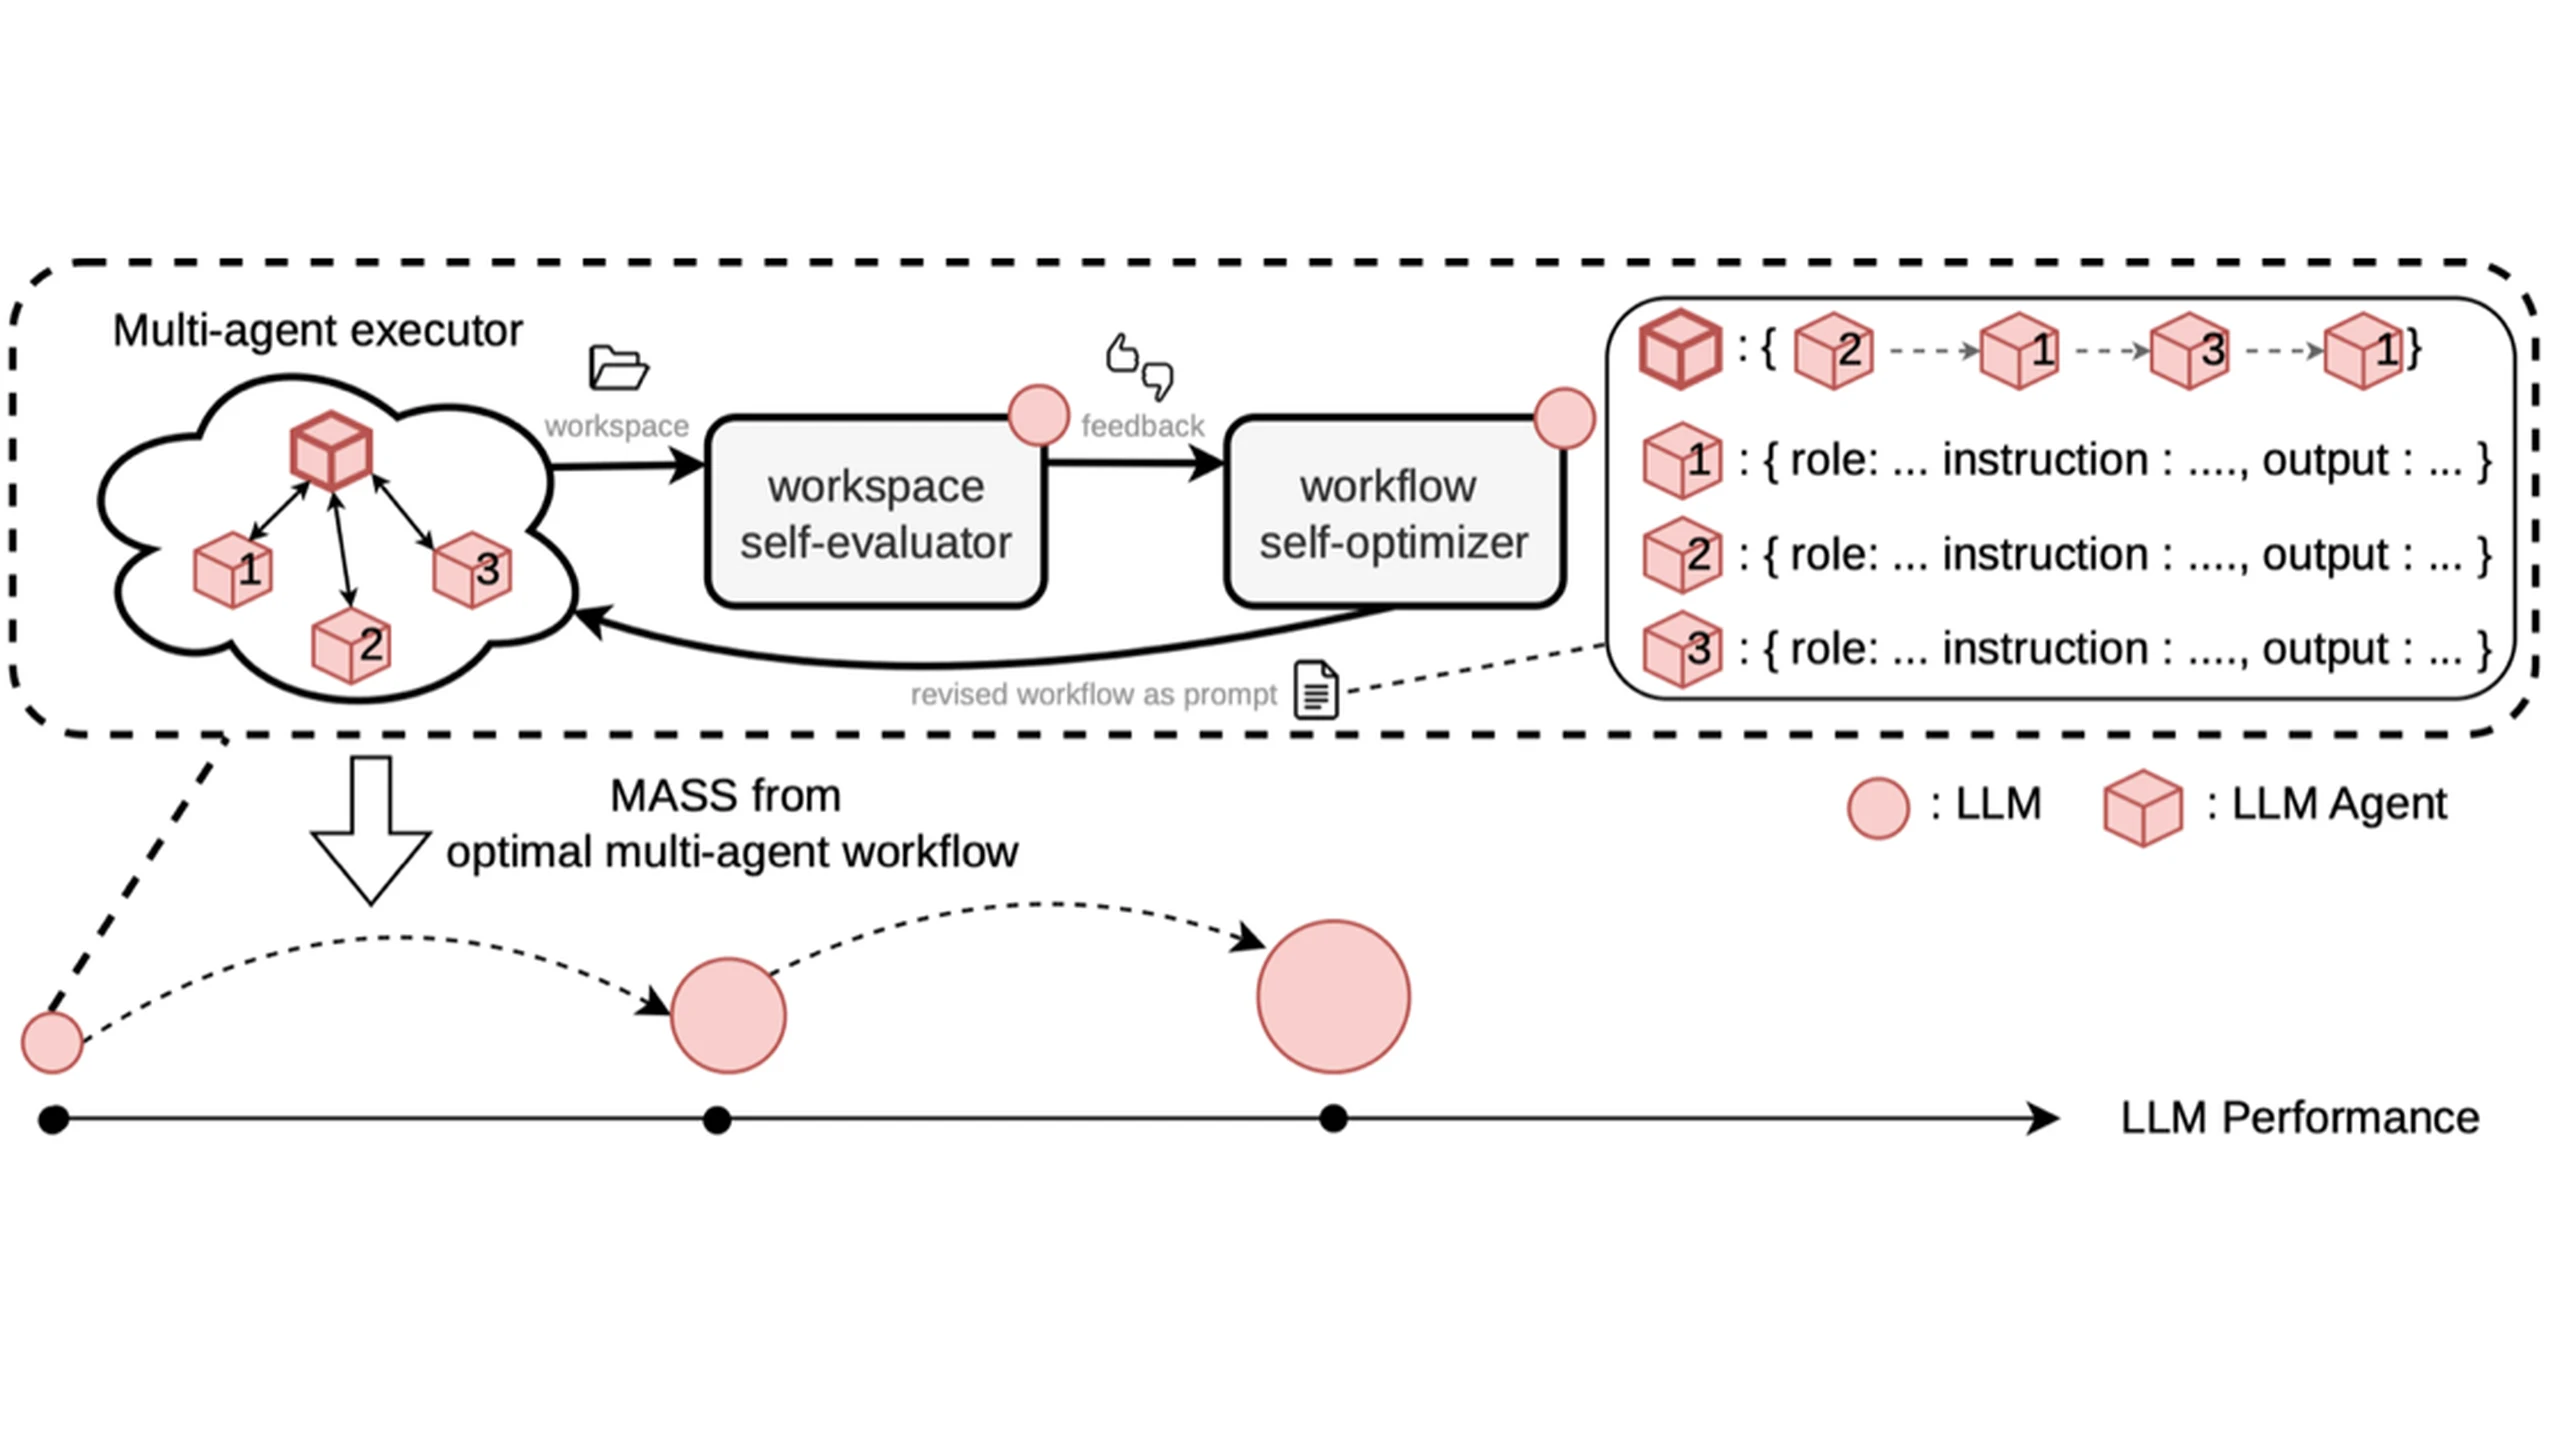
Sakana AI a terminé deux cycles de Multi-Agent Self-Supervision, ou MASS. Des copies d’un même modèle produisent des travaux de recherche, les jugent puis transforment les trajectoires sélectionnées en données d’entraînement pour leur successeur commun. Les progrès rapportés sont des résultats expérimentaux, mais inégaux : les benchmarks de recherche progressent tandis que deux tests de génie logiciel reculent. Il s’agit d’un post-entraînement encadré, pas d’une explosion autonome de l’intelligence.
L’article soumis le 8 octobre 2026 et l’implémentation ouverte fournissent consignes, configurations d’entraînement, outils d’évaluation et documentation du pipeline. Ils exposent aussi les limites du qualificatif « récursif » : deux cycles seulement, peu de tâches et un modèle susceptible de reproduire la même erreur comme exécutant, optimiseur et évaluateur.
Du travail collectif à la mise à jour du modèle
L’inférence multi-agent ordinaire répartit une tâche entre plusieurs instances et assemble leurs réponses sans changer les poids. MASS conserve au contraire messages, appels d’outils, productions intermédiaires et résultats comme trajectoires d’entraînement. Les instances ont des missions différentes, mais partagent le même modèle : ce ne sont pas des experts entraînés indépendamment.
La boucle interne garde les poids fixes et recherche un meilleur workflow défini par consignes. Celui-ci précise rôles, instructions, contrats de sortie et étapes de communication. Chaque tâche d’entraînement possède un workflow champion. Une équipe candidate exécute la tâche, le modèle compare son espace de travail à celui du champion et l’optimiseur propose une révision à partir du jugement.
Après sélection, MASS exécute le workflow 18 fois par tâche. Les jugements du modèle comparent les espaces deux à deux ; un modèle de Bradley–Terry convertit ces préférences en scores. Jusqu’à 16 trajectoires sont retenues : 15 peuvent servir à l’entraînement, une à la validation. Le texte du workflow est retiré de la consigne initiale d’entraînement de l’orchestrateur afin qu’il déduise l’organisation à partir de la tâche plutôt que recopier le plan fourni.
La boucle externe utilise l’adaptation de faible rang, LoRA, pour ajuster un ensemble limité de paramètres. Les conversations de l’orchestrateur et des sous-agents deviennent des cibles d’entraînement. Le modèle mis à jour reprend ensuite les trois rôles. Le terme récursif se défend puisque chaque génération contribue aux données de la suivante. Les humains définissent toujours architecture, tâches, optimisation, benchmarks, infrastructure et limites des cycles.
Des progrès en recherche, une frontière nette du transfert
Le modèle initial est Qwen3.6-27B dans un environnement d’agent de programmation. La suite synthétique comprend 12 tâches de finance, robotique et pharmacie, exigeant chacune code, analyse quantitative et rapport. Neuf étaient prévues pour l’entraînement, mais huit ont finalement fourni des données. Trois, une par domaine, ont été exclues de l’ajustement, de la validation et du choix des points de contrôle.
GPT-5.5 et Claude Opus 4.8 ont jugé les espaces de travail terminés depuis l’extérieur, sans superviser la boucle d’entraînement. Sur les trois tâches réservées, le premier modèle gagne 53,9 % des comparaisons contre le modèle initial, et le deuxième 69,9 %. Le deuxième bat le premier dans 60,8 % des cas. Sur les tâches d’entraînement, les victoires contre la base atteignent respectivement 65,6 % et 82,5 %. Ces résultats plus forts ne doivent pas être confondus avec les preuves hors entraînement.
Sur les benchmarks publics de recherche, Sakana rapporte des scores par jeton de sortie de 1,2 à 1,6 fois ceux de la base au deuxième cycle. MLR-Bench passe de 1,71 à 2,25, avec un taux de remise d’articles de 57 % à 76 %. ScienceAgentBench progresse de 28,8 % à 31,7 %. AstaBench E2E-Hard passe de 0,053 à 0,067 et son taux de remise de rapports de 50 % à 76 %. DSBench ne bouge que de 0,473 à 0,482 : un meilleur ratio d’efficacité ne transforme pas cette faible variation absolue en forte hausse du score.
Le génie logiciel suit la direction inverse. Terminal-Bench 2.0 recule de 0,375 à 0,352, et SWE-bench Verified de 0,626 à 0,611. Leurs ratios par jeton sont de 0,96 et 0,94 fois la base. Le modèle n’est donc pas uniformément plus fort.
L’adéquation des tâches est une explication plausible : l’entraînement privilégiait rapports, preuves quantitatives et code, non le débogage de dépôts ou les opérations de terminal. Ajouter des tâches logicielles pourrait aider, comme le suggère Sakana, mais cela reste à tester et pourrait perturber des capacités existantes. Une vraie évaluation du transfert doit vérifier les nouveaux domaines et la conservation des anciens acquis.
Les coûts absents des chiffres d’efficacité
Dans une comparaison d’entraînement, un élève multi-agent atteint 68,3 % de victoires après 28,8 millions de jetons supervisés. Le plus grand élève mono-agent atteint 64 % après 42 millions. C’est un meilleur résultat avec 31 % de jetons supervisés en moins, pas la démonstration d’une baisse de 31 % du coût total de développement.
Avant sélection, les équipes généraient en moyenne environ 2,4 fois plus de jetons. Les juges externes préféraient leurs productions dans 85,1 % des comparaisons avec celles d’agents seuls. Sur dix paires de traces de longueur similaire, les équipes gagnaient encore 80 % des cas. Coordination et sélection semblent donc utiles, mais la comparaison n’isole pas la délégation : workflows et consignes de vérification différaient aussi.
Le score par jeton mesure une sortie productive, pas le pipeline entier. Recherche de workflows, répétitions, comparaisons, génération de données et évaluation consomment du calcul supplémentaire. Les totaux supervisés excluent les jetons d’entrée et plusieurs coûts amont. MASS soutient donc l’idée de données sélectionnées plus denses ; l’efficacité globale demande un bilan plus complet.
Les contrats d’information plutôt que les personnages
La recherche modifie rôles, instructions, contrats et étapes de communication. Un contrat définit la preuve ou la production à rendre ; une étape détermine quand transmettre l’information ou la renvoyer en révision. C’est plus précis que demander à plusieurs copies de jouer chercheur, critique ou rédacteur.
Dans un exemple financier, les agents couvrent préparation des données, construction des variables, modélisation, backtest, audit, rapprochement et rapport. L’agent des données doit signaler si des informations futures ont contaminé les décisions historiques. Cette exigence vise un vrai échec : un excellent backtest peut simplement utiliser des données indisponibles à l’époque.
L’analyse textuelle de Sakana trouve une concentration croissante de l’information propre à la tâche dans les contrats et l’ordre de communication, plutôt que dans les rôles et instructions générales. L’échantillon ne compte que huit ou neuf tâches selon la comparaison, et l’information mutuelle estimée porte sur les textes de workflow, non sur tous les messages. C’est un indice du mécanisme, pas une preuve causale générale.
Les précédents travaux sur le débat multi-agent étudiaient les progrès issus de l’échange de réponses et de critiques. MASS transfère les comportements collectifs sélectionnés dans les poids : les traces d’orchestration enseignent décomposition et coordination, celles des sous-agents les missions bornées. Une base de connaissances techniques interrogeable illustre l’intérêt organisationnel de preuves et décisions consultables, mais ne constitue pas une validation indépendante de MASS.
L’optimiseur et le juge partagent leurs limites
Un modèle jouant trois rôles réduit la dépendance à un professeur durablement plus fort, mais crée des échecs corrélés. L’exécutant peut mal comprendre la tâche, l’évaluateur récompenser cette erreur et le successeur l’apprendre avec davantage d’assurance. Échantillonnage aléatoire et spécialisation créent de la variation, pas des parcours d’entraînement indépendants ni une indépendance de jugement garantie.
La présentation du projet Sakana identifie les angles morts communs comme un problème de sécurité. L’accord entre juges internes et externes passe de 73 % à 93 % sur trois générations. C’est encourageant pour ces tâches, pas une preuve de justesse : les juges peuvent partager des présupposés ou préférer des rapports soignés tout en manquant des erreurs exigeant des expériences réelles.
La force de l’optimiseur constitue une autre contrainte. En conservant Qwen initial comme exécutant, utiliser GPT-5.5 seulement comme juge apporte un gain limité. Comme juge et optimiseur, il trouve des workflows gagnants pour les 12 tâches en cinq itérations au plus. La boucle homogène finit par en trouver pour 11 sur 12, mais nécessite jusqu’à 13 itérations. Une bonne critique ne suffit pas si l’optimiseur ne sait pas la convertir en meilleur processus.
La recherche est également instable : de fortes itérations peuvent être suivies de régressions brutales. Les critiques communautaires citées dans le reportage initial questionnaient le terme récursif et l’arrêt après deux cycles. L’interprétation prudente est une recherche itérative de workflows et un ajustement supervisé, délimités par les humains, non une réécriture autonome sans limites ni la preuve de progrès indéfinis.
La supervision doit progresser avec les capacités
La recherche sans règle automatique de réussite est particulièrement exposée à l’autoconfirmation. Un rapport cohérent peut comporter une erreur conceptuelle, omettre des preuves contraires ou coder un mauvais objectif dans un programme qui fonctionne. Le consensus des modèles ne tranche pas seul nouveauté scientifique, stratégie, valeurs ou sécurité.
Les travaux d’OpenAI sur l’observabilité du raisonnement montrent que les traces peuvent révéler davantage que les actions et réponses finales, mais que la surveillance reste incomplète et dépend de l’agent comme du contrôleur. Les trajectoires riches de MASS offrent des occasions d’inspection et des cachettes. Optimiser le raisonnement visible peut récompenser une explication convaincante sans corriger le comportement.
La discussion d’Anthropic sur l’auto-amélioration récursive insiste aussi sur supervision, validation et vérification. Modèles externes, experts, tests exécutables, pipelines de données fiables, évaluations adversariales et validation réelle différée sont des contrôles possibles. Aucun ne couvre toutes les défaillances ; des modèles d’accord peuvent partager le même biais.
Les prochains tests décisifs sont des cycles supplémentaires, un transfert sans perte des acquis et la correction d’un angle mort commun introduit délibérément. Il ne suffit pas que des juges externes détectent une erreur : la boucle doit modifier son workflow et exclure les traces défectueuses de l’entraînement. Pour l’instant, MASS prouve l’intérêt d’un apprentissage concentré à partir d’équipes de recherche bornées et riches en preuves. Il ne démontre ni amélioration récursive illimitée ni légitimité de supprimer l’examen humain des décisions importantes.