
Blog AI Tools Radar
Guias, métodos e observações sobre ferramentas de IA para o trabalho e a criação no mundo real.
De ligante a medicamento: como ler o resultado Chai–GSK
O teste da GSK apoia um uso real de descoberta. Denominadores ausentes e etapas biológicas posteriores delimitam a evidência disponível.
Reino Unido alarga ciberdefesa IA e avisa laboratórios sobre lançamentos
O pacote de 12 de outubro reúne pilotos públicos, avisos de publicação e comunicação de incidentes em estudo. Limiares legais e poderes de supervisão continuam abertos.
As quatro camadas da Tessl mostram por que uma instrução no repositório não é uma barreira de segurança
Contexto persistente, regras por escopo, skills e hooks têm funções distintas. A estrutura da Tessl facilita a revisão, mas permissões, proteção contra alterações e testes adversariais determinam o que pode ser impedido.
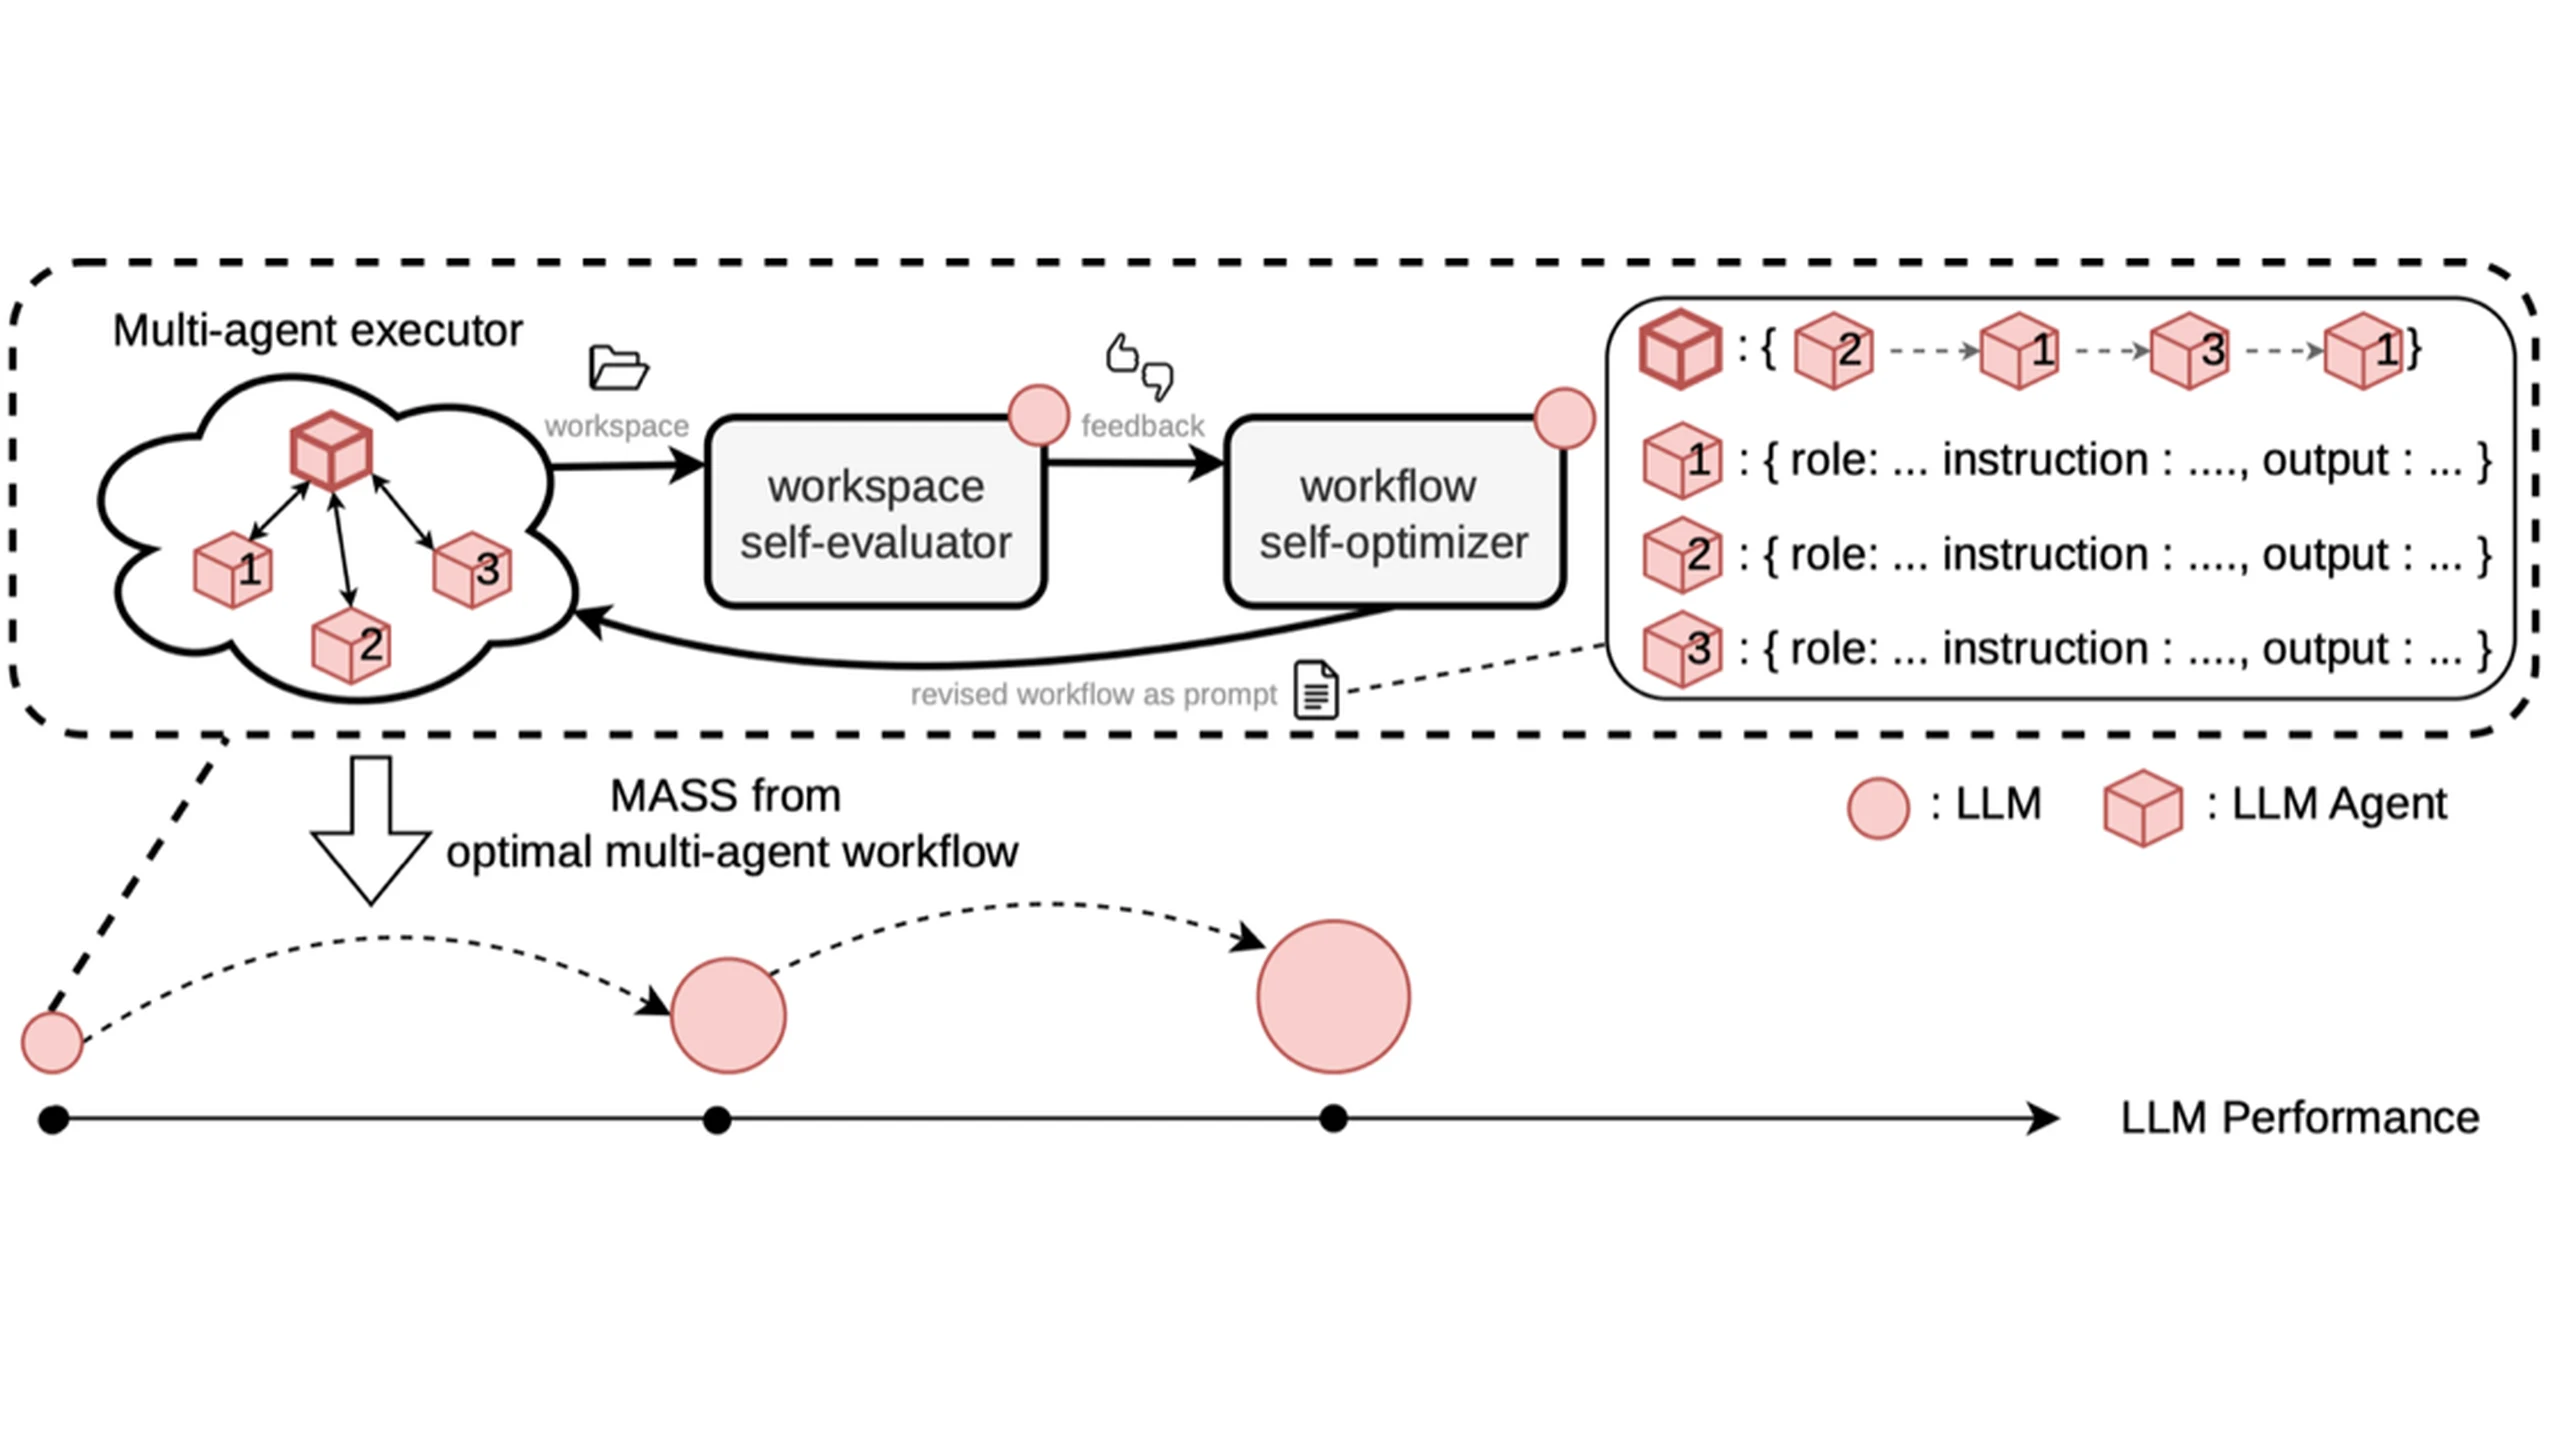
Sakana MASS melhora na investigação, mas a recursão continua delimitada
Dois ciclos MASS melhoram resultados e tokens supervisionados, mas a transferência para software recua e o julgamento partilhado mantém problemas de supervisão.
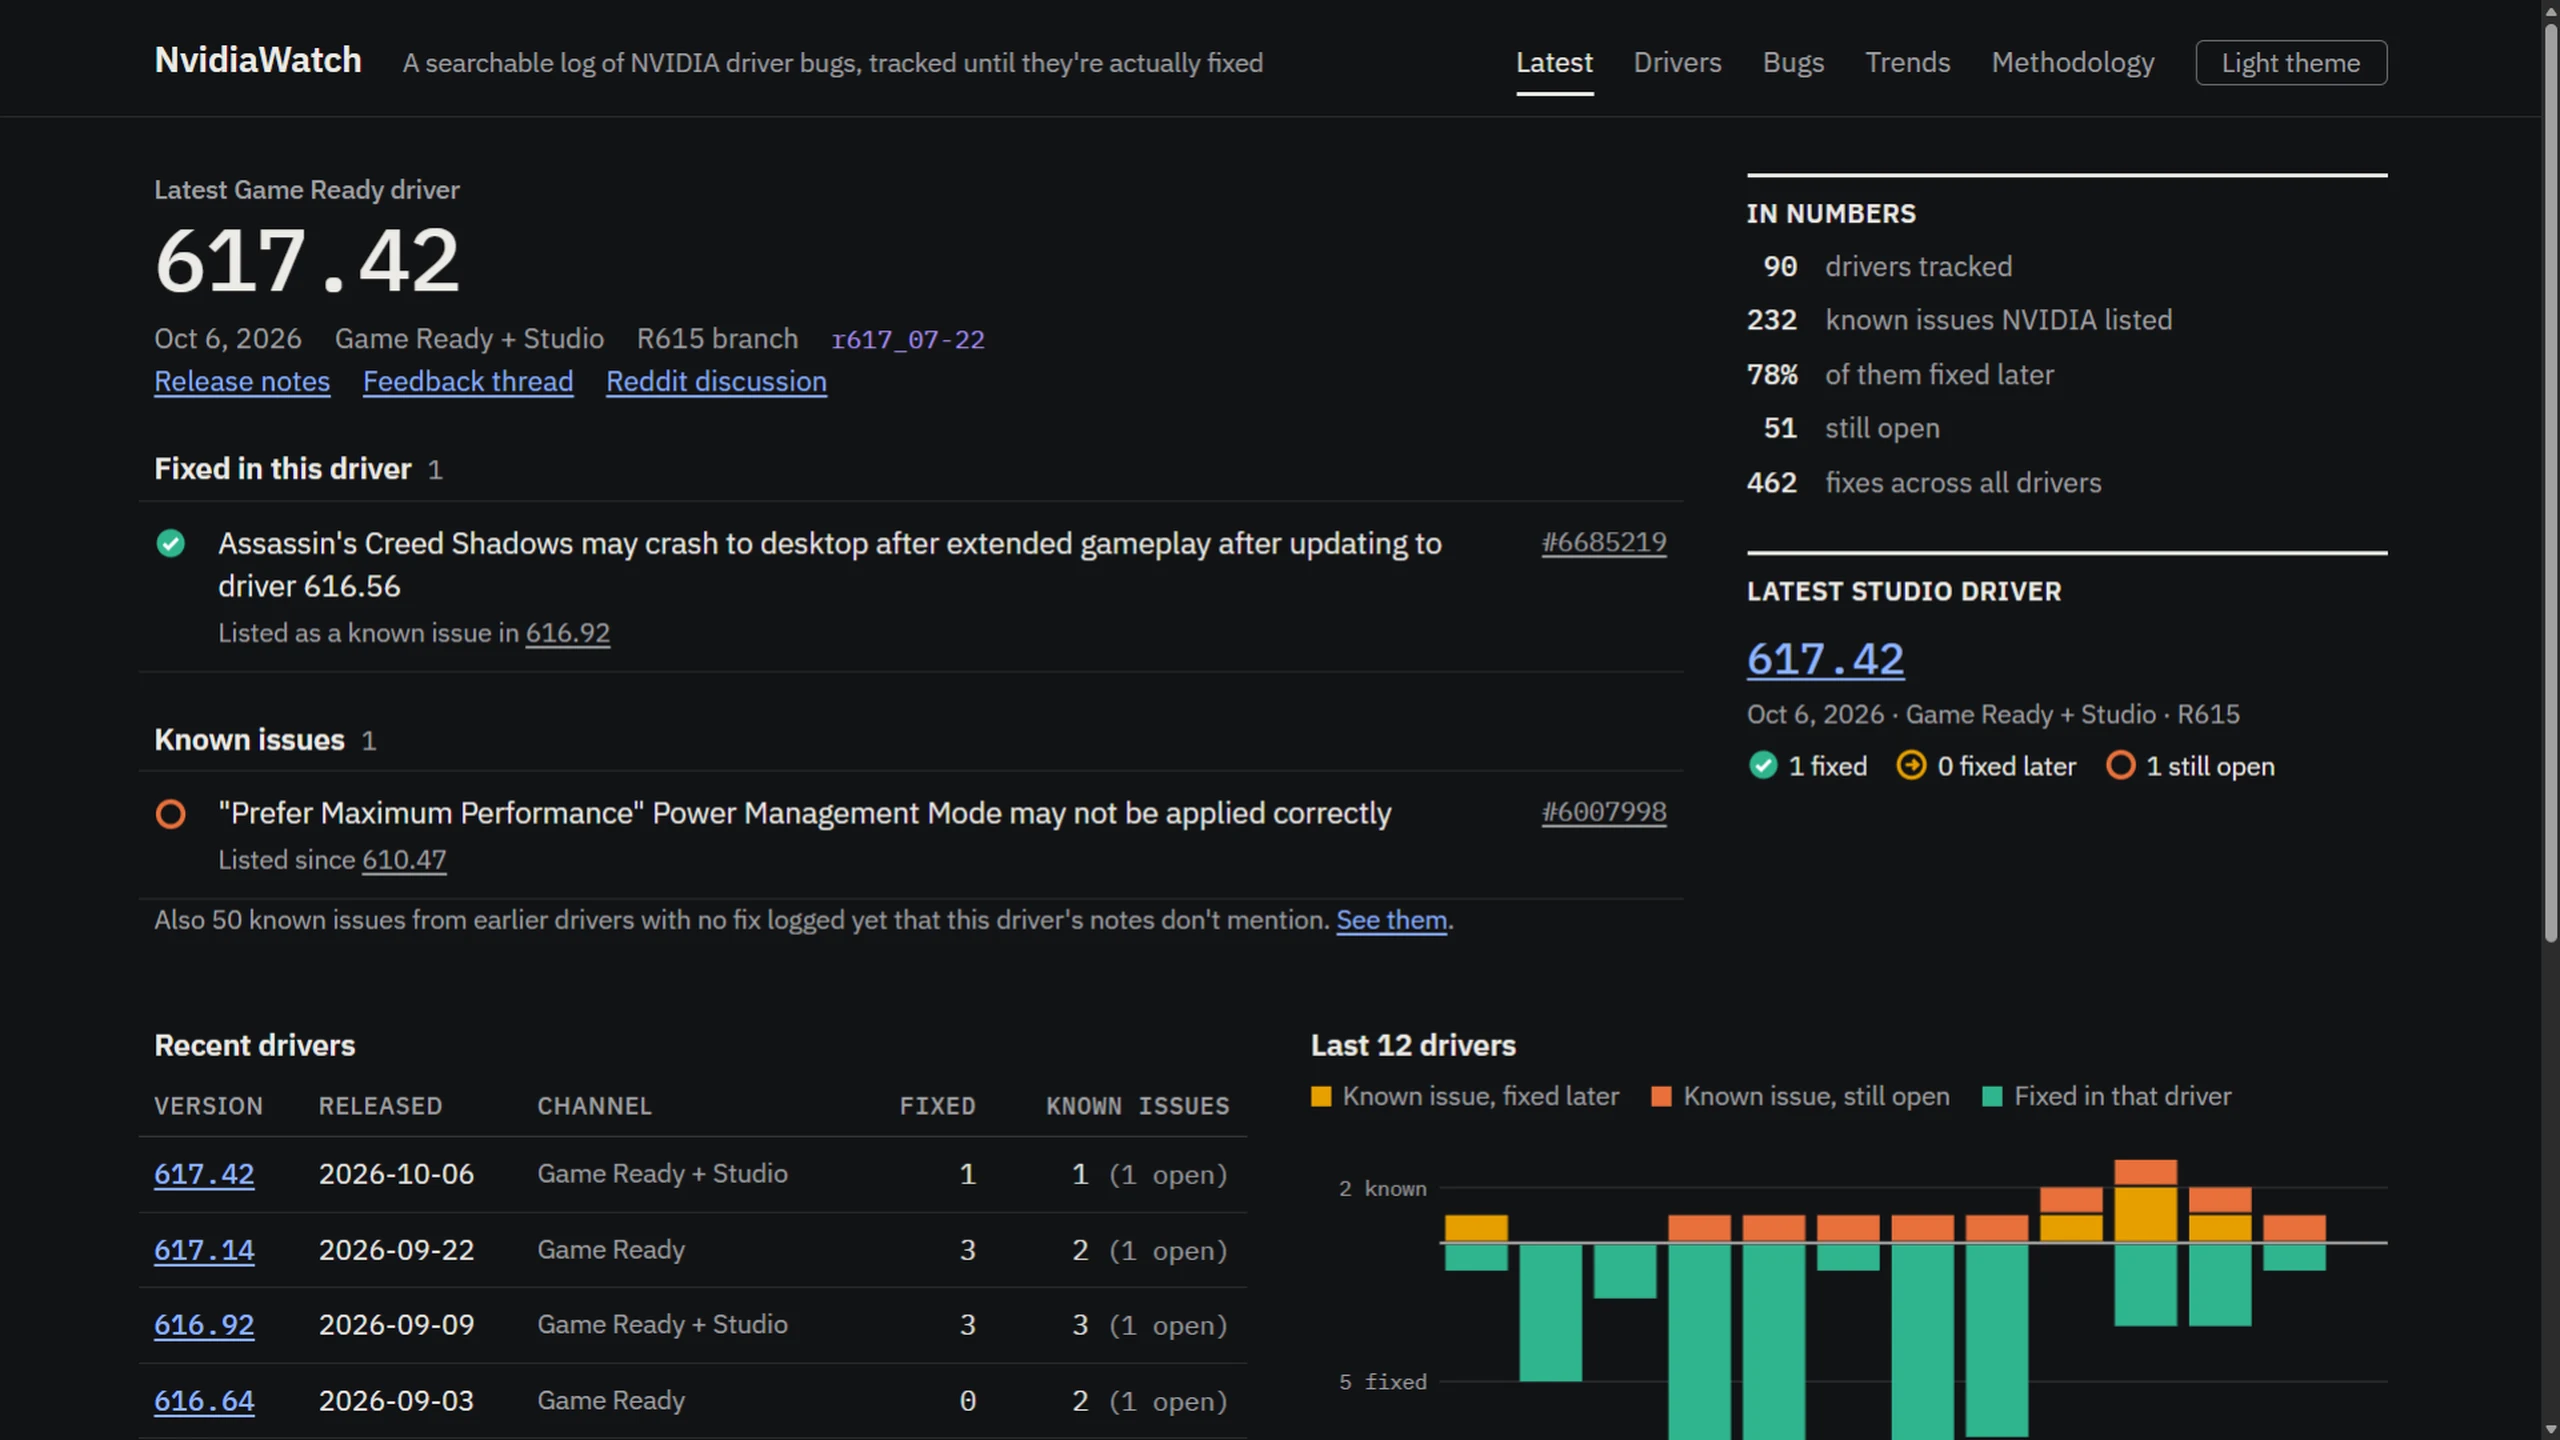
NvidiaWatch conecta históricos de drivers, mas contar bugs não mede estabilidade
O projeto comunitário relaciona notas dispersas da Nvidia. Retratos variáveis, problemas não reconhecidos e categorias dos gráficos limitam o que se pode concluir sobre confiabilidade.
A comparação de Brad Smith com o leite também põe a Microsoft à prova
O presidente Microsoft pede controlos de emergência, avaliação e proteção das vítimas. Importam deveres exigíveis, não um interruptor universal.
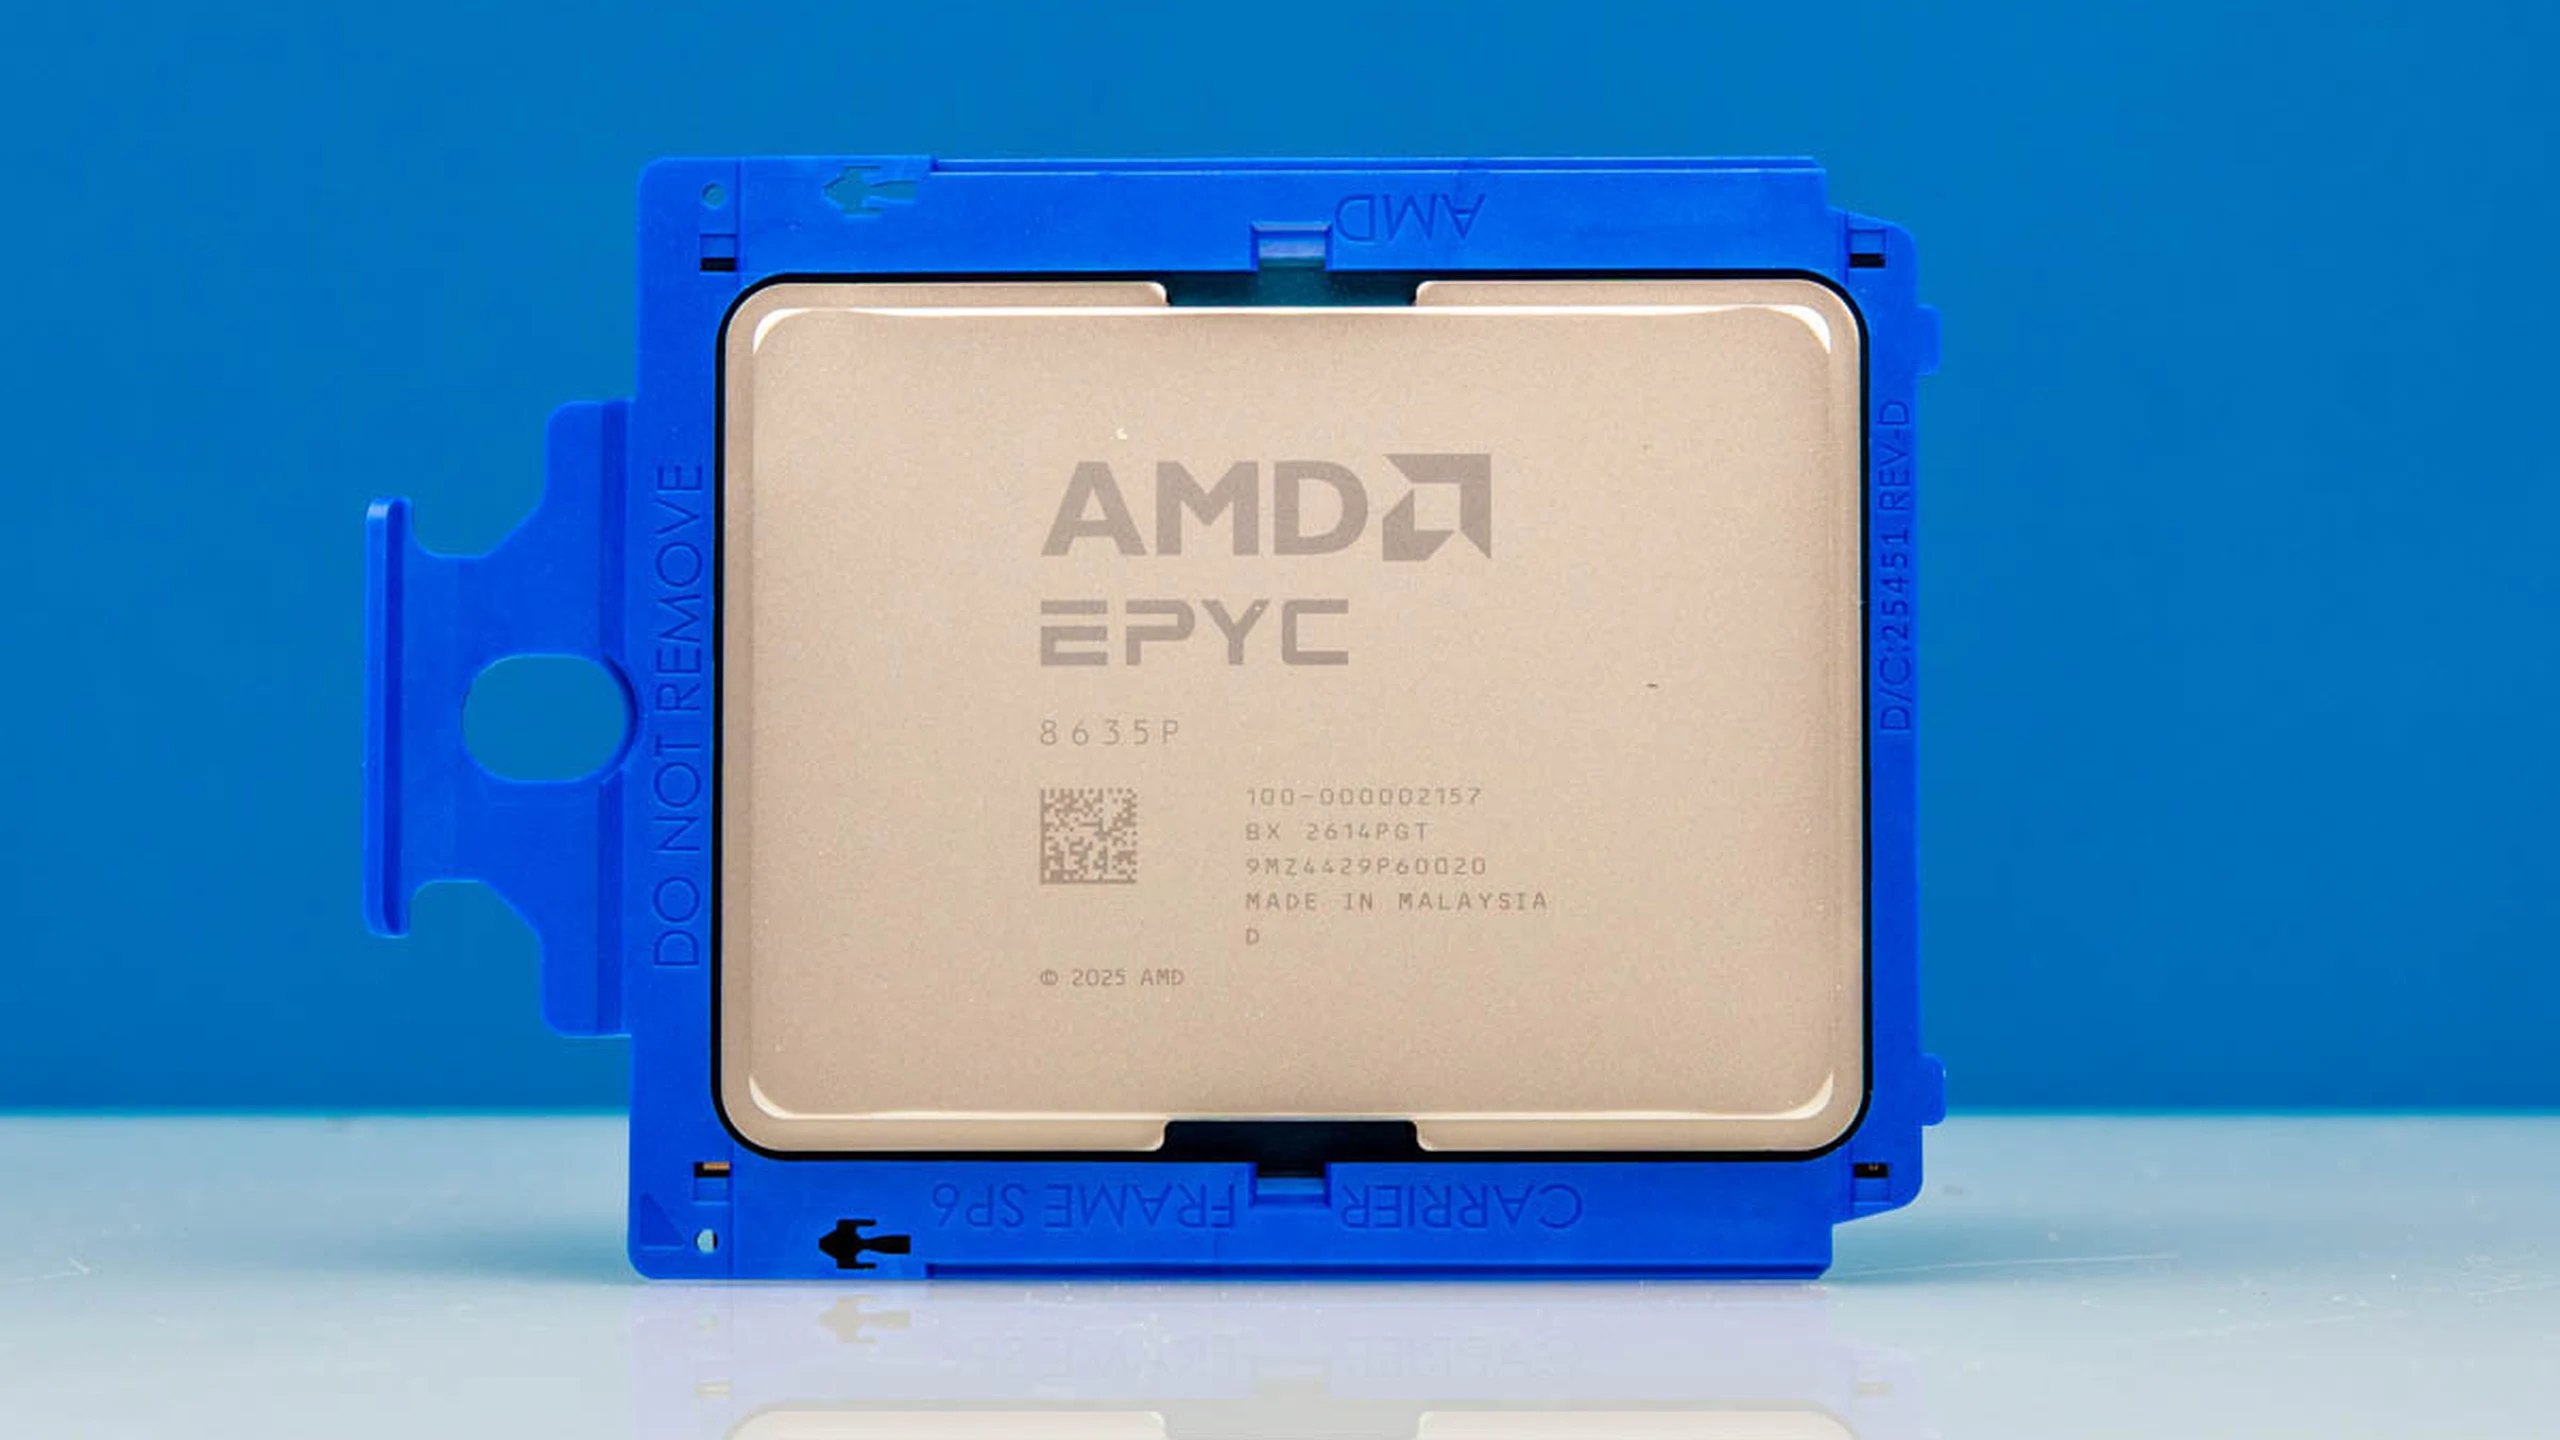
AMD EPYC 8005 alarga SP6: recursos partilhados determinam o valor
Sete Zen 5 mantêm seis canais de memória e 96 vias PCIe. Frequências, cache, licenças e comparações condicionais distinguem as cargas adequadas.
Por que uma citação do chatbot não valida um dispositivo médico
Um estudo de medidores de pressão encontrou erros mesmo com registros oficiais citados. O modelo exato precisa de evidência direta.
Conversas NVIDIA–Reflection testam a neutralidade da plataforma por trás dos modelos abertos
Compra, contratação com licença ou novo investimento teriam efeitos diferentes. A escala declarada do Beam explica o interesse, sem resolver promessas de lançamento e confiança dos parceiros.
Nvidia VoiceChat abre ferramentas full-duplex, mas concluir tarefas continua sendo o teste
Bons resultados de interrupção convivem com 42,2% de precisão dos argumentos e 33% de sucesso inicial. Pesos abertos e licença não demonstram prontidão para produção.
Correções Claude: 29,5 pontos entre teste de falha e do programador
Opus 4.7 trava 90,2% dos exploits mas passa 60,7% dos testes dos programadores. Instruções, PoC e avaliação mudam as conclusões.
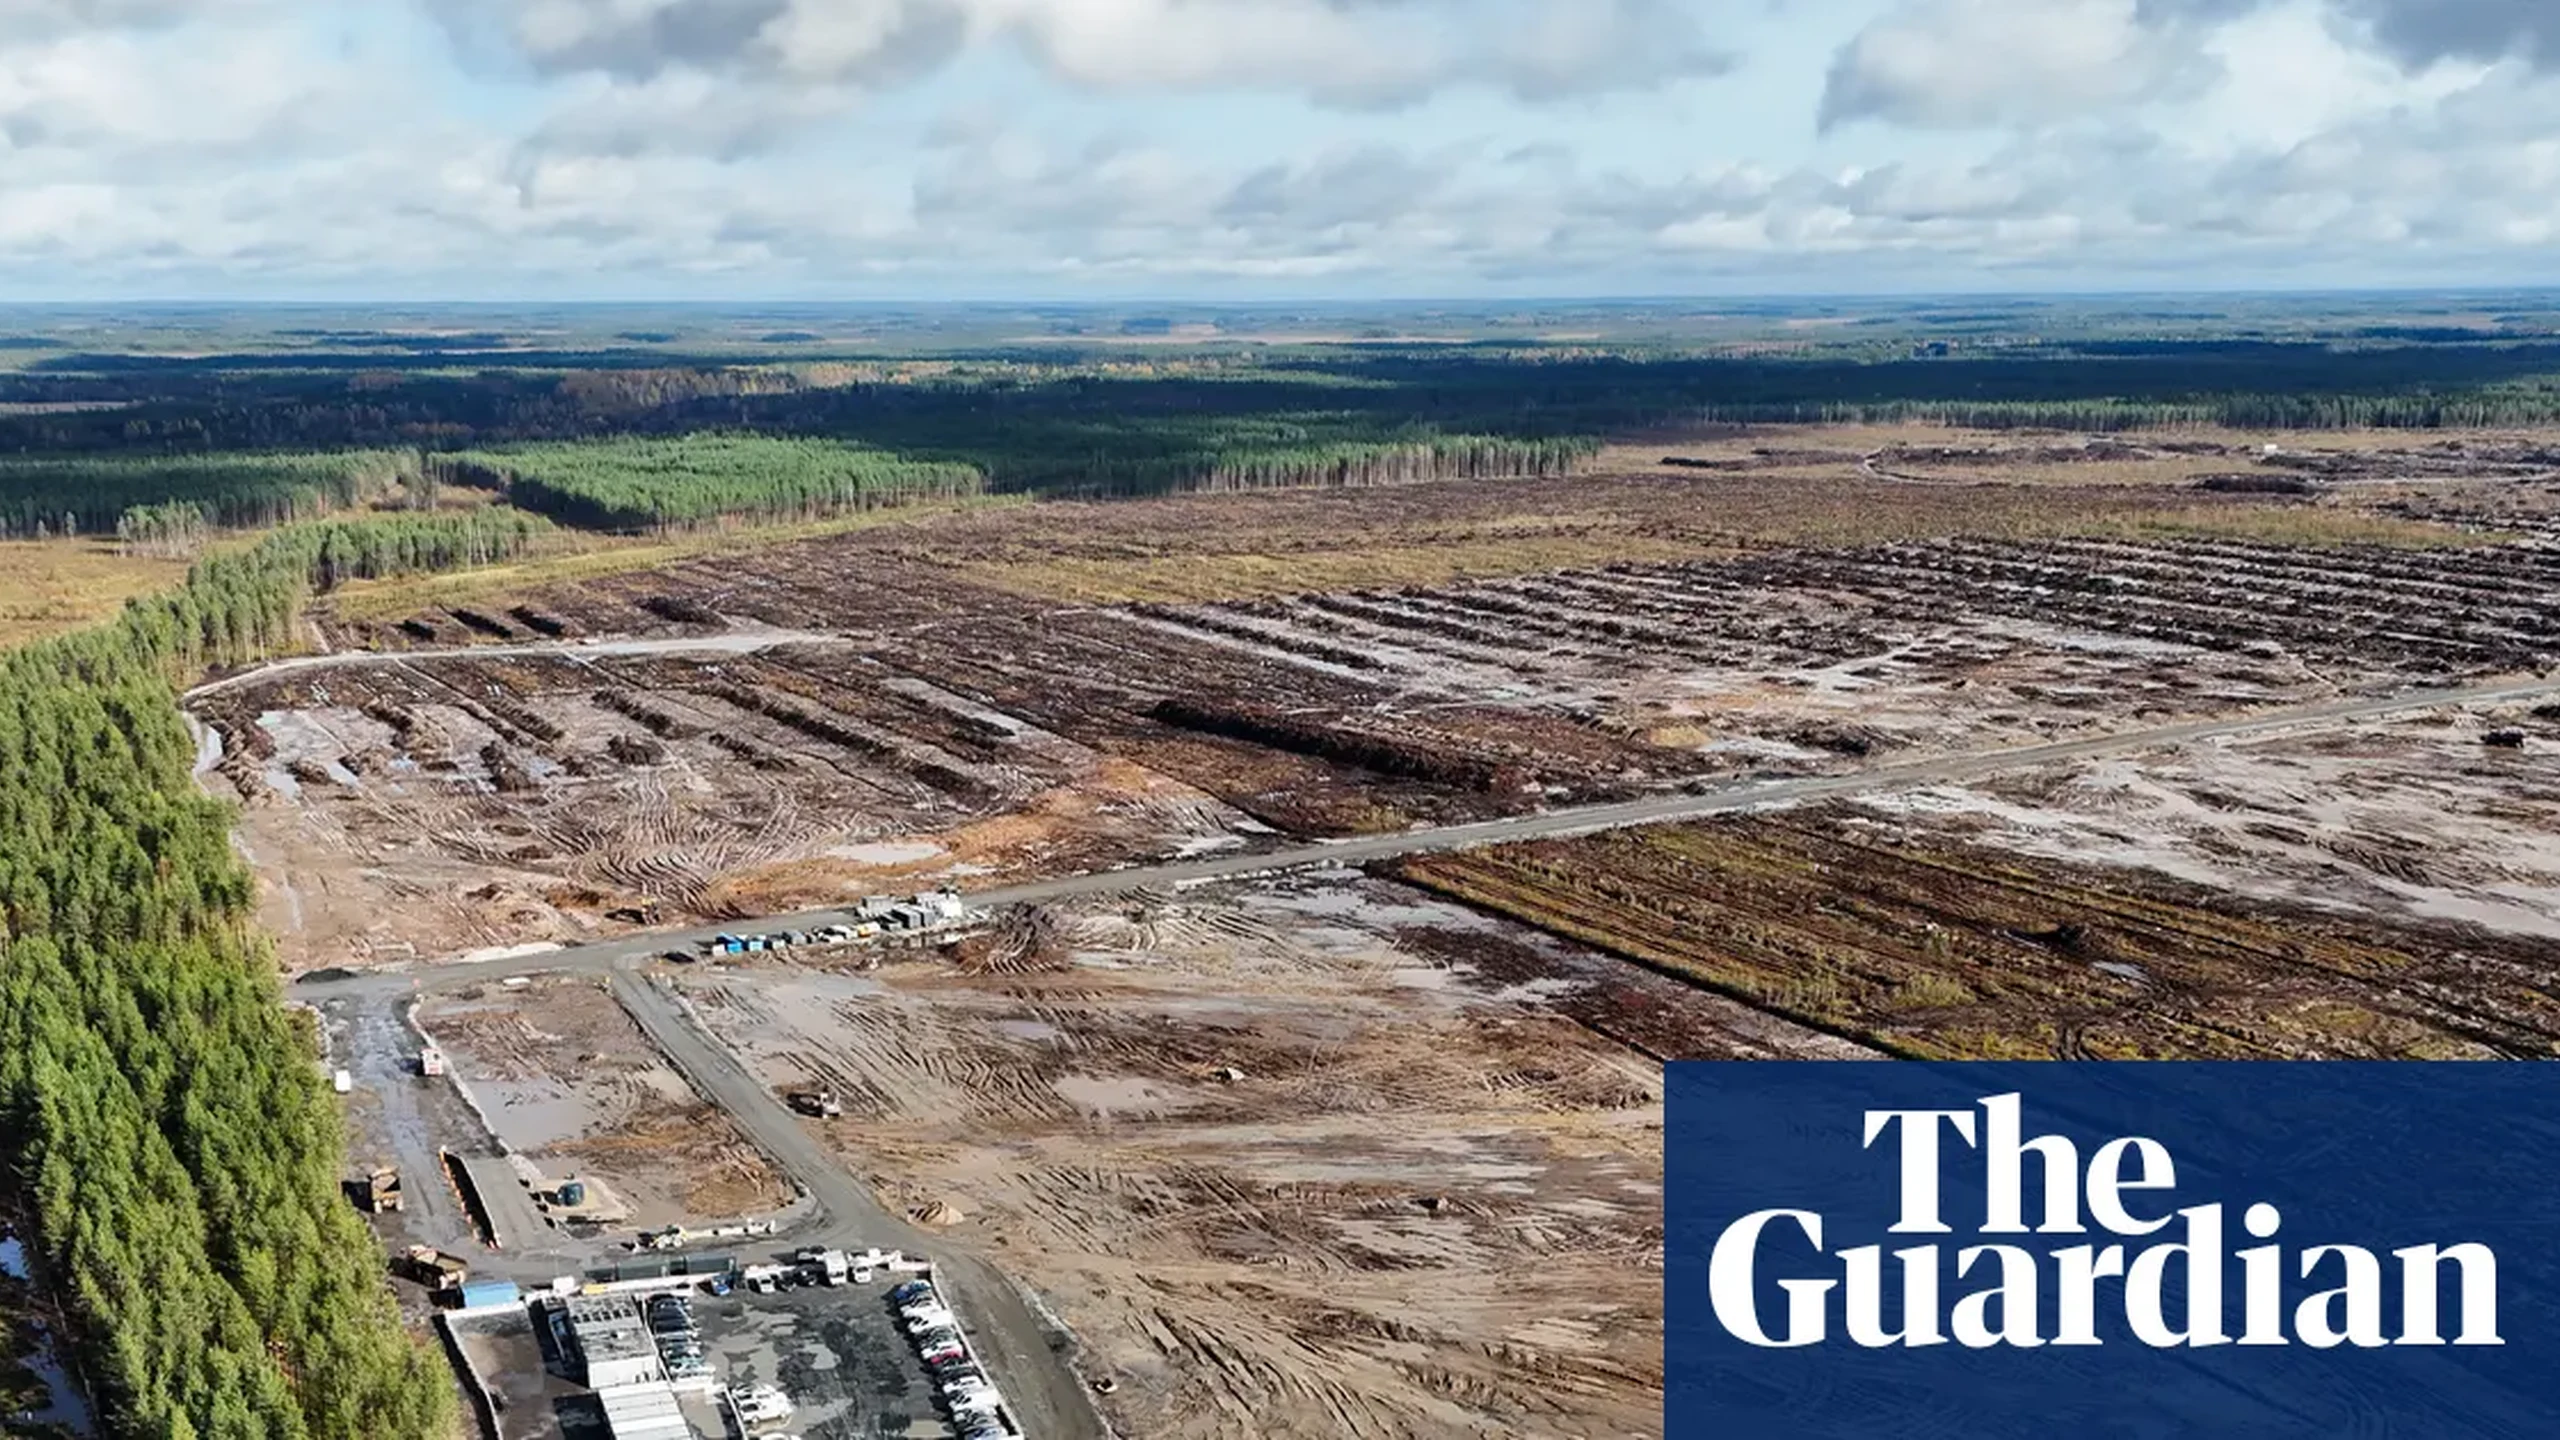
Google na Finlândia: terrenos, defesa e restauração em análise
A pausa atinge Muhos e Kajaani. €13bilhões, defesa florestal e130hectares de plantio não substituem avaliação.