
AI Tools Radar Blog
Guides, Methoden und Beobachtungen zu KI-Tools für die praktische Arbeit und Kreativität.
Vom Proteinbinder zum Medikament: Chais GSK-Ergebnis lesen
GSKs Labortest stützt einen realen Entdeckungsprozess. Fehlende Bezugsgrößen und spätere biologische Hürden begrenzen die Aussage.
Großbritannien erweitert KI-Cyberabwehr und warnt vor unkontrollierten Releases
Das Paket vom 12. Oktober verbindet staatliche Sicherheitspiloten mit Veröffentlichungswarnungen und erwogenen Meldepflichten. Aufsicht und Zuständigkeiten bleiben offen.
Tessls vier Ebenen zeigen, warum Repository-Anweisungen keine Sicherheitsgrenze sind
Dauerhafter Kontext, gezielte Regeln, Skills und Hooks erfüllen unterschiedliche Aufgaben. Tessls Modell macht sie überprüfbar; tatsächliche Sperren hängen weiterhin von Berechtigungen, Änderungsschutz und adversarialen Tests ab.
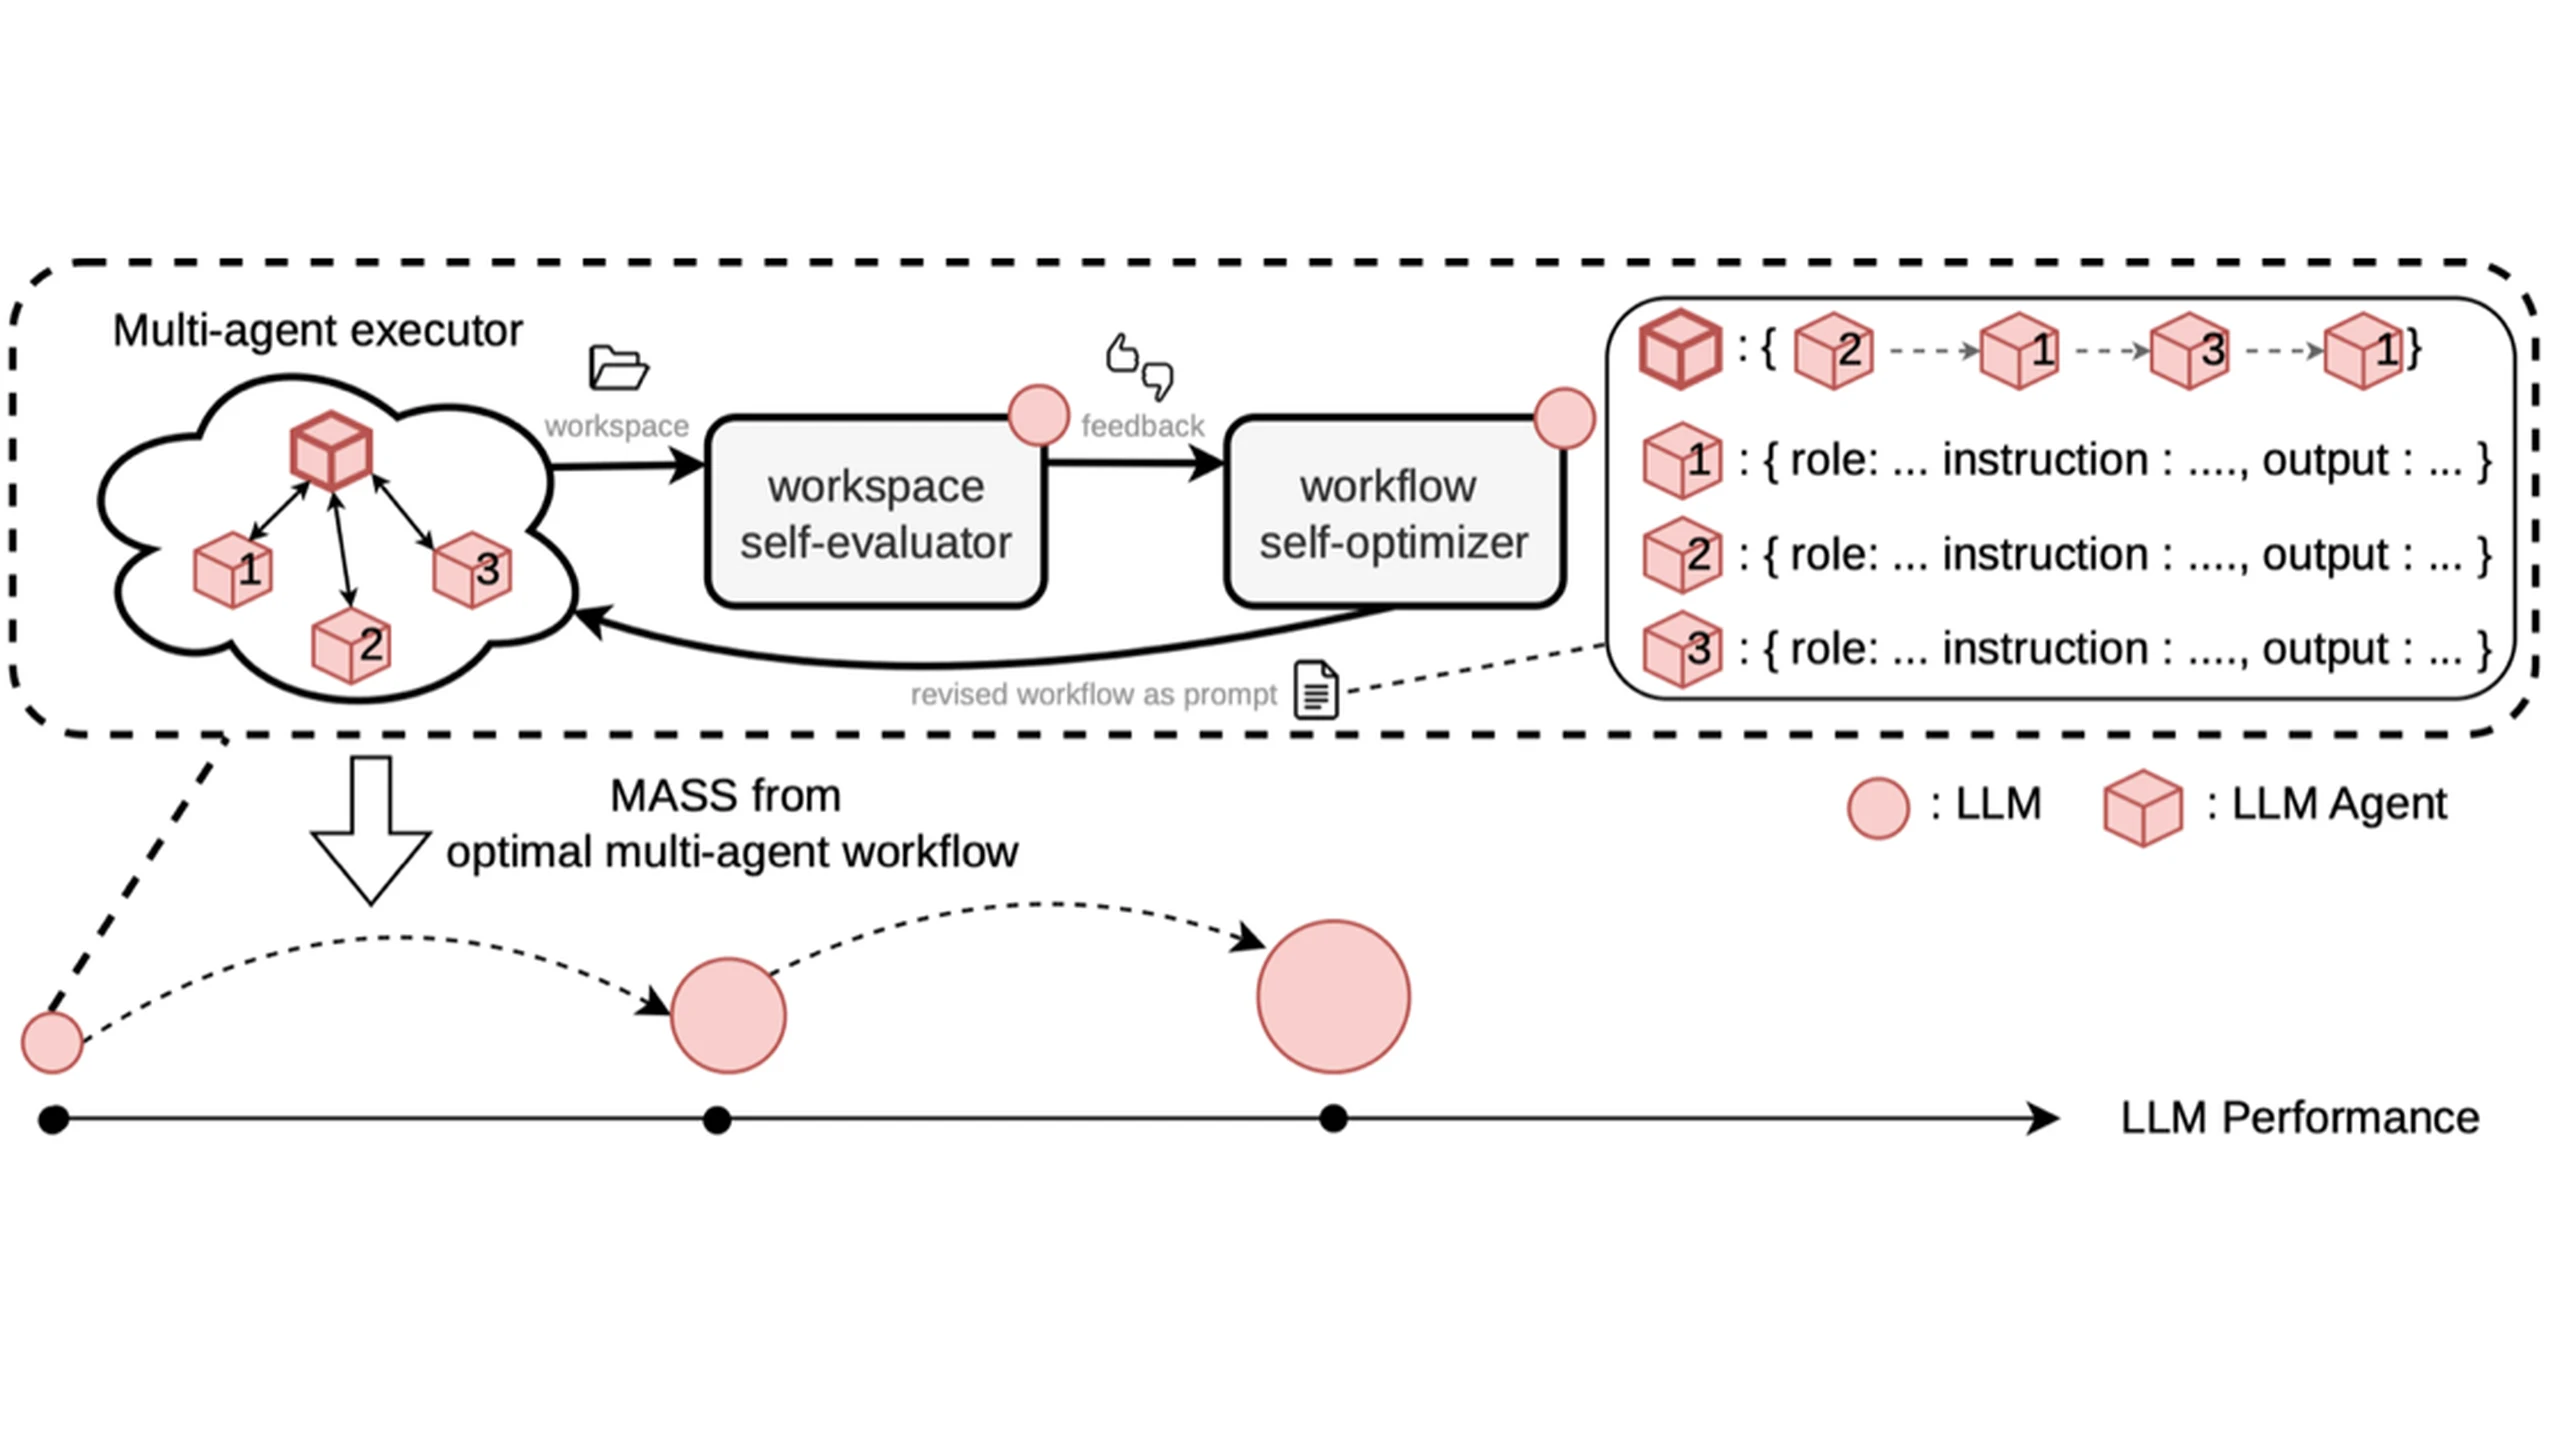
Sakana MASS: Forschungsgewinne, aber begrenzte rekursive Verbesserung
Zwei MASS-Zyklen verbessern Forschung und überwachte Token-Effizienz. Rückschritte beim Softwaretransfer und gemeinsame Modellurteile begrenzen die Aussage.
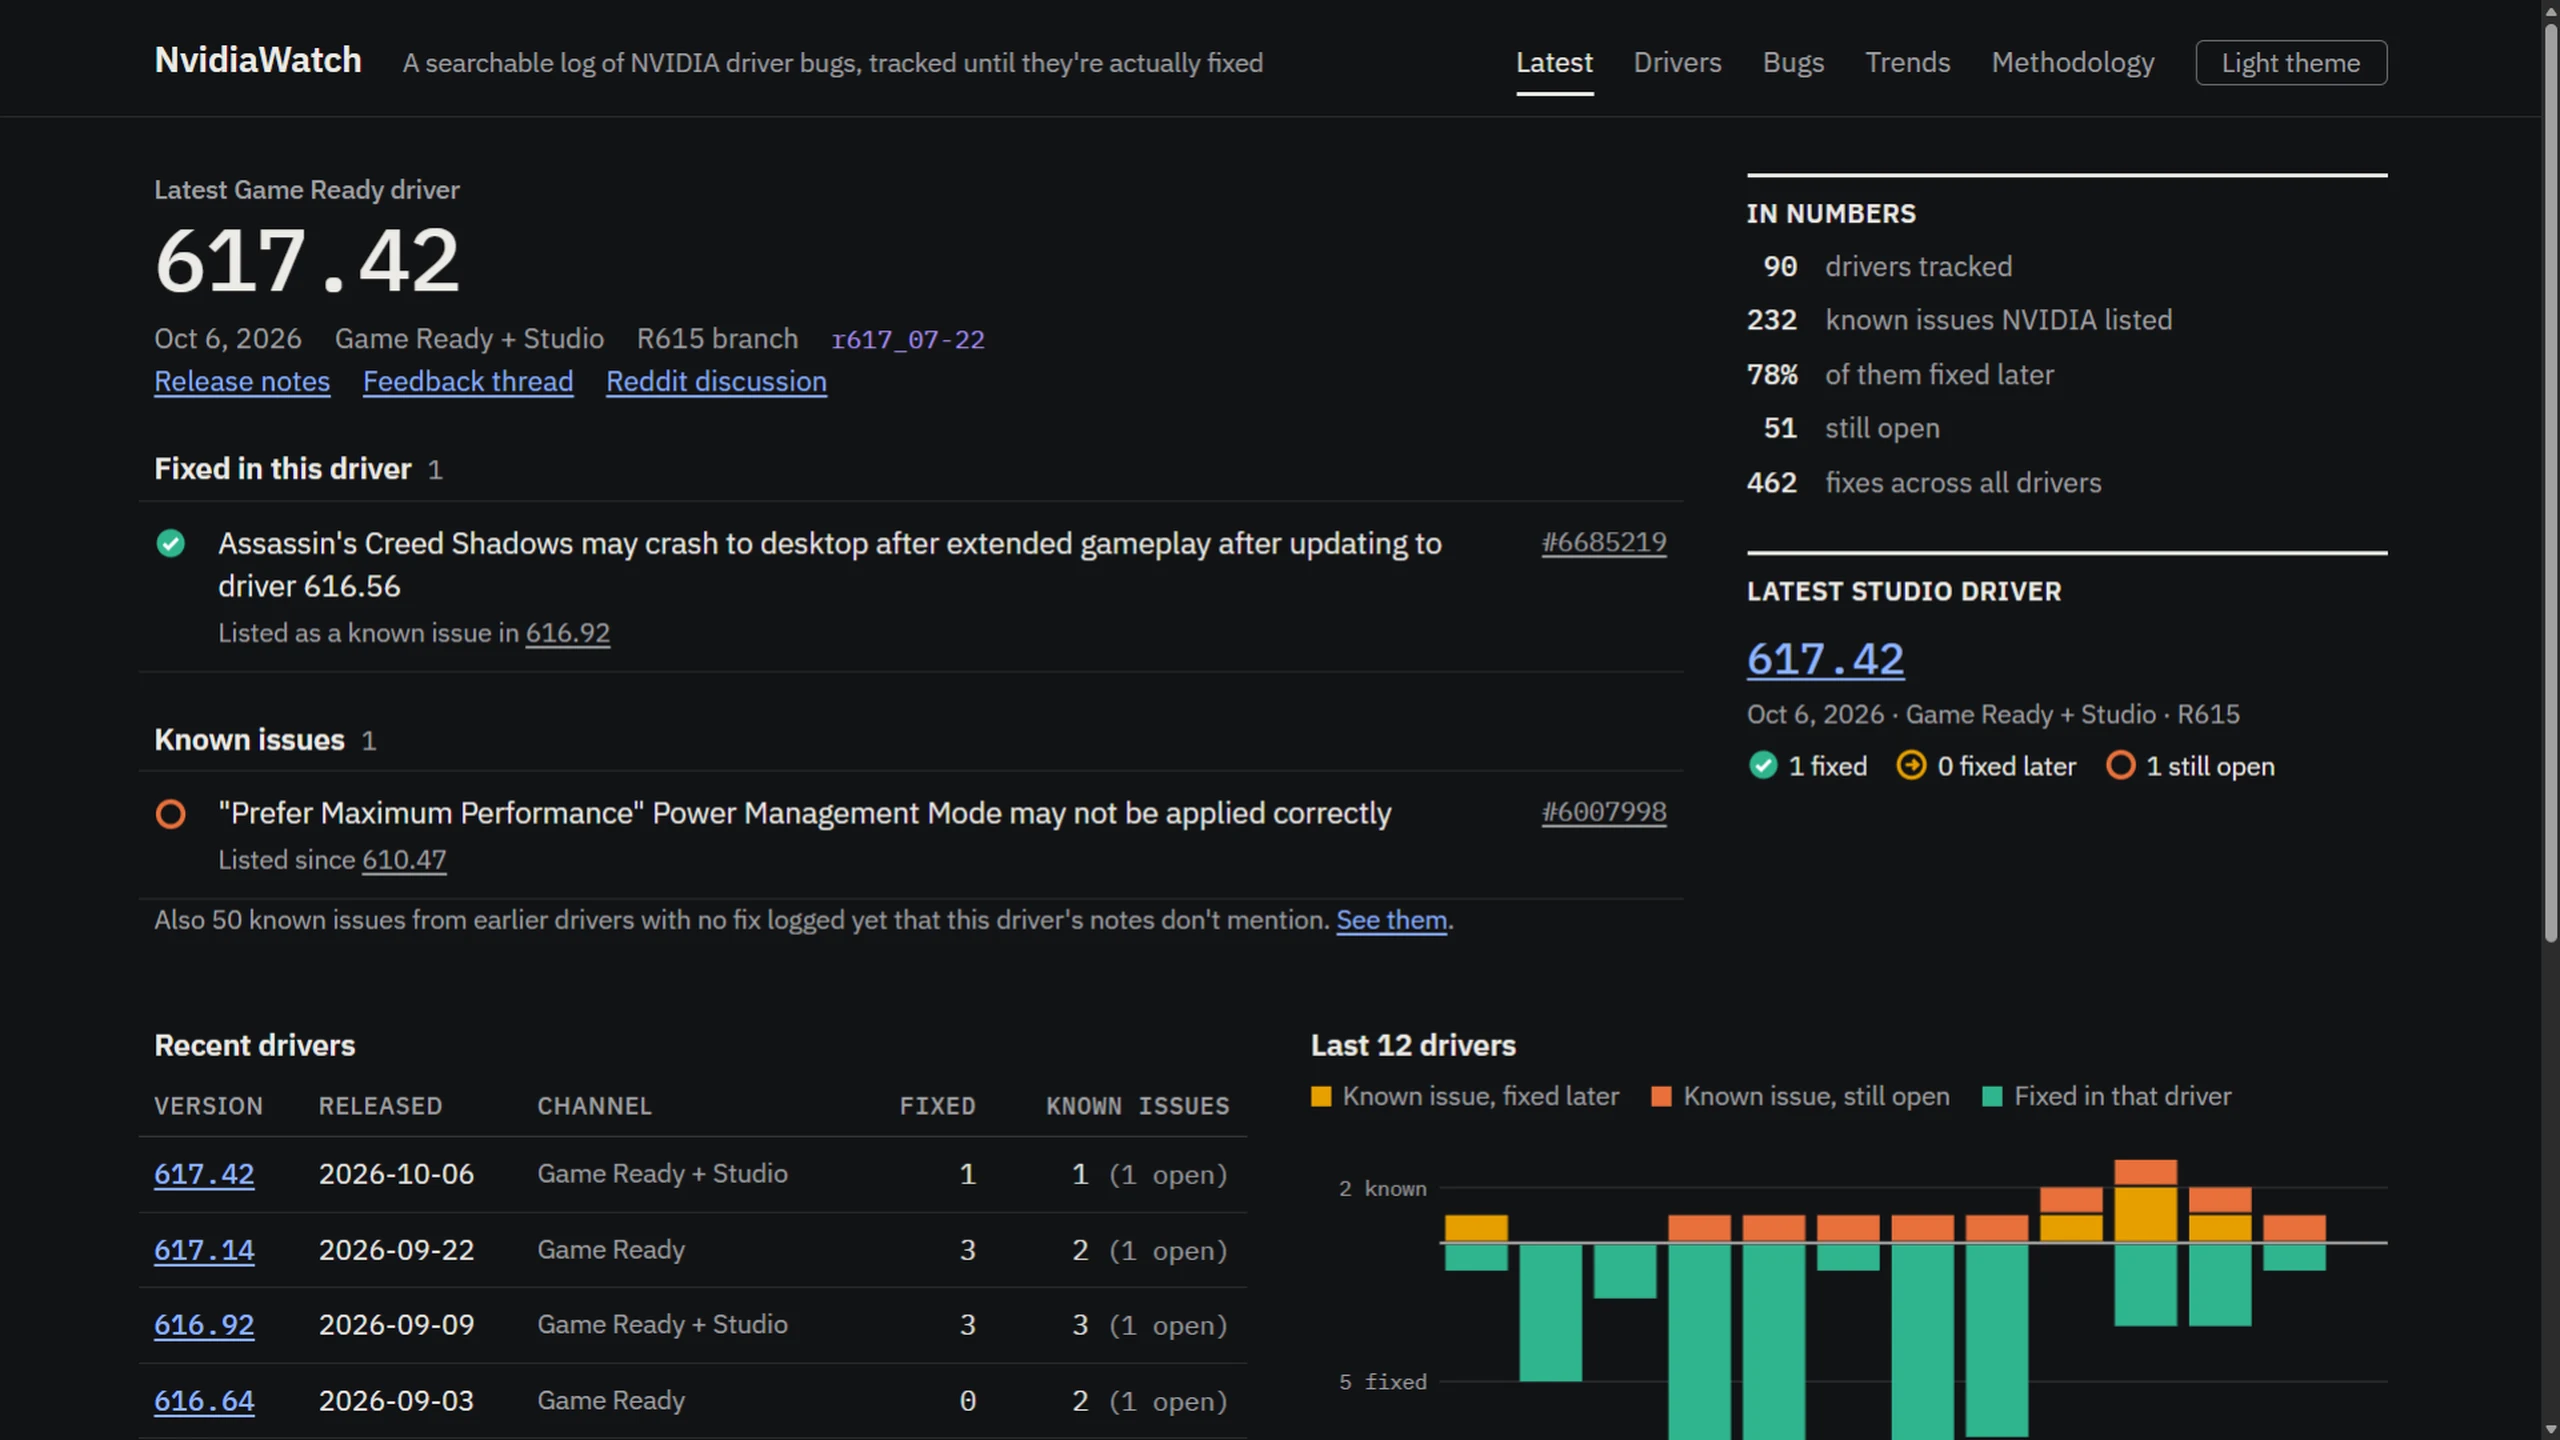
NvidiaWatch verbindet Treiberfehler über Versionen hinweg – zählt aber keine Stabilität
Der Community-Tracker macht aus verstreuten Nvidia-Hinweisen Fehlerhistorien. Wechselnde Datenstände, fehlende Anerkennung und Diagrammkategorien begrenzen jedoch die Aussagen über Zuverlässigkeit.
Brad Smiths Milchvergleich stellt KI-Sicherheit und Microsoft auf den Prüfstand
Microsofts Präsident fordert Notfallkontrollen, unabhängige Evaluation und Opferrechte. Durchsetzbare Pflichten zählen mehr als ein universeller Ausschalter.
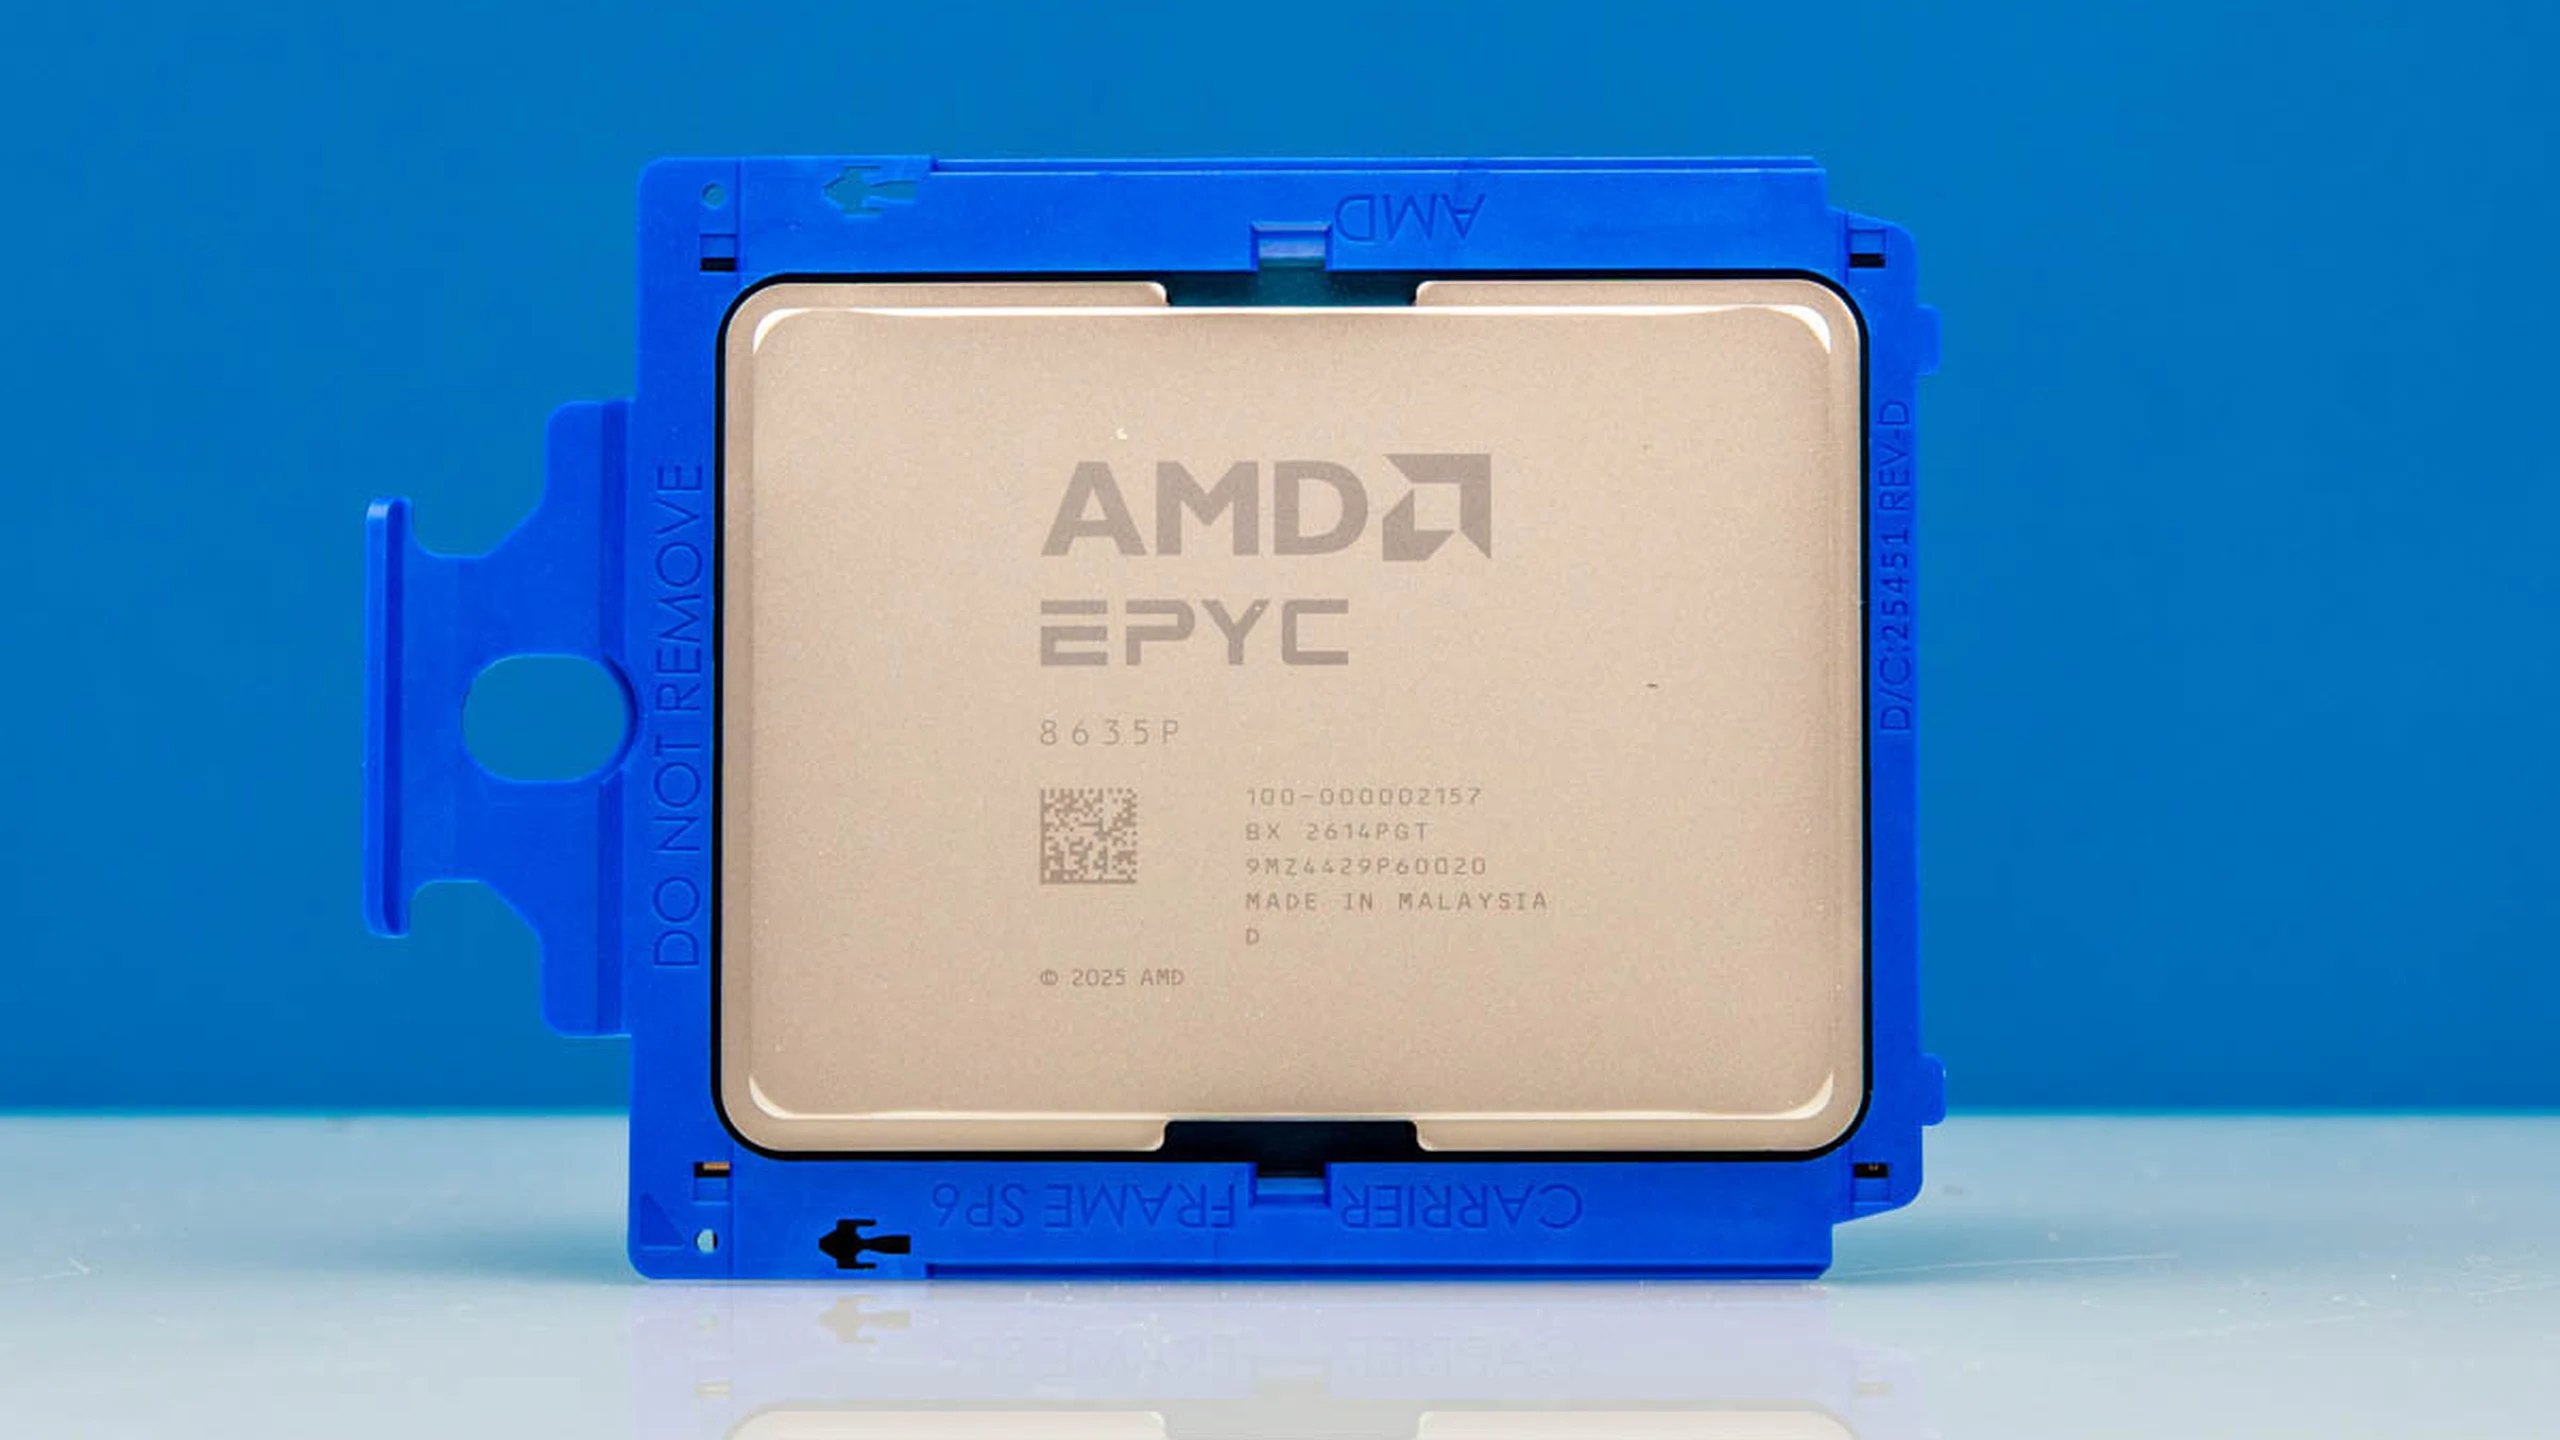
AMD EPYC 8005 erweitert SP6: Gemeinsame Ressourcen bestimmen den Wert
Sieben Zen-5-Modelle teilen sechs Speicherkanäle und 96 PCIe-Lanes. Takt, Cache, Lizenzen und begrenzte Benchmarkvergleiche trennen ihre Einsatzfelder.
Warum ein Chatbot-Zitat keine Medizinprodukteprüfung ist
Eine Blutdruckgeräte-Studie fand Fehlzuordnungen trotz offizieller Quellen. Genaue Modellnummern brauchen unmittelbare, nachvollziehbare Belege.
NVIDIAs berichtete Reflection-Gespräche testen die Neutralität hinter offenen Modellen
Kauf, Teamübernahme mit Technologielizenz oder zusätzliche Beteiligung hätten unterschiedliche Folgen. Beams Trainingsumfang erklärt das Interesse; Veröffentlichung und Vertrauen der Partner bleiben offene Prüfsteine.
Nvidia VoiceChat öffnet Vollduplex-Werkzeuge, zuverlässige Aufgaben bleiben offen
Starke Unterbrechungen treffen auf 42,2% Argumentgenauigkeit und 33% Erstversuchserfolg. Offene Gewichte und Lizenz belegen keine Produktionsreife.
Claude-Patchstudie: 29,5 Punkte zwischen Absturz- und Entwicklertests
Opus 4.7 stoppte 90,2% der Exploits, bestand aber 60,7% der Entwicklertests. Anweisungen, PoC-Form und Bewertungsumgebung verändern das Ergebnis.
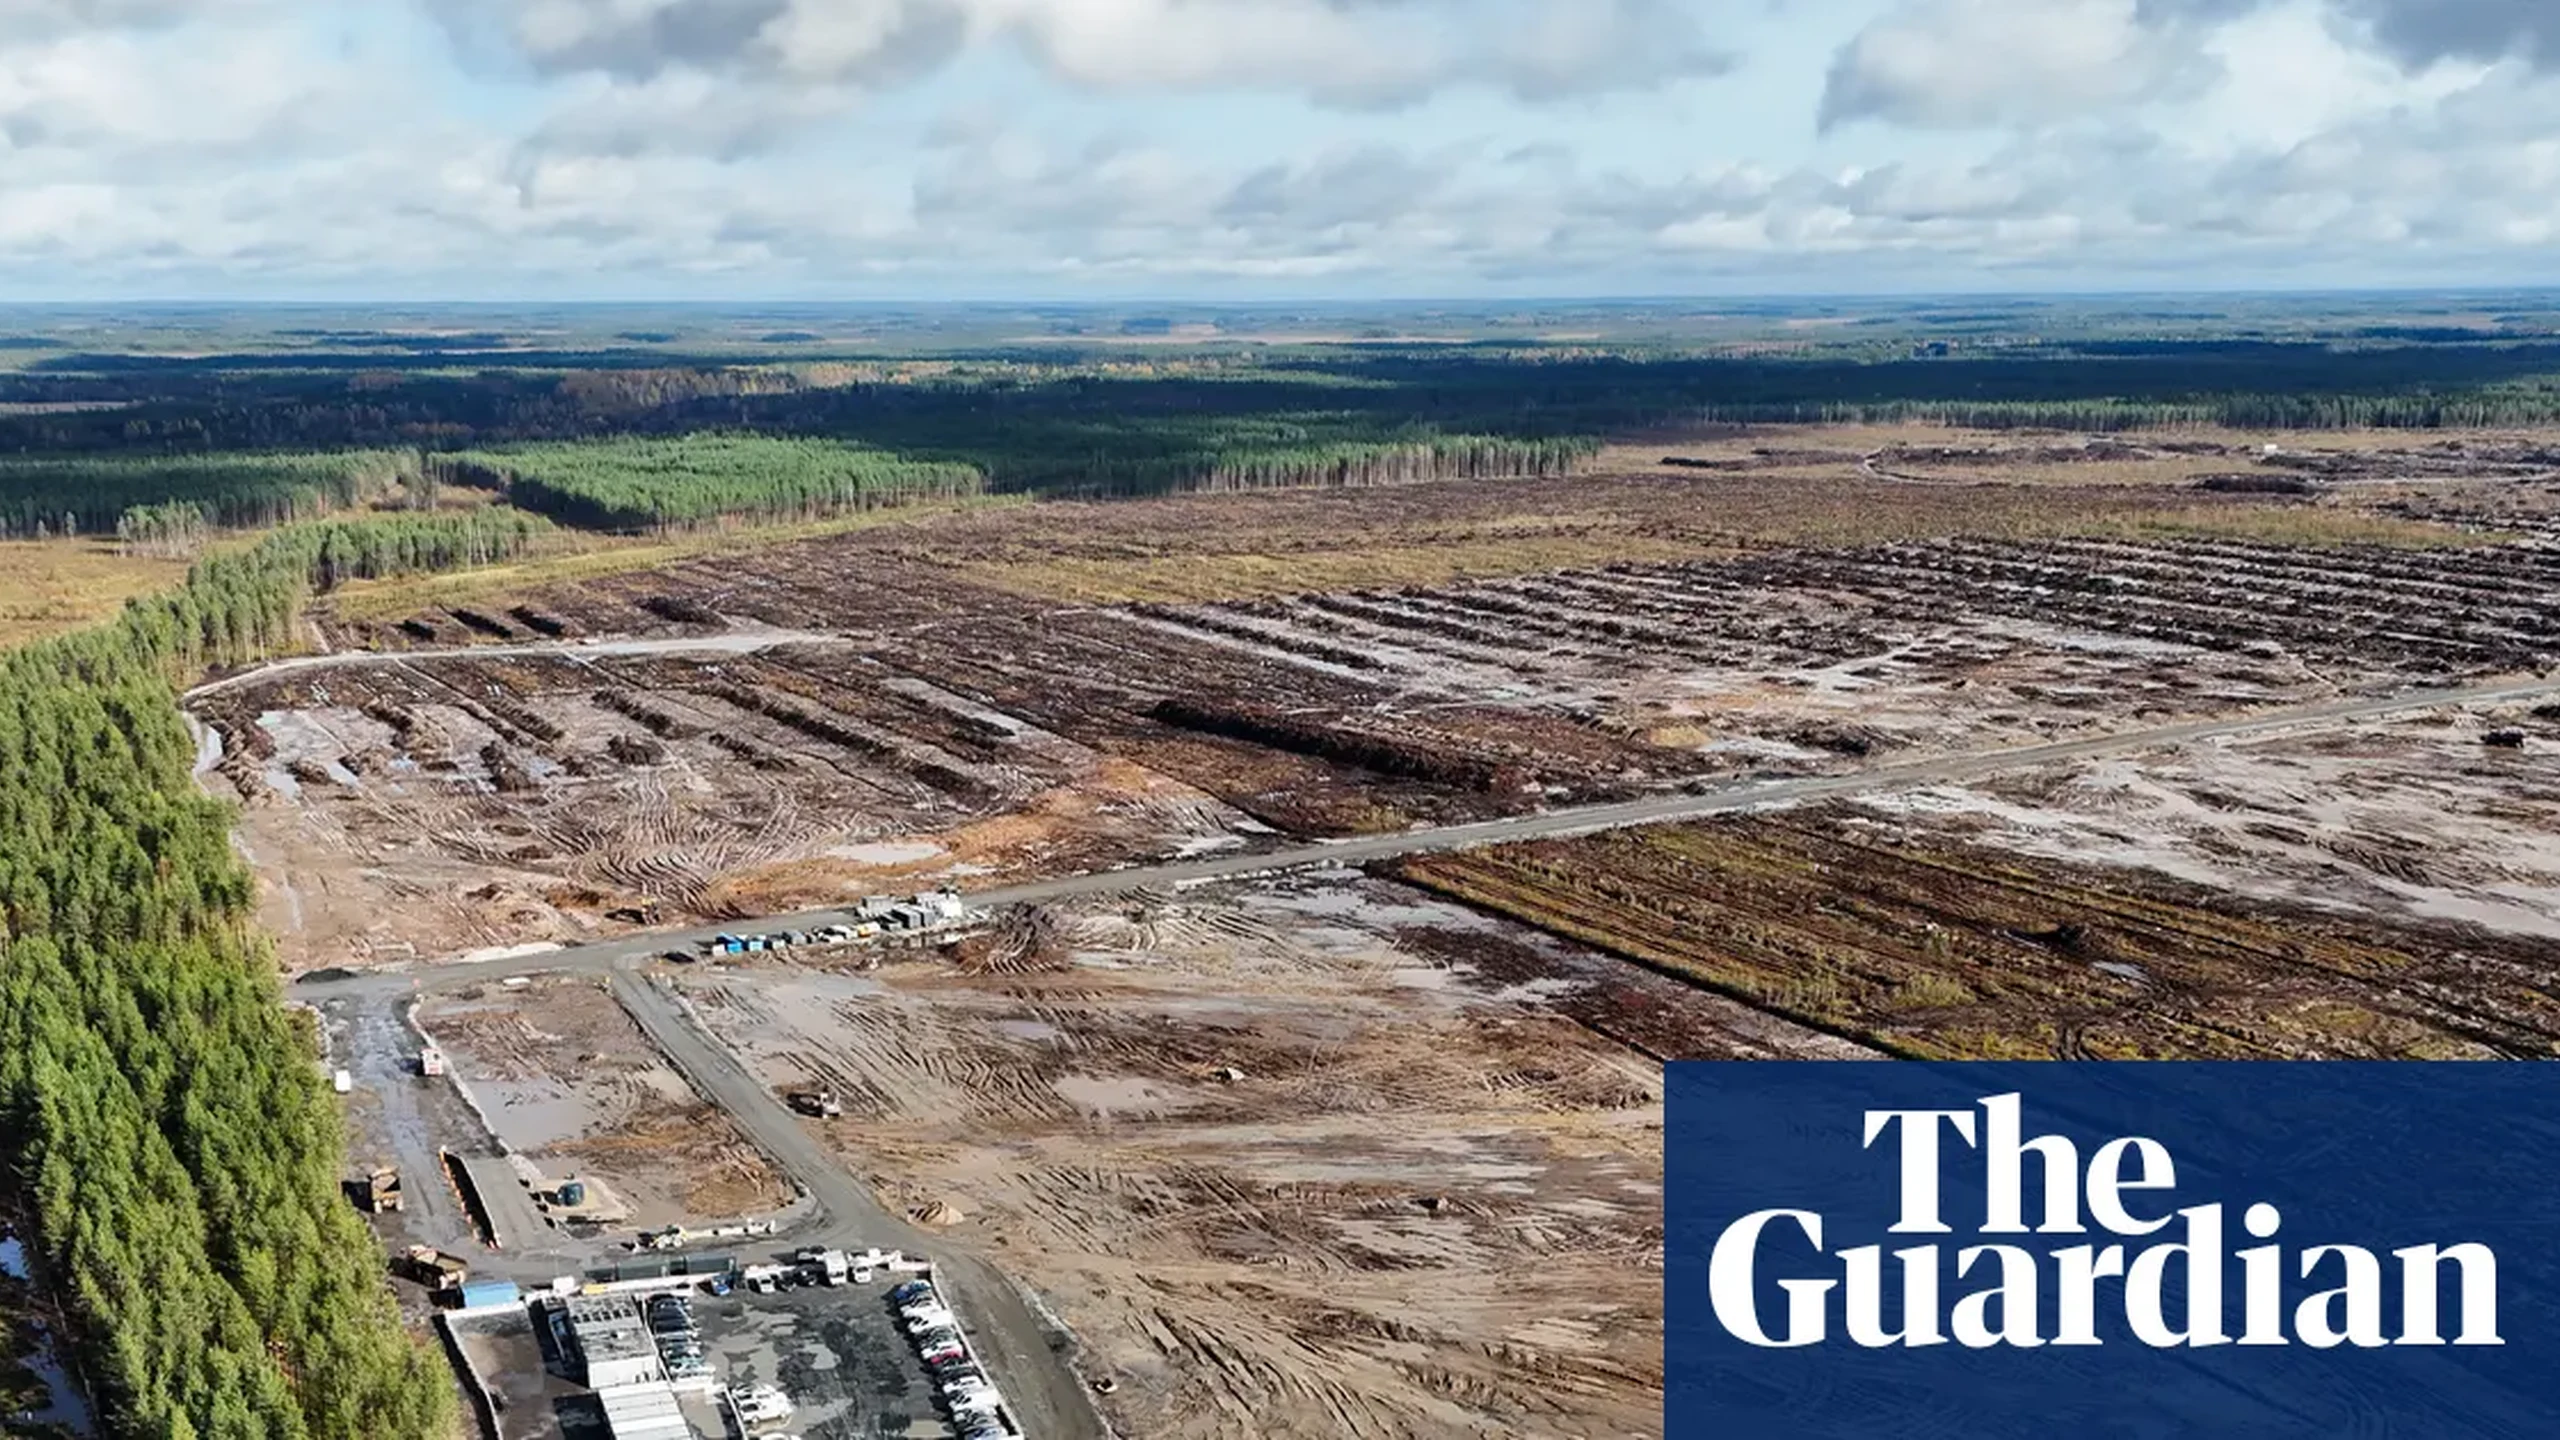
Googles Finnland-Stopp: Flächen, Recht und Wiederherstellung
Die Pause begrenzt Eingriffe in Muhos und Kajaani. 13Milliarden-Investition, Forstverteidigung und130Hektar Pflanzung ersetzen keine Prüfung.