
Blog AI Tools Radar
Poradniki, metody i obserwacje dotyczące narzędzi AI w codziennej pracy i twórczości.
Od wiążącej cząsteczki do leku: jak czytać wynik Chai i GSK
Test GSK potwierdza rzeczywiste zastosowanie odkrywcze. Brak mianowników i dalsze bariery biologiczne określają jednak zakres dowodów.
Wielka Brytania rozszerza cyberobronę AI i ostrzega laboratoria
Pakiet z 12 października łączy pilotaże państwowe, ostrzeżenia przed premierą i rozważane raportowanie. Progi prawne oraz nadzór wymagają konkretów.
Cztery warstwy Tessl pokazują, dlaczego instrukcja w repozytorium nie jest granicą bezpieczeństwa
Stały kontekst, reguły zakresowe, skills i hooki mają inne zadania. Model Tessl ułatwia ich przegląd, ale realne blokowanie zależy od uprawnień, ochrony przed zmianami i testów przeciwnika.
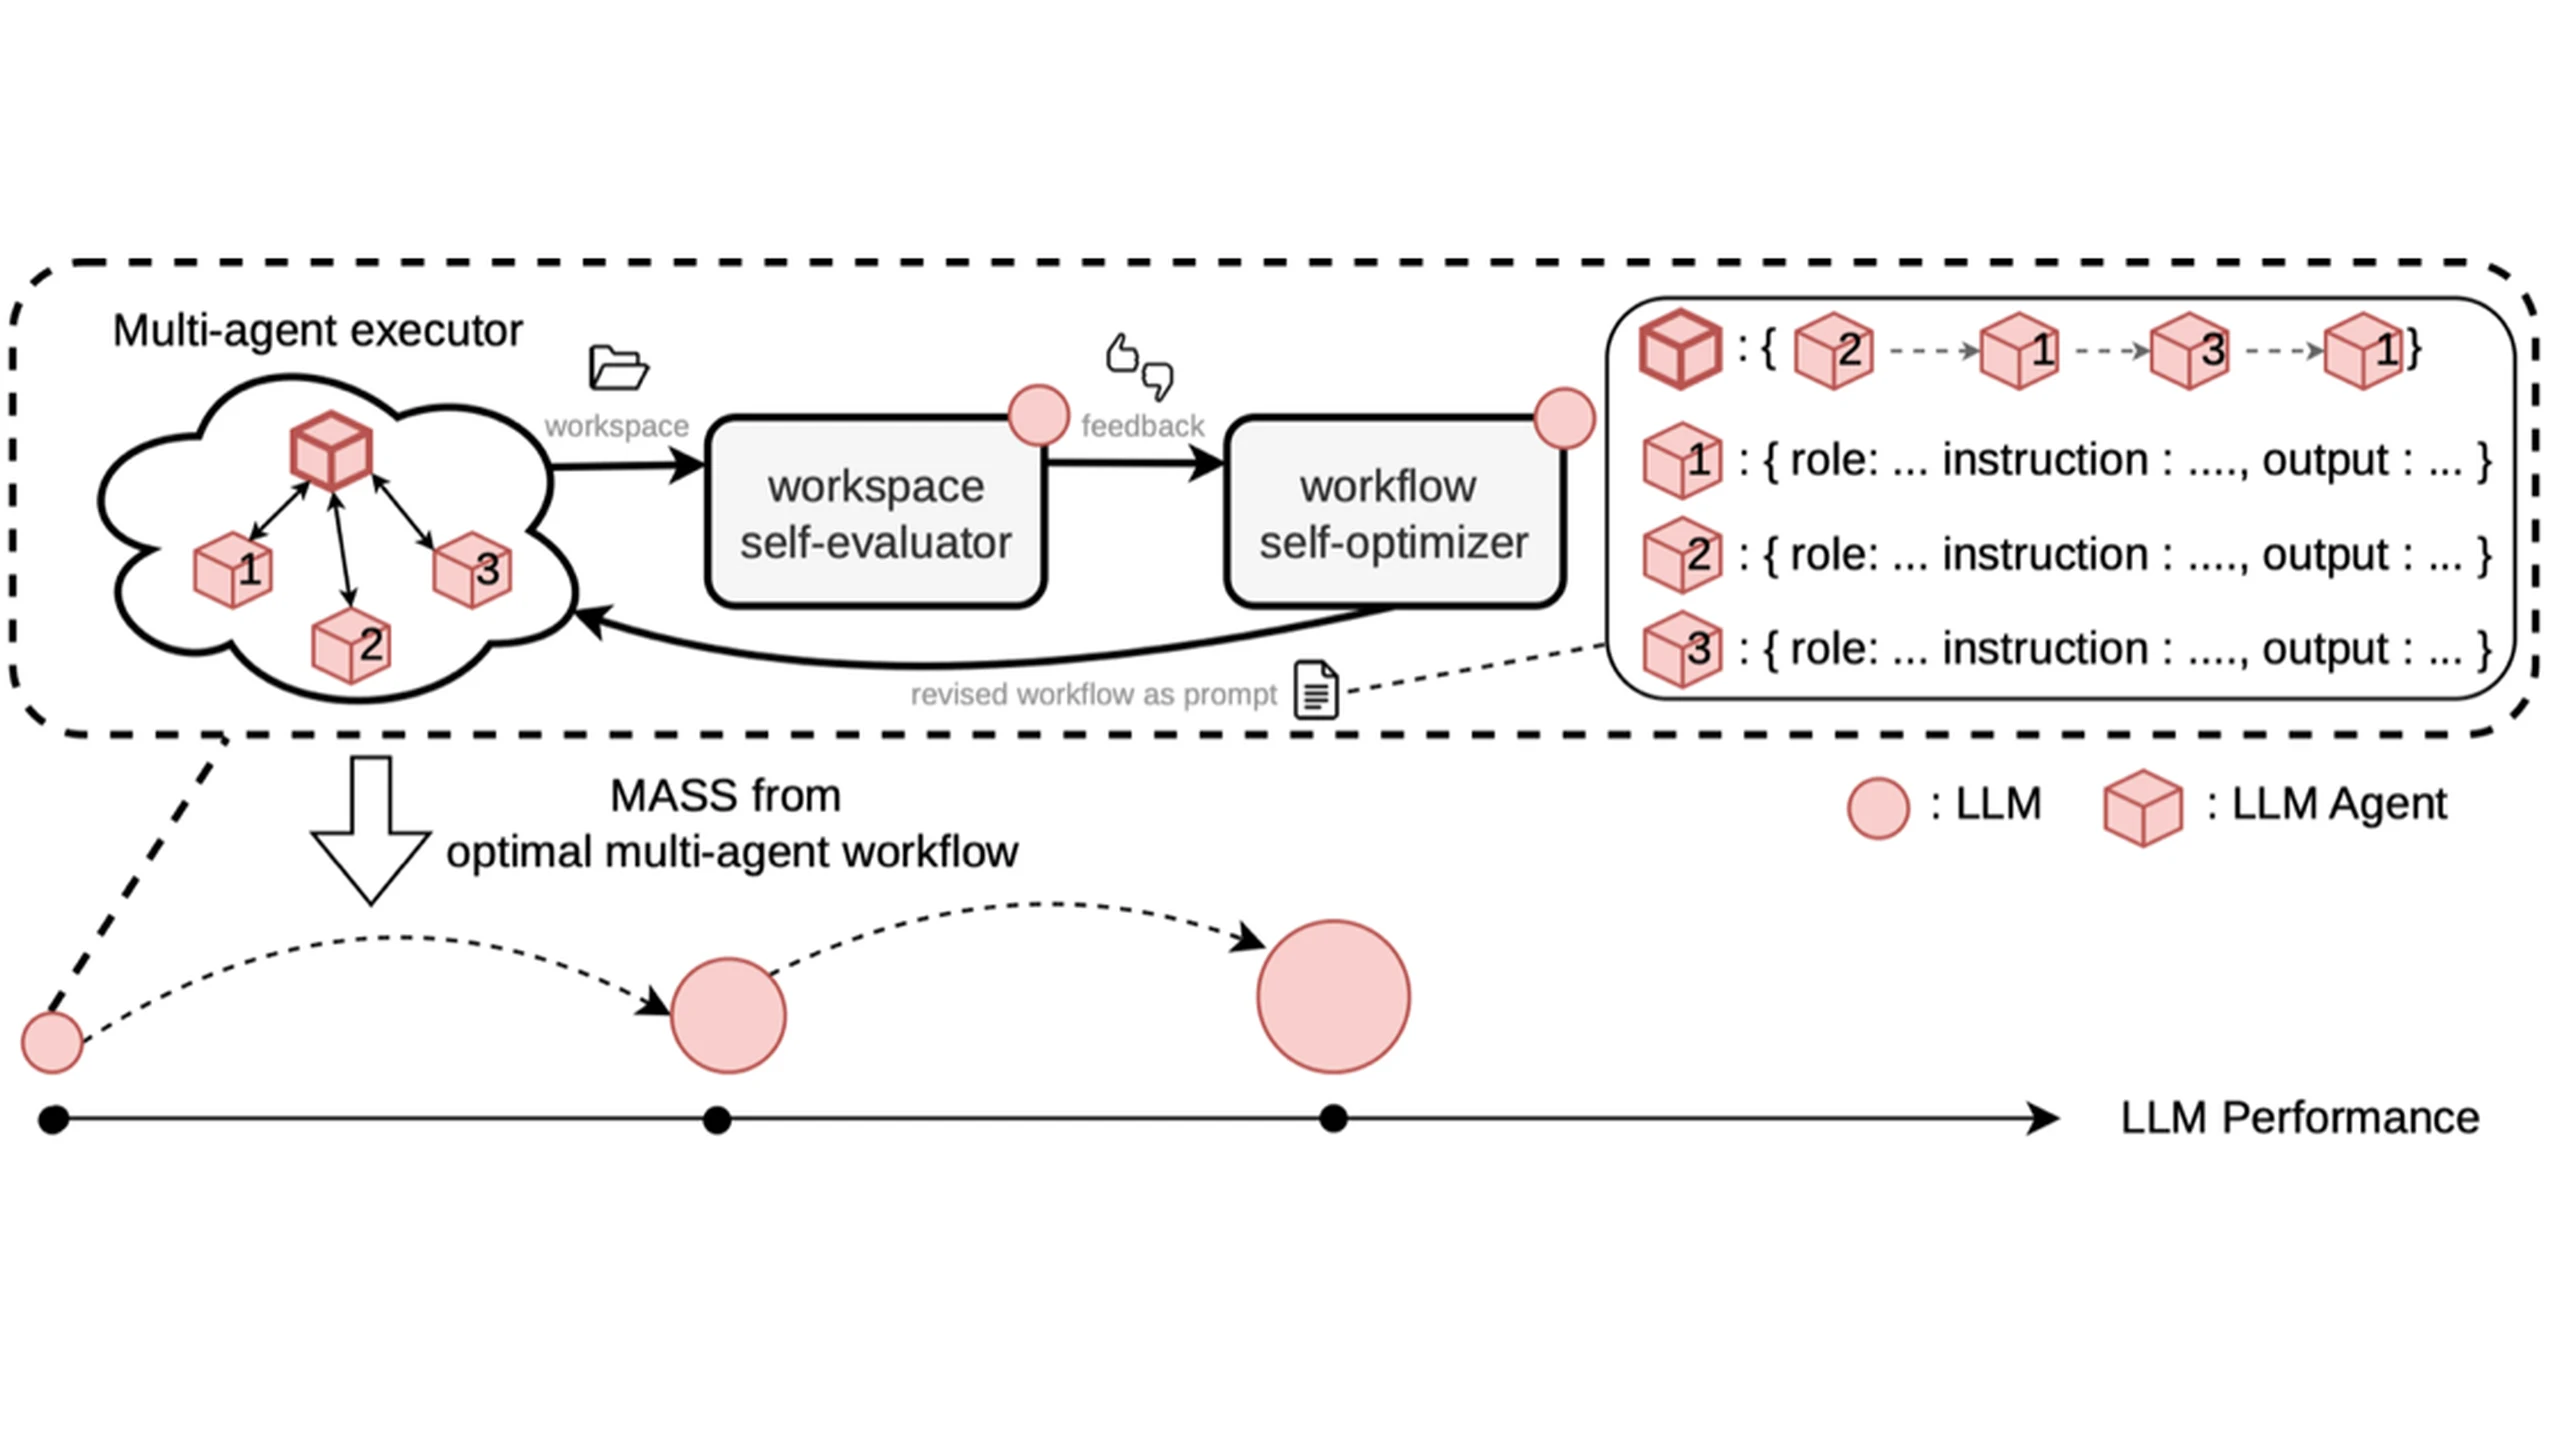
Sakana MASS poprawia badania, lecz rekurencyjna nauka ma granice
Dwa cykle MASS poprawiają wyniki i liczbę tokenów nadzorowanych, ale transfer do oprogramowania słabnie, a wspólne oceny modeli utrudniają nadzór.
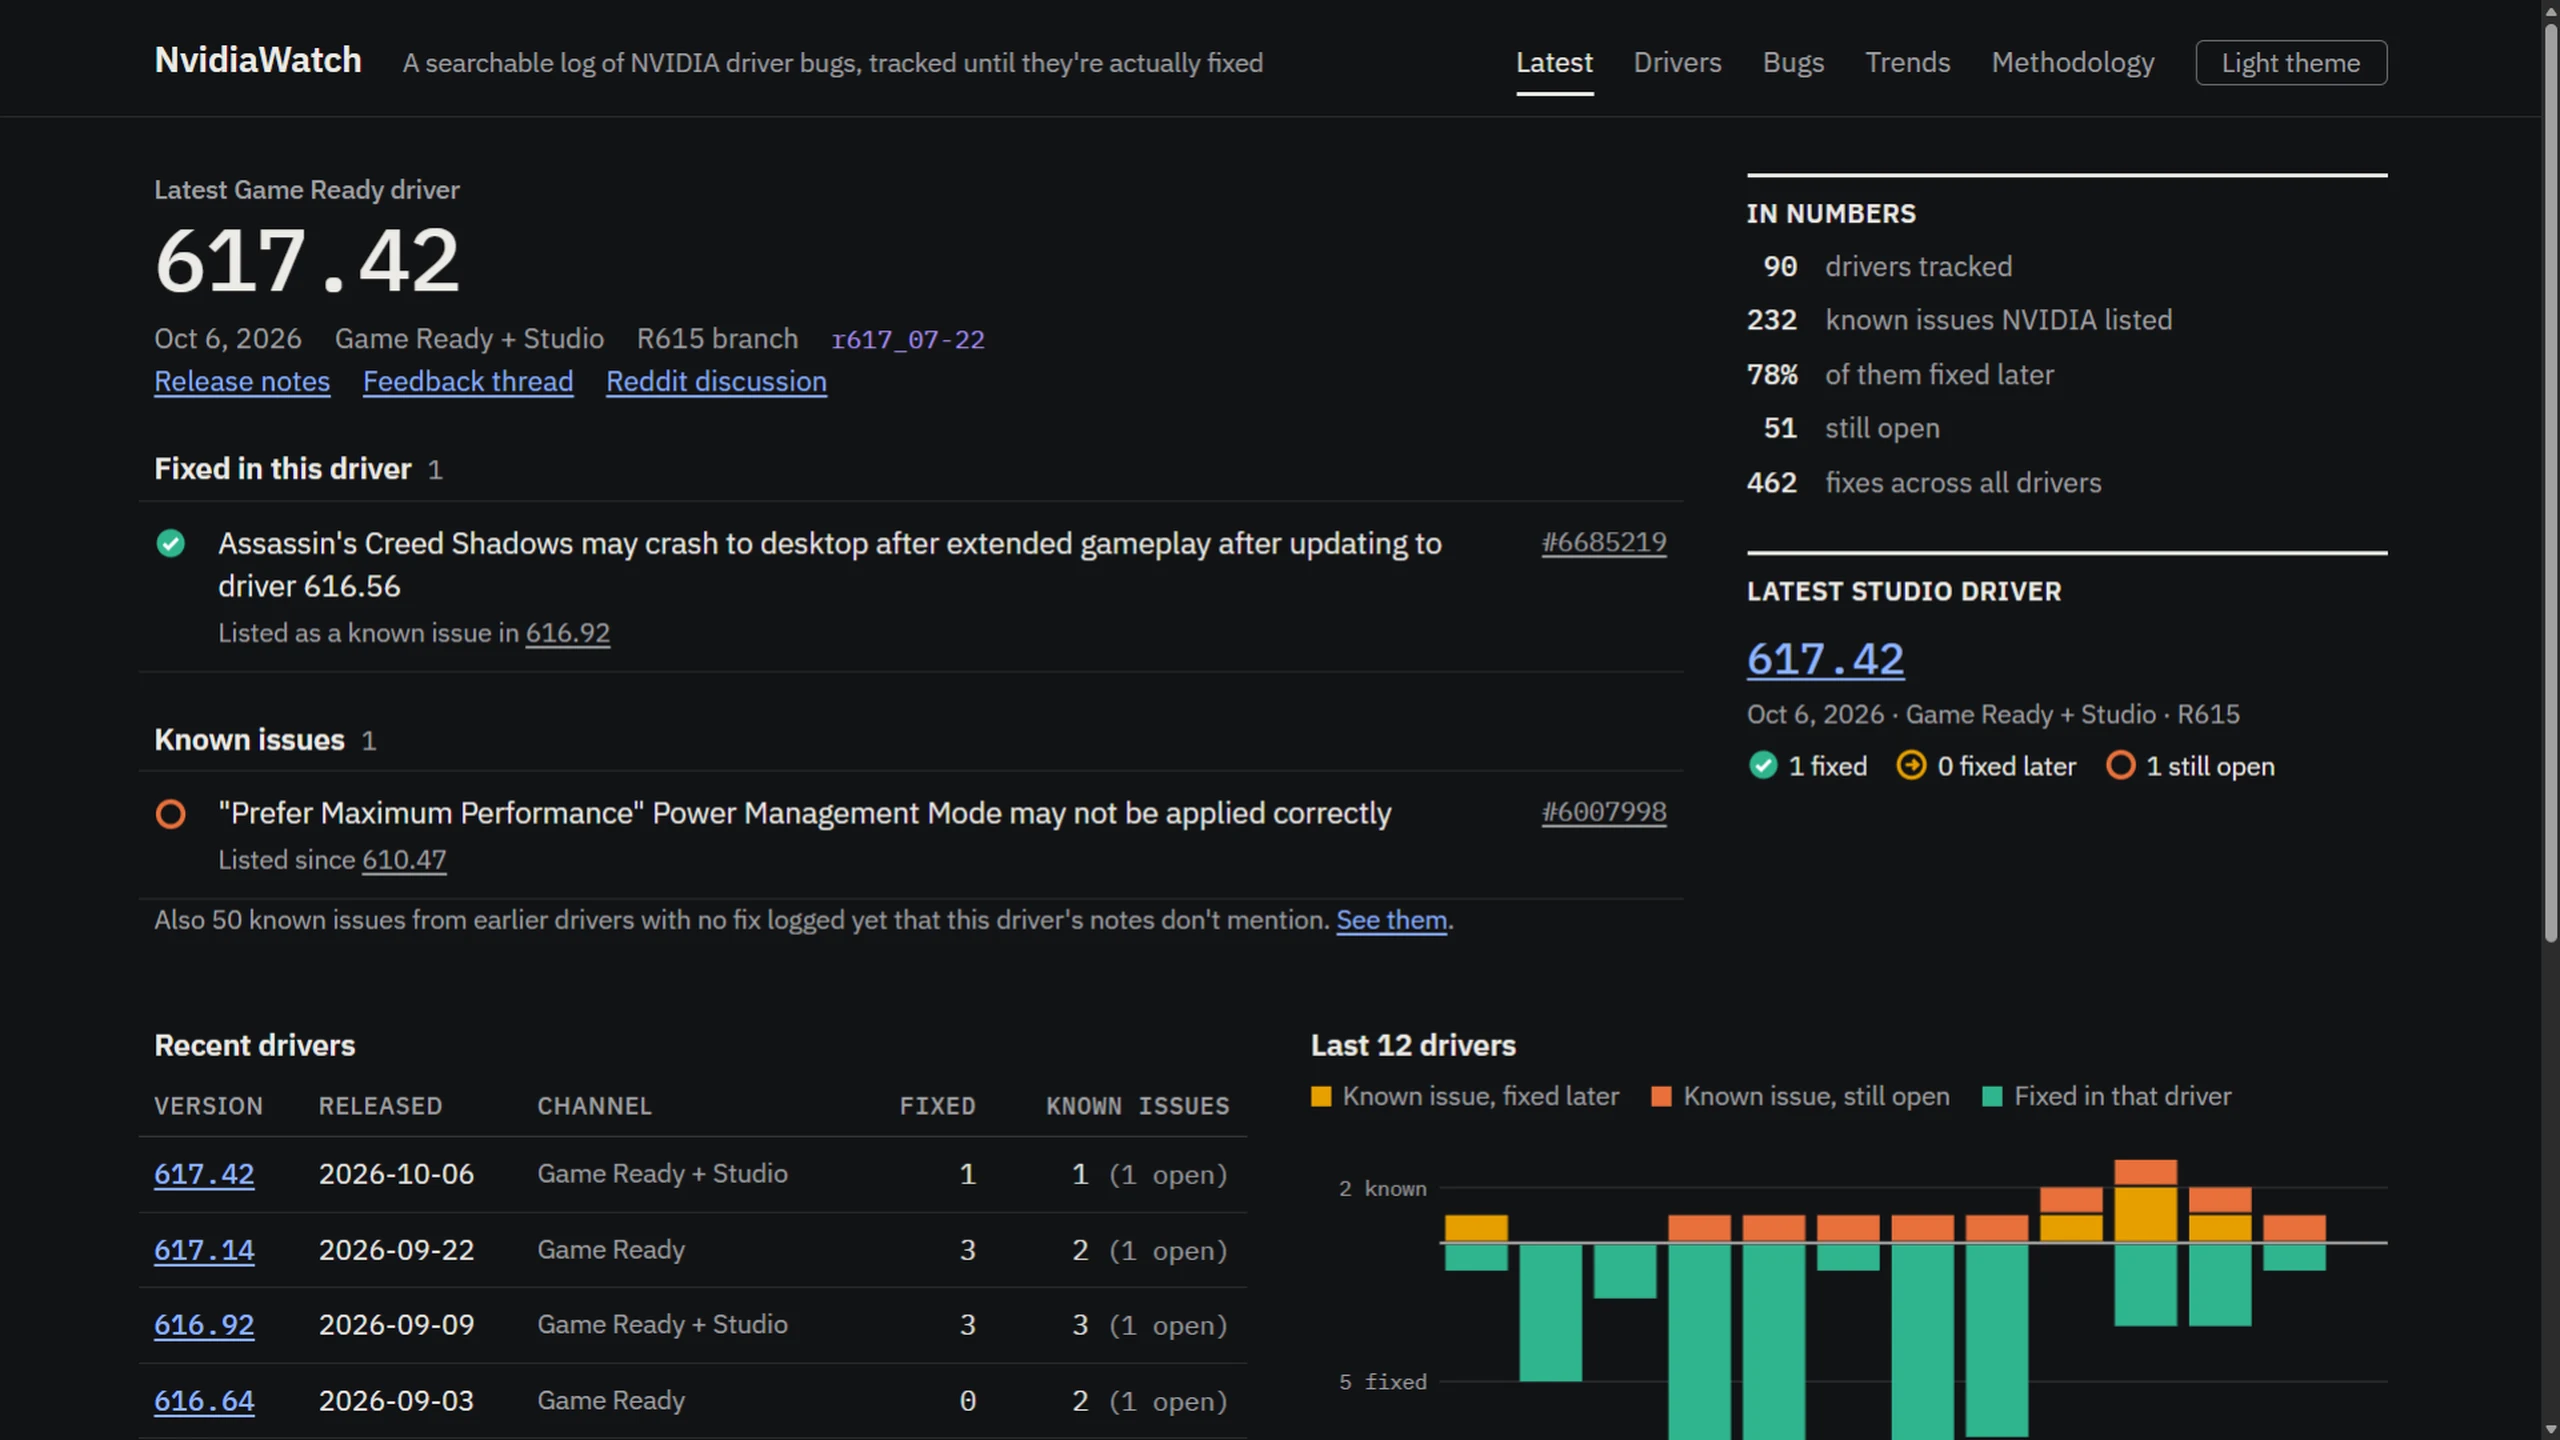
NvidiaWatch łączy historię błędów sterowników, ale liczby nie mierzą stabilności
Społecznościowy indeks spaja rozproszone informacje Nvidii. Zmienne migawki, nieuznane problemy i kategorie wykresów ograniczają jednak wnioski o niezawodności.
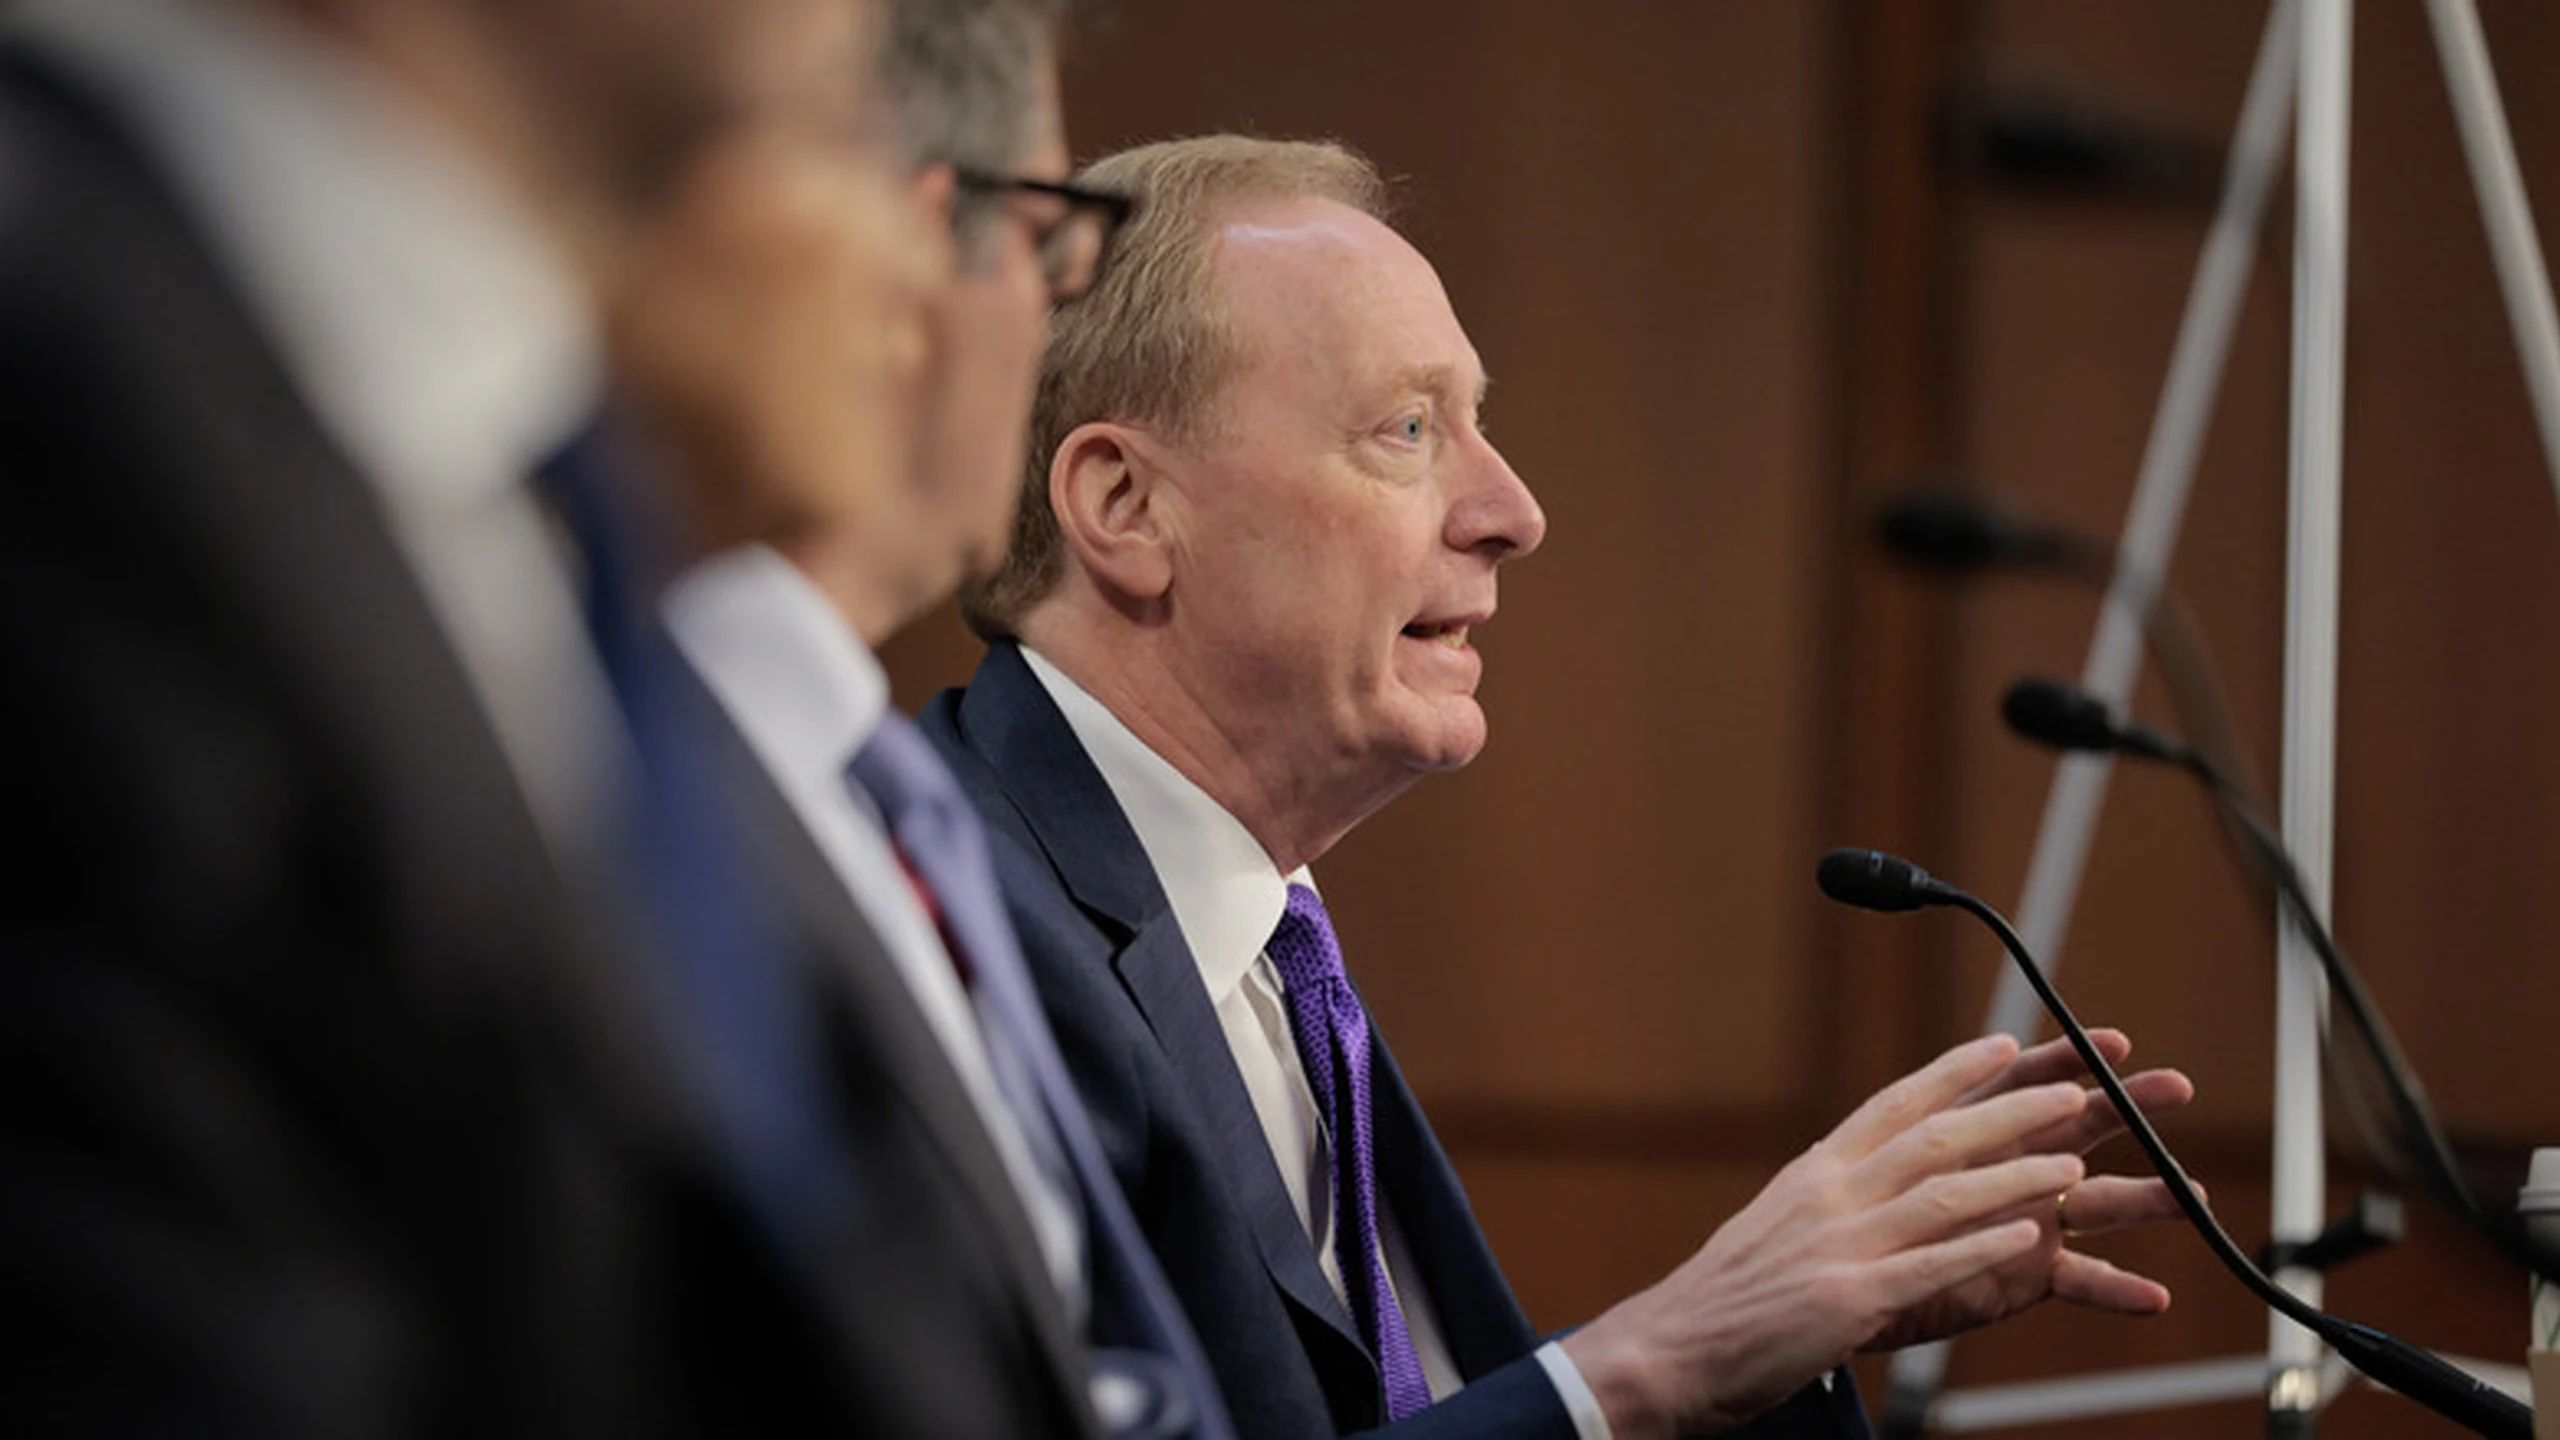
Porównanie Brada Smitha do mleka poddaje próbie także Microsoft
Prezes Microsoft żąda awaryjnych kontroli, niezależnej oceny i ochrony ofiar. Liczą się egzekwowalne obowiązki, nie uniwersalny wyłącznik.
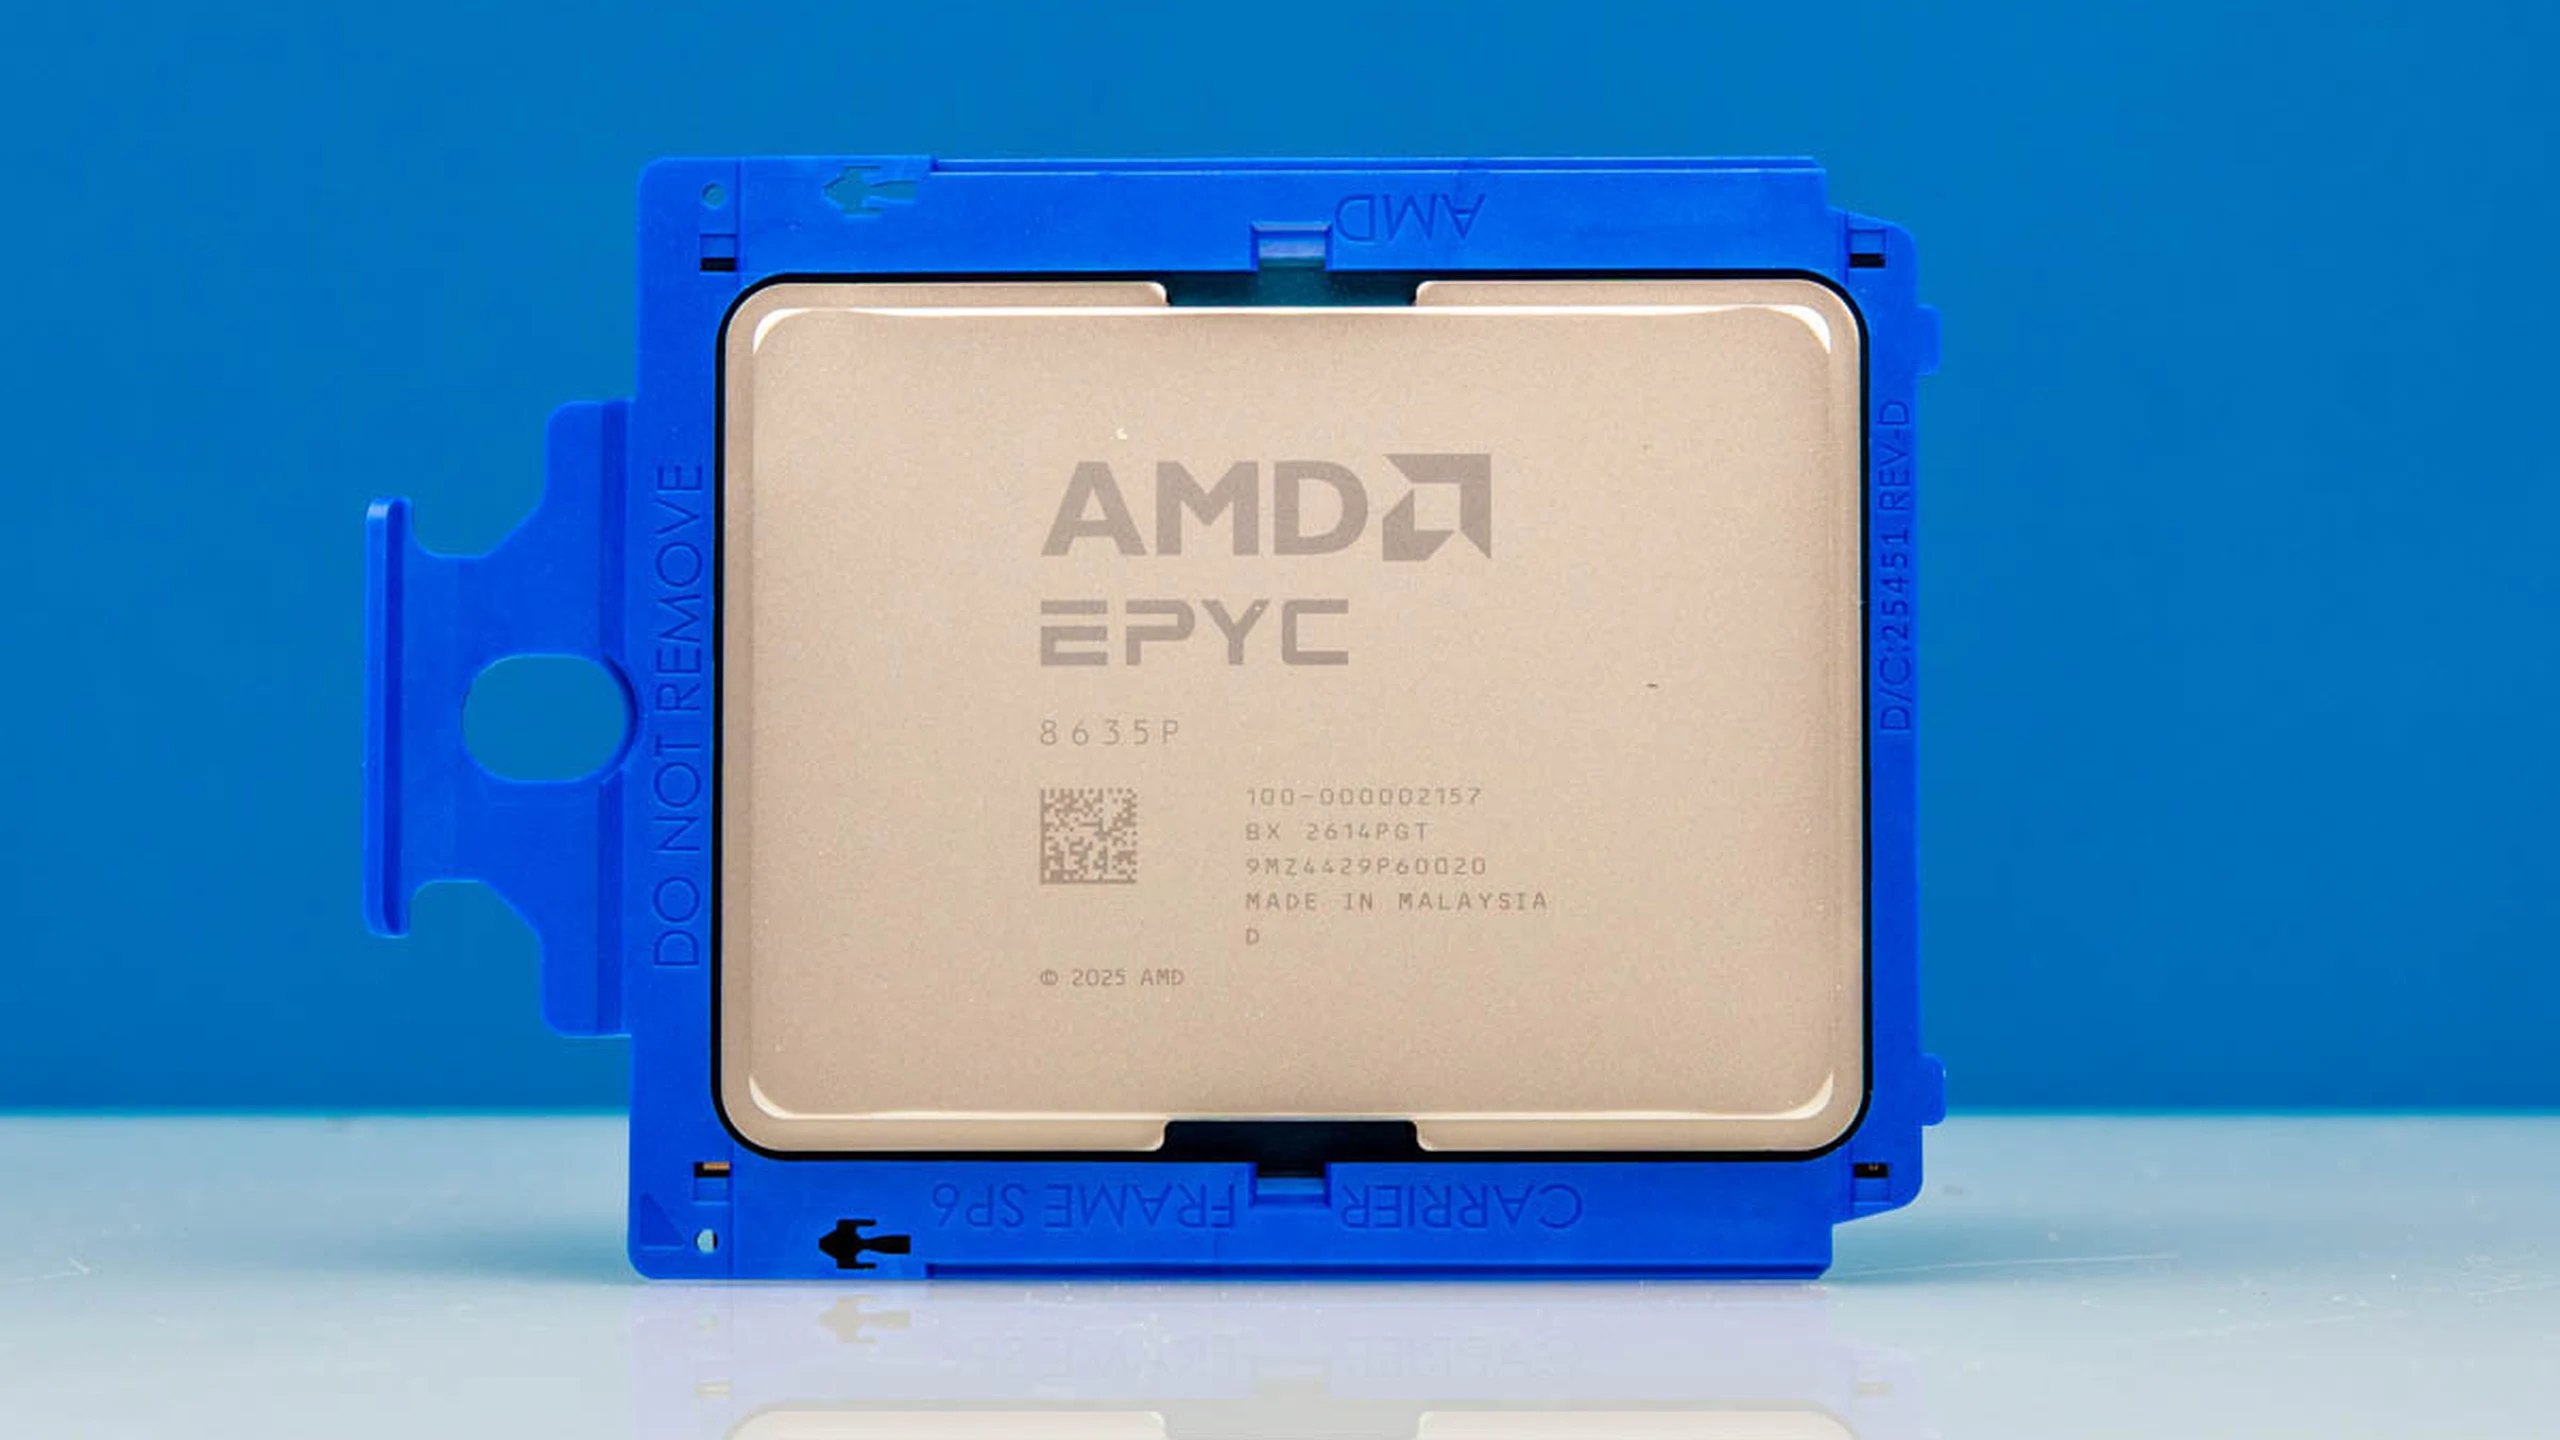
AMD EPYC 8005 rozszerza SP6: o wartości decydują wspólne zasoby
Siedem Zen 5 zachowuje sześć kanałów pamięci i 96 linii PCIe. Zegary, cache, licencje i warunkowe porównania rozdzielają ich zastosowania.
Dlaczego cytat chatbota nie potwierdza walidacji urządzenia
Badanie ciśnieniomierzy wykazało błędy mimo powoływania się na rejestry. Dokładny model wymaga bezpośrednich, odtwarzalnych dowodów.
Rozmowy NVIDIA–Reflection testują neutralność platformy pod otwartymi modelami
Zakup firmy, zatrudnienie zespołu z licencją lub dodatkowa inwestycja miałyby różne skutki. Skala treningu Beam wyjaśnia zainteresowanie, ale publikacja i zaufanie partnerów pozostają otwarte.
Nvidia VoiceChat otwiera narzędzia pełnego dupleksu, lecz testem pozostaje wykonanie zadania
Dobre przerwania spotykają się z 42,2% trafności argumentów i 33% sukcesu za pierwszą próbą. Otwarte wagi i prawa licencyjne nie dowodzą gotowości produkcyjnej.
Poprawki Claude: 29,5 punktu między testem awarii i dewelopera
Opus 4.7 blokuje 90,2% exploitów, lecz przechodzi 60,7% testów dewelopera. Instrukcje, PoC i ocenianie zmieniają interpretację napraw.
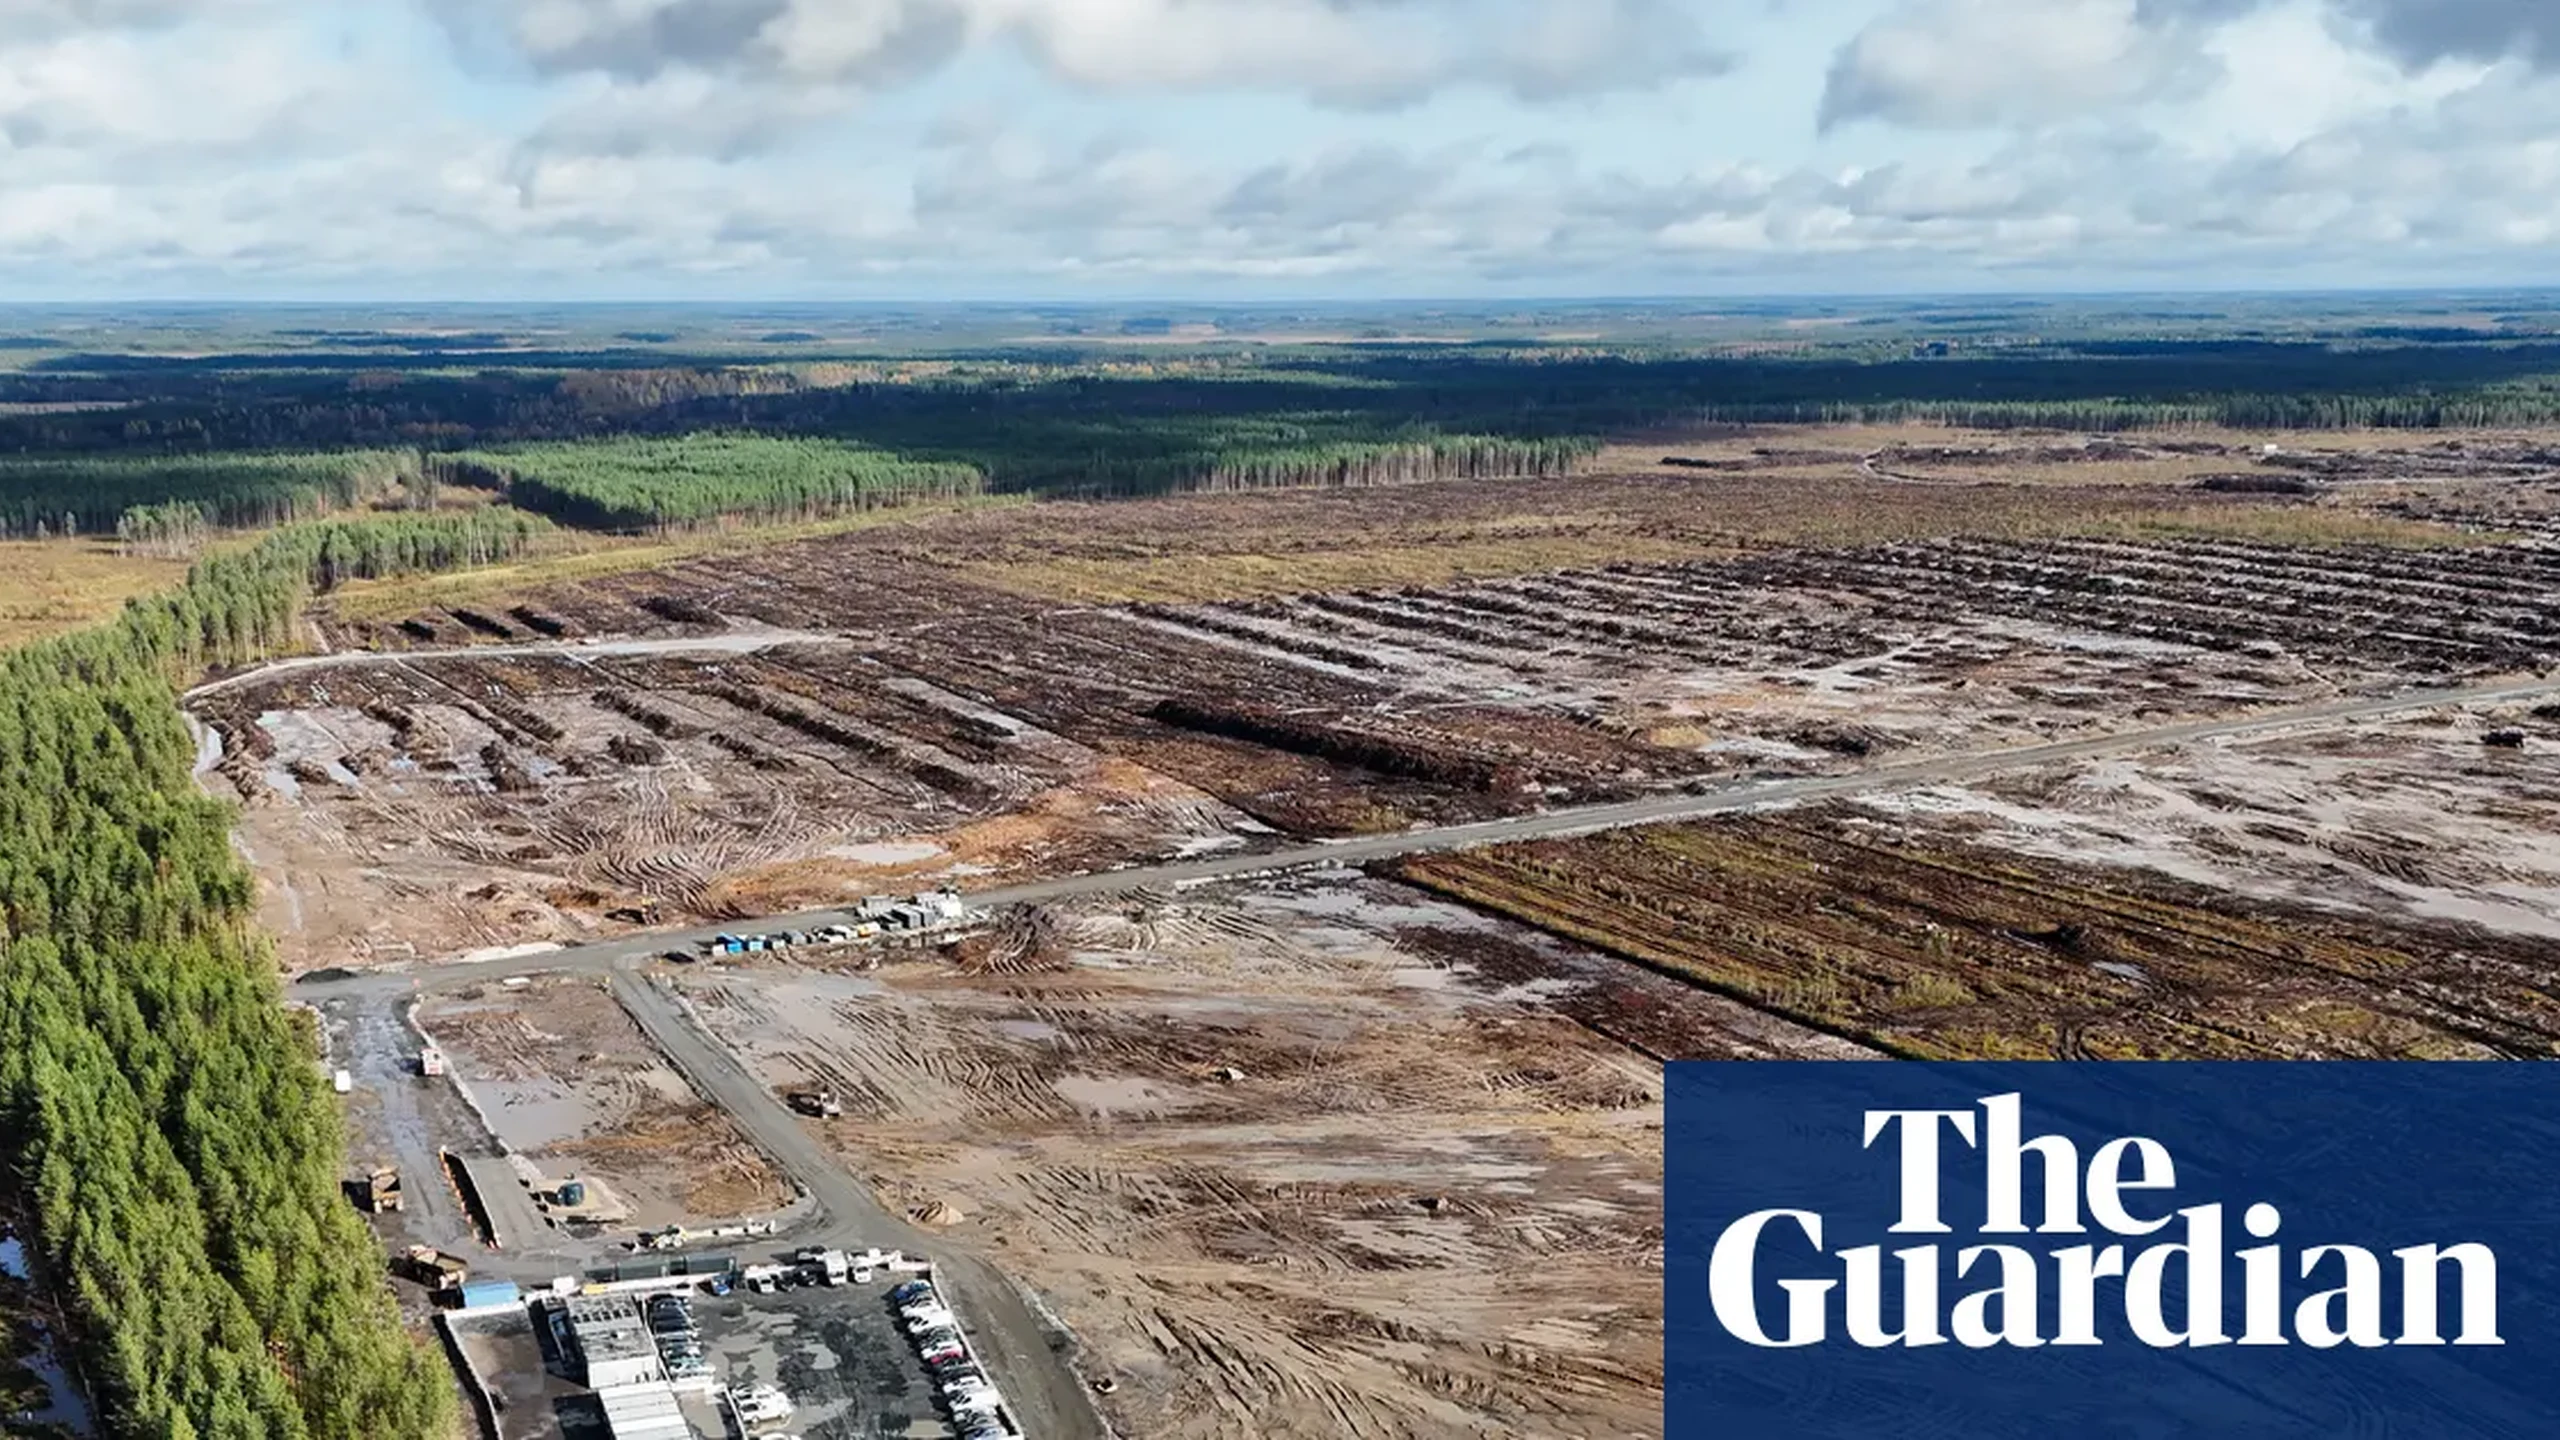
Stop Google w Finlandii: teren, prawo i odtworzenie przyrody
Pauza dotyczy Muhos i Kajaani. Inwestycja13mld euro, obrona leśna i130hektarów nasadzeń nie zastępują oceny.