
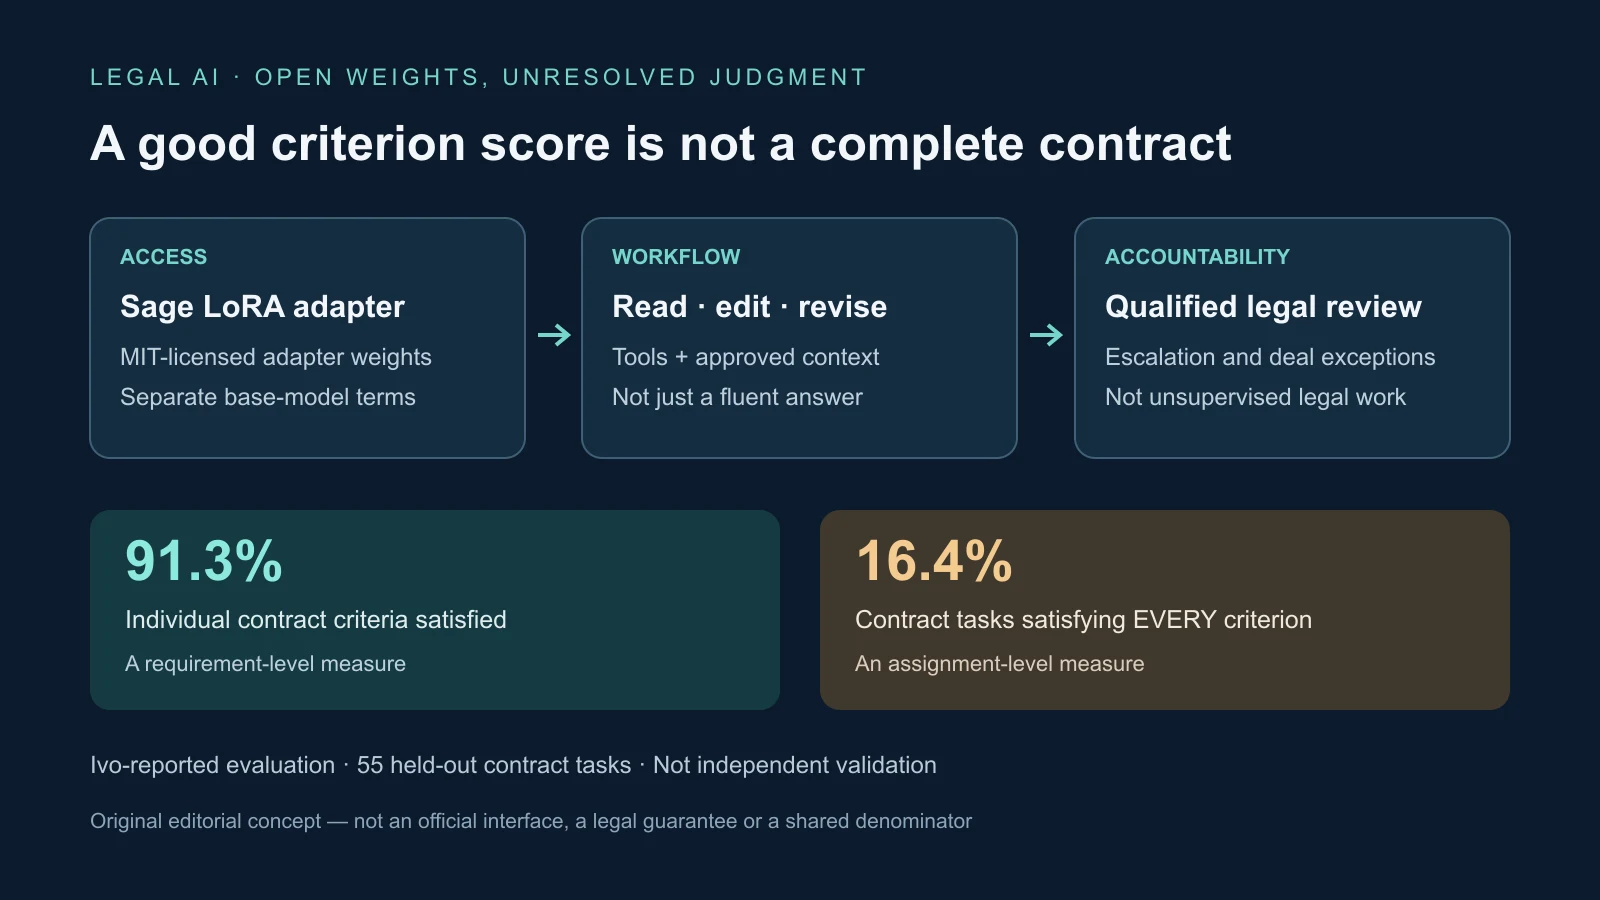
Ivos offenes Vertragsmodell liefert ungewöhnlich gut einsehbare Argumente für spezialisierte Rechts-KI – und zeigt die verbleibende Arbeit. Sage wurde am 1. Oktober 2026 auf der ersten Kundenkonferenz Ivo Inscribe in San Francisco vorgestellt. Verfügbar sind Adaptergewichte und detaillierte Evaluierungsunterlagen. Die berichtete Erfüllungsrate einzelner Vertragskriterien erreichte 91,3 Prozent, aber nur 16,4 Prozent der Vertragsaufgaben erfüllten jede Anforderung. Das sind sehr unterschiedliche Erfolgsmaße.
Die Veröffentlichung fordert Geheimhaltung auf der Modellebene heraus, beweist aber nicht, dass offene Software eine kommerzielle Rechtsplattform ersetzt. Ivo sieht Sages Arbeit zur Prüfung durch qualifizierte Juristen vor und beansprucht keinen Sieg über alle Frontier-Modelle. Die strategische Wette lautet: Unternehmensdokumente, Verhandlungsrichtlinien und Workflow-Ausführung werden wichtiger als exklusiver Zugang zu großen Modellen.
Ein Adapter für mehrstufige Arbeit, kein Rechtsberater auf dem Desktop
Sage soll Dokumente lesen, Werkzeuge nutzen, entwerfen und über viele Schritte überarbeiten. Es erstellt Vertragsänderungen, Vereinbarungen und Memoranden statt isolierter Antworten. Vor dem Speichern können Dutzende Werkzeugaufrufe liegen. Training muss deshalb nutzbare Ergebnisse belohnen, die Anweisungen über zusammengehörige Dateien hinweg einhalten, nicht bloß überzeugende Sprache.
Ivo entwickelte kein Basismodell von Grund auf. Sage besteht aus LoRA-Adaptergewichten für DeepSeek V4 Flash, ein Mixture-of-Experts-Modell mit insgesamt 284 Milliarden und 13 Milliarden aktiven Parametern. Pro Token werden ausgewählte Netzwerkteile aktiviert, was gegenüber dem gesamten Netz Rechenaufwand spart. LoRA verändert Verhalten durch einen kleineren zusätzlichen Gewichtssatz. Der Adapter umfasst 12,2 GiB. Trainiert wurden Feed-forward- und Ausgabeprojektionen bei eingefrorenen Attention-Gewichten. Das berichtete Training und die Bewertung nutzten 262.144 Token Kontext.
Nach Firmenangaben erfolgte Reinforcement Learning anhand von 1.040 Aufgaben des Legal Agent Benchmark. Sechs Werkzeuge unterstützten Lesen, Schreiben, Bearbeiten, Suchen und Dateinavigation. Episoden endeten bei ausbleibender Werkzeugnutzung oder festgelegten Gesprächs- und Generierungsgrenzen. Vertragsarbeit verlangt Klauselsuche, Quellenvergleich, Umsetzung von Anweisungen und gespeicherte Änderungen; belohnt wurden Arbeitsergebnisse statt Gesprächsfluss.
Veröffentlicht sind Aufgabenlisten, Protokolle, Ergebnisse, Bewertungsentscheidungen und Trainingsaufzeichnungen. Die MIT-Lizenz des Adapters erlaubt üblicherweise unter ihren Bedingungen kommerzielle Nutzung, Änderungen und Weitergabe. Für DeepSeek und weitere Komponenten gelten jedoch separate Bestimmungen. Offene Adaptergewichte sind keine eigenständige, vollständig offene Anwendung. Ivo empfiehlt SGLang auf mehreren GPUs; das Beispiel verteilt die Ausführung mit achtfachem Tensorparallelismus auf acht Beschleuniger. Ein kleinerer Download bedeutet daher keinen kleinen Betrieb.
Bessere Durchschnittswerte bedeuten keine vollständigen Verträge
Ivo hielt verwandte Verträge und Quellen auf derselben Seite der Trainings- und Validierungsaufteilung, um nahezu doppelte Inhalte zwischen Gruppen zu reduzieren. Zurückgehalten wurden 180 Aufgaben, davon 125 allgemeine juristische und 55 Vertragsaufgaben. Je Aufgabe lief eine Episode mit drei Bewertungsdurchgängen. Wiederholtes Bewerten prüft ein erzeugtes Ergebnis, nicht drei unabhängige Lösungsversuche.
Insgesamt stieg die Erfüllung einzelner Kriterien von 82,4 Prozent beim Basismodell auf 91,5 Prozent bei Sage. Die strenge Erfüllung sämtlicher Kriterien stieg von 7,2 auf 15,6 Prozent. Bei Verträgen erhöhte sich die Kriterienrate von 70,1 auf 91,3 Prozent, während vollständige Erfüllung 16,4 Prozent erreichte. Mehr als vier von fünf Vertragsaufgaben ließen demnach etwas aus. Ein Formatfehler und eine versäumte Eskalation können sehr unterschiedliche Folgen haben, verhindern aber beide einen strikten Erfolg.
Auch die Effizienz im Testumfeld verbesserte sich: durchschnittlich 31,2 Gesprächsschritte wurden zu 25, und die Zahl gesampelter Token sank um 21 Prozent. Auf dem nicht zum Training verwendeten RedlineBench stieg der Wert von 30,8 auf 45,7. Über 161 LegalBench-Aufgaben blieb der Durchschnitt mit 83,0 gegenüber 83,1 des Basismodells nahezu gleich. Diese Firmenbefunde sprechen für bessere lange Vertragsarbeit ohne wesentlichen Verlust in diesem Kurzformat-Benchmark, nicht für universell erhaltene Rechtsfähigkeiten.
Ivo bestimmte Konfigurationen, führte Wettbewerbsmodelle aus und veröffentlichte die Resultate. LLM-Bewerter benoteten nach Kriterienrastern, wodurch ein weiteres Modell Teil der Messung wird. Drei Durchgänge und öffentliche Spuren verbessern Prüfbarkeit, ersetzen aber weder unabhängige Replikation noch Juristenprüfung realer Vorgänge. Auch Modell-, Inferenz- und Agentenentwicklungen können Ranglisten rasch überholen.
Schwieriger ist zu wissen, wann Widerspruch oder Eskalation nötig sind
Auf der Konferenz stellte Ivo die Ivo-micro1 Contract Bench vorab vor. Sie untersucht Priorisierung, Zurückhaltung, Deal-Anpassung, Eskalation und Playbook-Treue. Vorläufige Zahlen betrafen getestete Frontier-Modelle, nicht eine weitere bewiesene Sage-Ergebnisreihe. Öffentliche Resultate sollten folgen; die Firmen- und Partnerbefunde waren damals noch nicht vollständig von außen überprüfbar.
Laut Ivo gelangen Annahme- oder Nichtänderungsentscheidungen in 82 Prozent der Fälle, Gegenangebote oder Zurückweisungen dagegen in 46 Prozent. Erforderliche neue Verhandlungspunkte kamen nur in 23 Prozent hinzu, und durchschnittlich 23 Prozent der expertendefinierten Eskalationskriterien wurden erfüllt. Es sind verschiedene Entscheidungen und Kriterien, keine austauschbaren Gesamtgenauigkeiten.
Auch der Bearbeitungsstil unterschied sich. Juristen führten 64 Prozent der Änderungen direkt innerhalb des vorhandenen Textes aus, durchschnittlich 92 Zeichen lang. Modelle lagen bei 14–37 Prozent, mit durchschnittlich 207–369 Zeichen je Änderung. Umfangreiche Neufassungen können ausgehandelte Formulierungen stören, Prüfzeit erhöhen und den genauen Unterschied verschleiern, selbst wenn sie plausibel klingen. Standardpositionen erfüllten Modelle zu 51 Prozent; veränderte Deal-Fakten senkten den Wert auf 38 Prozent.
Das erklärt, warum Vertragsurteil mehr als Klauselerkennung verlangt. Systeme müssen entscheiden, wann Text bleibt, Widerspruch nötig ist, ein Punkt fehlt oder ein Mensch übernehmen soll. Langer Kontext stellt Dokumente bereit, garantiert aber weder die Verknüpfung der richtigen Klausel mit der richtigen Richtlinie noch das Erkennen berechtigter Ausnahmen. Zusätzliche Werkzeugaufrufe erhöhen Fehler- und Abweichungsmöglichkeiten. Fehlerklassen zählen daher neben Mittelwerten.
Was offen ist und wo kommerzielle Vorteile bleiben
Ivos „erster“-Anspruch braucht die volle Einschränkung: ein von einem Rechts-KI-Unternehmen veröffentlichtes offenes Modell, nachtrainiert für langfristige Vertragsarbeit. Offene Rechtsmodelle begannen nicht mit Sage. Equall veröffentlichte 2024 SaulLM-7B unter MIT für Rechtstexte; andere Forscher entwickelten Encoder, Schlussfolgerungsmodelle, Retrieval und rechtsraumspezifische Modelle. Sages beanspruchte Neuheit kombiniert mehrstufiges Vertragstraining, zugängliche Gewichte, freizügige Adapterlizenz und öffentliche Abläufe.
Mitgründer und CEO Min-Kyu Jung erwartet die nächsten Verbesserungen aus Arbeitskontext – Dokumenten, Verhandlungsplaybooks und etablierten Teamverfahren – statt nur aus größeren Modellen. Das passt zu Ivos Fokus auf Verträge interner Rechtsabteilungen, während andere Anbieter breitere Kanzlei- und Unternehmensarbeit abdecken. Eine Finanzierungsankündigung Anfang 2026 beschrieb ein Word-Produkt für Klauselprüfung, Risikoerkennung und Änderungsvorschläge.
Harvey entwickelte den für Sage verwendeten Legal Agent Benchmark, konkurriert aber über eine proprietäre Rechtsplattform. Kostenlos gegen kostenpflichtig greift zu kurz: Anbieter liefern Bereitstellung, Integrationen, Sicherheitskontrollen, Support und Oberflächen. Gewichte holen weder automatisch das richtige Playbook noch setzen sie Dokumentrechte oder Prüfprotokolle um. Offener Zugang schwächt Geheimhaltung als Modellvorteil, liefert aber nicht den restlichen Produktstapel.
Der Adapter kann Entwickler, Universitäten, Anbieter und Unternehmensforscher anziehen und alternative Agentenschleifen, Anpassungen mit freigegebenen Daten sowie Fehleranalysen ermöglichen. Wettbewerber können zugleich Trainingslehren übernehmen. Ivo akzeptiert das offenbar in Erwartung austauschbarerer Modelle und dauerhafter Differenzierung durch Kundenkontext. Das ist eine überprüfbare Geschäftsthese, kein Branchengesetz. Übersteigen Einführungsaufwand und Betriebskosten den Nutzen oder bleibt der Vorsprung geschlossener Grundlagen uneinholbar, behalten verwaltete Plattformen Vorteile.
Lokale Kontrolle bedeutet weder Nullkosten noch automatische Governance
Self-Hosting kann Vertragsinhalte auf kontrollierter Infrastruktur halten, löst jedoch Berechtigungen, Protokollierung, Modellaufsicht oder Lizenzprüfung nicht automatisch. Die DeepSeek-Abstammung kann weiterhin Beschaffungs-, Rechtsraum- und Lieferkettenfragen auslösen. Der Adapter ist relativ kompakt, das große Basismodell braucht praktisch erhebliche GPU-Kapazität. Freie Gewichte lassen Rechen-, Entwicklungs-, Prüf-, Sicherheits- und juristische Aufsichtskosten bestehen.
Auch Organisationswissen muss gepflegt werden. Agenten können interne Regeln nur anwenden, wenn diese aktuell, auffindbar und dem richtigen Vorgang zugeordnet sind. Kuratierte Dokumente, Arbeitsanweisungen, Eskalationsregeln und verantwortliche Prüfer gehören zum System. Der unten verlinkte Wissensdatenbankartikel illustriert diese Retrieval-Aufgabe, validiert aber nicht Sages juristische Genauigkeit.
Unabhängige Replikation sollte unter vergleichbaren Bedingungen strikte Vollständigkeit, Bewertungskonsistenz, Fehlerschwere, Prompt-Empfindlichkeit und Werkzeugstabilität untersuchen. Verblindete Expertenprüfung kann zeigen, ob Zahlen klarere und brauchbarere Arbeit ergeben. Aussagekräftige externe Nutzung bedeutet veröffentlichte Bewertungen oder Anpassungen für Einkauf, Beschäftigung, Datenschutzanhänge oder bestimmte Rechtsräume, nicht bloße Downloads.
Betriebsberichte brauchen Latenz, Infrastrukturbedarf, Fehlerbehandlung und Governance. Sie müssen den gesamten Ablauf erklären, statt jeden Gewinn den Gewichten zuzuschreiben. Wettbewerber können ohne offene Modelle mit aufgabenbezogenen Spuren, kundengesteuerten Tests, Kundeninfrastruktur und strengen Abschlussraten antworten. Schweigen beweist keine Unterlegenheit, doch transparente Nachweise könnten Erwartungen verändern.
Sages unmittelbarer Beitrag ist ein prüfbarer Ausgangspunkt. Dieselbe Veröffentlichung meldet bessere, kürzere Vertragsarbeit und zeigt ungelöstes zuverlässiges End-to-End-Urteil. Ob unabhängige Teams Fortschritte wiederholen, sinnvolle Varianten finden und die angekündigten Ivo-micro1-Ergebnisse prüfen, wird die Marktwirkung bestimmen. Kein zukünftiger Test macht den heutigen Kriterienwert von 91,3 Prozent zur Erlaubnis, qualifizierte juristische Prüfung abzuschaffen.
Quellen
Sage-Gewichte und Bewertungen · Legal Agent Benchmark · Frühere SaulLM-7B-Forschung · Ivo-Finanzierungs- und Produktankündigung · Weiterführend: durchsuchbare technische Wissensbestände · Google-News-Aggregation, keine offizielle Modellveröffentlichung