
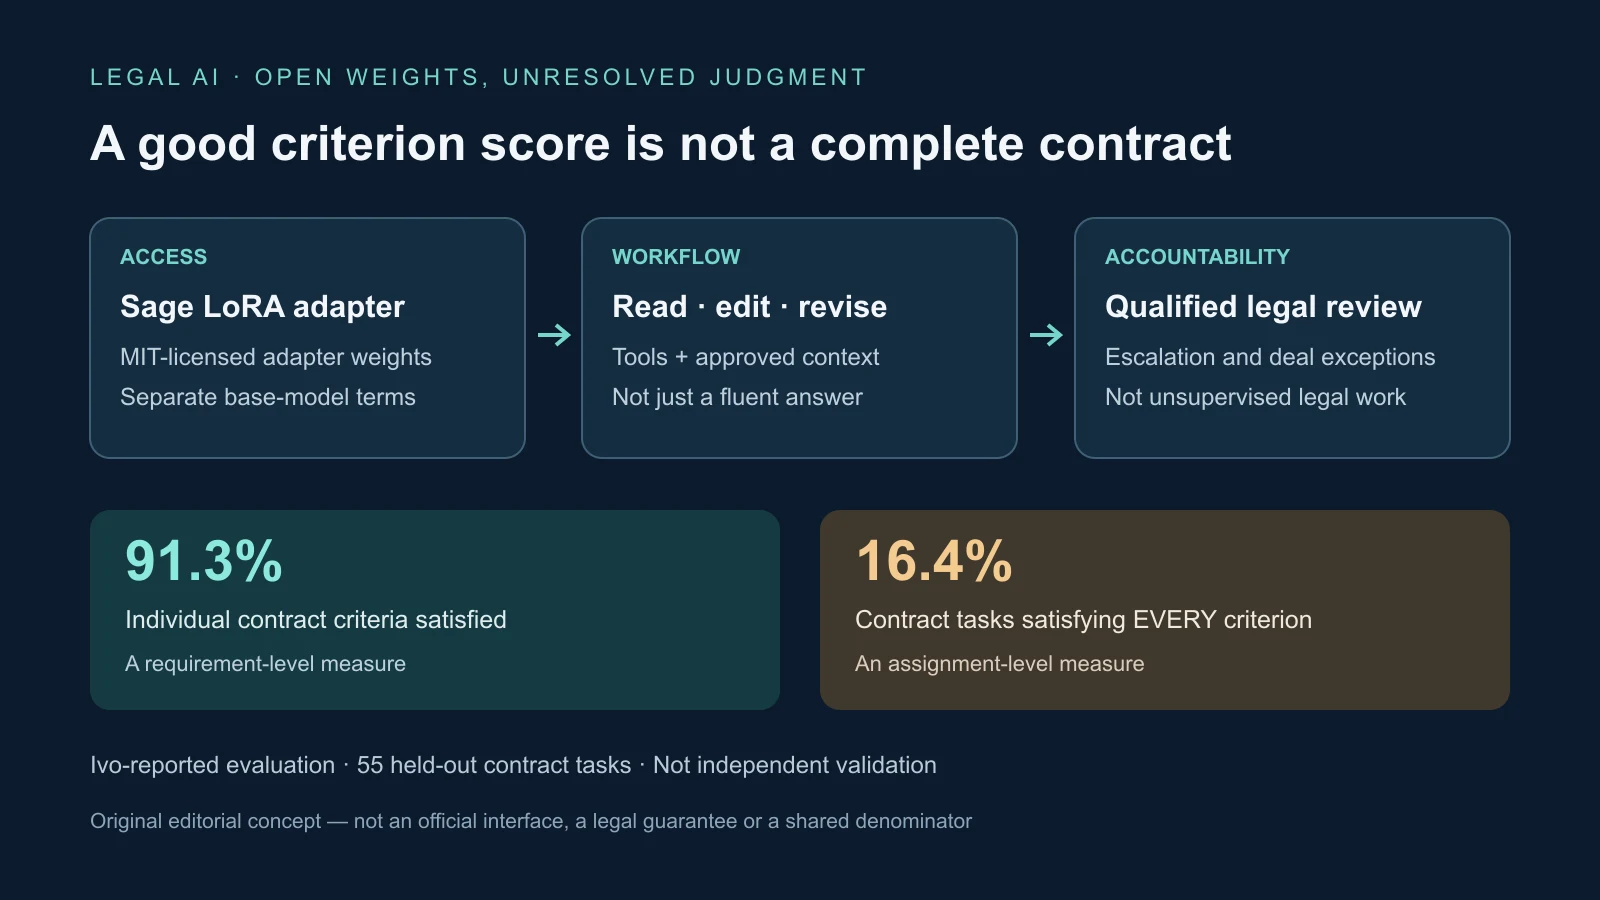
Il modello contrattuale aperto di Ivo presenta un argomento insolitamente verificabile a favore dell'IA legale specializzata, mostrando anche quanto resti da fare. Sage, presentato il 1° ottobre 2026 alla prima conferenza Ivo Inscribe di San Francisco, offre pesi dell'adattatore e registri dettagliati delle valutazioni. Il superamento dei singoli criteri contrattuali ha raggiunto il 91,3%, ma solo il 16,4% degli incarichi soddisfaceva tutti i requisiti. Sono misure di successo profondamente diverse.
Il rilascio sfida la segretezza a livello di modello, non dimostra che software aperto sostituisca una piattaforma legale commerciale. Ivo destina il lavoro di Sage alla revisione di un avvocato qualificato e non sostiene di battere ogni modello di frontiera. Scommette che documenti aziendali, politiche negoziali ed esecuzione dei processi conteranno più dell'accesso esclusivo a grandi modelli.
Un adattatore per attività in più fasi, non un consulente sul desktop
Sage legge documenti, usa strumenti, redige e rivede attraverso molti passaggi. Produce modifiche contrattuali, accordi e memorandum anziché risposte isolate. Un incarico può richiedere decine di chiamate prima del salvataggio finale. L'addestramento deve quindi premiare risultati utilizzabili che rispettino le istruzioni tra file collegati, non soltanto un linguaggio convincente.
Ivo non ha costruito un modello di base da zero. Sage è un adattatore LoRA per DeepSeek V4 Flash, un mixture-of-experts con 284 miliardi di parametri totali e 13 miliardi attivi. Per ogni token si attivano solo parti selezionate, riducendo il calcolo rispetto all'intera rete. LoRA modifica il comportamento con un insieme più piccolo di pesi aggiuntivi. L'adattatore occupa 12,2 GiB; Ivo ha addestrato proiezioni feed-forward e di uscita congelando l'attenzione. Addestramento e valutazione descritti utilizzavano 262.144 token di contesto.
L'azienda dichiara apprendimento per rinforzo su 1.040 incarichi del Legal Agent Benchmark. Sei strumenti consentivano lettura, scrittura, modifica, ricerca e navigazione tra file. Gli episodi terminavano all'interruzione degli strumenti o ai limiti di turni e generazione. Cercare clausole, confrontare fonti, applicare istruzioni e salvare revisioni legava la ricompensa al risultato, non alla fluidità della conversazione.
Sono pubblici elenchi, trascrizioni, elaborati, decisioni dei valutatori e registri di addestramento. La licenza MIT dell'adattatore generalmente permette uso commerciale, modifiche e ridistribuzione alle sue condizioni, ma la base DeepSeek e gli altri componenti hanno termini separati. Pesi aperti non significano applicazione autonoma completamente aperta. Ivo raccomanda SGLang su più GPU; l'esempio usa parallelismo tensoriale a otto vie su otto acceleratori. Un download relativamente piccolo non equivale a una piccola infrastruttura.
Medie migliori non significano incarichi completi
Ivo ha mantenuto contratti e fonti correlati sullo stesso lato della divisione tra addestramento e validazione, riducendo la contaminazione da quasi duplicati. Il set escluso dal training conteneva 180 incarichi: 125 legali generali e 55 contrattuali. Ogni incarico aveva un episodio e tre passaggi di giudizio. Valutare ripetutamente lo stesso elaborato non significa tentare tre volte indipendentemente il compito.
Il superamento complessivo dei singoli criteri è salito dall'82,4% della base al 91,5% di Sage. Il completamento rigoroso di tutti i criteri è cresciuto dal 7,2% al 15,6%. Nei contratti i criteri sono passati dal 70,1% al 91,3%, ma il completamento integrale era del 16,4%. Oltre quattro incarichi su cinque omettevano ancora qualcosa secondo il protocollo. Un difetto di formato e una mancata escalation possono avere conseguenze molto diverse, pur impedendo entrambi il superamento rigoroso.
Anche l'efficienza nel contesto testato migliorava: episodi medi da 31,2 a 25 turni e token campionati ridotti del 21%. Su RedlineBench, non incluso nel training, il punteggio saliva da 30,8 a 45,7. In 161 attività LegalBench la media restava quasi invariata, 83,0 contro 83,1 della base. I dati aziendali suggeriscono migliori processi contrattuali prolungati senza perdita sostanziale in quel benchmark breve, non la conservazione universale delle capacità legali.
Ivo ha selezionato configurazioni, eseguito concorrenti e pubblicato risultati. Giudici LLM assegnavano punteggi tramite rubriche, aggiungendo un altro modello alla misurazione. Tre valutazioni e tracce pubbliche migliorano l'ispezionabilità, ma non sostituiscono repliche indipendenti né avvocati su casi reali. Cambiamenti di base, inferenza e framework agentici possono inoltre invecchiare rapidamente le classifiche.
Più difficile è sapere quando opporsi o chiedere intervento
Alla conferenza Ivo ha anticipato Ivo-micro1 Contract Bench, dedicato a priorità, moderazione, adattamento alla transazione, escalation e rispetto del playbook. Le cifre preliminari riguardavano modelli di frontiera testati, non una seconda serie dimostrata di risultati Sage. I dati pubblici erano promessi successivamente: erano conclusioni aziendali e del partner non ancora pienamente verificabili dall'esterno.
Secondo Ivo, accettazione o assenza di modifiche erano corrette nell'82% dei casi, scendendo al 46% quando servivano controproposte o rifiuti. I modelli aggiungevano punti negoziali obbligatori solo nel 23% dei casi e soddisfacevano mediamente il 23% dei criteri di escalation degli esperti. Sono decisioni e criteri distinti, non percentuali complessive intercambiabili di accuratezza.
Diverso anche lo stile. Gli avvocati facevano il 64% delle modifiche puntualmente nel testo, con media di 92 caratteri. I modelli erano al 14–37%, con modifiche medie di 207–369 caratteri. Riscritture ampie possono alterare formule negoziate, allungare la revisione e oscurare il cambiamento esatto anche quando plausibili. Le posizioni standard del playbook avevano il 51% dei criteri soddisfatti; quando i fatti della transazione cambiavano la risposta, si scendeva al 38%.
Il quadro spiega perché giudicare contratti sia più che rilevare clausole. Occorre decidere quando lasciare il testo, opporsi, aggiungere un punto o coinvolgere una persona. Contesto lungo rende disponibili i documenti ma non garantisce l'abbinamento fra disposizione e politica, né riconosce automaticamente eccezioni giustificate. Ogni strumento aggiunge occasioni di errore e deriva. Le categorie di fallimento contano insieme alle medie.
Che cosa è aperto e dove resta il vantaggio commerciale
La pretesa di essere il “primo” richiede la qualifica completa: modello aperto di un'azienda di IA legale, post-addestrato per attività contrattuali prolungate. I modelli legali aperti precedono Sage. Equall pubblicò SaulLM-7B sotto MIT per testi legali nel 2024; altri ricercatori hanno realizzato encoder, ragionamento, ricerca e modelli di giurisdizione. La novità rivendicata combina training contrattuale in più fasi, pesi accessibili, licenza permissiva dell'adattatore e tracce pubbliche.
Min-Kyu Jung, cofondatore e CEO, vede i prossimi miglioramenti nel contesto di lavoro: documenti, playbook negoziali e metodi consolidati, non solo modelli maggiori. È coerente con Ivo, focalizzata sui contratti dei team interni, rispetto a rivali che coprono lavoro più ampio per studi e imprese. L'annuncio di finanziamento dell'inizio 2026 descriveva un prodotto in Word per rivedere clausole, individuare rischi e suggerire modifiche.
Harvey ha creato il Legal Agent Benchmark usato da Sage, ma compete tramite una piattaforma proprietaria. Non è semplicemente gratuito contro pagamento: i fornitori gestiti offrono distribuzione, integrazioni, sicurezza, assistenza e interfacce. I pesi non recuperano da soli il playbook giusto, applicano autorizzazioni o mantengono audit. L'apertura indebolisce la segretezza come vantaggio del modello senza fornire il resto del prodotto.
L'adattatore può attirare sviluppatori, università, fornitori e ricercatori aziendali, permettendo cicli alternativi, adattamenti con dati approvati e analisi dei fallimenti. Consente però anche ai rivali di copiare lezioni utili. Ivo sembra accettarlo prevedendo modelli più intercambiabili e differenziazione duratura nel contesto del cliente. È una tesi verificabile, non un esito certo. Piattaforme gestite restano avvantaggiate se gli oneri superano i benefici o la specializzazione non colma il vantaggio delle basi chiuse.
Controllo locale non significa costo zero o governo automatico
L'hosting interno può mantenere contratti nell'infrastruttura controllata dall'operatore, ma non risolve automaticamente permessi, registri, governance o licenze. L'origine DeepSeek può ancora porre questioni di acquisti, giurisdizione e filiera. L'adattatore è compatto, ma la base grande richiede importanti GPU per un servizio pratico. Pesi gratuiti lasciano costi di calcolo, ingegneria, valutazione, sicurezza e supervisione legale.
Anche la conoscenza organizzativa va mantenuta. Le politiche devono essere aggiornate, reperibili e collegate alla pratica corretta. Documenti curati, istruzioni, regole di escalation e revisori responsabili sono parti del sistema. L'articolo correlato sulla base di conoscenza illustra questa sfida di recupero, non valida l'accuratezza giuridica di Sage.
La replica indipendente dovrebbe esaminare completamento rigoroso, coerenza dei giudici, gravità degli errori, sensibilità ai prompt e stabilità degli strumenti in condizioni comparabili. La revisione in cieco di esperti mostrerebbe se i numeri producono lavoro più chiaro e utilizzabile. Adozione esterna significativa vuol dire valutazioni o adattamenti pubblicati per acquisti, lavoro, appendici privacy o giurisdizioni, non soli download.
Resoconti produttivi devono includere latenza, infrastruttura, gestione degli errori e governance, spiegando tutto il flusso invece di attribuire ogni miglioramento ai pesi. I concorrenti possono rispondere senza aprire modelli: tracce delle attività, test controllati dal cliente, hosting del cliente e percentuali rigorose. Silenzio non prova inferiorità, ma evidenza trasparente può cambiare le aspettative.
Sage offre oggi un punto di partenza ispezionabile. Lo stesso rilascio che dichiara processi contrattuali migliori e più brevi mostra il problema irrisolto del giudizio completo affidabile. Repliche, adattamenti utili e verifica dei promessi risultati Ivo-micro1 determineranno l'impatto. Nessuno di quei test futuri autorizza a usare l'attuale 91,3% per criterio come permesso di rimuovere la revisione legale qualificata.
Fonti
Pesi e valutazioni Sage · Legal Agent Benchmark · Ricerca precedente SaulLM-7B · Finanziamento e prodotto Ivo · Lettura correlata: basi tecniche di conoscenza ricercabili · Voce aggregata Google News, non rilascio ufficiale del modello