
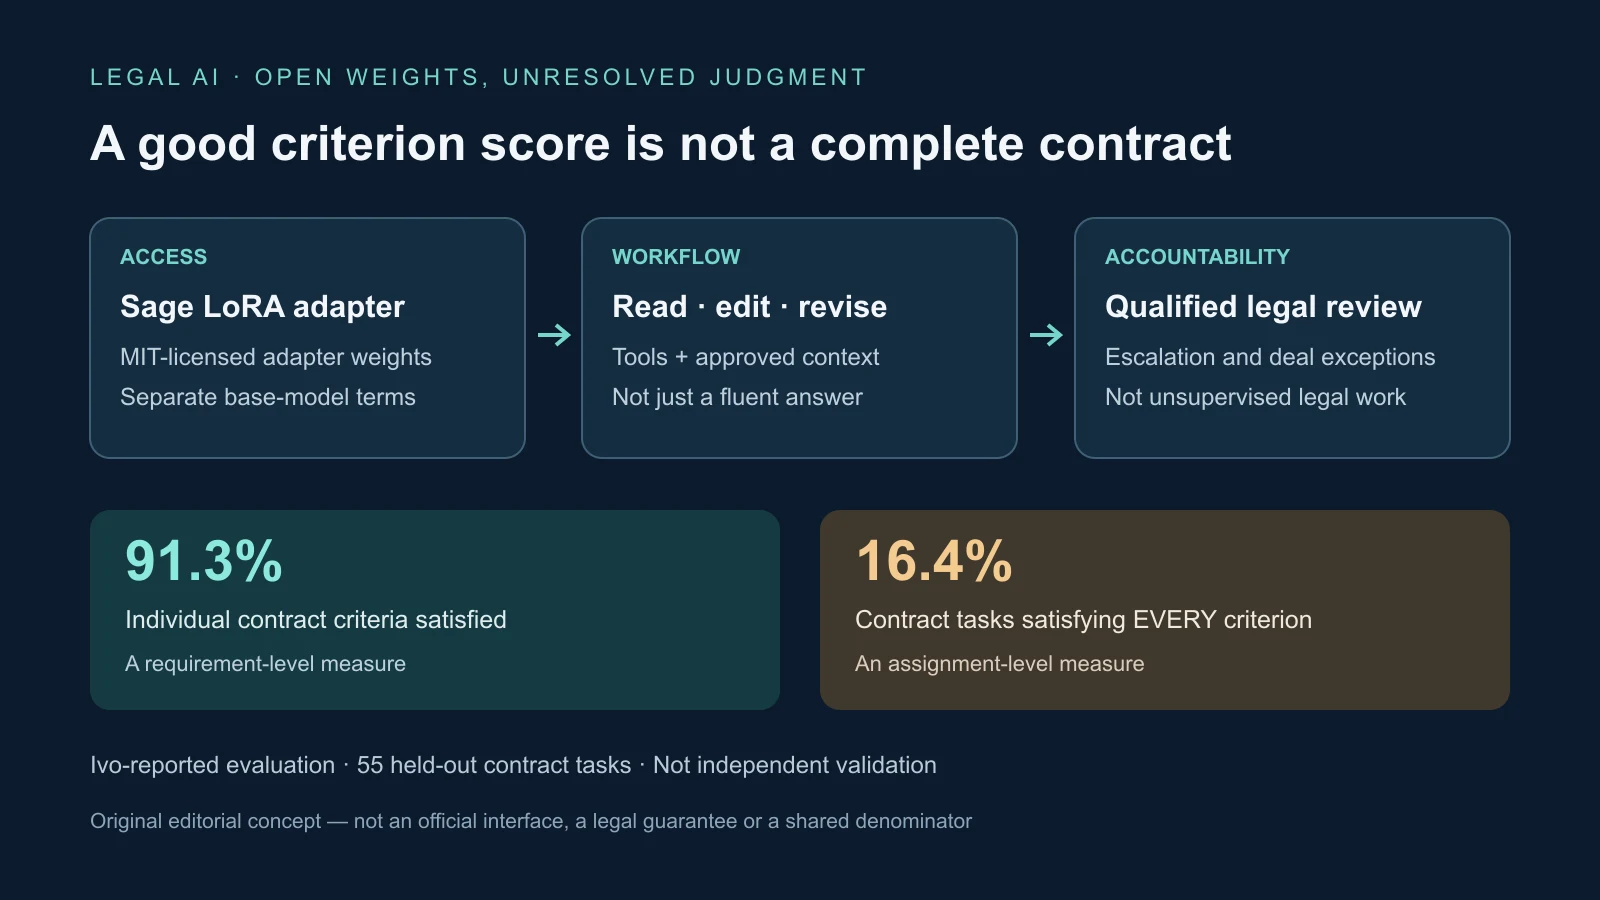
Le modèle contractuel ouvert d'Ivo présente un argument exceptionnellement vérifiable en faveur d'une IA juridique spécialisée, tout en exposant le travail restant. Présenté le 1er octobre 2026 à la première conférence Ivo Inscribe de San Francisco, Sage offre des poids d'adaptateur et des dossiers d'évaluation détaillés. Son taux de réussite par critère contractuel aurait atteint 91,3 %, mais seules 16,4 % des missions satisfaisaient toutes les exigences. Ce sont des mesures très différentes du succès.
La publication remet en cause le secret au niveau du modèle, sans prouver qu'un logiciel ouvert remplace une plateforme juridique commerciale. Ivo destine les travaux de Sage à l'examen d'un avocat qualifié et ne prétend pas battre tous les modèles de pointe. Son pari est que documents organisationnels, politiques de négociation et exécution des processus compteront plus que l'accès exclusif à de grands modèles.
Un adaptateur pour plusieurs étapes, pas un conseiller juridique de bureau
Sage lit, utilise des outils, rédige et révise au fil de nombreuses étapes. Il produit modifications contractuelles, accords et mémorandums plutôt que réponses isolées. Une mission peut nécessiter des dizaines d'appels avant l'enregistrement final. L'entraînement doit donc récompenser un résultat utilisable respectant les instructions entre fichiers liés, pas seulement une formulation convaincante.
Ivo n'a pas construit un modèle fondamental de zéro. Sage se compose de poids LoRA pour DeepSeek V4 Flash, mélange d'experts de 284 milliards de paramètres totaux et 13 milliards actifs. Des parties sélectionnées s'activent par token, réduisant les calculs par rapport au réseau entier. LoRA modifie le comportement par un petit ensemble de poids supplémentaires. L'adaptateur occupe 12,2 GiB ; les projections feed-forward et de sortie ont été entraînées, avec attention gelée. L'entraînement et l'évaluation rapportés utilisaient 262 144 tokens de contexte.
L'entreprise déclare avoir appliqué l'apprentissage par renforcement à 1 040 missions du Legal Agent Benchmark. Six outils permettaient lecture, écriture, modification, recherche et navigation. Les épisodes se terminaient à l'arrêt des outils ou aux limites de tours et de génération. Repérer les clauses, comparer les sources, suivre les instructions et enregistrer les révisions liait la récompense au livrable, non à la fluidité conversationnelle.
Listes, transcriptions, livrables, décisions des juges et journaux d'entraînement sont publiés. La licence MIT de l'adaptateur autorise généralement usage commercial, modification et redistribution sous ses conditions, mais la base DeepSeek et les composants associés conservent leurs conditions distinctes. Des poids ouverts ne sont pas une application autonome entièrement ouverte. Ivo recommande SGLang sur plusieurs GPU ; son exemple emploie huit voies de parallélisme tensoriel sur huit accélérateurs. Un téléchargement relativement petit n'implique donc pas une petite infrastructure.
De meilleures moyennes ne signifient pas des contrats complets
Ivo a conservé les contrats et documents liés du même côté de la séparation entraînement-validation, réduisant les fuites de quasi-doublons. Le jeu réservé comprenait 180 missions : 125 générales et 55 contractuelles. Chaque mission avait un épisode et trois passages de jugement. Juger plusieurs fois évalue le même livrable, pas trois tentatives indépendantes d'accomplir la tâche.
La réussite globale par critère est passée de 82,4 % pour la base à 91,5 % pour Sage. L'accomplissement strict de tous les critères est passé de 7,2 % à 15,6 %. Pour les contrats, la réussite par critère a progressé de 70,1 % à 91,3 %, mais l'accomplissement intégral n'atteignait que 16,4 %. Plus de quatre missions sur cinq omettaient encore quelque chose selon ce protocole. Un défaut de format et une escalade oubliée peuvent avoir des conséquences très différentes, bien que les deux empêchent une réussite stricte.
L'efficacité dans l'environnement testé s'améliorait également : épisodes moyens de 31,2 à 25 tours et tokens échantillonnés réduits de 21 %. Sur RedlineBench, exclu de l'entraînement, le score montait de 30,8 à 45,7. Sur 161 tâches LegalBench, la moyenne restait presque inchangée, 83,0 contre 83,1 pour la base. Ces résultats d'entreprise suggèrent une amélioration des longs processus sans perte substantielle dans ce benchmark court, pas une conservation universelle des aptitudes juridiques.
Ivo a choisi les configurations, exécuté les concurrents et publié les résultats. Des juges LLM notaient selon des grilles, ajoutant un autre modèle à la mesure. Trois passages et des traces publiques facilitent l'examen, sans remplacer réplication indépendante ni avocats sur des dossiers réels. Modèles de base, inférence et frameworks agentiques évoluent aussi et peuvent rapidement périmer les classements.
Le plus difficile est de savoir quand résister ou transmettre
La conférence a présenté en avant-première Ivo-micro1 Contract Bench, consacré à la priorisation, la retenue, l'adaptation à la transaction, l'escalade et le respect du playbook. Les chiffres préliminaires décrivaient les modèles de pointe testés, pas une seconde série démontrée de résultats Sage. Les données publiques étaient promises ensuite ; les conclusions de l'entreprise et du partenaire n'étaient pas encore intégralement auditables de l'extérieur.
Selon Ivo, les décisions d'accepter ou de ne rien changer étaient correctes dans 82 % des cas, contre 46 % lorsqu'une contre-proposition ou un rejet était nécessaire. Les modèles ajoutaient un point nouveau obligatoire dans seulement 23 % des cas et satisfaisaient en moyenne 23 % des critères d'escalade experts. Ce sont des décisions et critères distincts, pas des taux globaux d'exactitude interchangeables.
Le style différait aussi. Les avocats effectuaient 64 % de leurs changements ponctuellement dans le texte, de 92 caractères en moyenne. Les modèles étaient à 14–37 %, avec des modifications moyennes de 207–369 caractères. De vastes réécritures peuvent perturber les formulations négociées, allonger la révision et masquer le changement exact même si elles paraissent raisonnables. Les positions standard obtenaient 51 % de critères satisfaits ; lorsque les faits de la transaction changeaient la bonne réponse, cela tombait à 38 %.
Cela explique pourquoi juger un contrat dépasse la détection des clauses. Il faut savoir quand conserver, contester, ajouter un point ou faire intervenir une personne. Le contexte long rend les documents disponibles, sans garantir la bonne correspondance entre disposition et politique ni reconnaître une exception justifiée. Chaque outil ajoute des occasions d'erreur et de dérive. Les catégories d'échec importent avec les moyennes.
Ce qui est ouvert, et où demeure l'avantage commercial
L'affirmation de « premier » exige sa qualification entière : modèle ouvert d'une entreprise d'IA juridique, post-entraîné pour un travail contractuel prolongé. La modélisation juridique ouverte précédait Sage. Equall a publié SaulLM-7B sous MIT pour les textes juridiques en 2024 ; des chercheurs ont créé encodeurs, raisonnement, recherche et modèles juridictionnels. La nouveauté revendiquée combine entraînement contractuel en étapes, poids accessibles, licence permissive de l'adaptateur et traces publiques.
Min-Kyu Jung, cofondateur et directeur général, attend les prochains gains du contexte de travail : documents, playbooks et méthodes établies, pas seulement de modèles plus grands. Cela correspond à l'orientation d'Ivo vers les contrats des équipes internes, face aux concurrents couvrant davantage les cabinets et entreprises. Son annonce de financement du début 2026 décrivait un produit Word pour examiner les clauses, repérer les risques et suggérer des modifications.
Harvey a créé le Legal Agent Benchmark utilisé par Sage, mais concurrence par sa plateforme propriétaire. L'opposition gratuit-payant ne suffit pas : les fournisseurs gérés apportent déploiement, intégrations, sécurité, assistance et interfaces. Les poids ne récupèrent pas seuls le bon playbook, n'appliquent pas les droits et ne maintiennent pas l'audit. L'ouverture affaiblit le secret comme avantage du modèle sans fournir le reste du produit.
L'adaptateur peut attirer développeurs, universités, fournisseurs et chercheurs d'entreprise, permettant boucles alternatives, réglages avec données approuvées et analyse des échecs. Il permet aussi aux rivaux de copier des enseignements. Ivo semble l'accepter en prévoyant des modèles plus interchangeables et une différenciation durable par le contexte client. C'est une thèse vérifiable, pas une issue certaine. Les plateformes gérées restent avantagées si les charges dépassent les gains ou si la spécialisation ne rattrape pas les bases fermées.
Contrôle local ne signifie ni coût nul ni gouvernance automatique
L'auto-hébergement peut garder les contrats dans une infrastructure contrôlée, mais ne résout pas automatiquement droits, journaux, gouvernance et licences. L'origine DeepSeek peut encore soulever des questions d'achats, de juridiction et de chaîne d'approvisionnement. L'adaptateur est compact, mais sa grande base nécessite d'importants GPU pour un service pratique. Des poids gratuits laissent les coûts de calcul, ingénierie, évaluation, sécurité et supervision juridique.
Les connaissances organisationnelles doivent aussi être entretenues. Les agents appliquent des politiques seulement si elles sont à jour, trouvables et liées au bon dossier. Documents préparés, instructions, escalades et réviseurs responsables font partie du système. L'article connexe sur les bases de connaissances illustre ce défi de recherche, non une validation de l'exactitude juridique de Sage.
La réplication indépendante devrait examiner accomplissement strict, cohérence des juges, gravité des erreurs, sensibilité aux invites et stabilité des outils à conditions comparables. L'examen en aveugle d'experts montrerait si les chiffres apportent un travail plus clair et utilisable. Une adoption significative implique évaluations ou adaptations publiées pour achats, emploi, avenants de confidentialité ou juridictions, pas seulement des téléchargements.
Les rapports d'exploitation doivent présenter latence, infrastructure, gestion des échecs et gouvernance, en expliquant tout le processus plutôt qu'en attribuant tout aux poids. Les concurrents peuvent répondre sans ouvrir leurs modèles : traces par tâche, tests contrôlés par le client, infrastructure du client et taux stricts d'accomplissement. Le silence ne prouve pas l'infériorité, mais la transparence peut modifier les attentes.
Sage offre aujourd'hui un point de départ inspectable. La même publication rapporte des processus meilleurs et plus courts tout en montrant le jugement juridique intégral fiable non résolu. Réplication, adaptations utiles et audit des résultats Ivo-micro1 promis détermineront son impact. Aucun test futur ne permet de transformer les 91,3 % actuels par critère en autorisation de supprimer l'examen juridique qualifié.
Sources
Poids et évaluations Sage · Legal Agent Benchmark · Recherches antérieures SaulLM-7B · Financement et produit Ivo · Lecture connexe : bases techniques de connaissances consultables · Entrée agrégée Google News, non publication officielle du modèle