
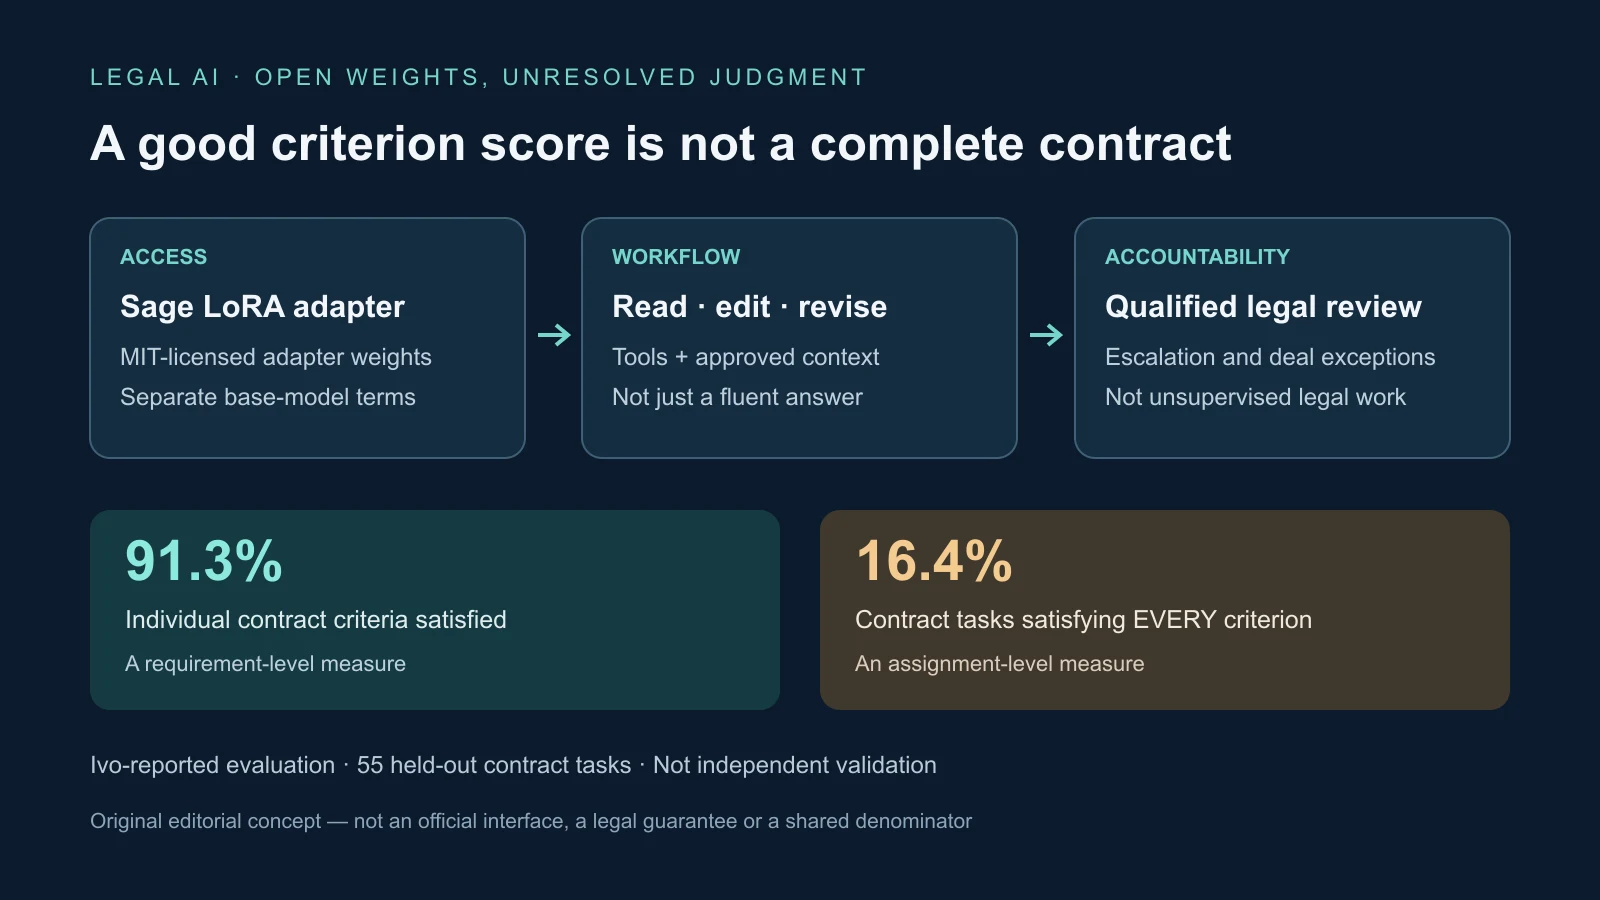
Ivo的开放合同模型,用一套格外可检查的材料论证专业法律AI的价值,同时暴露出仍未完成的工作。公司于2026年10月1日在旧金山首届Ivo Inscribe客户大会推出Sage,提供可下载的适配器权重与详细评估记录。其合同逐项标准通过率据称达到91.3%,但只有16.4%的合同任务满足所有要求。这是两种截然不同的成功指标。
发布挑战的是模型层的保密壁垒,并未证明开放软件可以取代商业法律平台。Ivo称Sage生成的工作须由合格律师审查,也没有宣称胜过所有前沿模型。它的战略押注是:组织特定文件、谈判政策和工作流执行,将比大型模型的独占访问更重要。
面向多步骤工作的适配器,不是桌面法律顾问
Sage旨在跨多个步骤阅读文件、调用工具、起草和修订,产出合同修订稿、协议及备忘录,而非孤立回答。一次任务可能在保存最终文档前调用数十次工具。因此,训练奖励的对象应是跨相关文件遵守指令的可用成果,而不只是有说服力的文字。
Ivo并未从头建设基础模型。Sage是DeepSeek V4 Flash的LoRA适配器权重;后者为混合专家模型,总参数2840亿、活跃参数130亿,每个token只激活网络的选定部分,比全部激活减少计算。LoRA训练较小的附加权重集以调整行为。适配器为12.2 GiB;Ivo训练前馈和输出投影,冻结注意力权重。所报告训练及评估使用262,144-token上下文窗口。
公司称对Legal Agent Benchmark的1040项任务实施强化学习。六种工具用于读取、写入、编辑、搜索和浏览文件;当工具使用停止或达到规定轮次、生成上限时,回合结束。合同工作要求定位条款、对比来源、执行指令及保存修改,奖励与交付物挂钩,而非对话流畅程度。
公开材料包括任务清单、记录、交付物、评审判断及训练记录。适配器MIT许可通常在满足条件时允许商业使用、修改和再分发,但DeepSeek基础模型及相关组件仍有独立条款。开放适配器权重不是自包含、完全开放的应用。Ivo建议以SGLang在多个GPU部署,示例采用八路张量并行、分布在八个加速器上。因此下载相对小,并不代表部署规模小。
平均成绩提高,不等于合同工作完整
Ivo将相关合同及源文件放在训练或验证划分的同一侧,以减少近似重复材料泄漏。保留验证集有180项任务,其中125项一般法律任务、55项合同任务。每项运行一个回合,每回合做三次评审。重复评审是在判断一份已生成成果,不是每项任务独立尝试三次。
总体单项标准通过率从基础模型82.4%升至Sage的91.5%,所有标准全通过的严格完成率从7.2%升至15.6%。合同任务的逐项通过率由70.1%升至91.3%,全标准完成率却为16.4%。按这一协议,五分之四以上合同任务仍有所遗漏。漏格式要求与漏掉升级处理可能后果悬殊,但都可能阻止严格通过。
测试环境中的效率也改善:平均回合长度从31.2轮降到25轮,采样token使用量减少21%。未参与训练的RedlineBench上,得分从30.8升到45.7。161项LegalBench任务的平均分基本不变,Sage为83.0,基础模型83.1。这些公司结果表明,专业训练改善长流程合同行为,同时没有在该短形式法律基准上造成实质损失;并不证明所有法律能力都得到保留。
Ivo选择配置、运行竞品并发布结果。LLM评审按量表评分,使测量过程本身又加入模型。三次评审和公开轨迹提高可检查性,却不能替代独立复现或合格律师审阅真实事项。基础模型、推理系统和智能体框架更新,也可能使排名迅速过时。
更难的是知道何时反对或升级
大会上,Ivo预告了Ivo-micro1 Contract Bench,用于考察优先级、克制、交易适应、升级处理和手册遵循。初步数据描述的是受测前沿模型,不是另一组已证实的Sage结果。公司称将随后公开结果;当时这些来自公司及合作伙伴的发现,外界尚无法完整审计。
据Ivo,模型在接受或不修改决策上正确率为82%,需要反提案或拒绝时降至46%。加入必需新谈判点的比例只有23%,平均满足23%的专家定义升级标准。这些数字分别衡量不同决策或标准,不能互换成整体准确率。
编辑方式也不同。律师64%的修改是局部行内修改,平均92字符;模型只有14%至37%,编辑平均207至369字符。长篇重写即使合理,也可能打乱已谈定措辞、增加审查时间、掩盖具体变动。标准手册立场的标准满足率为51%,交易事实改变正确回应时则降至38%。
这说明合同判断不只是识别条款。系统要知道何时保持原文、坚持立场、补充遗漏论点或交给人工。长上下文让文件可用,却不保证正确条款匹配正确政策,也不保证识别合理例外。工具调用越多,错误及偏离机会也更多。因此,失败分类与平均分同样重要。
开放的是什么,商业壁垒又在哪里
Ivo的“首个”说法必须保留完整限定:由法律AI公司发布、针对长流程合同工作后训练的开放模型。开放法律建模并非始于Sage。Equall在2024年发布MIT许可的法律文本模型SaulLM-7B,研究者也已提供法律编码器、推理模型、检索系统和司法辖区特定模型。Sage所主张的新意,在于多步骤合同训练、可获得权重、宽松适配器许可与公开轨迹的组合。
联合创始人兼CEO Min-Kyu Jung认为,下一阶段收益来自工作语境——文件、谈判手册及团队既定方法——而不只是更大的模型。这符合Ivo面向企业内部法务合同的定位;其他大厂覆盖更广的律所与企业法律业务。其2026年早些时候融资公告描述了在Microsoft Word中审查条款、识别风险、建议修订的产品。
Harvey创建了Sage训练采用的Legal Agent Benchmark,却凭专有法律平台竞争。对比不只是免费与付费:托管厂商提供部署、集成、安全控制、支持和界面。权重无法自动取得正确手册、执行文档权限或保留审计轨迹。开放访问削弱了模型层保密优势,却没有补齐整个产品栈。
发布适配器可吸引开发者、大学、厂商及企业研究者,支持替代智能体循环、批准数据微调和失败审查;也让对手复制有用训练经验。Ivo似乎愿意承担这一风险,因为它预期模型会更可替代,客户语境才是持久差异。这是可检验的商业论点,不是行业定论;若部署负担超过收益,或封闭基础模型保有专业训练无法弥合的领先,托管平台仍有优势。
本地控制不等于零成本或自动治理
自行托管可将合同内容留在运营方控制的基础设施内,却不会自动解决权限、日志、模型治理和许可审查。DeepSeek来源仍可能引发采购、司法辖区和供应链问题。适配器相对紧凑,但大基础模型需要可观GPU容量才能实际部署。权重免费仍有计算、工程、评估、安全和法律监督成本。
组织知识也要维护。只有内部政策最新、可发现且关联正确事项,智能体才能应用。整理文件、任务指令、升级规则和可追责审查者,是系统组成,而非更强模型的可选替代品。下列知识库相关阅读说明这一检索难题,并不构成Sage法律准确性的验证证据。
独立复现应在可比条件下考察严格完成率、评审一致性、错误严重性、提示敏感性和工具稳定性。法律专家盲审可以判断数值提高是否带来更清楚、更实用的工作。有意义的外部采用是公开评估或采购、雇佣、隐私附件、特定辖区适配,而非仅有下载次数。
真实部署报告需要说明延迟、基础设施要求、失败处理及治理,解释全工作流,而非把改善都归于权重。竞争者不必开放模型,也可发布任务轨迹、允许客户控制测试、支持客户管理部署及披露严格完成率。沉默不证明能力差,但透明证据可能改变买家期望。
Sage眼下提供的是可检查的起点。它报告合同流程更强、步骤更少的同时,也说明可靠端到端法律判断尚未解决。独立团队能否复现收益、找到有效适配、审计承诺公开的Ivo-micro1结果,将决定其市场影响。无论未来测试如何,都不能以今天91.3%的逐项得分为取消合格律师审查的许可。
来源
Ivo Sage权重及评估材料 · Legal Agent Benchmark · 此前SaulLM-7B研究 · Ivo融资及产品公告 · 相关阅读:可检索技术文档知识库 · Google News聚合入口,非官方模型发布