
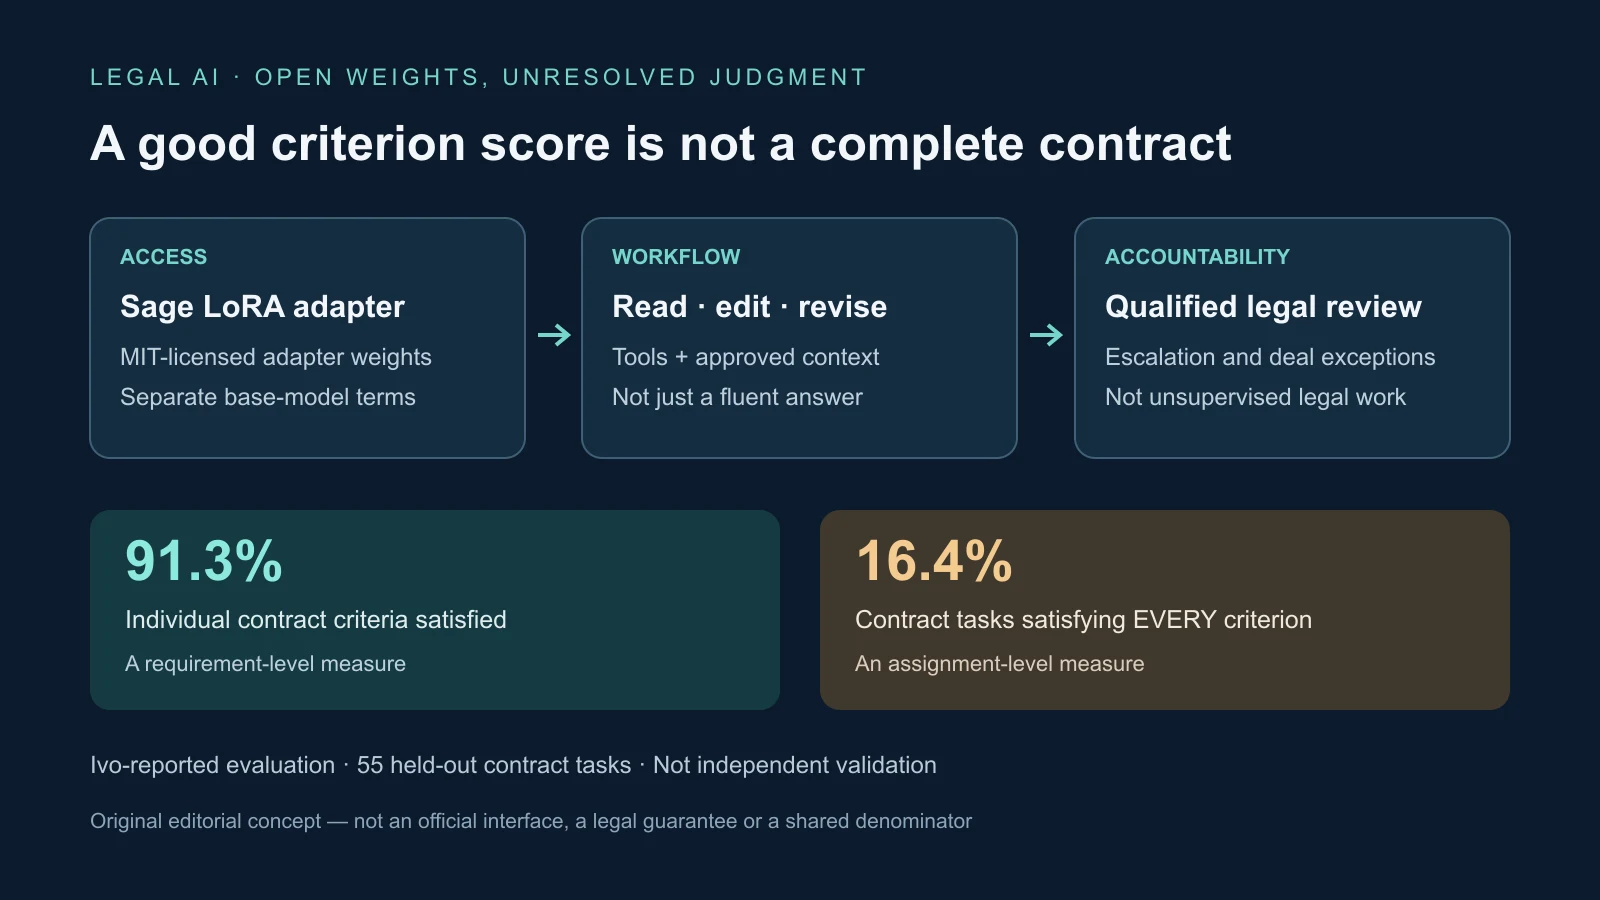
El modelo contractual abierto de Ivo presenta un argumento excepcionalmente verificable a favor de la IA jurídica especializada y revela cuánto trabajo queda. Sage, presentado el 1 de octubre de 2026 en la primera conferencia Ivo Inscribe de San Francisco, ofrece pesos del adaptador y registros detallados de evaluación. Su tasa reportada por criterio contractual llegó al 91,3%, pero solo el 16,4% de las tareas cumplió todos los requisitos. Son medidas muy diferentes del éxito.
El lanzamiento desafía el secreto en la capa del modelo, no demuestra que software abierto sustituya una plataforma jurídica comercial. Ivo destina el trabajo de Sage a la revisión de un abogado cualificado y no afirma superar a todos los modelos de frontera. Apuesta a que documentos organizativos, políticas de negociación y ejecución de procesos importarán más que el acceso exclusivo a modelos grandes.
Un adaptador para varias etapas, no un asesor jurídico de escritorio
Sage lee documentos, usa herramientas, redacta y revisa durante muchos pasos. Produce modificaciones contractuales, acuerdos y memorandos en lugar de respuestas aisladas. Una tarea puede requerir decenas de llamadas antes de guardar el archivo final. El entrenamiento debe premiar un resultado utilizable que siga instrucciones entre archivos relacionados, no solo lenguaje convincente.
Ivo no construyó un modelo fundacional desde cero. Sage consiste en pesos LoRA para DeepSeek V4 Flash, una mezcla de expertos de 284.000 millones de parámetros totales y 13.000 millones activos. Solo partes seleccionadas se activan por token, reduciendo cómputo frente a toda la red. LoRA cambia el comportamiento con un conjunto menor de pesos adicionales. El adaptador ocupa 12,2 GiB; se entrenaron proyecciones feed-forward y de salida manteniendo congelada la atención. El entrenamiento y evaluación descritos usaron 262.144 tokens de contexto.
La empresa afirma haber aplicado aprendizaje por refuerzo a 1040 tareas de Legal Agent Benchmark. Seis herramientas permitían leer, escribir, editar, buscar y navegar archivos. Los episodios terminaban al dejar de usar herramientas o alcanzar límites de turnos y generación. Localizar cláusulas, comparar fuentes, aplicar instrucciones y guardar revisiones vinculaba la recompensa al entregable, no a la fluidez conversacional.
Se publicaron listas de tareas, transcripciones, resultados, decisiones de jueces y registros de entrenamiento. La licencia MIT del adaptador suele permitir uso comercial, modificación y redistribución bajo sus condiciones, pero DeepSeek y los componentes asociados mantienen términos separados. Pesos abiertos no equivalen a una aplicación autónoma completamente abierta. Ivo recomienda SGLang con varias GPU; su ejemplo usa paralelismo tensorial de ocho vías en ocho aceleradores. Una descarga relativamente pequeña no implica una instalación pequeña.
Mejores medias no significan contratos completos
Ivo mantuvo contratos y documentos relacionados al mismo lado de la separación entrenamiento-validación para reducir filtraciones de casi duplicados. El conjunto reservado incluía 180 tareas: 125 generales y 55 contractuales. Cada tarea tuvo un episodio y tres pasadas de evaluación. Juzgar repetidamente el mismo resultado no significa tres intentos independientes de realizar la tarea.
El cumplimiento general por criterio pasó del 82,4% de la base al 91,5% de Sage. El cumplimiento estricto de todos los criterios subió del 7,2% al 15,6%. En contratos, los criterios pasaron del 70,1% al 91,3%, pero la finalización integral fue del 16,4%. Más de cuatro de cada cinco tareas seguían omitiendo algo bajo ese protocolo. Un fallo de formato y un escalado omitido pueden tener consecuencias muy distintas, aunque ambos impidan superar la evaluación estricta.
La eficiencia del entorno probado también mejoró: episodios medios de 31,2 a 25 turnos y tokens muestreados reducidos un 21%. En RedlineBench, excluido del entrenamiento, el resultado subió de 30,8 a 45,7. En 161 tareas LegalBench la media quedó casi igual, 83,0 frente a 83,1 de la base. Los resultados empresariales sugieren mejor trabajo contractual prolongado sin pérdida material en ese benchmark breve, no conservación universal de la capacidad jurídica.
Ivo eligió configuraciones, ejecutó competidores y publicó resultados. Jueces LLM puntuaron con rúbricas, introduciendo otro modelo en la medición. Tres pasadas y trazas públicas facilitan la inspección, pero no sustituyen replicación independiente ni abogados revisando asuntos reales. Cambios de bases, inferencia y marcos de agentes también pueden envejecer rápidamente los rankings.
Lo más difícil es saber cuándo oponerse o escalar
La conferencia anticipó Ivo-micro1 Contract Bench, que evalúa prioridad, moderación, adaptación al acuerdo, escalado y cumplimiento del manual. Las cifras preliminares describían modelos de frontera evaluados, no una segunda serie demostrada de resultados Sage. La empresa prometía datos públicos posteriores; los hallazgos de ella y su socio todavía no podían auditarse íntegramente desde fuera.
Según Ivo, las decisiones de aceptar o no cambiar eran correctas el 82% de las veces, cayendo al 46% cuando hacía falta contrapropuesta o rechazo. Los modelos añadían puntos nuevos obligatorios solo el 23% de las veces y cumplían, en promedio, el 23% de los criterios expertos de escalado. Son decisiones y criterios diferentes, no porcentajes generales intercambiables de exactitud.
También difería la edición. Los abogados hacían el 64% de los cambios de forma puntual dentro del texto, con media de 92 caracteres. Los modelos estaban en 14–37%, con ediciones medias de 207–369 caracteres. Las reescrituras amplias pueden alterar lenguaje negociado, alargar la revisión y ocultar el cambio preciso, incluso siendo razonables. Las posiciones estándar cumplían el 51% de los criterios; cuando los hechos cambiaban la respuesta correcta, bajaba al 38%.
El patrón explica por qué juzgar contratos va más allá de detectar cláusulas. Hay que saber cuándo mantener texto, resistir, añadir un punto o llamar a una persona. Contexto largo aporta documentos, no garantiza enlazar la disposición adecuada con la política correcta ni reconocer excepciones justificadas. Más herramientas crean ocasiones de error y deriva. Las categorías de fallo importan junto a las medias.
Qué está abierto y dónde queda la ventaja comercial
La afirmación de ser el “primero” necesita su calificación completa: modelo abierto de una empresa de IA jurídica, posentrenado para trabajo contractual prolongado. Los modelos jurídicos abiertos no empezaron con Sage. Equall publicó SaulLM-7B bajo MIT para textos jurídicos en 2024; investigadores ya crearon codificadores, razonamiento, recuperación y modelos jurisdiccionales. La novedad alegada combina entrenamiento contractual multietapa, pesos accesibles, licencia permisiva del adaptador y trazas públicas.
Min-Kyu Jung, cofundador y CEO, espera mejoras del contexto de trabajo: documentos, manuales y métodos establecidos, no solo modelos mayores. Encaja con Ivo, centrada en contratos de equipos internos, frente a competidores que cubren trabajo más amplio para despachos y empresas. Su anuncio de financiación de principios de 2026 describía un producto en Word para revisar cláusulas, identificar riesgos y sugerir cambios.
Harvey creó Legal Agent Benchmark, utilizado por Sage, pero compite mediante una plataforma propietaria. No es simplemente gratis frente a pago: los proveedores gestionados aportan despliegue, integraciones, seguridad, soporte e interfaces. Los pesos no recuperan automáticamente el manual correcto, aplican permisos ni conservan auditorías. La apertura debilita el secreto como ventaja del modelo sin proporcionar el resto del producto.
El adaptador puede atraer desarrolladores, universidades, proveedores e investigadores empresariales, permitiendo bucles alternativos, ajustes con datos aprobados y análisis de fallos. También deja copiar lecciones útiles a los rivales. Ivo parece aceptar el riesgo esperando modelos intercambiables y diferenciación duradera mediante el contexto del cliente. Es una tesis comprobable, no un desenlace seguro. Las plataformas gestionadas mantendrán ventaja si las cargas superan los beneficios o la especialización no alcanza bases cerradas superiores.
Control local no significa coste cero ni gobernanza automática
El autoalojamiento puede mantener contratos en infraestructura controlada, pero no resuelve automáticamente permisos, registros, gobernanza o licencias. El origen DeepSeek aún puede plantear cuestiones de compras, jurisdicción y cadena de suministro. El adaptador es compacto, pero la base grande requiere capacidad GPU considerable para un servicio práctico. Los pesos gratuitos dejan costes de cómputo, ingeniería, evaluación, seguridad y supervisión jurídica.
También hay que mantener el conocimiento organizativo. Los agentes aplican políticas solo si están actualizadas, localizables y vinculadas al asunto correcto. Documentos preparados, instrucciones, escalados y revisores responsables son partes del sistema. El artículo relacionado sobre bases de conocimiento ilustra ese reto de recuperación, no valida la exactitud jurídica de Sage.
La replicación independiente debería estudiar finalización estricta, coherencia de jueces, gravedad de fallos, sensibilidad a prompts y estabilidad de herramientas en condiciones comparables. La revisión ciega por expertos mostraría si las cifras producen trabajo más claro y útil. Adopción externa significativa implica evaluaciones o adaptaciones publicadas para compras, empleo, anexos de privacidad o jurisdicciones, no solo descargas.
Los informes productivos necesitan latencia, infraestructura, gestión de fallos y gobernanza, explicando todo el proceso en vez de atribuirlo todo a los pesos. Los rivales pueden responder sin abrir modelos mediante trazas de tareas, pruebas controladas por clientes, infraestructura del cliente y tasas estrictas. El silencio no demuestra inferioridad, pero evidencia transparente puede cambiar expectativas.
Sage ofrece hoy un punto de partida inspeccionable. El mismo lanzamiento que informa de flujos mejores y más breves muestra que el juicio jurídico integral fiable sigue sin resolverse. Replicaciones, adaptaciones útiles y auditoría de los prometidos resultados Ivo-micro1 determinarán el impacto. Ninguna prueba futura autoriza usar el 91,3% actual por criterio como permiso para eliminar la revisión jurídica cualificada.
Fuentes
Pesos y evaluaciones Sage · Legal Agent Benchmark · Investigación previa SaulLM-7B · Financiación y producto Ivo · Lectura relacionada: bases técnicas de conocimiento consultables · Entrada agregadora Google News, no lanzamiento oficial del modelo