
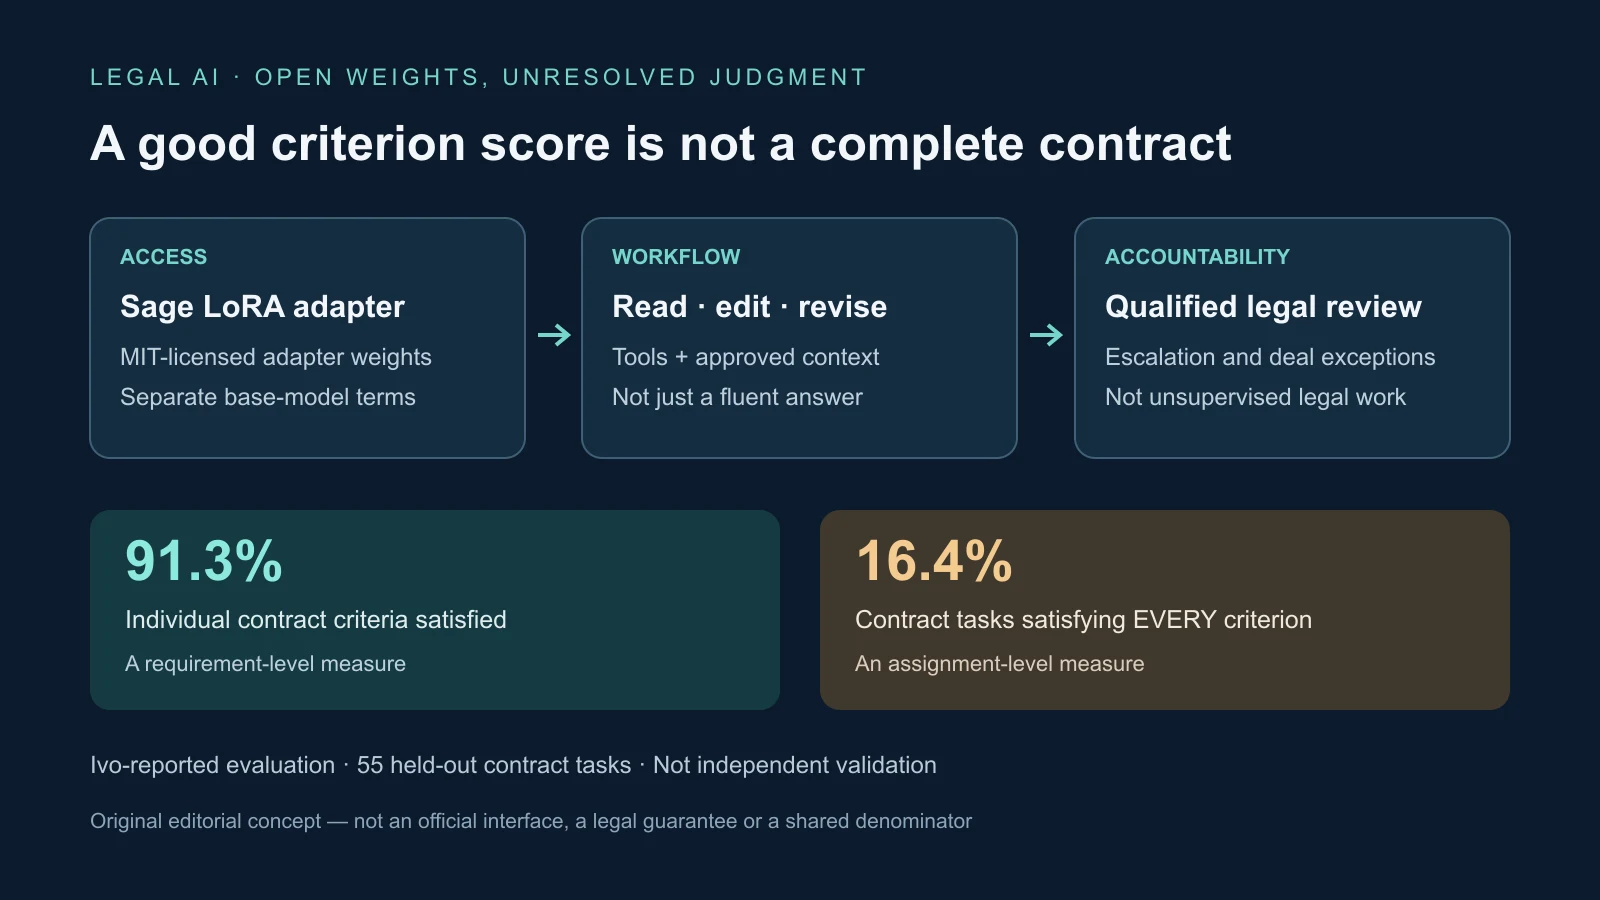
Otwarty model kontraktowy Ivo przedstawia wyjątkowo przejrzysty argument za specjalistyczną prawniczą AI i jednocześnie ujawnia, ile pracy pozostało. Sage, zaprezentowany 1 października 2026 r. podczas pierwszej konferencji Ivo Inscribe w San Francisco, oferuje wagi adaptera i szczegółowe zapisy ewaluacji. Raportowany odsetek spełnionych kryteriów umownych osiągnął 91,3%, ale tylko 16,4% zadań kontraktowych spełniło wszystkie wymagania. To zupełnie różne miary sukcesu.
Publikacja podważa tajność na poziomie modelu, nie dowodzi zastąpienia komercyjnej platformy przez otwarte oprogramowanie. Ivo wskazuje, że pracę Sage powinien sprawdzać wykwalifikowany prawnik, i nie deklaruje pokonania wszystkich modeli frontier. Strategiczny zakład dotyczy rosnącej roli dokumentów organizacji, polityk negocjacji i wykonania procesu zamiast wyłącznego dostępu do wielkiego modelu.
Adapter do wieloetapowej pracy, nie prawnik na komputerze
Sage czyta dokumenty, używa narzędzi, redaguje i poprawia przez wiele kroków. Tworzy zmiany umów, porozumienia i memoranda zamiast pojedynczych odpowiedzi. Przed zapisaniem dokumentu może wykonać dziesiątki wywołań narzędzi. Trening musi więc nagradzać użyteczny rezultat przestrzegający instrukcji między powiązanymi plikami, nie tylko przekonujący język.
Ivo nie zbudowało modelu bazowego od zera. Sage to wagi adaptera LoRA dla DeepSeek V4 Flash, modelu mixture-of-experts o 284 mld parametrów ogółem i 13 mld aktywnych. Dla tokenu uruchamia wybrane części sieci, oszczędzając obliczenia względem całej sieci. LoRA zmienia zachowanie mniejszym zestawem dodatkowych wag. Adapter ma 12,2 GiB; trenowano projekcje feed-forward i wyjścia przy zamrożonej uwadze. Opisany trening i ocena używały kontekstu 262 144 tokenów.
Firma podaje uczenie ze wzmocnieniem na 1040 zadaniach Legal Agent Benchmark. Sześć narzędzi obsługiwało czytanie, pisanie, edycję, szukanie i nawigację plików. Epizod kończył się przy zaprzestaniu narzędzi lub osiągnięciu limitów tur i generowania. Szukanie klauzul, porównanie źródeł, stosowanie instrukcji i zapis zmian sprawiały, że nagroda zależała od dokumentu, nie płynności rozmowy.
Opublikowano zadania, transkrypcje, rezultaty, decyzje oceniających i zapisy treningu. Licencja MIT adaptera zasadniczo dopuszcza komercyjne użycie, modyfikacje i redystrybucję na jej warunkach. DeepSeek i inne komponenty zachowują jednak odrębne zasady. Otwarte wagi nie są samodzielną, całkowicie otwartą aplikacją. Ivo zaleca SGLang na wielu GPU; przykład stosuje ośmiokierunkowy paralelizm tensorowy na ośmiu akceleratorach. Mniejszy plik nie oznacza małego wdrożenia.
Wyższe średnie nie oznaczają pełnych umów
Ivo umieściło powiązane umowy i źródła po tej samej stronie podziału trening–walidacja, ograniczając przeciek niemal duplikatów. Zbiór pozostawiony poza treningiem obejmował 180 zadań: 125 ogólnoprawnych i 55 kontraktowych. Każde miało jeden epizod i trzy przebiegi oceny. Wielokrotna ocena bada ten sam rezultat; nie oznacza trzech niezależnych prób wykonania zadania.
Ogólne spełnienie pojedynczych kryteriów wzrosło z 82,4% modelu bazowego do 91,5% Sage. Rygorystyczne spełnienie wszystkich wymagań wzrosło z 7,2% do 15,6%. Dla umów kryteria poprawiły się z 70,1% do 91,3%, ale pełne wykonanie osiągnęło 16,4%. Ponad cztery na pięć zadań nadal czegoś nie spełniały. Pominięcie formatu i eskalacji może mieć różne konsekwencje, choć oba blokują ścisłe zaliczenie.
Poprawiła się też efektywność w testowanym środowisku: średni epizod skrócił się z 31,2 do 25 tur, a próbkowane tokeny spadły o 21%. Na wyłączonym z treningu RedlineBench wynik wzrósł z 30,8 do 45,7. W 161 zadaniach LegalBench średnia prawie się nie zmieniła: 83,0 wobec 83,1 modelu bazowego. Wyniki firmy sugerują lepszą długą pracę kontraktową bez istotnej straty w tym krótkim benchmarku, nie powszechne zachowanie wszystkich kompetencji.
Konfiguracje, konkurencyjne uruchomienia i publikację wybrało Ivo. Sędziowie LLM oceniali według rubryk, więc pomiar zawierał kolejny model. Trzy oceny i jawne ślady ułatwiają kontrolę, lecz nie zastępują niezależnej replikacji ani prawników oceniających realne sprawy. Zmiany modeli bazowych, inferencji i frameworków agentów mogą szybko zdezaktualizować rankingi.
Trudniej wiedzieć, kiedy się sprzeciwić lub eskalować
Na konferencji zapowiedziano Ivo-micro1 Contract Bench badający priorytety, powściągliwość, adaptację do transakcji, eskalację i stosowanie wytycznych. Wstępne liczby dotyczyły testowanych modeli frontier, a nie kolejnych udowodnionych wyników Sage. Firma zapowiedziała publiczne dane później; wyników firmy i partnera nie można było wtedy w pełni zewnętrznie skontrolować.
Według Ivo modele poprawnie podejmowały decyzje o akceptacji lub braku zmian w 82% przypadków, ale o kontrpropozycji lub odrzuceniu w 46%. Dodawały potrzebne nowe punkty negocjacyjne w 23% przypadków i spełniały średnio 23% eksperckich kryteriów eskalacji. Są to różne decyzje i kryteria, nie zamienne wskaźniki ogólnej trafności.
Różnił się też styl edycji. Prawnicy wykonywali 64% zmian bezpośrednio w istniejącym tekście, średnio 92 znaki. Modele miały 14–37% takich zmian i średnio 207–369 znaków edycji. Szerokie przeróbki mogą naruszać uzgodnione brzmienie, zwiększać czas przeglądu i zacierać dokładną zmianę, nawet brzmiąc rozsądnie. Standardowe stanowiska spełniały 51% kryteriów, a zmiana właściwej reakcji przez fakty transakcji obniżała wynik do 38%.
To wyjaśnia, dlaczego osąd kontraktowy wykracza poza detekcję klauzul. System musi wiedzieć, kiedy pozostawić tekst, sprzeciwić się, dodać punkt lub oddać decyzję człowiekowi. Długi kontekst zapewnia dokumenty, nie gwarantuje dopasowania właściwej klauzuli do polityki ani uzasadnionego wyjątku. Więcej narzędzi to kolejne okazje błędów i odchyleń. Klasy błędów liczą się obok średnich.
Co jest otwarte i gdzie pozostaje przewaga komercyjna
Twierdzenie Ivo o „pierwszym” wymaga pełnego ograniczenia: otwarty model firmy prawniczej AI dodatkowo trenowany do wieloetapowej, długotrwałej pracy z umowami. Otwarte modele prawne nie zaczęły się od Sage. Equall opublikował w 2024 r. SaulLM-7B na MIT dla tekstów prawnych, a badacze tworzyli enkodery, modele rozumowania, wyszukiwanie i modele jurysdykcyjne. Deklarowana nowość łączy trening kontraktowy, dostępne wagi, liberalną licencję adaptera i jawne przebiegi.
Współzałożyciel i CEO Min-Kyu Jung oczekuje kolejnych korzyści z kontekstu pracy: dokumentów, wytycznych negocjacyjnych i utrwalonych metod zespołu, nie tylko większych modeli. Pasuje to do skupienia Ivo na umowach działów wewnętrznych, podczas gdy inni obsługują szerszą pracę kancelarii i przedsiębiorstw. Ogłoszenie finansowania z początku 2026 r. opisywało produkt w Wordzie do przeglądu klauzul, wykrywania ryzyka i proponowania zmian.
Harvey stworzył Legal Agent Benchmark użyty do treningu Sage, lecz konkuruje własnościową platformą. Darmowe kontra płatne nie wystarcza: dostawcy zapewniają wdrożenie, integracje, bezpieczeństwo, wsparcie i interfejsy. Wagi nie pobiorą same właściwych wytycznych, nie egzekwują praw dokumentów i nie zachowają ścieżki audytu. Otwarty dostęp osłabia tajność modelu jako przewagę, nie dostarcza reszty produktu.
Adapter może przyciągnąć programistów, uczelnie, dostawców i badaczy firm, umożliwiając alternatywne pętle agentów, dostrajanie zatwierdzonymi danymi i analizę błędów. Pozwala też rywalom kopiować użyteczne wnioski. Ivo najwyraźniej akceptuje to, oczekując wymienności modeli i trwałej roli kontekstu klienta. To sprawdzalna teza biznesowa, nie przesądzony rezultat. Platformy zarządzane zachowają przewagę, jeśli obciążenia przewyższą korzyści albo specjalizacja nie dogoni zamkniętych modeli.
Lokalna kontrola nie oznacza zerowego kosztu ani automatycznej ochrony
Samodzielny hosting utrzymuje umowy w kontrolowanej infrastrukturze, ale nie rozwiązuje automatycznie uprawnień, logów, nadzoru modelu ani licencji. Pochodzenie DeepSeek może nadal rodzić pytania o zakupy, jurysdykcję i łańcuch dostaw. Adapter jest niewielki względem bazy, ale duży model wymaga znacznych GPU do praktycznej obsługi. Darmowe wagi pozostawiają koszty obliczeń, inżynierii, ewaluacji, bezpieczeństwa i prawnego nadzoru.
Wiedzę organizacji też trzeba utrzymywać. Agenci zastosują polityki tylko, gdy są aktualne, dostępne i przypisane do właściwej sprawy. Uporządkowane dokumenty, instrukcje, eskalacje i odpowiedzialni oceniający są częścią systemu. Powiązany artykuł o bazie wiedzy poniżej ilustruje problem wyszukiwania, nie stanowi walidacji prawniczej trafności Sage.
Niezależna replikacja powinna badać ścisłe ukończenie, spójność ocen, wagę błędów, wrażliwość na prompty i stabilność narzędzi w porównywalnych warunkach. Zaślepiona ocena ekspertów pokaże, czy liczby przekładają się na jaśniejszą, użyteczną pracę. Znaczące wdrożenie to opublikowane oceny i adaptacje do zakupów, zatrudnienia, dodatków prywatności lub jurysdykcji, nie tylko pobrania.
Raporty produkcyjne potrzebują opóźnień, wymagań infrastruktury, obsługi awarii i zasad zarządzania, z opisem całego procesu zamiast przypisywania wszystkiego wagom. Rywale mogą odpowiedzieć bez otwierania modeli: śladami zadań, testami pod kontrolą klienta, hostingiem klienta i ścisłymi wskaźnikami ukończenia. Milczenie nie dowodzi słabości, ale przejrzyste dane mogą zmienić oczekiwania nabywców.
Sage daje dziś sprawdzalny punkt wyjścia. Ta sama publikacja raportuje lepszą i krótszą pracę z umowami oraz nierozwiązany niezawodny osąd od początku do końca. Replikacje, użyteczne adaptacje i audyt obiecanych wyników Ivo-micro1 zdecydują o wpływie rynkowym. Żaden przyszły test nie uprawnia do traktowania dzisiejszych 91,3% kryteriów jako pozwolenia na usunięcie wykwalifikowanego przeglądu prawnego.
Źródła
Wagi i oceny Sage · Legal Agent Benchmark · Wcześniejsze badania SaulLM-7B · Finansowanie i produkt Ivo · Powiązana lektura: przeszukiwalne techniczne bazy wiedzy · Agregacja Google News, nie oficjalna publikacja modelu