
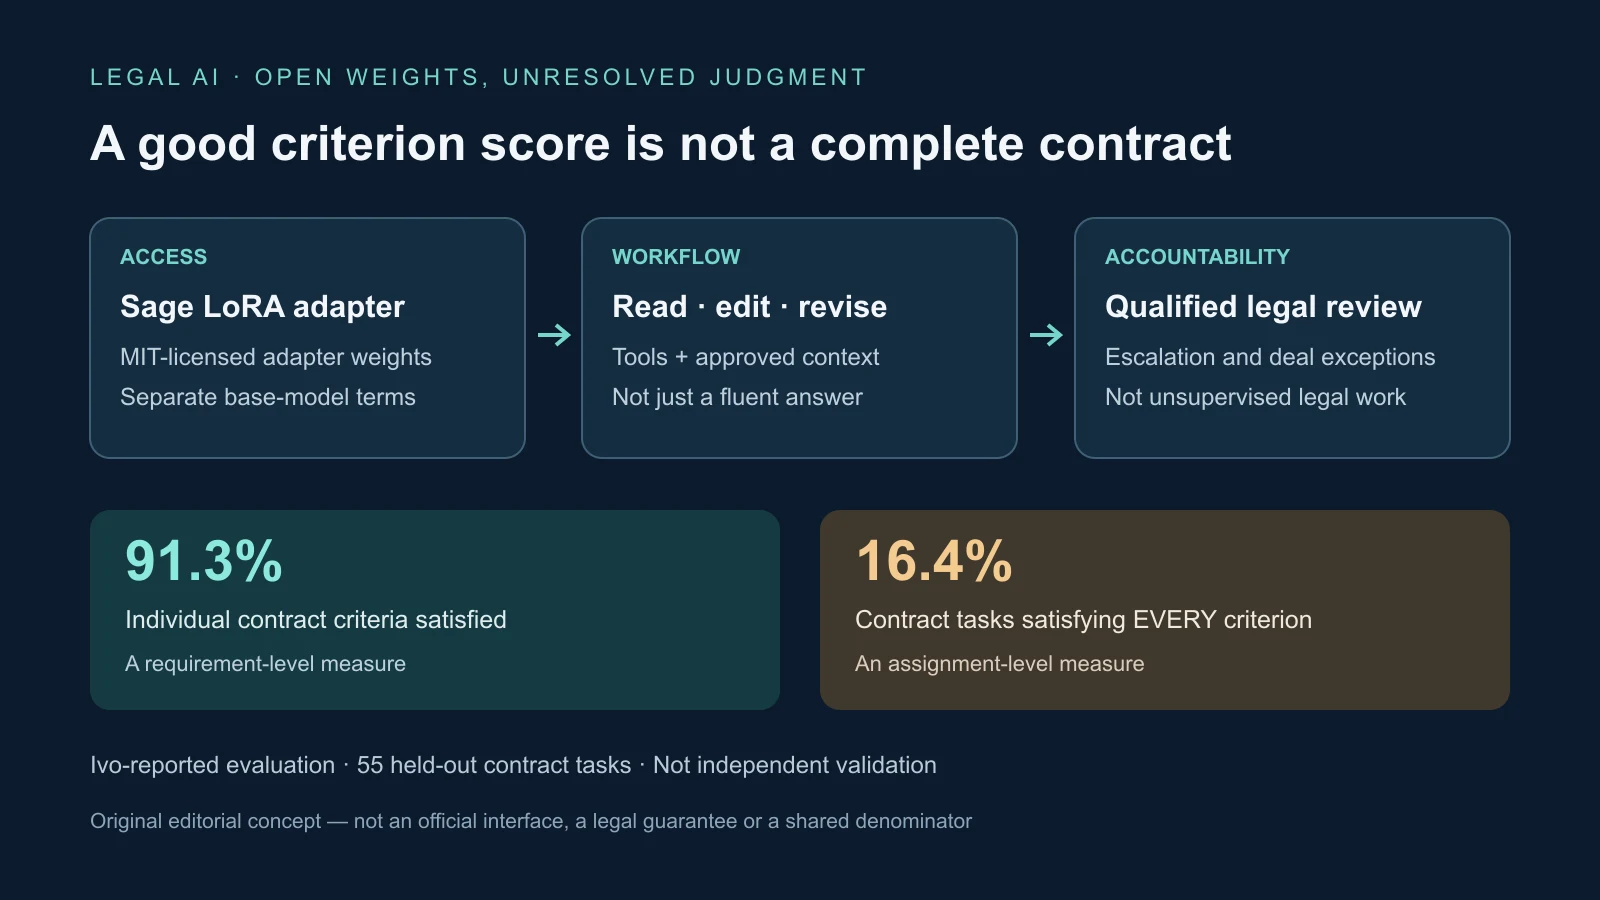
Ivoのオープン契約モデルは、専門法務AIの価値を検証しやすい資料とともに提示し、残された課題も明らかにした。2026年10月1日、San Franciscoで初開催されたIvo Inscribe顧客会議で発表されたSageは、ダウンロード可能なアダプター重みと詳細な評価記録を提供する。契約の個別基準通過率は91.3%に達したが、全要件を満たした契約案件は16.4%だった。二つは全く異なる成功指標である。
今回の公開はモデル層の秘密主義に挑むもので、オープンソフトが商用法務プラットフォームを代替する証明ではない。Ivoは、Sageの成果物を有資格弁護士が確認する用途だと説明し、全フロンティアモデルに勝るとも主張していない。組織固有の文書、交渉方針、業務実行が大型モデルの独占利用より重要になる、という戦略的な賭けだ。
多段階業務のアダプターであり、デスクトップ法律顧問ではない
Sageは文書を読み、ツールを使い、複数段階で起案・修正して、単発回答ではなく契約修正稿、合意書、法務メモを作る。最終文書の保存まで数十回のツール呼び出しを要し得る。訓練が報酬を与えるべきものも変わる。説得力のある文章だけでなく、関連ファイルを横断して指示に従う使える成果物である。
Ivoは基盤モデルをゼロから作っていない。SageはDeepSeek V4 Flash向けLoRAアダプター重みだ。ベースは総2,840億、アクティブ130億パラメータの混合専門家モデルで、トークンごとに一部を動かし全体稼働より計算を減らす。LoRAは比較的小さな追加重み群で挙動を変える。アダプターは12.2 GiBで、Ivoは注意重みを固定し、フィードフォワードと出力投影を訓練した。報告された訓練・評価のコンテキストは262,144トークンだった。
同社はLegal Agent Benchmarkの1,040案件で強化学習したという。六つのツールが読解、作成、編集、検索、ファイル移動を支え、ツール利用停止か規定のターン・生成制限でエピソードが終了した。条項探索、出典比較、指示適用、修正保存という契約業務に対し、会話の流暢さではなく成果物が報酬につながった。
公開資料には案件一覧、記録、成果物、判定、訓練記録がある。MITライセンスは条件の下で通常、商用利用・変更・再配布を認めるが、DeepSeekベースと関連部品には別条件が残る。オープンアダプターは自己完結した完全オープンアプリではない。Ivoは複数GPUでSGLangを使う配信を推奨し、例は八つのアクセラレータによる8方向テンソル並列だ。小さめのダウンロードは小規模な運用を意味しない。
平均改善は契約の完了を意味しない
Ivoは近似文書の漏洩を減らすため、関連契約と原資料を訓練・検証分割の同じ側に置いた。保持した180案件は一般法務125件、契約55件。案件ごとに一つのエピソードを実行し、三回判定した。繰り返し判定は一つの成果物を評価することで、案件を独立に三回試したことではない。
全体の個別基準通過率はベースの82.4%から91.5%へ、全基準を満たす厳格完了率は7.2%から15.6%へ上昇した。契約では個別基準が70.1%から91.3%になったが、全基準完了は16.4%だった。この手順では5件中4件超が何かを欠く。書式指示漏れとエスカレーション漏れの結果は大きく異なり得るが、どちらも厳格合格を妨げる。
評価環境では効率も改善し、平均31.2ターンが25へ、サンプリングトークンは21%減った。訓練外のRedlineBenchは30.8から45.7へ。LegalBenchの161タスク平均はベース83.1に対し83.0でほぼ不変だった。長い契約業務を改善し、この短形式ベンチマークで重大な損失がなかったことを会社結果は示唆するが、全法務能力の維持は立証しない。
構成選択、競合実行、報告はIvo自身だ。LLM判定が成果物を基準表で採点し、測定にも別モデルが入る。三回判定と公開記録は検査可能性を高めても、独立再現や有資格弁護士による実案件審査の代わりにはならない。ベース、推論システム、エージェント枠組みの変化で順位も古くなる。
より難しいのは、反対やエスカレーションの判断
会議ではIvo-micro1 Contract Benchも予告された。優先順位、抑制、取引への適応、エスカレーション、方針遵守を測るものだ。予備数値は試験対象フロンティアモデルの結果であり、Sageについて実証された別結果ではない。公開データは後日とされ、当時は会社と協力先の発見を外部から全面監査できなかった。
Ivoによると、受諾・変更不要の判断は82%正しかったが、対案や拒否が必要な場合46%へ下がった。必要な新交渉点の追加は23%、専門家定義のエスカレーション基準充足も平均23%だった。別々の判断や基準であり、同じ総合正答率として扱えない。
編集方法も異なった。弁護士は変更の64%をインラインで行い、平均92文字。モデルは14~37%で、編集長は平均207~369文字だった。長い書き直しは妥当でも交渉済み表現を崩し、確認時間を増やし、変更箇所を曖昧にする。標準方針の基準は51%満たしたが、取引事実で正しい対応が変わると38%だった。
この傾向は、契約判断が条項検出だけではない理由を示す。原文を残す時、抵抗する時、論点を加える時、人に渡す時を判断しなければならない。長いコンテキストは文書を収めても、正しい条項と方針の接続や正当な例外の認識を保証しない。ツール呼び出し追加は誤り・逸脱の機会にもなる。平均だけでなく失敗分類が重要だ。
何がオープンで、商業的な強みはどこに残るか
Ivoの「初」には、法務AI会社が公開し長期契約業務向けに後訓練したオープンモデル、という全限定が必要だ。オープン法務モデルはSage以前からある。Equallは2024年にMIT版SaulLM-7Bを法律文書向けに出し、研究者は法務エンコーダー、推論、検索、法域特化モデルを作った。Sageが主張する新規性は、多段階契約訓練、取得可能な重み、寛容なアダプター許諾、公開記録の組合せにある。
共同創業者・CEOのMin-Kyu Jungは、次の改善は単に大型化ではなく文書、交渉方針、既存のチーム手法という業務文脈から生まれると考える。社内法務の契約に注力するIvoと、より幅広い法律事務所・企業業務を扱う競合の違いにも沿う。2026年前半の資金調達発表は、Word内で条項確認、リスク発見、修正提案を行う製品を説明した。
HarveyはSage訓練に使ったLegal Agent Benchmarkを作ったが、競争の基盤は専有法務プラットフォームだ。無料対有料だけではない。管理型企業は導入、連携、安全制御、支援、画面を提供する。重みだけでは適切な方針取得、文書権限、監査履歴を実装できない。公開はモデル層の秘密を弱い優位にしても、製品全体を供給しない。
公開は開発者、大学、業者、企業研究者を呼び込み、別のエージェントループ、承認データでの調整、失敗検査を可能にする一方、競合にも訓練知見を与える。Ivoはモデルが代替可能になり顧客文脈が持続的差になると見込み、リスクを受け入れるようだ。確定した業界結論ではなく検証可能な事業仮説である。導入負担が利益を上回るか、閉鎖基盤の差を専門化で埋められなければ管理型が有利だ。
ローカル管理は無料運用や自動統治ではない
自己運用は契約情報を管理下の設備に置けるが、権限、記録、モデル統治、ライセンス確認を自動解決しない。DeepSeek由来の調達、法域、供給網の問題も残り得る。小型のアダプターの下に大型基盤があり実用配信には相当なGPUが必要だ。重みが無料でも計算、開発、評価、安全確認、法律監督に費用がかかる。
組織知識の維持も必要である。内部方針が最新で見つけられ、正しい案件に結び付いて初めてエージェントは適用できる。整備文書、案件指示、エスカレーション規則、責任者はシステムの一部だ。下記の知識ベース関連記事は検索の課題を説明するもので、Sageの法務正確性を検証する証拠ではない。
独立再現は同等条件で厳格完了、判定一致、誤り重大性、プロンプト感度、ツール安定性を調べるべきだ。専門家の盲検確認なら数値が明瞭で使える成果に転換するかを測れる。意味ある外部採用は、調達・雇用・プライバシー追加条項・特定法域の評価や派生公開であり、ダウンロード数だけではない。
運用報告には遅延、設備要求、失敗処理、統治が必要で、全改善を重みに帰さず業務全体を説明しなければならない。競合は重みを開かずとも案件記録、顧客管理テスト、顧客運用配置、厳格完了率で応答できる。沈黙は劣位を証明しないが、透明な証拠は買い手の期待を変え得る。
Sageの当面の貢献は検査できる出発点だ。強化・短縮された契約作業と同時に、信頼できる一貫した法律判断が未解決とも示した。独立再現、有用な派生、約束されたIvo-micro1結果の監査が市場への影響を決める。将来の検査はどれも、今の91.3%という個別基準率を有資格者の審査撤廃の根拠にはしない。
出典
Sage重みと評価資料 · Legal Agent Benchmark · 以前のSaulLM-7B研究 · Ivo資金調達・製品発表 · 関連記事:技術文書の検索可能な知識ベース · Google News集約入口:公式モデル公開ではない