
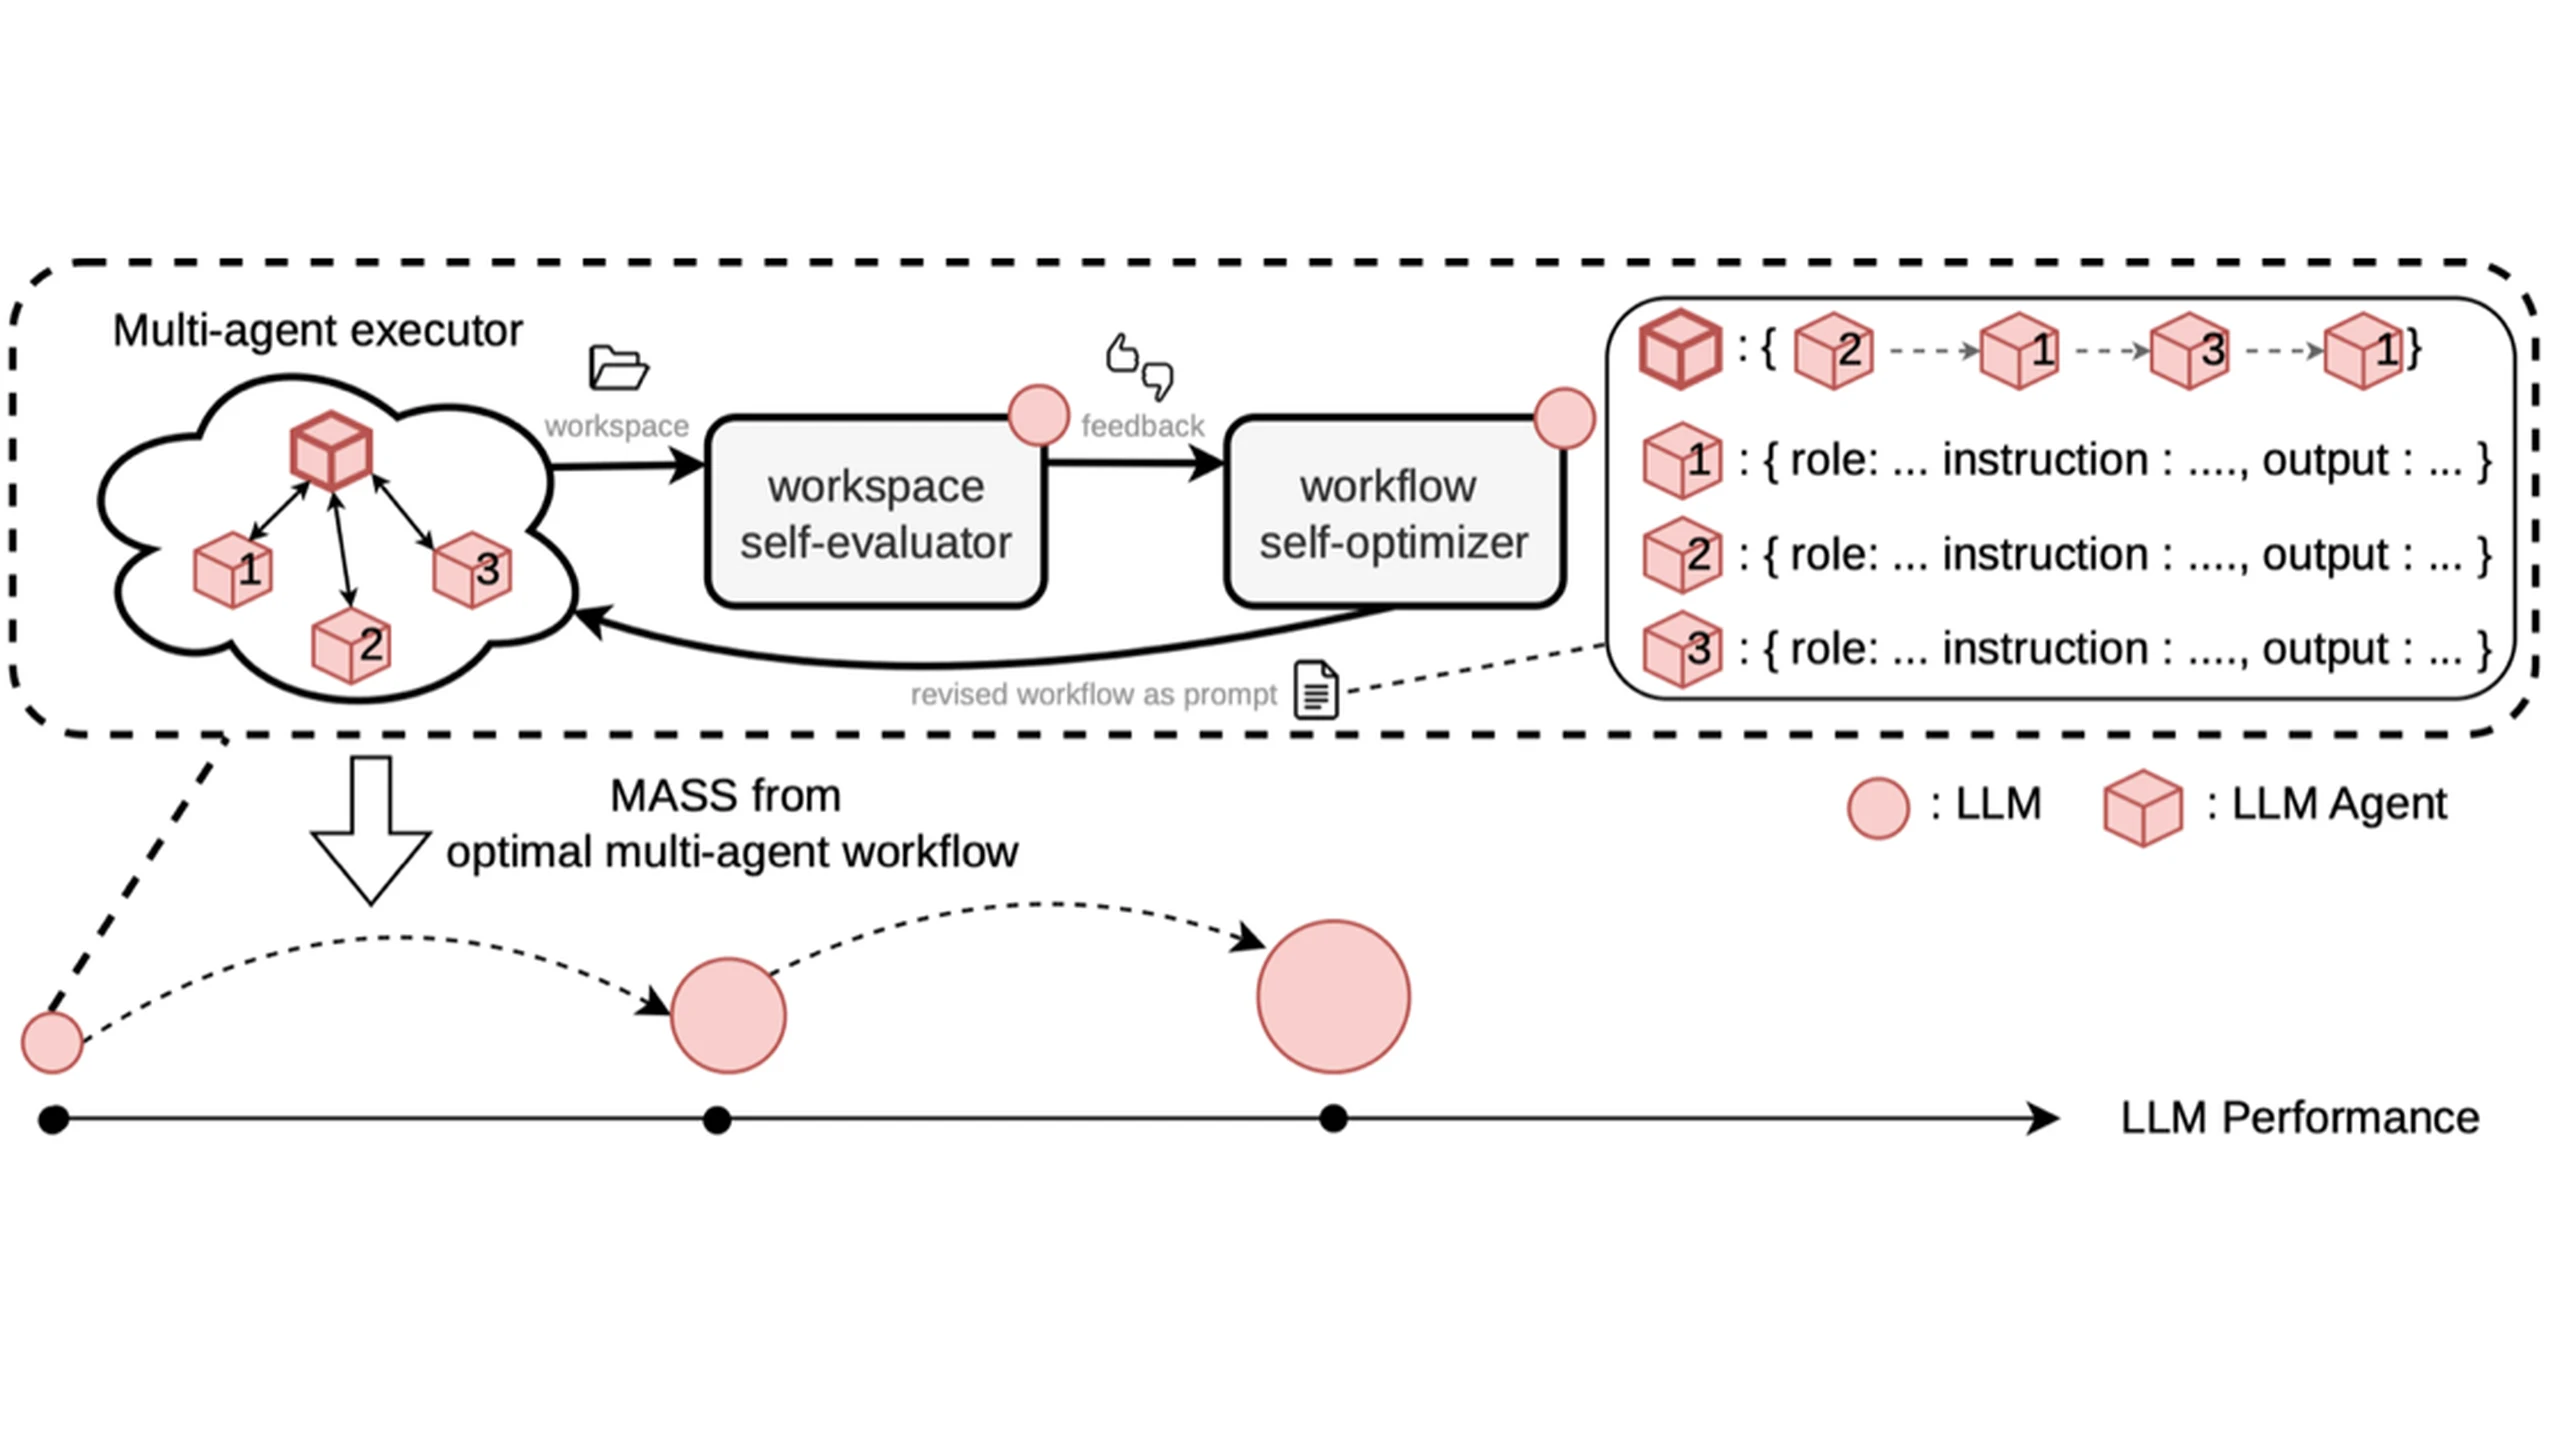
Sakana AI hat zwei Zyklen von Multi-Agent Self-Supervision, kurz MASS, abgeschlossen. Kopien eines Modells erledigen Forschungsaufgaben, bewerten die Ergebnisse und verwenden ausgewählte Abläufe als Trainingsdaten für ihren gemeinsamen Nachfolger. Die berichteten Verbesserungen sind experimentelle Ergebnisse, fallen aber ungleich aus: Forschungsbenchmarks steigen, zwei Softwareentwicklungsbenchmarks sinken. Das ist begrenztes Nachtraining, kein Beleg für eine autonome Intelligenzexplosion.
Die am 8. Oktober 2026 eingereichte Arbeit und die offene Implementierung enthalten Aufgabenprompts, Trainingskonfigurationen, Evaluationswerkzeuge und Pipeline-Dokumentation. Sie zeigen zugleich die Grenzen des Begriffs „rekursiv“: nur zwei vollständige Zyklen, wenige Aufgaben und ein Modell, das als Ausführer, Optimierer und Bewerter denselben Fehler wiederholen kann.
Von der Teamarbeit zum Modellupdate
Übliche Multi-Agenten-Inferenz verteilt Aufgaben auf Modellinstanzen und kombiniert ihre Ergebnisse, ohne die Gewichte zu ändern. MASS bewahrt dagegen Nachrichten, Werkzeugaufrufe, Zwischenprodukte und Resultate als Trainingsabläufe. Verschiedene Instanzen übernehmen verschiedene Arbeiten, teilen jedoch dasselbe Modell und sind keine unabhängig trainierten Fachleute.
Die innere Schleife hält die Gewichte fest und sucht einen besseren promptbasierten Workflow. Dieser legt Rollen, Anweisungen, Ausgabeverträge und Kommunikationsschritte fest. Jede Trainingsaufgabe besitzt einen bisher besten Workflow. Ein Kandidatenteam bearbeitet sie, das Modell vergleicht dessen Arbeitsbereich mit dem bisherigen Sieger, und der Optimierer schlägt anhand des Urteils eine Überarbeitung vor.
Nach der Auswahl führt MASS den Workflow 18-mal pro Aufgabe aus. Paarweise Modellurteile ordnen die Arbeitsbereiche; ein Bradley–Terry-Modell wandelt Präferenzen in Werte um. Höchstens 16 Abläufe bleiben erhalten: 15 können Training liefern, einer dient der Validierung. Der Workflowtext wird vor dem Training aus dem anfänglichen Orchestrator-Prompt entfernt. So soll das Modell Organisation aus der Aufgabe ableiten, nicht nur einen vorgegebenen Plan kopieren.
Die äußere Schleife verwendet Low-Rank Adaptation, LoRA, zum Feinabstimmen eines begrenzten Parametersatzes. Gespräche des Orchestrators und der Unteragenten sind Trainingsziele. Danach übernimmt das aktualisierte Modell erneut alle drei Rollen. „Rekursiv“ ist insofern vertretbar, als eine Generation Daten ihres Nachfolgers erzeugt und auswählt. Menschen bestimmen weiterhin Architektur, Aufgaben, Optimierung, Benchmarks, Recheninfrastruktur und Zyklusgrenzen.
Forschungsgewinne mit klarer Transfergrenze
Grundlage ist Qwen3.6-27B in einer Coding-Agenten-Umgebung. Die synthetische Sammlung enthält zwölf Forschungsaufgaben aus Finanzen, Robotik und Pharmazie, jeweils mit Code, quantitativer Analyse und Bericht. Neun waren für das Training vorgesehen, tatsächlich lieferten acht Daten. Drei, je eine pro Fachgebiet, blieben von Feinabstimmung, Validierung und Checkpoint-Auswahl ausgeschlossen.
GPT-5.5 und Claude Opus 4.8 bewerteten fertige Arbeitsbereiche extern; sie waren keine Lehrer in der Trainingsschleife. Bei den drei zurückgehaltenen Aufgaben gewann das Modell nach Runde eins 53,9% der Vergleiche mit der Basis, nach Runde zwei 69,9%. Runde zwei schlug Runde eins in 60,8%. Auf Trainingsaufgaben betrugen die Siege gegen die Basis 65,6% und 82,5%. Die stärkeren Trainingsergebnisse müssen von den zurückgehaltenen Belegen getrennt bleiben.
Für öffentliche Forschungsbenchmarks meldet Sakana nach Runde zwei das 1,2- bis 1,6-Fache des Basiswerts pro Ausgabetoken. MLR-Bench stieg von 1,71 auf 2,25; die Papierabgabequote von 57% auf 76%. ScienceAgentBench verbesserte sich von 28,8% auf 31,7%. AstaBench E2E-Hard stieg von 0,053 auf 0,067, seine Berichtsabgabequote von 50% auf 76%. DSBench veränderte sich nur von 0,473 auf 0,482. Ein besseres Effizienzverhältnis macht diese kleine absolute Differenz nicht zu einem großen Leistungsgewinn.
Softwareentwicklung verlief entgegengesetzt. Terminal-Bench 2.0 sank von 0,375 auf 0,352, SWE-bench Verified von 0,626 auf 0,611. Pro Ausgabetoken erreichten sie das 0,96- beziehungsweise 0,94-Fache der Basis. Das Modell ist damit nicht durchgehend stärker.
Eine plausible Erklärung ist die Aufgabenpassung: Forschung, quantitative Belege und Code dominierten das Training, nicht Repository-Fehlersuche oder Terminalarbeit. Zusätzliche Softwareaufgaben könnten laut Sakana helfen, sind aber ungetestet und könnten vorhandene Fähigkeiten beeinträchtigen. Echte Transfertests müssen neue Bereiche und den Erhalt alter Fähigkeiten prüfen.
Welche Kosten die Effizienzwerte auslassen
Ein Multi-Agenten-Schülermodell erreichte in einem Trainingsvergleich mit 28,8 Millionen überwachten Tokens eine Gewinnrate von 68,3%. Das größte Einzelagenten-Schülermodell erreichte mit 42 Millionen Tokens 64%. Das ist ein besseres Ergebnis mit 31% weniger überwachten Tokens, kein Nachweis für 31% geringere gesamte Entwicklungskosten.
Vor der Auswahl erzeugten Teams durchschnittlich etwa 2,4-mal so viele Tokens. Externe Bewerter bevorzugten ihre Arbeit in 85,1% der Vergleiche mit Einzelagenten-Ausgaben. Bei zehn Paaren mit ähnlicher Ablauflänge gewannen Teams noch 80%. Das spricht für nützliche Beispiele durch Koordination und Auswahl, isoliert Delegation aber nicht: Workflows und Prüfanweisungen unterschieden sich ebenfalls.
Werte pro Ausgabetoken messen produktiven Output, nicht die gesamte Pipeline. Workflow-Suche, Wiederholungen, Vergleiche, Datenerzeugung und Evaluation kosten zusätzlich Rechenleistung. Überwachte Tokenzahlen enthalten weder Eingabetokens noch mehrere vorgelagerte Kosten. MASS belegt daher konzentriertere ausgewählte Trainingsdaten; die Gesamtwirtschaftlichkeit braucht eine vollständigere Rechnung.
Informationsverträge statt bloßer Rollenbilder
Die Suche verändert Rollen, Anweisungen, Verträge und Kommunikationsschritte. Ein Vertrag definiert zurückzuliefernde Belege oder Artefakte; ein Kommunikationsschritt bestimmt die Weitergabe oder erneute Prüfung. Das ist konkreter, als mehrere Kopien Forscher, Kritiker oder Redakteur spielen zu lassen.
In einem Finanzbeispiel bearbeiten Agenten Datenaufbereitung, Merkmalsbildung, Modellierung, Backtests, Audit, Abgleich und Bericht. Der Datenagent muss angeben, ob Zukunftsinformationen in historische Entscheidungen gelangt sind. Die Vorgabe adressiert einen echten Fehler: Ein überzeugender Backtest kann bloß damals nicht verfügbare Daten benutzt haben.
Sakanas Textanalyse fand Aufgabeninformation zunehmend in Verträgen und Kommunikationsreihenfolge, weniger in Rollen und allgemeinen Anweisungen. Je nach Vergleich umfasst die Stichprobe nur acht oder neun Aufgaben. Die Schätzungen gegenseitiger Information betreffen Workflowtexte, nicht sämtliche ausgetauschten Nachrichten. Das ist ein Mechanismushinweis, kein breiter Kausalnachweis.
Frühere Forschung zu Multi-Agenten-Debatten untersuchte Gewinne durch ausgetauschte Antworten und Kritik. MASS überträgt ausgewähltes kollektives Verhalten in Gewichte: Orchestrator-Abläufe lehren Zerlegung und Koordination, Unteragenten-Abläufe begrenzte Arbeiten. Eine durchsuchbare technische Wissensbasis verdeutlicht den organisatorischen Wert prüfbarer Belege und Entscheidungen, ist jedoch keine unabhängige Validierung von MASS.
Optimierer und Bewerter teilen Grenzen
Ein Modell in drei Rollen verringert die Abhängigkeit von einem dauerhaft stärkeren Lehrer, erzeugt aber korrelierte Fehler. Der Ausführer missversteht eine Aufgabe, der Bewerter belohnt das Missverständnis, und das Nachfolgemodell lernt es selbstbewusster. Zufallsstichproben und spezialisierte Aufträge schaffen Variation, keine unabhängigen Trainingsgeschichten oder garantiert unabhängigen Urteile.
Sakanas Projektübersicht bezeichnet gemeinsame blinde Flecken als Sicherheitsproblem. Die Übereinstimmung interner und externer Bewerter stieg über drei Modellgenerationen von 73% auf 93%. Das ist für diese Aufgaben ermutigend, aber kein Richtigkeitsbeweis: Bewerter können Annahmen teilen, ausgefeilte Berichte bevorzugen oder Fehler übersehen, die reale Versuche erfordern.
Auch Optimiererstärke begrenzte den Prozess. Bei Tests mit Basis-Qwen als Ausführer brachte GPT-5.5 allein als Bewerter nur begrenzte Verbesserung. Als Bewerter und Optimierer fand es binnen fünf Suchiterationen erfolgreiche Workflows für alle zwölf Aufgaben. Die homogene Schleife fand schließlich Gewinner für elf von zwölf, benötigte aber bis zu 13 Iterationen. Gute Kritik reicht nicht, wenn der Optimierer sie nicht in bessere Prozesse übersetzt.
Die Suche war zudem instabil: Auf starke Iterationen konnten deutliche Rückschritte folgen. In der ursprünglichen Berichterstattung erwähnte Community-Kritik hinterfragte den rekursiven Begriff und das Ende nach zwei Runden. Präziser ist die Beschreibung als menschlich begrenzte iterative Workflow-Suche mit überwachter Feinabstimmung, nicht als uneingeschränktes Selbstumschreiben oder Beleg endlosen Fortschritts.
Aufsicht muss mit den Fähigkeiten wachsen
Forschung ohne automatische Erfolgsregel ist besonders anfällig für Selbstbestätigung. Ein schlüssiger Bericht kann einen Denkfehler enthalten, Gegenbelege auslassen oder in lauffähigem Code das falsche Ziel umsetzen. Modellkonsens entscheidet nicht allein über wissenschaftliche Neuheit, Strategie, Werte oder Sicherheit.
OpenAIs Forschung zur Überwachbarkeit zeigt, dass Denkspuren mehr als Handlungen und Endantworten verraten können. Überwachung bleibt jedoch unvollständig und hängt von Agent und Beobachter ab. Die reichhaltigen MASS-Abläufe schaffen Prüfgelegenheiten und Verstecke. Die Optimierung sichtbaren Denkens kann überzeugende Erklärungen belohnen, ohne Verhalten zu korrigieren.
Anthropics Diskussion rekursiver Selbstverbesserung betont ebenfalls Aufsicht, Validierung und Verifikation. Unabhängige Prüfungen umfassen externe Modelle, Fachleute, ausführbare Tests, vertrauenswürdige Datenpipelines, adversarielle Evaluationen und spätere Realweltvalidierung. Keine erfasst jeden Fehler; mehrere übereinstimmende Modelle können denselben Bias teilen.
Entscheidend sind weitere Zyklen, Transfer ohne Fähigkeitsverlust und die Korrektur absichtlich eingeführter gemeinsamer blinder Flecken. Nicht nur externe Bewerter sollten Fehler finden: Die Schleife muss den Workflow ändern und fehlerhafte Abläufe vom Training ausschließen. Bislang liefert MASS Belege für konzentriertes Lernen aus begrenzten, evidenzreichen Forschungsteams. Es belegt weder unbegrenzte rekursive Verbesserung noch rechtfertigt es den Verzicht auf menschliche Prüfung folgenreicher Entscheidungen.