
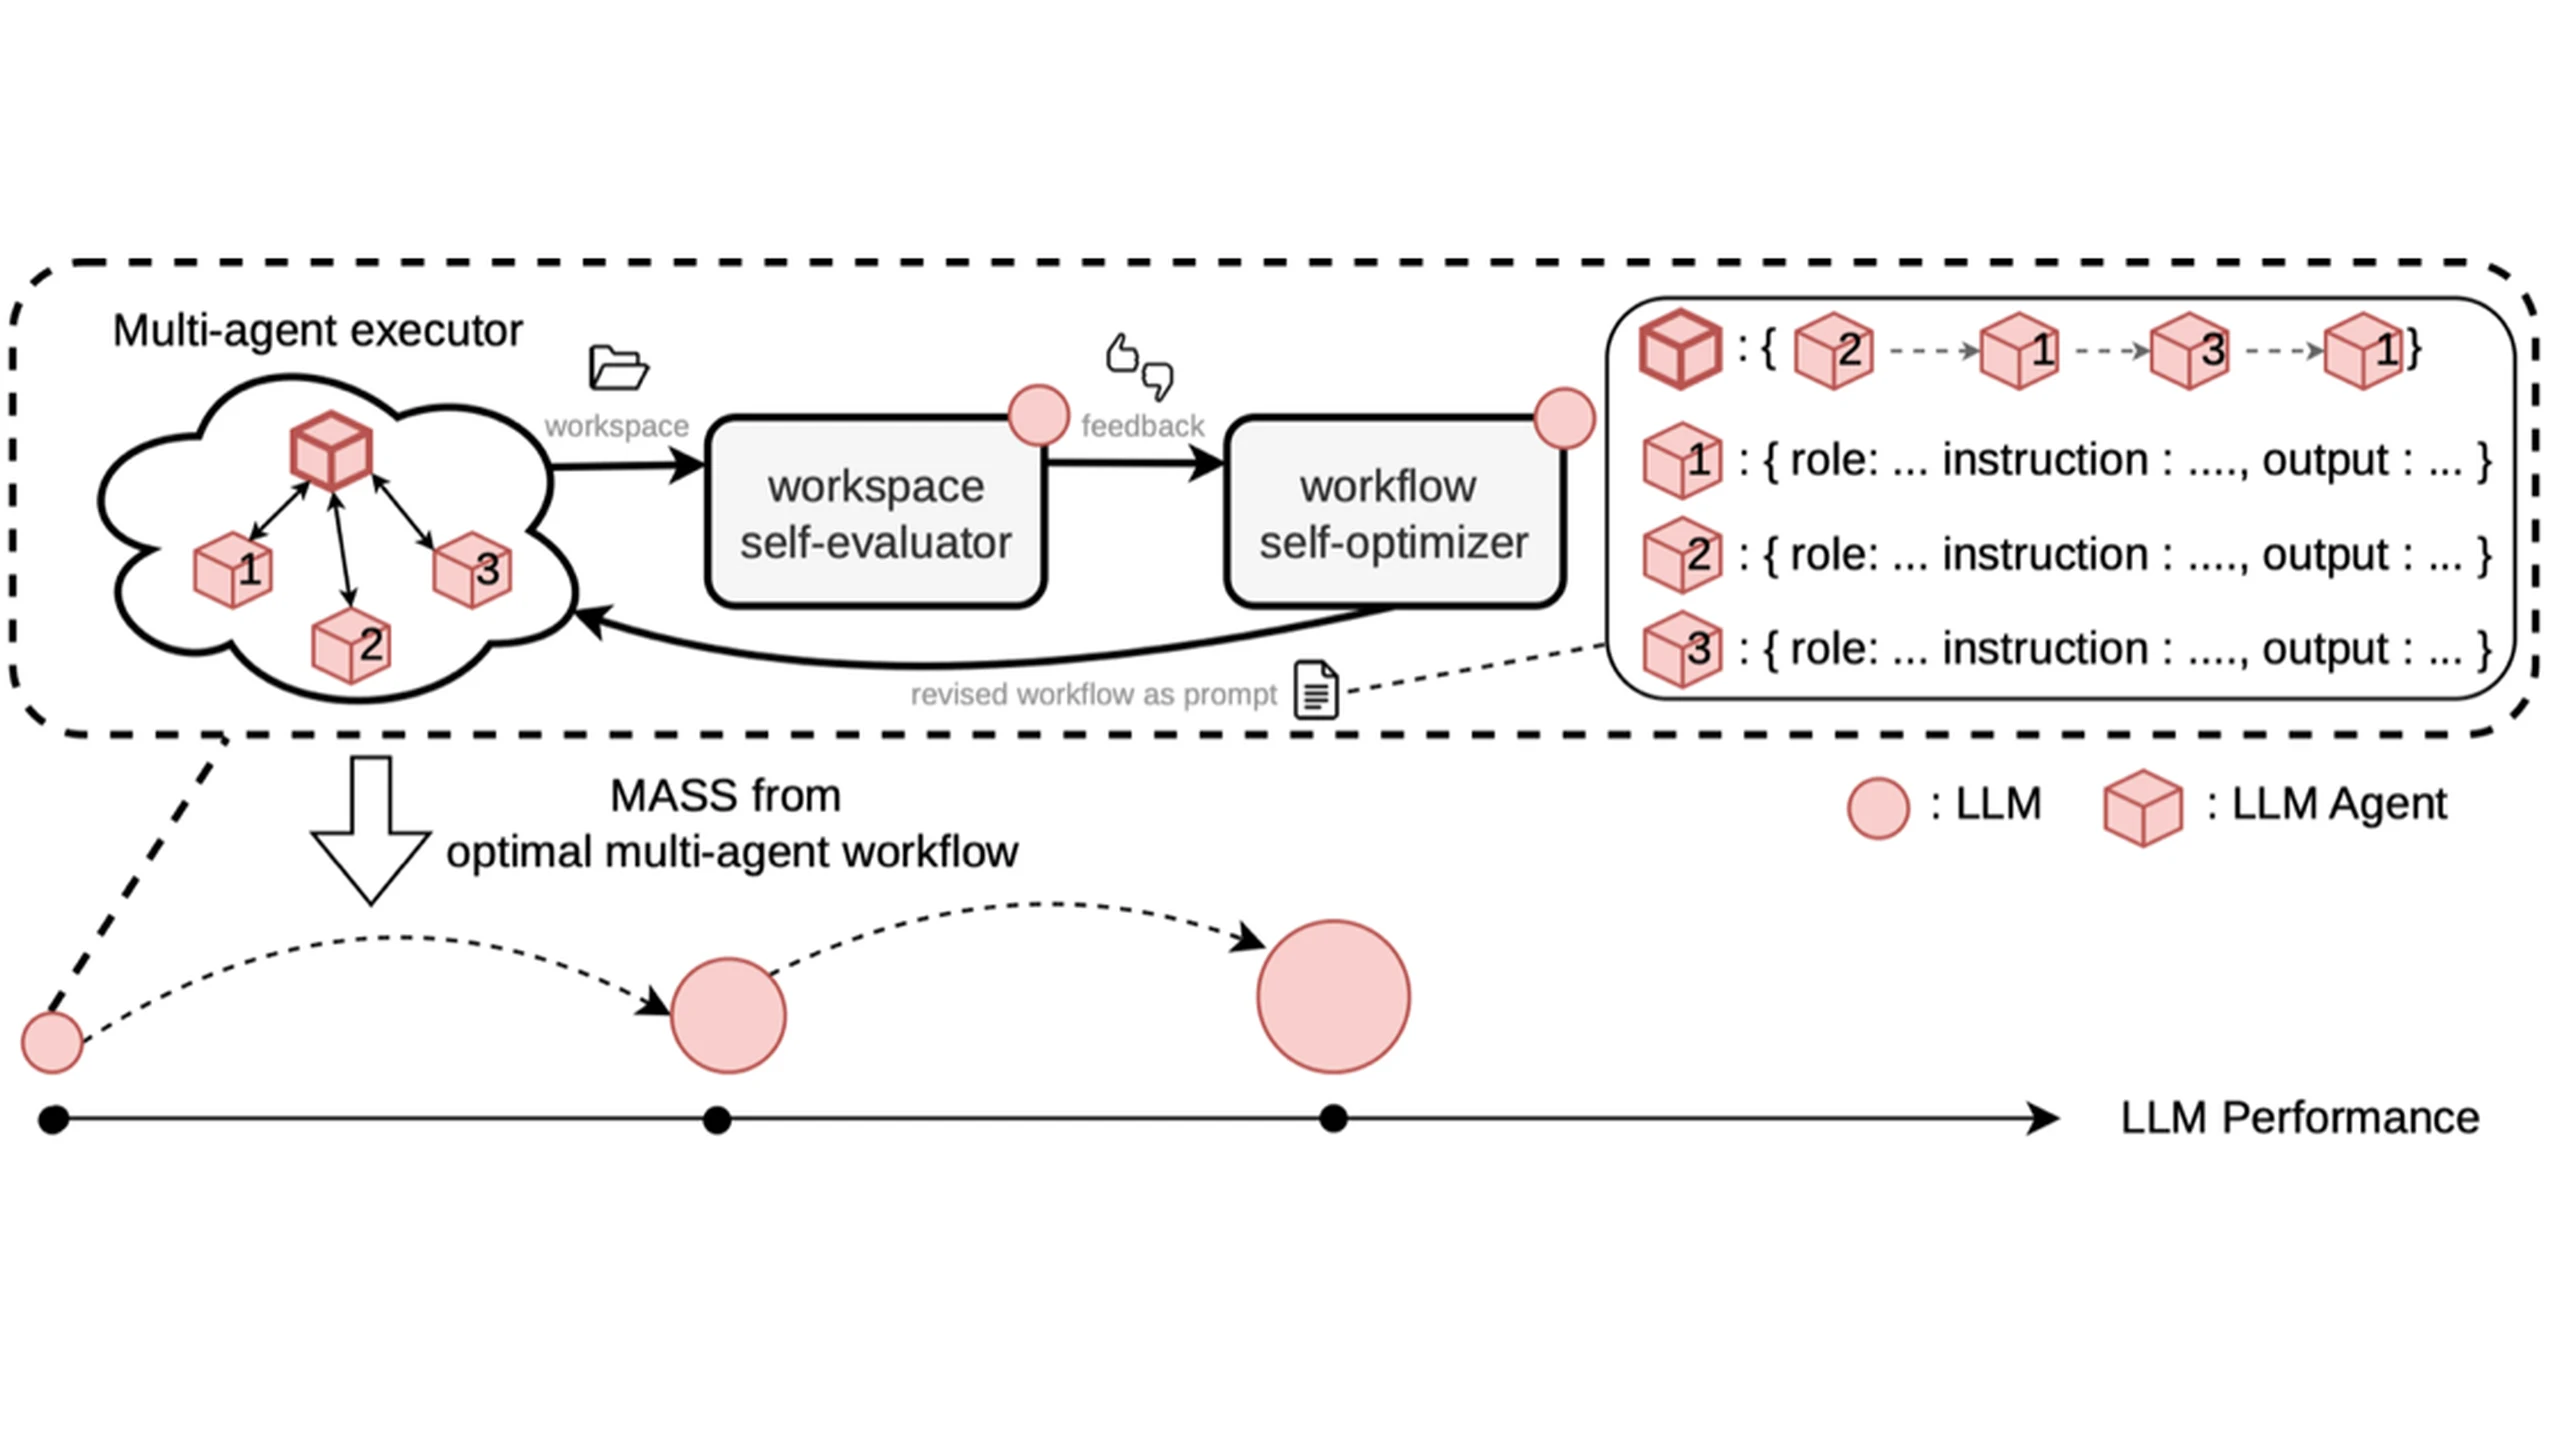
Sakana AI ha completado dos ciclos de Multi-Agent Self-Supervision, o MASS. Copias de un mismo modelo producen investigaciones, las juzgan y convierten las trayectorias seleccionadas en datos de entrenamiento para su sucesor compartido. Las mejoras comunicadas son resultados experimentales, pero desiguales: avanzan las pruebas de investigación y retroceden dos de ingeniería de software. Es posentrenamiento acotado, no una prueba de explosión autónoma de inteligencia.
El artículo presentado el 8 de octubre de 2026 y la implementación abierta incluyen instrucciones, configuraciones de entrenamiento, herramientas de evaluación y documentación del proceso. También exponen lo que la etiqueta «recursivo» no resuelve: solo dos ciclos completos, pocas tareas y un modelo que puede repetir el mismo error como ejecutor, optimizador y evaluador.
Del trabajo colectivo a una actualización del modelo
La inferencia multiagente habitual reparte tareas entre instancias y reúne sus respuestas sin cambiar los pesos. MASS conserva mensajes, llamadas a herramientas, productos intermedios y resultados como trayectorias de entrenamiento. Distintas instancias realizan trabajos diferentes, pero comparten el modelo: no son expertos entrenados de forma independiente.
El bucle interno mantiene los pesos fijos y busca un flujo mejor definido mediante instrucciones. Este especifica funciones, indicaciones, contratos de salida y pasos de comunicación. Cada tarea de entrenamiento tiene un flujo campeón. Un equipo candidato ejecuta la tarea, el modelo compara su espacio de trabajo con el del campeón y el optimizador propone cambios a partir de ese juicio.
Después de seleccionar un flujo, MASS lo ejecuta 18 veces por tarea. Las comparaciones por pares del modelo ordenan los espacios; un modelo Bradley–Terry convierte las preferencias en puntuaciones. Se conservan hasta 16 trayectorias: 15 pueden aportar ejemplos de entrenamiento y una se reserva para validación. Antes del ajuste se elimina el texto del flujo de la instrucción inicial de entrenamiento del orquestador, para que deduzca la organización desde la tarea en vez de copiar el plan entregado.
El bucle externo utiliza adaptación de bajo rango, LoRA, para ajustar un conjunto limitado de parámetros. Las conversaciones del orquestador y los subagentes son objetivos de entrenamiento. El modelo actualizado vuelve después a los tres papeles. Llamarlo recursivo es defendible porque una generación ayuda a crear y seleccionar los datos de su sucesora. Las personas siguen definiendo arquitectura, tareas, optimización, pruebas, infraestructura y límites de los ciclos.
Avances de investigación con una frontera clara de transferencia
La base es Qwen3.6-27B dentro de un entorno de agente de programación. La suite sintética contiene 12 investigaciones de finanzas, robótica y farmacia, cada una con código, análisis cuantitativo e informe. Nueve se destinaron al entrenamiento, pero ocho aportaron datos finalmente. Tres, una por ámbito, quedaron fuera del ajuste, la validación y la selección de puntos de control.
GPT-5.5 y Claude Opus 4.8 fueron jueces externos de los espacios terminados, no supervisores del bucle de entrenamiento. En las tres tareas reservadas, el primer modelo ganó el 53,9% de las comparaciones con la base y el segundo el 69,9%. El segundo superó al primero en el 60,8%. En tareas de entrenamiento, las victorias frente a la base fueron del 65,6% y el 82,5%. Esos resultados más fuertes deben distinguirse de la evidencia reservada.
En pruebas públicas de investigación, Sakana comunica puntuaciones por token de salida de entre 1,2 y 1,6 veces la base tras el segundo ciclo. MLR-Bench subió de 1,71 a 2,25, con una entrega de artículos del 57% al 76%. ScienceAgentBench mejoró del 28,8% al 31,7%. AstaBench E2E-Hard pasó de 0,053 a 0,067 y la entrega de informes del 50% al 76%. DSBench apenas cambió de 0,473 a 0,482: una mejor relación de eficiencia no convierte esa pequeña diferencia absoluta en una gran subida de puntuación.
La ingeniería de software fue en sentido contrario. Terminal-Bench 2.0 bajó de 0,375 a 0,352 y SWE-bench Verified de 0,626 a 0,611. Sus ratios por token fueron 0,96 y 0,94 veces la base. Por tanto, el modelo no es uniformemente más fuerte.
La afinidad entre tareas es una explicación plausible: el entrenamiento se centró en informes, pruebas cuantitativas y código, no en depuración de repositorios u operaciones de terminal. Añadir tareas de software podría ayudar, como propone Sakana, pero sigue sin probarse y podría interferir con capacidades existentes. Los ensayos de transferencia deben comprobar nuevos ámbitos y conservación de los anteriores.
Los costes que no incluyen las cifras de eficiencia
En una comparación de entrenamiento, un alumno multiagente alcanzó un 68,3% de victorias tras 28,8 millones de tokens supervisados. El mayor alumno de agente único llegó al 64% tras 42 millones. Es un resultado mejor con un 31% menos de tokens supervisados, no una reducción demostrada del 31% en el coste total de desarrollo.
Antes de seleccionar, los equipos generaban de media unas 2,4 veces más tokens. Los jueces externos preferían sus trabajos en el 85,1% de las comparaciones con salidas individuales. En diez parejas con trazas de longitud similar, los equipos aún ganaban el 80%. Coordinación y selección parecen producir ejemplos útiles, pero la comparación no aísla la delegación: también variaban los flujos y las instrucciones de verificación.
La puntuación por token mide salida productiva, no todo el proceso. Buscar flujos, repetir ejecuciones, comparar, generar datos y evaluar consume cómputo adicional. Los totales supervisados excluyen tokens de entrada y varios gastos previos. MASS respalda, por tanto, la idea de datos seleccionados más densos; la eficiencia global exige una contabilidad más completa.
Contratos de información, no solo personajes
La búsqueda modifica funciones, instrucciones, contratos y pasos de comunicación. Un contrato define qué prueba o producto debe entregar un agente; un paso determina cuándo transferir información o devolverla para revisión. Es más concreto que pedir a varias copias que actúen como investigador, crítico o editor.
En un ejemplo financiero, los agentes cubren preparación de datos, construcción de variables, modelado, backtesting, auditoría, conciliación e informe. El agente de datos debe declarar si información futura se filtró en decisiones históricas. El requisito aborda un fallo real: un backtest impresionante puede haber utilizado datos que entonces no estaban disponibles.
El análisis textual de Sakana observó una concentración creciente de información de la tarea en contratos y orden de comunicación, no en papeles e instrucciones generales. La muestra contiene solo ocho o nueve tareas según la comparación, y las estimaciones de información mutua describen textos de los flujos, no todos los mensajes. Es una pista sobre el mecanismo, no una prueba causal general.
Los anteriores estudios de debate multiagente analizaban mejoras mediante respuestas y críticas intercambiadas. MASS traslada comportamientos colectivos seleccionados a los pesos: las trazas del orquestador enseñan descomposición y coordinación; las de subagentes, encargos delimitados. Una base de conocimientos técnicos consultable ilustra el valor organizativo de conservar pruebas y decisiones inspeccionables, pero no valida MASS de forma independiente.
Optimizador y juez comparten limitaciones
Un modelo en tres papeles reduce la dependencia de un profesor permanentemente más fuerte, pero genera fallos correlacionados. El ejecutor puede interpretar mal una tarea, el evaluador premiar ese error y el sucesor aprenderlo con más confianza. El muestreo aleatorio y la especialización generan variación, no historias independientes de entrenamiento ni independencia de juicio garantizada.
La presentación del proyecto de Sakana señala los puntos ciegos compartidos como problema de seguridad. La coincidencia entre jueces internos y externos subió del 73% al 93% en tres generaciones. Es alentador en estas tareas, no una prueba de corrección: pueden compartir supuestos o favorecer informes pulidos mientras omiten errores que requieren experimentos reales.
La capacidad del optimizador fue otro límite. Manteniendo Qwen base como ejecutor, usar GPT-5.5 solo de evaluador aportó mejoras limitadas. Como evaluador y optimizador encontró flujos ganadores para las 12 tareas en cinco iteraciones como máximo. El bucle homogéneo terminó encontrándolos para 11 de 12, pero necesitó hasta 13 iteraciones. Una buena crítica no basta si el optimizador no sabe convertirla en mejor proceso.
La búsqueda también fue inestable: iteraciones fuertes podían preceder retrocesos bruscos. Las críticas comunitarias citadas en el texto original cuestionaban el término recursivo y la parada después de dos rondas. La interpretación prudente es búsqueda iterativa de flujos y ajuste supervisado dentro de límites humanos, no autorreescritura sin restricciones ni prueba de progreso indefinido.
La supervisión debe mejorar con las capacidades
La investigación sin una regla automática de éxito es especialmente vulnerable a la autoconfirmación. Un informe coherente puede contener un error conceptual, omitir pruebas contrarias o implementar el objetivo equivocado en código que funciona. El consenso de modelos no resuelve por sí solo novedad científica, estrategia, valores o seguridad.
La investigación de OpenAI sobre monitorización del razonamiento indica que las trazas pueden revelar más que acciones y respuestas finales, pero la vigilancia es incompleta y depende del agente y del monitor. Las ricas trayectorias de MASS ofrecen oportunidades de inspección y escondites. Optimizar el razonamiento visible puede premiar explicaciones convincentes sin corregir la conducta.
La discusión de Anthropic sobre mejora recursiva también destaca supervisión, validación y verificación. Entre los controles independientes están modelos externos, expertos, pruebas ejecutables, datos fiables, evaluaciones adversariales y validación posterior en el mundo real. Ninguno cubre todos los fallos; varios modelos de acuerdo pueden compartir sesgos.
Las siguientes pruebas decisivas serán más ciclos, transferencia sin pérdida de capacidades y recuperación de un punto ciego compartido introducido deliberadamente. No basta con que jueces externos descubran un error: el bucle debe revisar el flujo y evitar entrenarse con trayectorias defectuosas. Hoy MASS aporta evidencia de aprendizaje concentrado desde equipos de investigación acotados y ricos en pruebas. No demuestra mejora recursiva ilimitada ni justifica retirar la revisión humana de decisiones importantes.