
Sakana AI ukończyła dwa cykle Multi-Agent Self-Supervision, czyli MASS. Kopie jednego modelu przygotowują badania, oceniają je i przekształcają wybrane przebiegi w dane treningowe wspólnego następcy. Zgłoszone postępy są wynikami eksperymentalnymi, ale nierównymi: testy badawcze poprawiły się, a dwa benchmarki inżynierii oprogramowania pogorszyły. To ograniczone dalsze trenowanie, nie dowód autonomicznej eksplozji inteligencji.
Praca zgłoszona 8 października 2026 r. i otwarta implementacja zawierają prompty, konfiguracje treningu, narzędzia ewaluacji i dokumentację procesu. Pokazują też, czego nie rozstrzyga etykieta „rekurencyjny”: ukończono tylko dwa cykle, zadań jest niewiele, a ten sam model może powtarzać błąd jako wykonawca, optymalizator i oceniający.
Od pracy zespołu do aktualizacji modelu
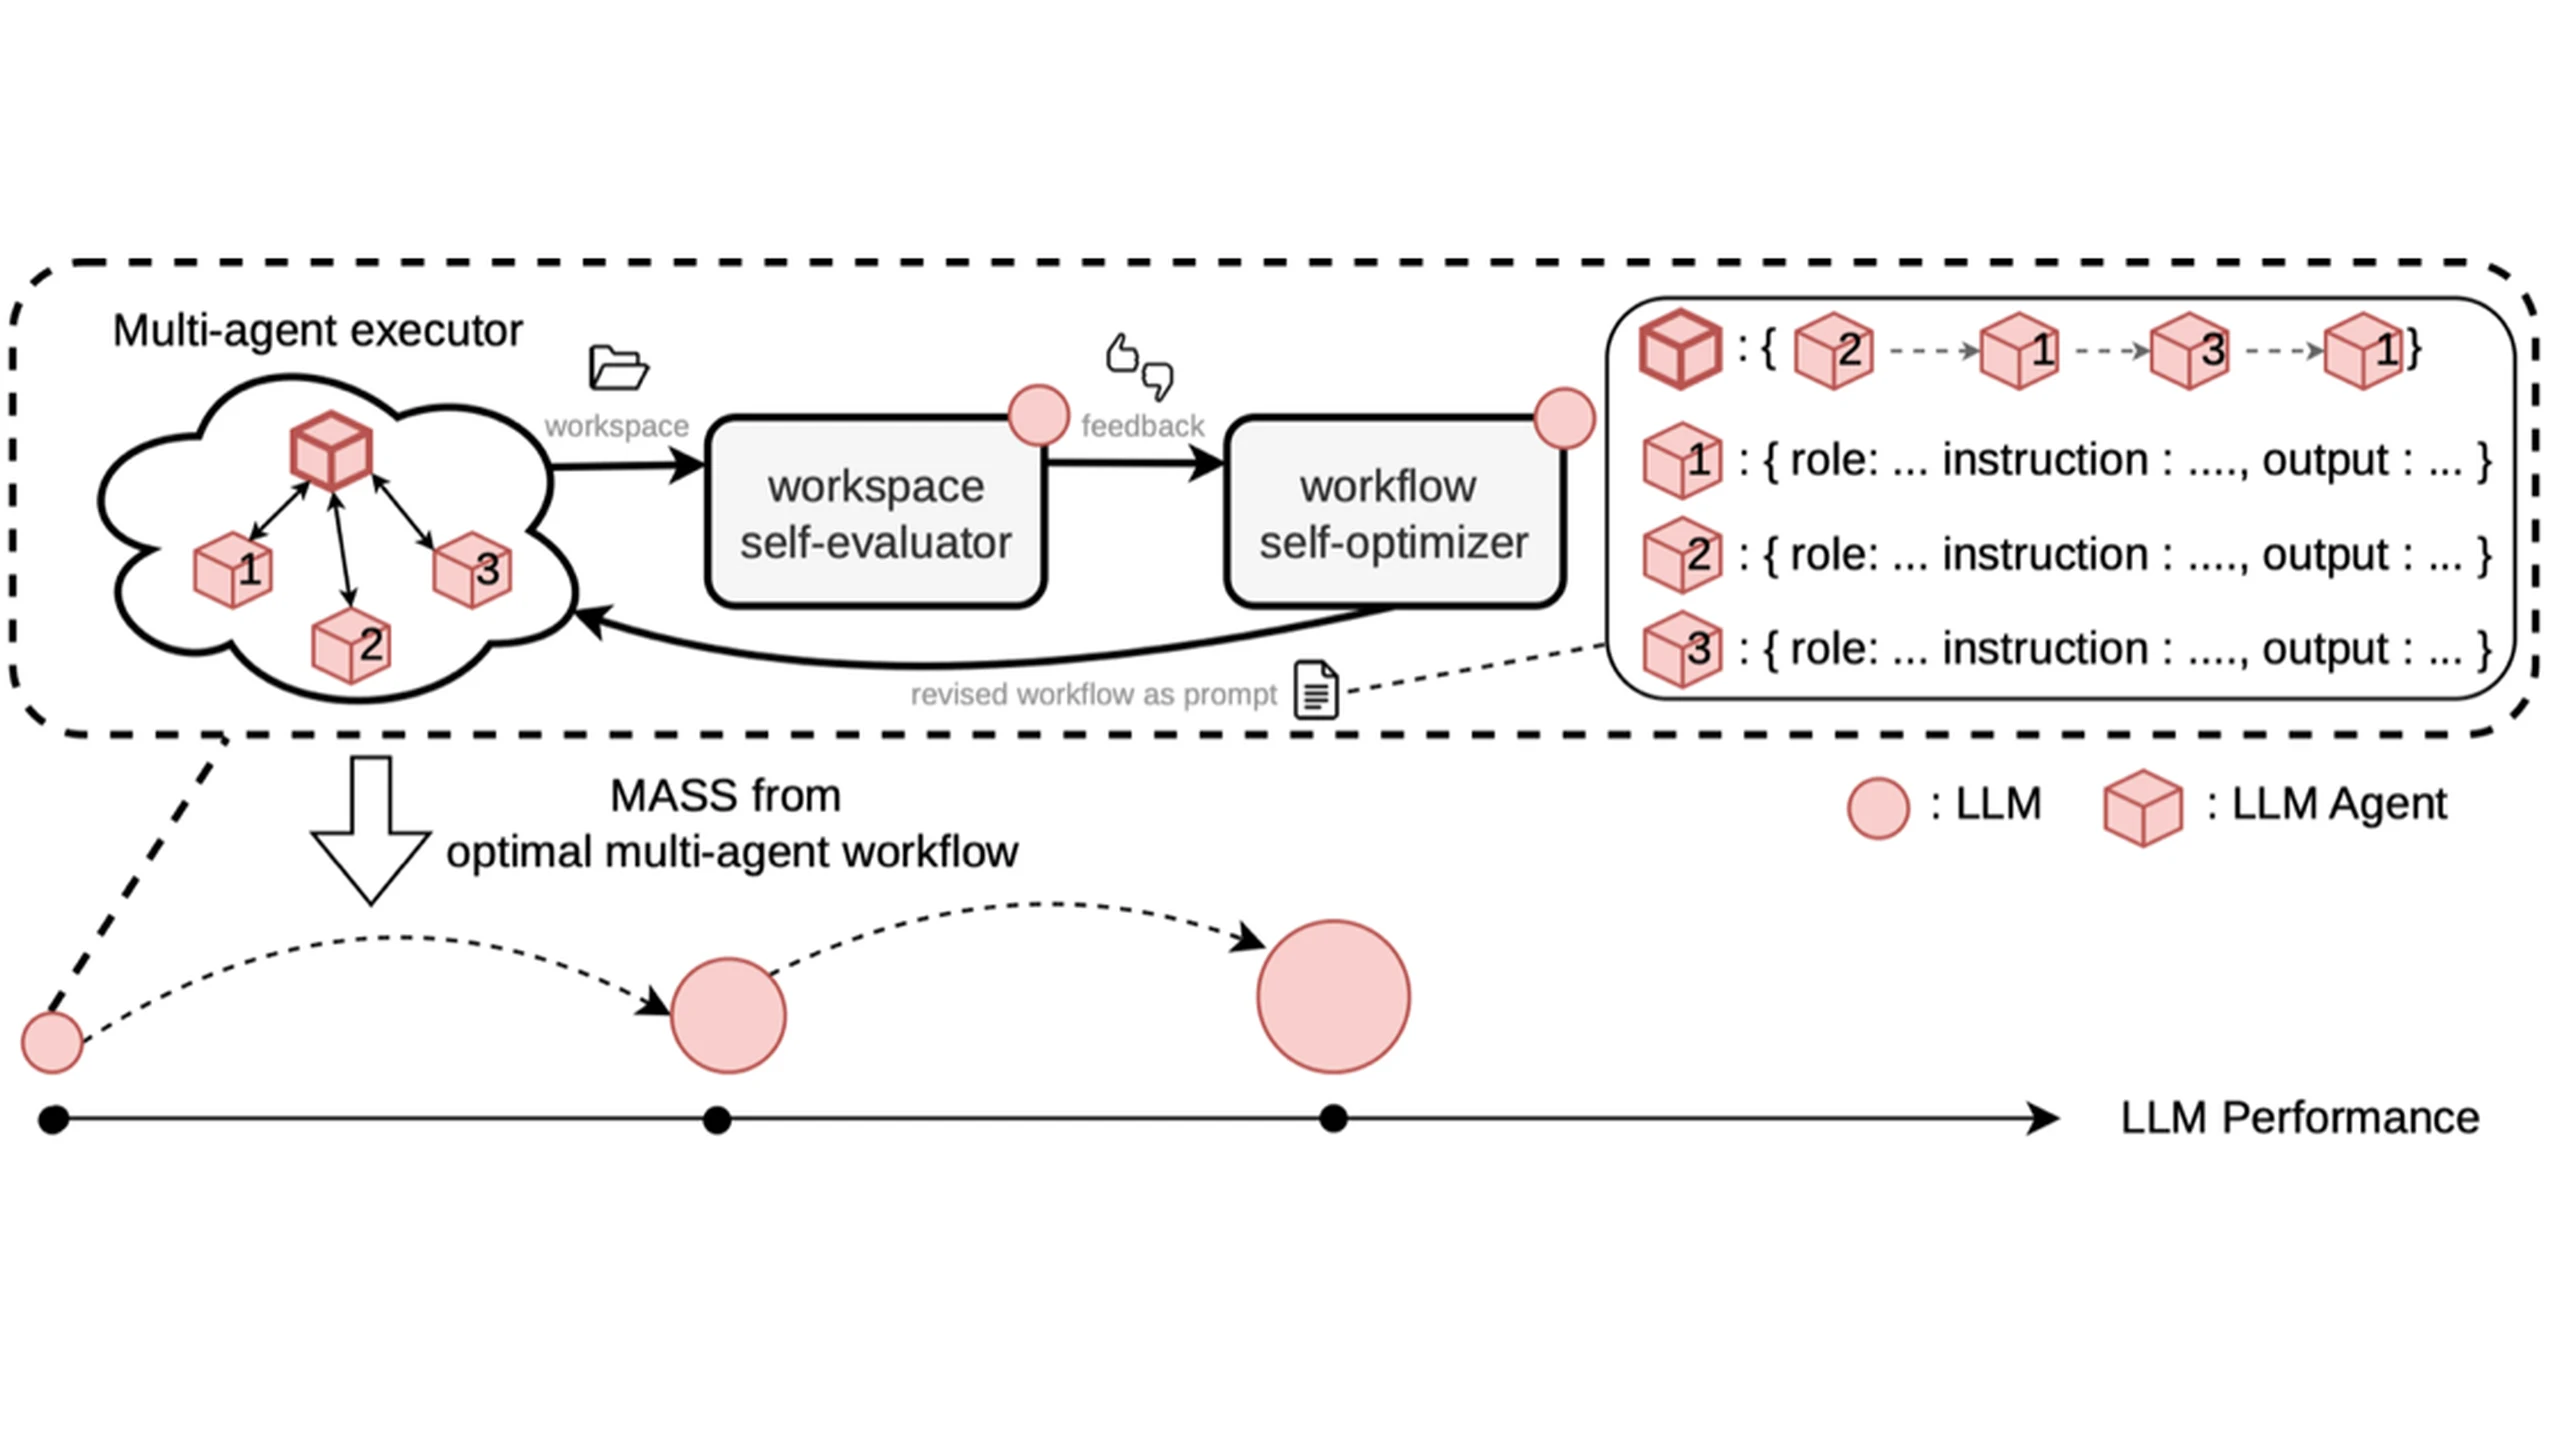
Zwykłe wnioskowanie wieloagentowe rozdziela zadanie między instancje i łączy odpowiedzi bez zmiany wag. MASS zachowuje wiadomości, wywołania narzędzi, pośrednie artefakty i wyniki jako przebiegi treningowe. Osobne instancje wykonują różne prace, ale dzielą model: nie są niezależnie wytrenowanymi ekspertami.
Pętla wewnętrzna utrzymuje stałe wagi i szuka lepszego procesu zdefiniowanego promptem. Określa on role, instrukcje, kontrakty wyników oraz kroki komunikacji. Każde zadanie treningowe ma aktualnie najlepszy proces. Zespół kandydujący wykonuje zadanie, model porównuje jego przestrzeń roboczą z dotychczasowym zwycięzcą, a optymalizator proponuje zmianę na podstawie tej oceny.
Po wyborze procesu MASS wykonuje go 18 razy na zadanie. Porównania parami dokonane przez model porządkują przestrzenie robocze; model Bradleya–Terry’ego zamienia preferencje na wyniki. Zachowuje się do 16 przebiegów: 15 może dostarczyć przykładów treningowych, jeden służy walidacji. Przed dostrajaniem tekst procesu usuwa się z początkowego promptu treningowego orkiestratora, aby wnioskował o organizacji z samego zadania, zamiast kopiować dostarczony plan.
Pętla zewnętrzna używa adaptacji niskiego rzędu, LoRA, do dostrojenia ograniczonego zbioru parametrów. Rozmowy orkiestratora i podagentów stają się celami treningu. Zaktualizowany model ponownie obejmuje wszystkie trzy role. Określenie rekurencyjny jest uzasadnione o tyle, że pokolenie pomaga tworzyć i wybierać dane następcy. Ludzie nadal definiują architekturę, zadania, optymalizację, testy, infrastrukturę i granice cykli.
Postępy badawcze i wyraźna granica transferu
Bazą jest Qwen3.6-27B w środowisku agenta programistycznego. Zestaw syntetyczny obejmuje 12 badań z finansów, robotyki i farmacji; każde wymaga kodu, analizy ilościowej i raportu. Dziewięć przeznaczono do treningu, ale ostatecznie osiem dostarczyło danych. Trzy, po jednym z każdej dziedziny, wyłączono z dostrajania, walidacji i wyboru punktów kontrolnych.
GPT-5.5 i Claude Opus 4.8 były zewnętrznymi sędziami ukończonych prac, nie nadzorcami pętli treningowej. W trzech odłożonych zadaniach model pierwszej rundy wygrał 53,9% porównań z bazą, a drugiej 69,9%. Druga runda pokonała pierwszą w 60,8%. Dla zadań treningowych odsetki zwycięstw nad bazą wyniosły 65,6% i 82,5%. Mocniejszych wyników treningowych nie należy utożsamiać z dowodami na zadaniach odłożonych.
W publicznych benchmarkach badawczych Sakana zgłasza po drugiej rundzie od 1,2 do 1,6 raza bazowej punktacji na token wyjściowy. MLR-Bench wzrósł z 1,71 do 2,25, a dostarczanie artykułów z 57% do 76%. ScienceAgentBench poprawił się z 28,8% do 31,7%. AstaBench E2E-Hard wzrósł z 0,053 do 0,067, a dostarczanie raportów z 50% do 76%. DSBench zmienił się nieznacznie, z 0,473 do 0,482. Lepszy wskaźnik wydajności nie zamienia tej małej różnicy bezwzględnej w duży wzrost punktacji.
Inżynieria oprogramowania poszła w przeciwną stronę. Terminal-Bench 2.0 spadł z 0,375 do 0,352, a SWE-bench Verified z 0,626 do 0,611. Wskaźniki na token wyniosły 0,96 i 0,94 wartości bazowej. Model nie jest zatem silniejszy pod każdym względem.
Prawdopodobnym wyjaśnieniem jest dopasowanie zadań: trening skupiał się na raportach, dowodach ilościowych i kodzie, nie debugowaniu repozytoriów czy operacjach terminalowych. Dodanie zadań programistycznych może pomóc, jak sugeruje Sakana, lecz pozostaje hipotezą i może zakłócić istniejące zdolności. Test transferu powinien sprawdzać nowe dziedziny i zachowanie poprzednich umiejętności.
Koszty pominięte we wskaźnikach wydajności
W porównaniu treningowym wieloagentowy model uczniowski osiągnął 68,3% zwycięstw po 28,8 mln tokenów nadzorowanych. Największy uczeń jednoagentowy osiągnął 64% po 42 mln. To lepszy wynik przy 31% mniej tokenów nadzorowanych, nie wykazane obniżenie całego kosztu rozwoju o 31%.
Przed selekcją zespoły generowały średnio około 2,4 raza więcej tokenów. Zewnętrzni sędziowie wybierali ich prace w 85,1% porównań z wynikami pojedynczych agentów. W dziesięciu parach przebiegów podobnej długości zespoły nadal wygrywały 80%. Koordynacja i selekcja mogą więc dawać wartościowe przykłady, ale porównanie nie izoluje delegowania: procesy i instrukcje weryfikacji również się różniły.
Punktacja na token mierzy produktywny wynik, nie cały proces. Poszukiwanie procesów, powtarzanie wykonań, porównania, generowanie danych i ewaluacja zużywają dodatkowe obliczenia. Sumy tokenów nadzorowanych nie obejmują wejścia i części wcześniejszych wydatków. MASS przemawia zatem za gęstszymi wybranymi danymi treningowymi; całkowita efektywność wymaga pełniejszego rachunku.
Kontrakty informacji zamiast samych person
Wyszukiwanie zmienia role, instrukcje, kontrakty i kroki komunikacji. Kontrakt określa dowód lub artefakt do zwrotu; krok wskazuje moment przekazania informacji albo ponownego przeglądu. To konkretniejsze niż polecenie kopiom odgrywania badacza, krytyka czy redaktora.
W przykładzie finansowym agenci zajmują się przygotowaniem danych, budową cech, modelowaniem, testami historycznymi, audytem, uzgadnianiem i raportem. Agent danych musi ujawnić, czy przyszłe informacje przedostały się do historycznych decyzji. Wymóg uderza w rzeczywisty błąd: znakomity backtest może po prostu używać danych niedostępnych w danym czasie.
Analiza tekstowa Sakany wykazała rosnącą koncentrację informacji o zadaniu w kontraktach i kolejności komunikacji, zamiast w rolach i ogólnych instrukcjach. Próba obejmuje tylko osiem lub dziewięć zadań zależnie od porównania, a szacunki informacji wzajemnej dotyczą tekstu procesu, nie wszystkich wiadomości. To wskazówka mechanizmu, nie szeroki dowód przyczynowy.
Wcześniejsze badania debat wieloagentowych analizowały poprawę dzięki wymianie odpowiedzi i krytyk. MASS przenosi wybrane zachowania zbiorowe do wag: przebiegi orkiestratora uczą podziału i koordynacji, podagentów zaś ograniczonych zleceń. Przeszukiwalna techniczna baza wiedzy ilustruje organizacyjną wartość sprawdzalnych dowodów i decyzji, ale nie jest niezależną walidacją MASS.
Optymalizator i sędzia dzielą ograniczenia
Jeden model w trzech rolach ogranicza zależność od stale silniejszego nauczyciela, lecz tworzy skorelowane błędy. Wykonawca może źle zrozumieć zadanie, sędzia nagrodzić pomyłkę, a następca nauczyć się jej z większą pewnością. Losowe próbkowanie i specjalizacja dają zróżnicowanie, nie niezależne historie treningu ani gwarancję niezależnego osądu.
Opis projektu Sakany wskazuje wspólne ślepe plamki jako problem bezpieczeństwa. Zgodność ocen wewnętrznych i zewnętrznych wzrosła z 73% do 93% przez trzy generacje. To obiecujące dla tych zadań, ale nie dowodzi poprawności: sędziowie mogą podzielać założenia lub lubić dopracowane raporty, przeoczając błędy wymagające rzeczywistych eksperymentów.
Siła optymalizatora była kolejną barierą. Przy bazowym Qwen jako wykonawcy użycie GPT-5.5 wyłącznie do oceniania dało ograniczoną poprawę. W roli sędziego i optymalizatora znalazł zwycięskie procesy dla wszystkich 12 zadań w najwyżej pięciu iteracjach. Pętla jednorodna znalazła je ostatecznie dla 11 z 12, potrzebując do 13 iteracji. Dobra krytyka nie wystarcza, jeśli optymalizator nie umie zamienić jej w lepszy proces.
Poszukiwanie było też niestabilne: po mocnych iteracjach mogły następować ostre regresje. Krytyka społeczności przytoczona w oryginalnym materiale kwestionowała nazwę oraz zakończenie po dwóch rundach. Ostrożna interpretacja to iteracyjne szukanie procesów i nadzorowane dostrajanie w ludzkich granicach, nie nieograniczone samoprzepisywanie czy dowód nieskończonego postępu.
Nadzór musi rosnąć wraz ze zdolnościami
Badania bez automatycznej reguły sukcesu są szczególnie podatne na samopotwierdzenie. Spójny raport może zawierać błąd pojęciowy, pomijać kontrdowody lub realizować zły cel w działającym kodzie. Konsensus modeli nie rozstrzyga sam nowości naukowej, strategii, wartości ani bezpieczeństwa.
Badania OpenAI nad monitorowalnością wskazują, że ślady rozumowania mogą ujawniać więcej niż działania i odpowiedzi końcowe. Monitoring pozostaje jednak niepełny i zależny od agenta oraz obserwatora. Bogate przebiegi MASS stwarzają okazje do kontroli i kryjówki. Optymalizacja widocznego rozumowania może nagradzać przekonujące wyjaśnienia bez poprawy zachowania.
Omówienie rekurencyjnego samodoskonalenia Anthropic również podkreśla nadzór, walidację i weryfikację. Niezależne kontrole obejmują modele zewnętrzne, ekspertów, testy wykonywalne, zaufane dane, ewaluacje adwersarialne i późniejszą walidację w świecie rzeczywistym. Żadna nie obejmuje wszystkich błędów; zgodne modele mogą dzielić ten sam bias.
Rozstrzygające będą dodatkowe cykle, transfer bez utraty zdolności i naprawa celowo wprowadzonej wspólnej ślepej plamki. Nie wystarczy wykrycie błędu przez sędziów zewnętrznych: pętla powinna zmienić proces i nie trenować na wadliwych przebiegach. Na dziś MASS pokazuje skoncentrowaną naukę z ograniczonych, opartych na dowodach zespołów badawczych. Nie dowodzi nieograniczonej rekurencji i nie uzasadnia usuwania ludzi z przeglądu decyzji o poważnych skutkach.