
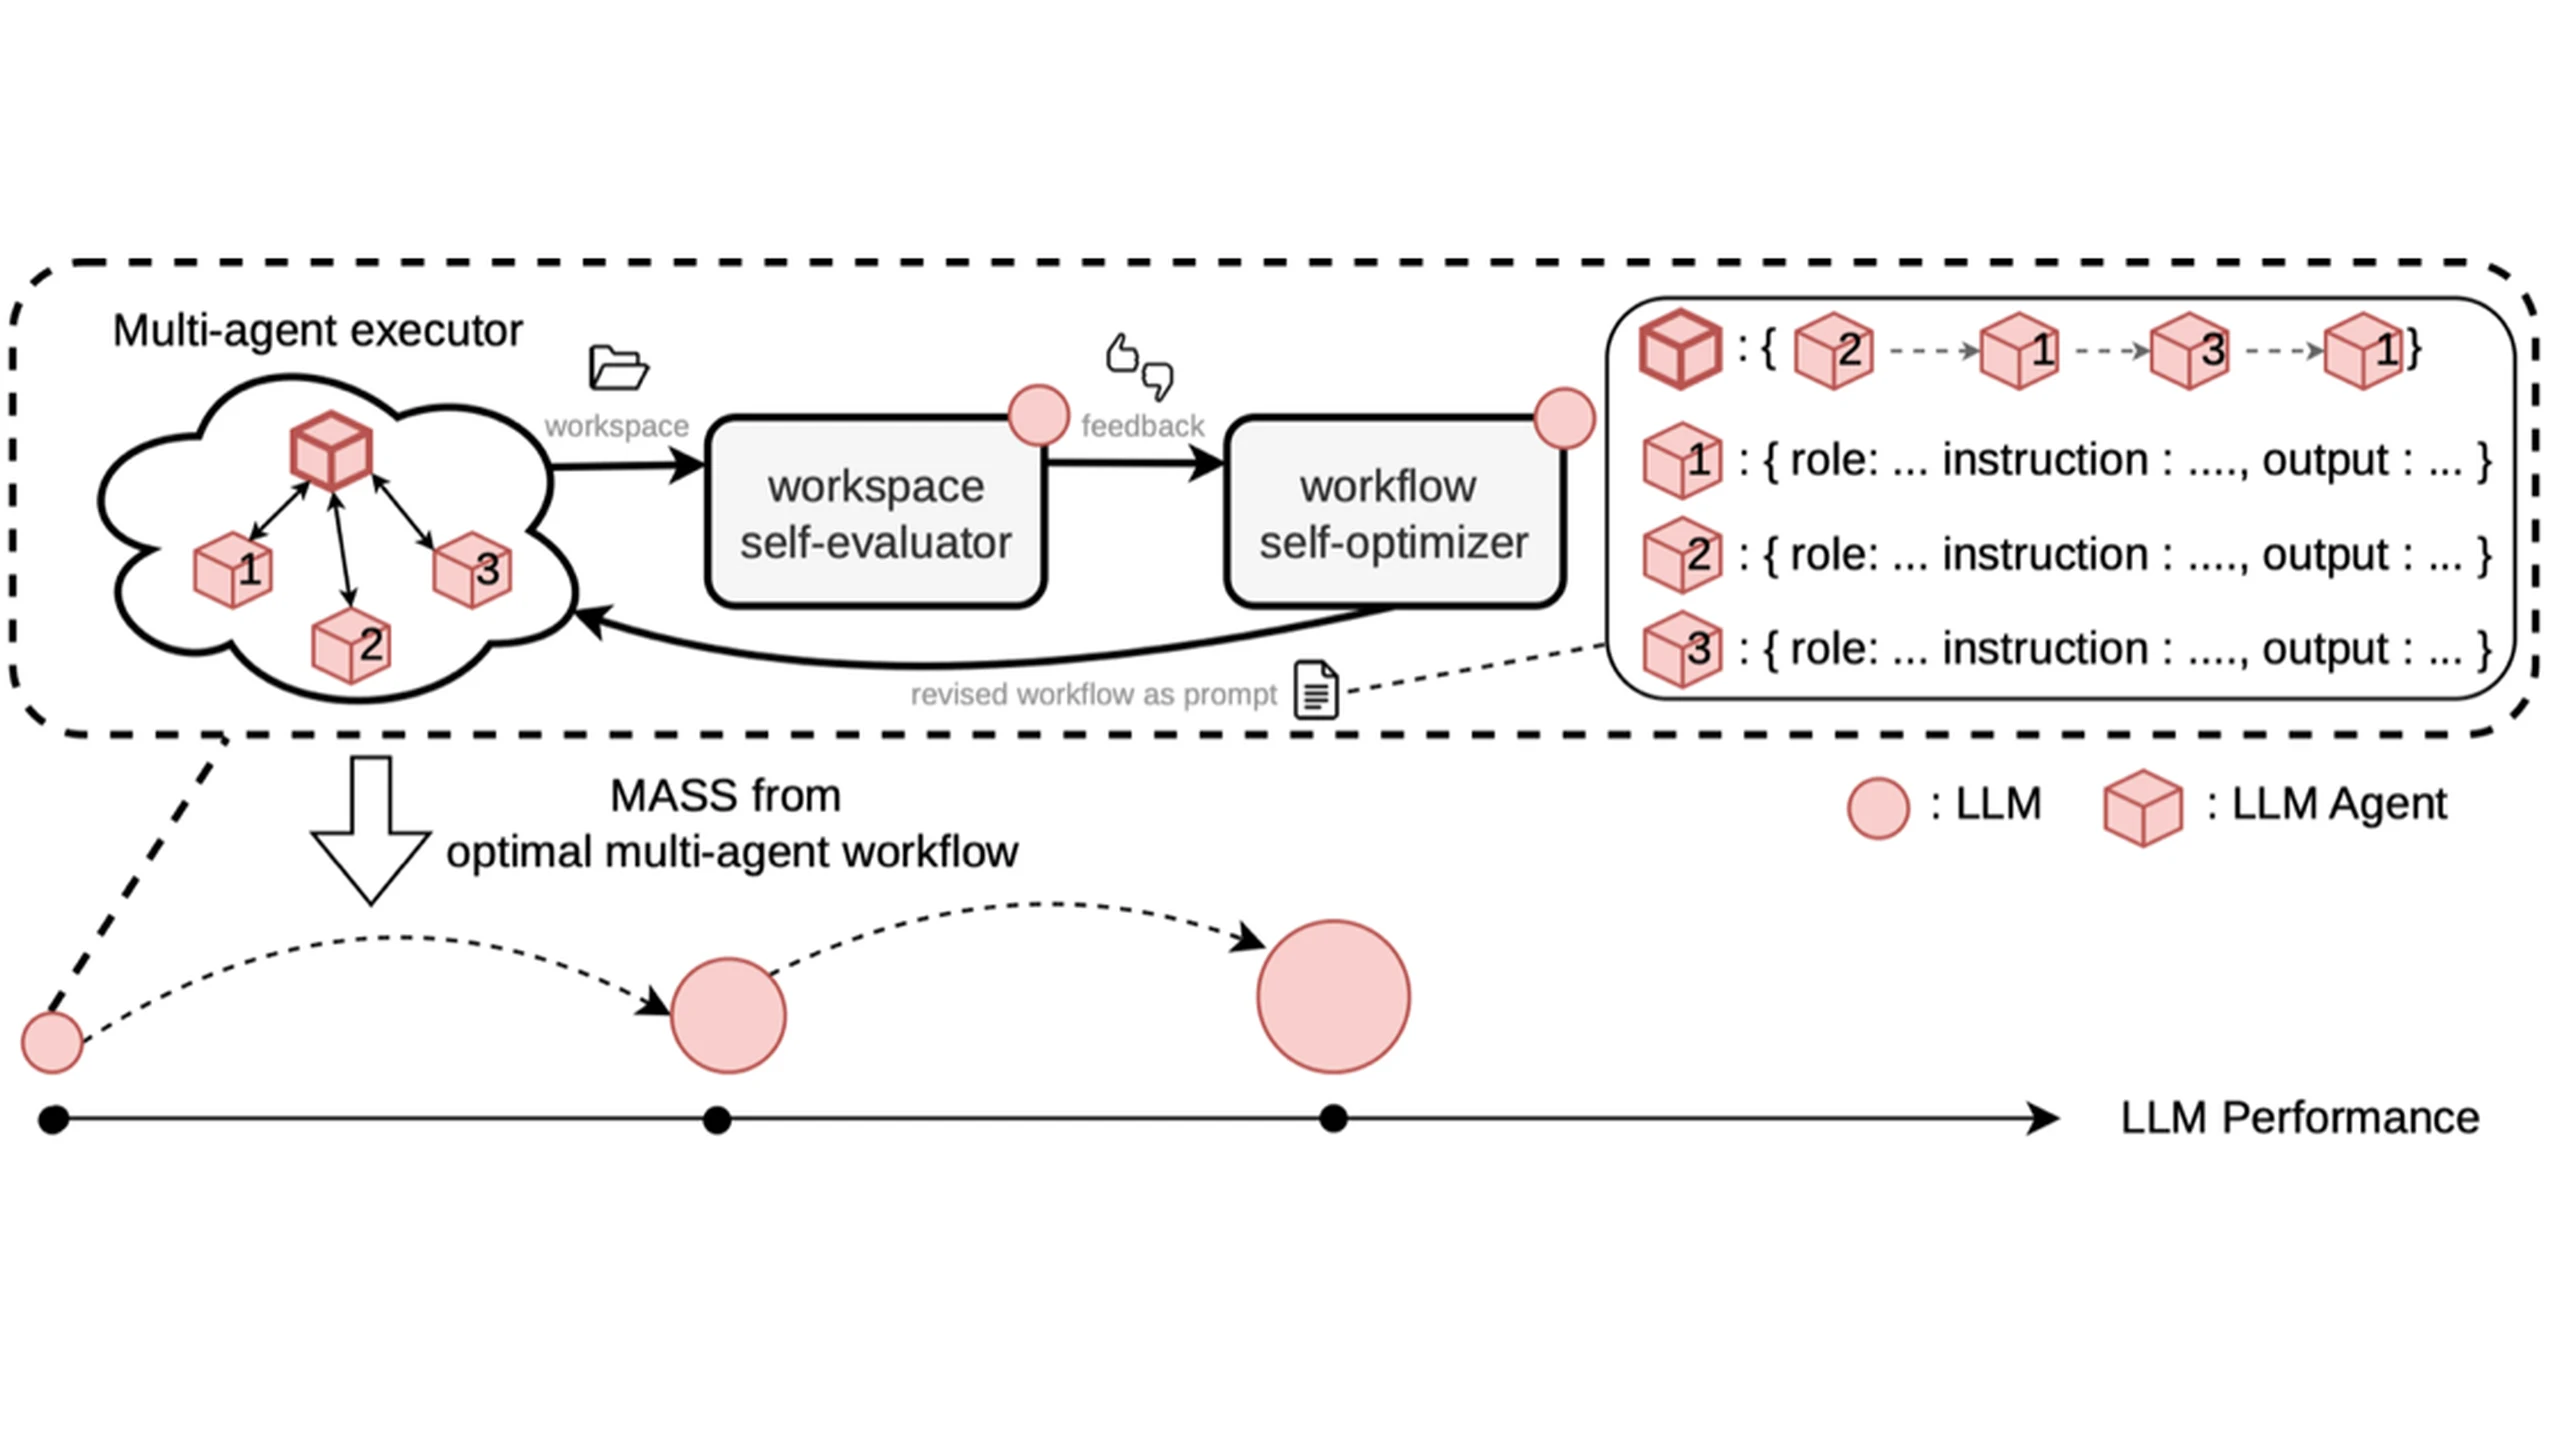
A Sakana AI concluiu dois ciclos de Multi-Agent Self-Supervision, ou MASS. Cópias do mesmo modelo produzem trabalhos de investigação, avaliam-nos e transformam as trajetórias selecionadas em dados de treino para o sucessor comum. Os avanços comunicados são resultados experimentais, mas desiguais: melhoram os benchmarks de investigação, enquanto dois testes de engenharia de software recuam. Trata-se de pós-treino delimitado, não de prova de uma explosão autónoma de inteligência.
O artigo submetido em 8 de outubro de 2026 e a implementação aberta incluem instruções das tarefas, configurações de treino, ferramentas de avaliação e documentação do processo. Mostram também o que o rótulo «recursivo» deixa por resolver: apenas dois ciclos completos, poucas tarefas e um modelo capaz de repetir o mesmo erro como executor, otimizador e avaliador.
Do trabalho da equipa à atualização do modelo
A inferência multiagente habitual divide uma tarefa entre instâncias e reúne os resultados sem alterar os pesos. O MASS preserva mensagens, chamadas de ferramentas, produtos intermédios e resultados como trajetórias de treino. Instâncias distintas realizam trabalhos diferentes, mas partilham o mesmo modelo: não são especialistas treinados de forma independente.
O ciclo interno mantém os pesos fixos e procura um fluxo de trabalho melhor definido por instruções. Este especifica papéis, orientações, contratos de saída e passos de comunicação. Cada tarefa de treino possui um fluxo campeão. Uma equipa candidata executa a tarefa, o modelo compara o seu espaço de trabalho com o do campeão e o otimizador propõe uma revisão a partir desse julgamento.
Depois da seleção, o MASS executa o fluxo 18 vezes por tarefa. Comparações aos pares feitas pelo modelo ordenam os espaços; um modelo Bradley–Terry converte preferências em pontuações. Retêm-se até 16 trajetórias: 15 podem fornecer exemplos de treino e uma fica para validação. O texto do fluxo é removido da instrução inicial de treino do orquestrador, para este inferir a organização a partir da tarefa em vez de copiar o plano fornecido.
O ciclo externo utiliza adaptação de baixo posto, LoRA, para ajustar um conjunto limitado de parâmetros. As conversas do orquestrador e dos subagentes são alvos de treino. O modelo atualizado regressa depois aos três papéis. O termo recursivo é defensável porque cada geração ajuda a gerar e selecionar os dados da seguinte. Os humanos continuam a definir arquitetura, tarefas, otimização, benchmarks, infraestrutura e limites dos ciclos.
Ganhos na investigação, uma fronteira clara na transferência
A base é Qwen3.6-27B num ambiente de agente de programação. A suite sintética contém 12 tarefas de finanças, robótica e farmácia, todas com código, análise quantitativa e relatório. Nove foram destinadas ao treino, mas oito acabaram por fornecer dados. Três, uma por domínio, ficaram fora do ajuste, da validação e da seleção de checkpoints.
GPT-5.5 e Claude Opus 4.8 foram avaliadores externos dos espaços de trabalho concluídos, não supervisores do ciclo de treino. Nas três tarefas reservadas, o modelo da primeira ronda venceu 53,9% das comparações com a base e o da segunda 69,9%. A segunda ronda venceu a primeira em 60,8%. Nas tarefas de treino, as vitórias contra a base foram 65,6% e 82,5%. Estes resultados mais fortes devem continuar separados da evidência reservada.
Nos benchmarks públicos de investigação, a Sakana comunica pontuações por token de saída entre 1,2 e 1,6 vezes a base após a segunda ronda. MLR-Bench subiu de 1,71 para 2,25, com entrega de artigos de 57% para 76%. ScienceAgentBench melhorou de 28,8% para 31,7%. AstaBench E2E-Hard passou de 0,053 para 0,067, e a entrega de relatórios de 50% para 76%. DSBench mudou apenas de 0,473 para 0,482: uma relação de eficiência superior não transforma essa pequena diferença absoluta numa grande subida de pontuação.
A engenharia de software seguiu o caminho inverso. Terminal-Bench 2.0 desceu de 0,375 para 0,352 e SWE-bench Verified de 0,626 para 0,611. Os rácios por token foram 0,96 e 0,94 vezes a base. Não é, portanto, um modelo uniformemente mais forte.
Uma explicação plausível é a correspondência entre tarefas: o treino privilegiou relatórios, provas quantitativas e código, não depuração de repositórios ou operações de terminal. Acrescentar tarefas de software pode ajudar, como sugere a Sakana, mas continua por testar e pode interferir com capacidades existentes. Testes de transferência devem verificar novos domínios e preservação dos anteriores.
Os custos ausentes dos números de eficiência
Numa comparação de treino, um aluno multiagente atingiu 68,3% de vitórias após 28,8 milhões de tokens supervisionados. O maior aluno de agente único atingiu 64% após 42 milhões. É um resultado melhor com menos 31% de tokens supervisionados, não uma redução demonstrada de 31% no custo total de desenvolvimento.
Antes da seleção, as equipas geravam em média cerca de 2,4 vezes mais tokens. Avaliadores externos preferiam os seus trabalhos em 85,1% das comparações com resultados individuais. Em dez pares de trajetórias com comprimentos semelhantes, as equipas ainda venciam 80%. Coordenação e seleção parecem produzir exemplos úteis, mas a comparação não isola delegação: fluxos e instruções de verificação também eram diferentes.
A pontuação por token mede resultados produtivos, não o processo inteiro. Procura de fluxos, execuções repetidas, comparações, geração de dados e avaliação consomem computação adicional. Os totais supervisionados excluem tokens de entrada e várias despesas anteriores. O MASS sustenta, assim, uma conclusão sobre dados selecionados mais densos; a eficiência global precisa de contabilidade mais completa.
Contratos de informação, não apenas personagens
A pesquisa altera papéis, instruções, contratos e passos de comunicação. Um contrato define a prova ou produto a devolver; um passo determina quando passar informação a outro agente ou devolvê-la para revisão. É mais concreto do que pedir a várias cópias que interpretem investigador, crítico ou editor.
Num exemplo financeiro, os agentes tratam de preparação de dados, construção de variáveis, modelação, backtesting, auditoria, reconciliação e relatório. O agente dos dados deve declarar se informação futura contaminou decisões históricas. A exigência visa uma falha real: um backtest impressionante pode simplesmente ter usado dados indisponíveis na altura.
A análise textual da Sakana encontrou concentração crescente de informação da tarefa em contratos e ordem de comunicação, não em papéis e instruções gerais. A amostra abrange apenas oito ou nove tarefas, conforme a comparação, e as estimativas de informação mútua descrevem textos dos fluxos, não todas as mensagens trocadas. É uma pista sobre o mecanismo, não uma prova causal ampla.
Os anteriores estudos de debate multiagente analisaram ganhos com respostas e críticas partilhadas. O MASS transfere comportamentos coletivos selecionados para os pesos: trajetórias do orquestrador ensinam decomposição e coordenação; as dos subagentes, missões delimitadas. Uma base de conhecimento técnico pesquisável ilustra o valor organizacional de preservar provas e decisões inspecionáveis, mas não valida o MASS de forma independente.
Otimizador e avaliador partilham limitações
Um modelo em três papéis reduz a dependência de um professor permanentemente mais forte, mas cria falhas correlacionadas. O executor pode interpretar mal uma tarefa, o avaliador premiar o erro e o sucessor aprendê-lo com maior confiança. Amostragem aleatória e especialização criam variação, não históricos independentes de treino nem julgamento garantidamente independente.
A apresentação do projeto Sakana identifica pontos cegos partilhados como problema de segurança. A concordância entre avaliadores internos e externos passou de 73% para 93% em três gerações. É encorajador nestas tarefas, não uma prova de correção: podem partilhar pressupostos ou favorecer relatórios polidos e ignorar erros que exigem experiências reais.
A capacidade do otimizador foi outro limite. Mantendo Qwen base como executor, GPT-5.5 apenas como avaliador trouxe melhoria limitada. Como avaliador e otimizador, encontrou fluxos vencedores para as 12 tarefas em até cinco iterações. O ciclo homogéneo acabou por encontrar vencedores em 11 de 12, mas precisou de até 13 iterações. Uma boa crítica não chega se o otimizador não a converter num processo melhor.
A procura também foi instável: iterações fortes podiam ser seguidas de regressões bruscas. As críticas comunitárias citadas no texto original questionavam o termo recursivo e a paragem após duas rondas. A interpretação prudente é procura iterativa de fluxos e ajuste supervisionado dentro de limites humanos, não autorreescrita sem restrições ou prova de progresso indefinido.
A supervisão deve acompanhar as capacidades
Investigação sem uma regra automática de sucesso é especialmente vulnerável à autoconfirmação. Um relatório coerente pode conter um erro conceptual, omitir provas contrárias ou implementar o objetivo errado em código funcional. O consenso dos modelos não resolve sozinho novidade científica, estratégia, valores ou segurança.
A investigação da OpenAI sobre monitorabilidade indica que trajetórias de raciocínio podem revelar mais do que ações e respostas finais, mas a monitorização é incompleta e depende de agente e monitor. As trajetórias ricas do MASS oferecem oportunidades de inspeção e esconderijos. Otimizar raciocínio visível pode premiar explicações convincentes sem corrigir comportamento.
A discussão da Anthropic sobre melhoria recursiva destaca igualmente supervisão, validação e verificação. Controlos independentes incluem modelos externos, especialistas, testes executáveis, dados fiáveis, avaliações adversariais e validação posterior no mundo real. Nenhum cobre todas as falhas; modelos concordantes podem partilhar o mesmo enviesamento.
Os testes decisivos seguintes são mais ciclos, transferência sem perda de capacidades e recuperação de um ponto cego comum introduzido deliberadamente. Não basta avaliadores externos detetarem o erro: o ciclo deve rever o fluxo e evitar treinar com trajetórias defeituosas. Por agora, o MASS demonstra aprendizagem concentrada a partir de equipas de investigação delimitadas e ricas em provas. Não demonstra melhoria recursiva ilimitada nem justifica retirar revisão humana de decisões importantes.