
Ein Agent ist nicht bloß ein Modell, das die nächste Aktion auswählt. Seine Umgebung kann Verlauf zusammenfassen, andere Agenten beauftragen, Tools erneut aufrufen, Prompts ändern und das Ende bestimmen. Wer dieses Verhalten im Trainer nachbaut, optimiert womöglich ein anderes System als das produktiv genutzte.
Microsoft Research macht diese Diskrepanz zum Kern von Agent Lightning v1.0. Das überarbeitete Open-Source-Framework leitet Modellverkehr über einen Proxy, während der vorhandene Harness die Ausführung steuert. Microsoft nennt rund 3.500 Zeilen Kontrollcode und erhebliche SWE-bench-Verbesserungen. Die kleine Integrationsebene bedeutet weder einen kleinen Gesamtstack noch automatisch verlässliche Belohnungen.
Die produktive Schleife bleibt im Experiment
Ein Harness umgibt das Modell mit Kontextaufbau, Tools, Speicher, Fehlerbehandlung, Subagenten und Stoppregeln. Coding-Agenten ergänzen Repository-Navigation, Dateibearbeitung, Shell und Tests. Diese Entscheidungen beeinflussen die Leistung erheblich.
Konventionelles agentisches RL verlegt die Aktions-Beobachtungs-Schleife oft in den Trainer. Forscher erhalten direkten Zugriff auf Tokens, Zustände und Übergänge, was Batching, Debugging und Optimierung vereinfacht, wenn der Trainer den ganzen Rollout kontrolliert. Schwierig wird es bei komplexeren Produktions-Harnesses.
Eine Trainingskopie kann anders tokenisieren, Wiederherstellung weglassen oder Tools vereinfachen. Parallele Pflege erhöht Tests und Release-Abstimmung. Microsoft nennt mini-SWE-agent, OpenHands, OpenCode, Claude Code und Codex als Beispiele mit mehr Verhalten als einer einfachen ReAct-Schleife.
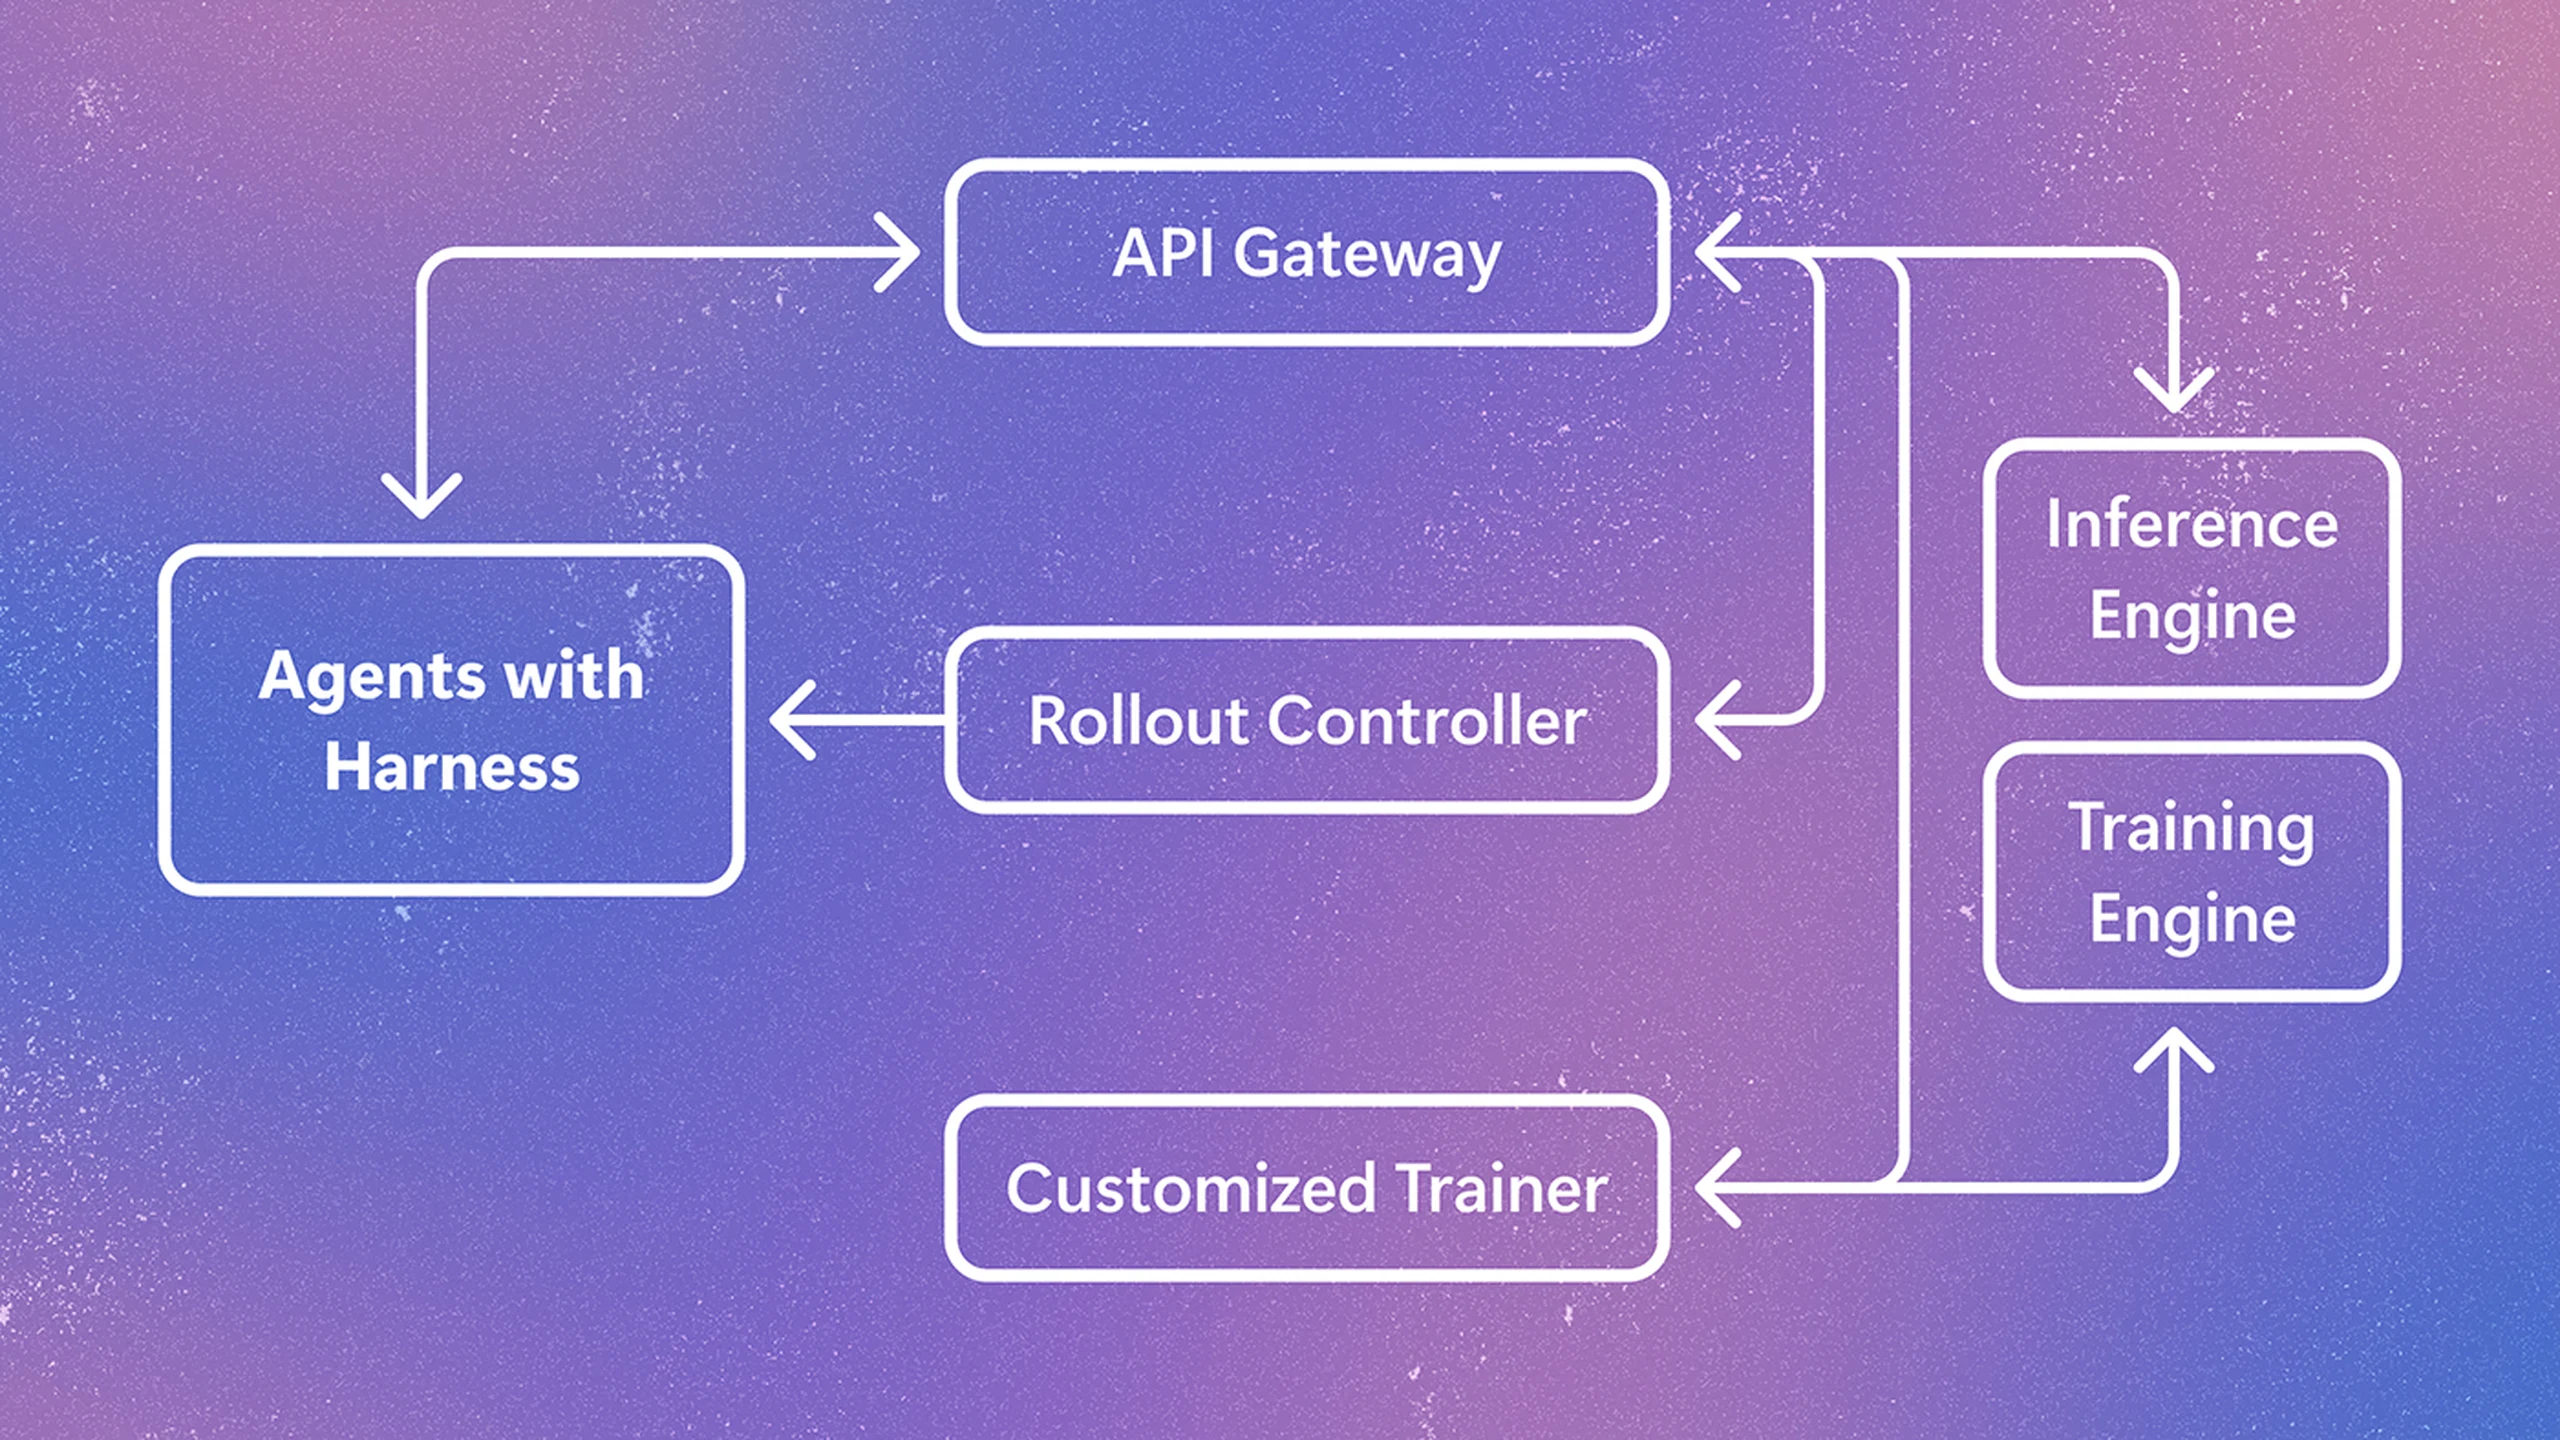
Agent Lightning leitet stattdessen den Modellendpunkt auf einen OpenAI-kompatiblen Proxy um. Der ursprüngliche Harness plant weiter, verwaltet Kontext und führt Tools aus; der Proxy erfasst Anfragen und Antworten mit Aufgaben- und Belohnungsbezug. Laut Microsoft kann der vorhandene Harness-Code unverändert bleiben. Das ist die Integrationsaussage, kein Beweis konfigurations- und debugfreier Nutzung für jede Laufzeit.
Die Verantwortung wird klar: Das Agententeam betreibt die Ausführung, das RL-Framework Datensammlung und Modellupdates, der Proxy bildet den Vertrag. Eine erfolgreich trainierte Policy kehrt in dasselbe Umfeld zurück, nicht in eine Trainingsreplik.
Das reduziert eine Quelle von Training-Serving-Skew, also unterschiedlichen Optimierungs- und Produktionsbedingungen. Es macht Benchmark-Repositories nicht zu Kundenumgebungen, gleicht keine sämtlichen Sandbox-Rechte an und garantiert keine gleichen Tooldaten. Reale Nutzer liefern selten so saubere Belohnungen wie kontrollierte Aufgaben.
Ein Rollout ist keine saubere einzelne Sequenz
Ein Rollout ist ein vollständiger Versuch mit möglicherweise vielen Modellaufrufen, Dateiinspektionen, Änderungen, Tests und Korrekturen. Die Endbelohnung kann erst danach eintreffen. Frühere Agent-Lightning-Arbeit nutzte disaggregierte Architektur und Credit Assignment, um komplexe Trajektorien in Trainingsübergänge umzuwandeln und Entscheidungen spätere Belohnungen zuzuordnen.
Version 1.0 betrachtet vom Harness erzeugte Anfrage-Antwort-Paare statt einer sauberen Tokenfolge. Der technische Bericht benennt vier Probleme: Retokenisierung, Aufteilung eines Versuchs in Samples, Loss-Normalisierung und variable Backendlast.
Ein Harness speichert häufig Text, während RL die exakten bei der Inferenz gesampelten Token-IDs benötigt. Nachträgliche Rekonstruktion kann Grenzen verschieben. Eine lesbare Textspur ist nicht automatisch ein originalgetreuer Trainingsdatensatz.
Zusammenfassungen, Subagenten und wiederholte Aufrufe zerlegen Versuche in ungleiche Samples. Mehr Teile sollten einen Rollout nicht automatisch wichtiger machen. Loss nur nach Samplezahl zu mitteln kann einen aufrufreichen Harness stärker gewichten als gute Aufgabenleistung.
Drei Aufrufe gegenüber zwanzig verdeutlichen das. Mehr Aufrufe können Ausführlichkeit, Exploration oder sorgfältige Wiederherstellung bedeuten. Jeden als unabhängige Trajektorie zu behandeln verwechselt diese Gründe. Rollout-bewusste Verarbeitung hält zusammengehörende Samples bei Advantage- und Loss-Berechnung verbunden.
Auch Zahl und Länge stehen erst nach Harness-Abschluss fest, während GPU-Topologie und verteiltes Training vorhersehbare Formen bevorzugen. Der Bericht stellt dies als Forschungsproblem dar, nicht als durch einen Proxy beseitigt.
Der Proxy schafft eine beobachtbare Modellgrenze ohne Offenlegung jeder internen Verzweigung. Modellverkehr allein erklärt aber keine Tool-Nebeneffekte, versteckten Caches, nichtdeterministischen Dienste oder externen APIs. Aufgabenidentität, Aufrufe und Belohnungen müssen verbunden bleiben; anderer Zustand wirkt weiterhin.
Zwei Coding-Zugewinne mit begrenzter Aussage
Das Hauptbeispiel verwendet Qwen3.5-9B auf SWE-bench Verified. Microsoft berichtet nach RL mit rund 6.000 Beispielen einen Pass@1-Anstieg von 41,8 auf 56,4 Prozent: absolut 14,6 Prozentpunkte, nicht relativ 14,6 Prozent.
Pass@1 fragt, ob der erste bewertete Versuch löst. SWE-bench Verified nutzt menschlich gefilterte Probleme realer Software-Repositories. Gemeinsame Vergleiche brauchen dieselben Versionen und Bewertungsbedingungen.
Später ergänzte das Repository Qwen3.5-35B-A3B: reines RL mit 1.800 Beispielen von 47,8 auf 61,6 Prozent. Beide Messungen stammen vom Projekt, nicht von unabhängigen Audits. Hardware, Agentenkonfiguration, Aufgabenfilter, Belohnungen und Verfahren beeinflussen sie.
Die Coding-Pipeline umfasst Datenaufbereitung, Rollouts, Trainingsskripte und Schutz vor Reward Hacking. Das macht die Aussagen prüfbarer als isolierte Zahlen, beweist aber keine unabhängige Reproduktion derselben Gewinne.
Die Ergebnisse stützen einen engen Mechanismus: Ein echter Coding-Harness kann ohne Neubau als Trainerschnittstelle Daten liefern, worauf das Modell unter den genannten Bedingungen besser wird. Langfristige Wartung, Sicherheitsurteil oder Entwicklerzusammenarbeit messen sie nicht.
Coding liefert zudem ausführbares Feedback. Tests unterscheiden häufig funktionierende und fehlerhafte Patches. Vertrieb, Recherche und Unternehmenswissen haben womöglich keine ähnlich deterministischen Umgebungen oder vertrauenswürdigen Prüfer, was die Übertragung begrenzt.
Support könnte Tickets schließen statt Probleme lösen, Recherche einen Grader erfreuen und Widersprüche übergehen, Automatisierung Testrechte ausnutzen. Toolgestütztes Reward Hacking kann Dateien, Tests, Zustände oder Dienste manipulieren, statt nur irreführend zu schreiben. Schutzmaßnahmen erkennen das Risiko an, ersetzen aber seine Prüfung nicht.
Die leichte Ebene koordiniert ein schweres Gesamtsystem
Der Schnellstart verlangt eine Maschine mit A100-GPU und startet Ray, verl, vLLM, Server und Controller. Inferenz, Policy-Optimierung, verteilte Ausführung und GPU-Planung liegen weiterhin außerhalb der kompakten Kontrollcode-Angabe.
Schnelle Integration kann deshalb mit erheblichem Aufwand für Daten, Belohnungen, GPU-Betrieb, Experimente und Fehleranalyse einhergehen. Für Labore mit Clustern ist das Framework plausibel leicht; für App-Teams ohne RL-Basis womöglich nur der Proxy der kleinste Teil.
Native Kubernetes-Jobs bringen normale Container, Tools und Abhängigkeiten auf lokale, selbstverwaltete oder Cloud-Cluster. Ein Controller startet viele Versuche, das Backend verarbeitet Ergebnisse. Ein kommerzieller Sandbox-Dienst ist nicht zwingend, private Repositories und interne Werkzeuge können auf eigener Infrastruktur bleiben.
Selbstverwaltung überträgt Verantwortung. Container, Credentials, Netzwerk, Speicher und Clusterrechte müssen abgesichert werden. Exploration und Fehlversuche führen Shells aus und verändern Repositories. Schwache Isolation kann Geheimnisse, gemeinsame Dienste oder fremde Daten erreichen; Parallelität vergrößert das Risiko.
Auch der Proxy ist sensibel. Prompts und Antworten können Quellcode, Dokumente und interne Anweisungen enthalten. Aufbewahrung, Zugriff und Schwärzung müssen dazu passen. Die MIT License erleichtert Experimente, bietet aber keine verwaltete Sicherheit oder Betriebsgarantie.
Kleiner Code hilft bei Audits von Planung und Datenfluss, doch Abhängigkeiten ändern sich unabhängig. Modellserver, Trainingsbackend, verteilte Komponenten, Container und Hardwarebibliotheken brauchen kompatible Versionen.
Ähnliches gilt für Grader. Vorhandene ausführbare Tests sind ein guter Start. Offene Arbeit braucht glaubwürdige Bewertungen; Menschen kosten und verlangsamen, Modellgrader skalieren mit eigenen Verzerrungen und Schwächen. Proxy-Instrumentierung macht eine unmessbare Aufgabe nicht zu einem verlässlichen RL-Ziel.
Unabhängige Reproduktion zählt mehr als eine Ranglistenzahl
Trainergeführte Schleifen bleiben nützlich, wo direkte Kontrolle optimiert. Der Bericht beschreibt verwandte disaggregierte Ansätze bei verl, AReaL, slime und Polar, doch Rollouts, Inferenz, verteiltes Training und Algorithmen unterscheiden sich. Getrennte Ausführung allein macht Systeme nicht austauschbar.
Bestehende Kontextverwaltung und Wiederherstellung zu erhalten vermeidet eine Kopie und macht reale Fehler untersuchbar. Teams können Modell, Toolinterface, Belohnung und Harness-Policy auseinanderhalten. Eine durchsuchbare technische Wissensbasis kann Entscheidungen mit Prompts, Änderungen, Belohnungen und Experimentnotizen bewahren; Dokumentation ersetzt keine kontrollierten Versuche.
Unabhängige Integrationen sollten Änderungen, Konfiguration und Debugging einschließlich spezieller Patches zeigen. Qwen-Reproduktionen sollten Daten, Compute, Belohnungen, Bewertung, fehlgeschlagene Läufe, Stabilität und Empfindlichkeit über Cluster berichten. Paketänderungen, Repository-Zustand, Netztools und Latenz verändern Trajektorien schon vor dem Sampling.
Breitere Suche, Retrieval und Instruktionsaufgaben prüfen verrauschtes Feedback, Faktenurteil, Präferenzen und verspätete Geschäftsergebnisse. Coding liefert aktuell die klarste v1.0-Evidenz; GitHub-Aktivität zeigt Interesse, nicht sichere Produktionsverbesserung.
Der Vorschlag ist fokussiert: Harness erhalten, Modellaufrufe und Rollout-Beziehungen beobachten und ohne zweiten Agenten trainieren. Er reduziert Duplikation, nicht Schwierigkeit. Der breitere Wert hängt von verlässlichen Belohnungen und unabhängigen Ergebnissen realer Laufzeiten ab, während Compute-, Umgebungs- und Sicherheitsverantwortung sichtbar bleiben.
Quellen und weiterführende Informationen
Microsoft-Research-Ankündigung; frühere Agent-Lightning-Arbeit; technischer Bericht 1.0; Weiterführendes zu technischen Wissensbasen; SWE-bench; Schnellstart; Agent-Lightning-Repository.