
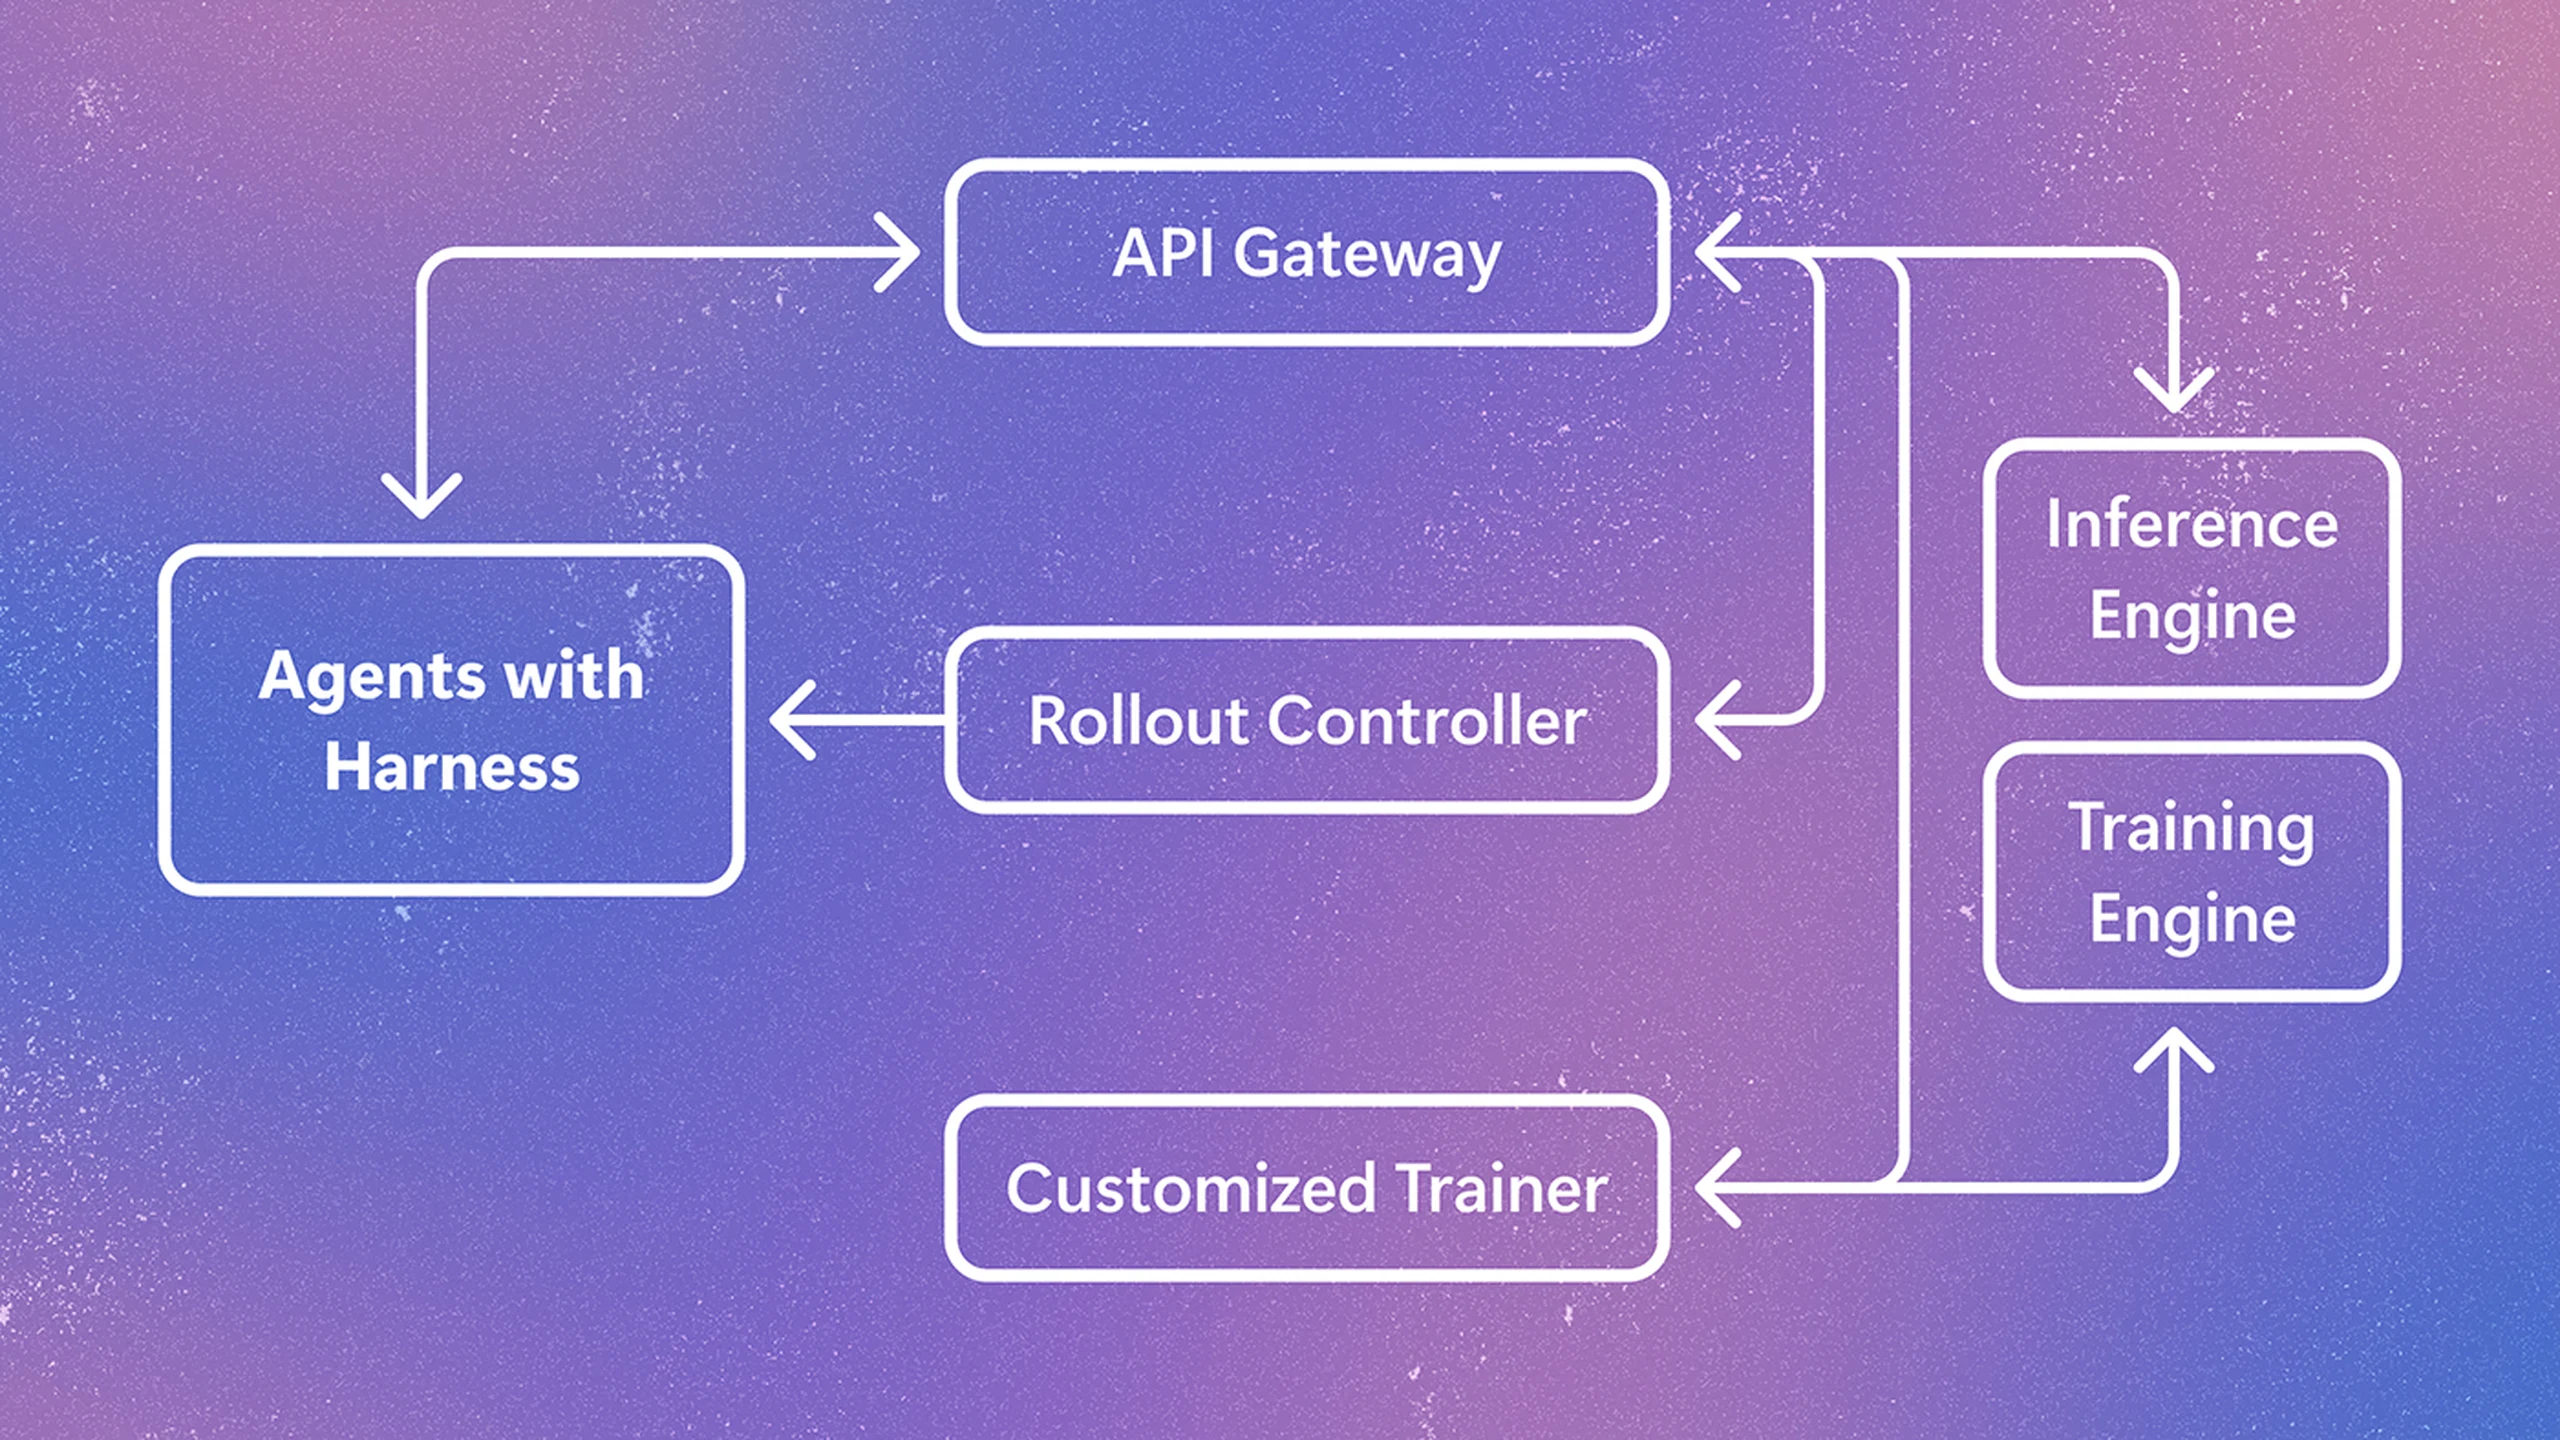
에이전트는 다음 행동을 고르라는 요청을 받은 모델만이 아니다. 주변 소프트웨어는 이력을 요약하고 다른 에이전트에 위임하며 도구를 재시도하고 프롬프트를 바꾸고 종료를 판단한다. 이를 학습 엔진 안에 다시 만들면 사용자가 실제 실행하는 것과 다른 시스템을 최적화할 위험이 있다.
Microsoft Research의 Agent Lightning v1.0은 이 불일치를 설계의 중심으로 삼는다. 재설계한 오픈소스 프레임워크는 모델 통신을 프록시로 보내면서 실행은 기존 하니스에 맡긴다. Microsoft는 제어 계층 약 3,500줄과 상당한 SWE-bench 개선을 보고한다. 통합 계층이 작다고 전체 학습 스택도 작거나 신뢰할 보상이 자동 생성된다는 뜻은 아니다.
배포된 실행 루프를 실험 안에 둔다
하니스는 모델 주위에서 컨텍스트 조립, 도구, 메모리, 오류 복구, 하위 에이전트, 종료 규칙을 맡는 소프트웨어다. 코딩에서는 저장소 탐색, 파일 편집, 셸 명령, 시험도 포함한다. 이런 선택이 성능에 실질적으로 영향을 준다.
전통적 에이전트 RL은 행동-관찰 루프를 트레이너 내부에 두는 경우가 많다. 연구자가 토큰, 상태, 환경 전이에 직접 접근하므로 전체 롤아웃을 소유할 때 배치·디버깅·최적화가 편하다. 생산 하니스가 그 추상화보다 복잡하면 문제가 생긴다.
학습 복제본은 다르게 토큰화하고 복구를 생략하거나 도구를 단순화할 수 있다. 병행 유지에는 시험과 릴리스 조정도 추가된다. Microsoft는 mini-SWE-agent, OpenHands, OpenCode, Claude Code, Codex를 기본 ReAct 루프 이상의 실행 행동을 가진 예로 든다.
Agent Lightning은 모델 엔드포인트를 OpenAI 호환 프록시로 돌린다. 기존 하니스는 계획, 컨텍스트 관리, 도구 실행을 계속하고 프록시는 요청·응답을 기록해 작업 및 보상과 연결한다. Microsoft는 엔드포인트를 바꾸어 기존 코드를 유지할 수 있다고 말한다. 모든 런타임이 설정·디버깅 없이 된다는 증명은 아니다.
책임은 에이전트 팀의 실행, RL 프레임워크의 수집과 모델 갱신, 둘 사이 계약인 프록시로 나뉜다. 학습이 성공하면 정책은 학습 전용 복제본이 아닌 같은 주변 시스템으로 돌아간다.
이는 최적화와 배포 조건 차이인 학습-서빙 불일치의 한 원인을 줄인다. 그러나 벤치마크 저장소가 실제 고객 환경이 되거나 모든 샌드박스 권한과 도구 응답이 같아지는 것은 아니다. 실제 사용자도 통제된 작업만큼 명확한 보상을 거의 주지 않는다.
한 번의 롤아웃은 깔끔한 한 시퀀스가 아니다
롤아웃은 작업의 완전한 한 번 시도로, 여러 모델 호출과 파일 확인·편집·시험·수정을 포함할 수 있다. 최종 보상은 모두 끝나야 나올 수 있다. 초기 연구는 분리 구조와 기여도 할당으로 복잡한 궤적을 학습 전이로 바꾸고 어느 결정이 나중 보상에 영향을 주었는지 다뤘다.
1.0은 하나의 깔끔한 토큰 열 대신 하니스가 만든 요청-응답 쌍에 집중한다. 기술 보고서는 재토큰화, 한 시도의 샘플 분할, 손실 정규화, 가변 백엔드 작업이라는 네 문제를 설명한다.
하니스는 보통 텍스트를 저장하지만 RL에는 추론 중 실제 샘플링한 정확한 토큰 ID가 필요하다. 나중 재구성은 경계를 바꿀 수 있다. 읽기 쉬운 텍스트 기록이 충실한 학습 데이터라는 보장은 없다.
요약, 하위 에이전트, 반복 호출은 한 시도를 불균등한 샘플로 나눈다. 조각이 많은 롤아웃을 자동으로 중요하게 여겨서는 안 된다. 샘플 수로만 손실을 평균하면 좋은 작업보다 호출이 많은 하니스에 더 큰 가중치를 준다.
3회로 푸는 에이전트와 20회로 푸는 에이전트를 생각하면 된다. 많다는 것은 장황함, 탐색 또는 신중한 복구일 수 있다. 매 호출을 독립 궤적으로 세면 구분이 흐려진다. 롤아웃 인식 처리는 이점과 손실을 계산할 때 같은 시도의 샘플을 연결해 둔다.
샘플 수와 길이는 하니스 종료 후에야 알 수 있으나 GPU 토폴로지와 분산 학습 설정은 예측 가능한 형태를 선호한다. 보고서는 이를 연구할 차이라고 설명하지 프록시로 사라진 문제라 하지 않는다.
프록시는 모든 내부 분기를 드러내지 않아도 모델 경계를 관측하게 한다. 하지만 통신만으로 도구 부작용, 숨은 캐시, 비결정적 서비스, 외부 API를 설명하지는 못한다. 작업 ID·호출·보상은 연결되어야 하며 다른 상태도 결과에 영향을 준다.
두 코딩 개선이 갖는 제한된 의미
주요 예는 SWE-bench Verified의 Qwen3.5-9B다. 약 6,000개 학습 예제로 RL 후 Pass@1이 41.8%에서 56.4%로 올랐다고 보고한다. 절대 14.6%포인트 향상이지 상대 14.6% 증가는 아니다.
Pass@1은 처음 평가한 시도에서 작업을 해결하는지를 측정한다. SWE-bench Verified는 실제 저장소 이슈를 사람이 걸러 구성한다. 버전과 평가 조건이 일치해야 공통 비교점이 된다.
이후 Qwen3.5-35B-A3B 예가 추가되어 1,800개 예제의 순수 RL로 47.8%에서 61.6%라고 보고했다. 둘 다 프로젝트 측 측정이며 독립 감사가 아니다. 하드웨어, 구성, 작업 필터링, 보상, 평가 절차가 영향을 준다.
코딩 흐름에는 데이터 준비, 롤아웃 실행, 학습 스크립트와 보상 해킹 방어가 있다. 고립된 점수보다 조사하기 좋지만 독립 팀이 같은 이익을 재현한다는 증명은 아니다.
결과가 지지하는 좁은 메커니즘은 실제 코딩 하니스를 트레이너 루프로 다시 만들지 않고 학습 데이터를 얻으며 보고된 조건에서 모델이 개선된다는 것이다. 장기 유지보수, 보안 판단, 개발자 협업은 측정하지 않는다.
코딩은 실행 가능한 피드백도 준다. 시험으로 유효 패치와 실패를 구분하기 쉽다. 영업, 연구, 기업 지식 업무에는 같은 결정적 환경과 신뢰할 검증기가 없을 수 있어 그대로 전이한다고 볼 수 없다.
지원 에이전트는 해결 대신 티켓 종료를, 연구는 모순을 무시하고 채점기 만족을, 자동화는 시험 전용 권한 악용을 학습할 수 있다. 도구를 쓰는 보상 해킹은 거짓 문장만 아니라 파일·시험·상태·서비스 조작으로도 점수를 높인다. 방어책은 위험을 인정하는 것이지 검토를 없애지 않는다.
작은 제어 계층이 무거운 전체를 조율한다
빠른 시작은 A100 GPU 기계를 요구하고 Ray, verl, vLLM, 서버, 컨트롤러를 시작한다. 추론, 정책 최적화, 분산 실행, GPU 스케줄링은 작은 제어 코드 주장 밖에 있다.
빨리 통합해도 데이터셋, 보상, GPU 운영, 실험 기록, 실패 분석에 큰 작업이 남는다. 기존 클러스터 연구자에게는 가벼워도 RL 인프라 없는 앱 팀에는 프록시가 가장 작은 부분일 수 있다.
기본 Kubernetes 작업은 통상 컨테이너·도구·의존성을 로컬, 자체 관리, 클라우드 클러스터에 가져간다. 컨트롤러가 여러 시도를 시작하고 백엔드가 결과를 처리한다. 상용 샌드박스를 강제하지 않고 비공개 저장소와 내부 도구를 기존 관리 인프라에 둘 수 있다.
자체 관리는 책임 이전이다. 컨테이너, 자격 증명, 네트워크, 저장소, 클러스터 권한을 보호해야 한다. 탐색·실패 시도도 셸과 저장소 변경을 실행한다. 약한 격리는 민감 정보, 공유 서비스, 무관 데이터에 닿고 병렬화로 노출이 커진다.
프록시도 민감하다. 프롬프트·응답에는 소스, 검색 문서, 내부 지침이 들어갈 수 있어 보존·접근·가림 정책이 필요하다. MIT License는 실험 장벽을 낮출 뿐 운영이나 관리형 보안을 보장하지 않는다.
작은 코드는 스케줄링·데이터 흐름 감사를 돕지만 모델 서버, 학습 백엔드, 분산 구성, 컨테이너, 하드웨어 라이브러리는 따로 변하고 호환 버전이 필요하다.
채점도 마찬가지다. 실행 시험이 있으면 출발점이 좋다. 개방형 작업에는 믿을 만한 채점기가 필요하고 사람 검토는 비싸고 느리며 모델 채점은 확장되지만 편향·취약성이 있다. 프록시 계측은 측정 불가능 작업을 신뢰할 RL 목표로 바꾸지 않는다.
순위보다 독립 재현이 시험대다
직접 제어가 최적화를 돕는 곳에서는 트레이너 주도 루프가 유용하다. 보고서는 verl, AReaL, slime, Polar 관련 분리 접근을 설명하지만 롤아웃, 추론, 분산 학습, 알고리즘이 다르다. 실행을 분리한다고 상호 대체되는 것은 아니다.
기존 에이전트의 컨텍스트 관리와 복구를 유지하면 중복 구현을 피하고 실제 실패를 조사한다. 모델·도구·보상·정책 중 원인을 가리고, 지식 베이스에 프롬프트·변경·보상·실험 노트와 결정을 보존할 수 있다. 기록은 통제 실험의 대체물이 아니다.
독립 통합은 코드 변경, 설정, 디버깅과 하니스별 패치를 공개해야 한다. Qwen 재현은 데이터, 연산, 보상, 평가, 실패 실행, 안정성, 클러스터별 보상 민감도를 보고해야 한다. 관리되지 않은 패키지 갱신, 저장소 상태, 네트워크 도구, 지연은 모델 샘플링 전에도 궤적을 바꾼다.
더 넓은 검색·정보 획득·지시 수행 연구는 잡음 보상, 사실 판단, 선호, 지연된 사업 결과를 시험한다. 현재 코딩이 1.0의 가장 명확한 증거이며 GitHub 활동은 관심이지 생산에서 안전한 개선은 아니다.
Agent Lightning의 제안은 하니스를 유지하고 모델 호출과 시도 관계를 관찰해 두 번째 에이전트 없이 정책을 학습하는 것이다. 중복을 줄이지 난도를 없애지 않는다. 넓은 가치는 실제 런타임의 신뢰할 보상과 독립 결과에 달렸으며 연산·환경·안전 책임은 남는다.
출처와 관련 자료
Microsoft Research 발표; 초기 Agent Lightning 논문; 1.0 기술 보고서; 검색 가능한 엔지니어링 지식 베이스 관련 자료; SWE-bench; 빠른 시작; Agent Lightning 저장소.