
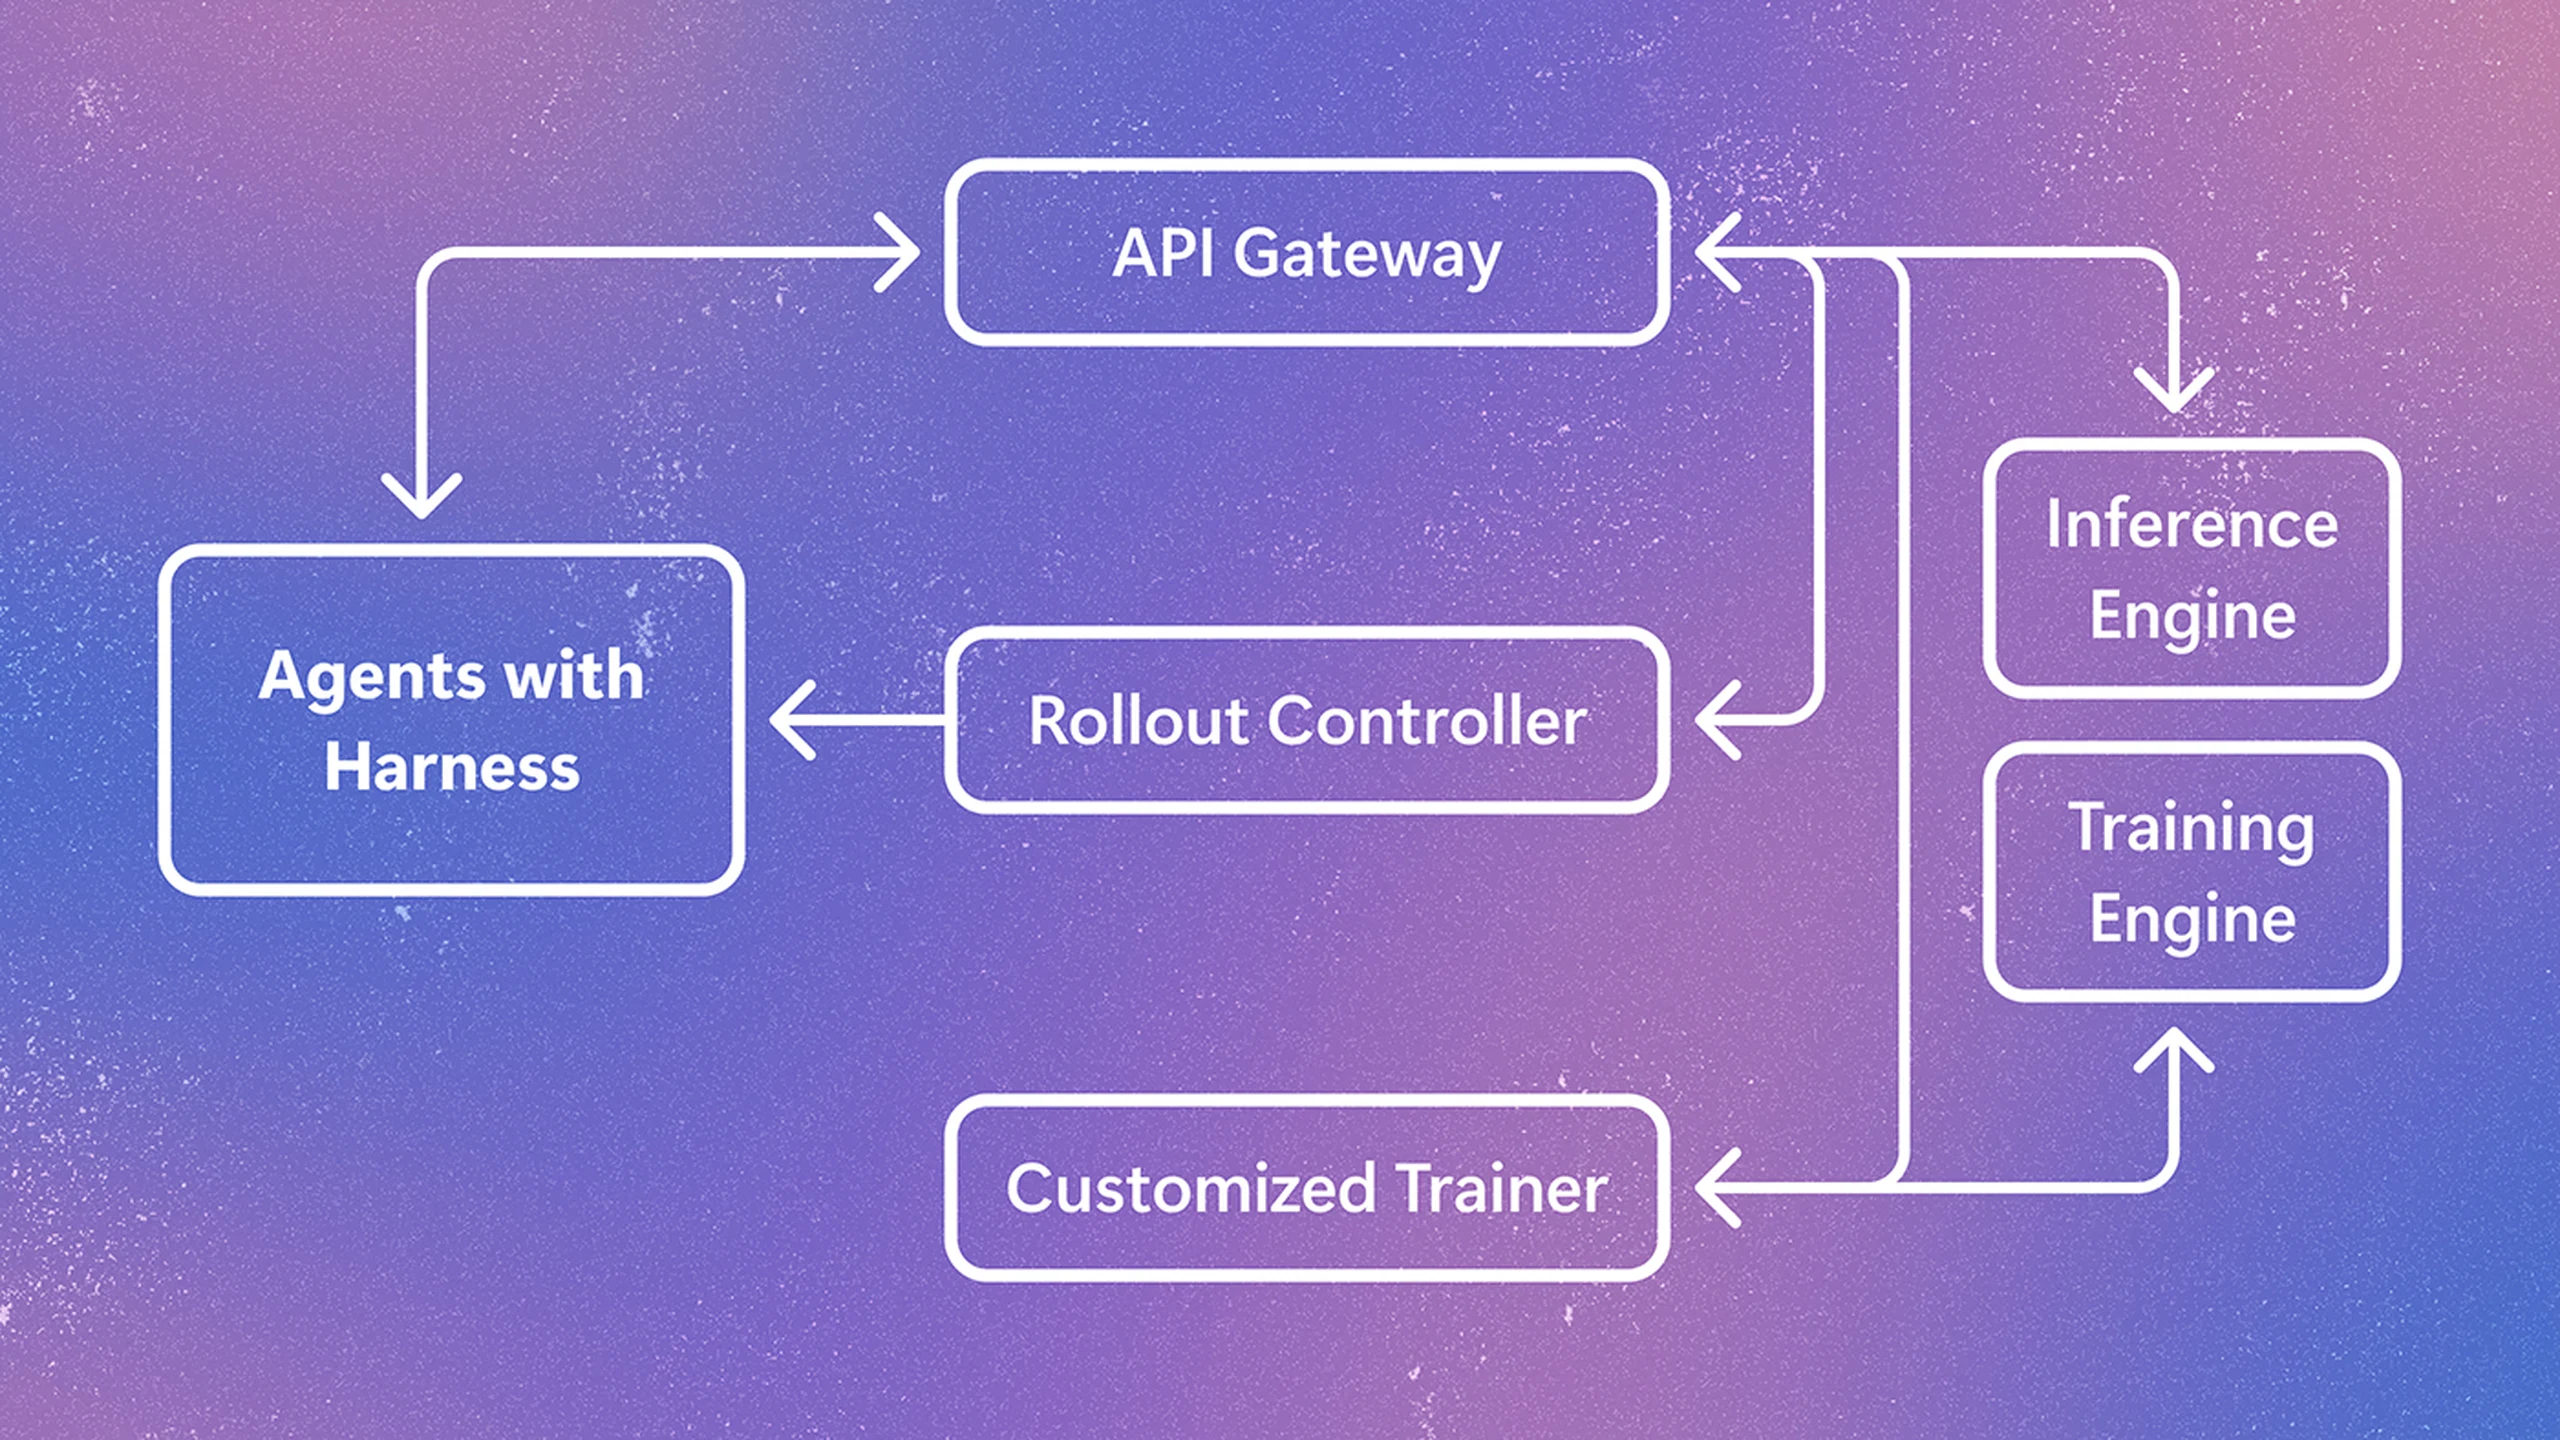
Agent nie jest wyłącznie modelem wybierającym następny krok. Otaczające oprogramowanie może streszczać historię, delegować innemu agentowi, ponawiać narzędzie, zmieniać prompty i określać koniec. Odtworzenie tego wewnątrz trenera grozi optymalizacją innego systemu niż używany przez ludzi.
Microsoft Research stawia tę rozbieżność w centrum Agent Lightning v1.0. Przebudowany framework open source kieruje ruch modelu przez proxy, pozostawiając wykonanie dotychczasowej warstwie, czyli harnessowi. Microsoft mówi o około 3500 liniach sterowania i dużych poprawach SWE-bench. Mała integracja nie oznacza małego całego treningu ani automatycznych wiarygodnych nagród.
Produkcyjna pętla pozostaje w eksperymencie
Harness otacza model składaniem kontekstu, narzędziami, pamięcią, odzyskiwaniem, podagentami i regułami zakończenia. W kodowaniu obejmuje nawigację repozytorium, edycje, powłokę i testy. Te wybory istotnie wpływają na wynik.
Tradycyjne agentowe RL często przenosi pętlę akcja–obserwacja do trenera. Badacze mają bezpośredni dostęp do tokenów, stanów i przejść, co upraszcza batchowanie, debugowanie i optymalizację przy kontroli całego rolloutu. Problem pojawia się, gdy produkcyjny harness jest bardziej złożony niż abstrakcja.
Kopia treningowa może inaczej tokenizować, pomijać odzyskiwanie lub upraszczać narzędzia. Równoległe utrzymanie zwiększa testy i koordynację wydań. Microsoft podaje mini-SWE-agent, OpenHands, OpenCode, Claude Code i Codex jako przykłady zachowań wykraczających poza prostą pętlę ReAct.
Agent Lightning przekierowuje zamiast tego endpoint do proxy zgodnego z OpenAI. Oryginalna warstwa nadal planuje, zarządza kontekstem i wykonuje narzędzia, a proxy zapisuje żądania i odpowiedzi z zadaniem i nagrodą. Microsoft twierdzi, że kod może pozostać bez zmian. To deklaracja integracyjna, nie dowód braku konfiguracji i debugowania dla każdego środowiska.
Podział jest jawny: zespół agenta odpowiada za wykonanie, framework RL za zbiór danych i aktualizacje, proxy za kontrakt. Wytrenowana polityka wraca do tego samego otoczenia, nie repliki przeznaczonej tylko do treningu.
Ogranicza to jedną przyczynę rozbieżności trening–produkcja, czyli inne warunki optymalizacji i wdrożenia. Nie zmienia benchmarkowego repozytorium w środowisko klienta, nie wyrównuje uprawnień sandboxów ani danych narzędzi. Prawdziwi użytkownicy rzadko dają równie czyste nagrody jak kontrolowane zadanie.
Jeden rollout nie jest jedną równą sekwencją
Rollout to pełna próba z potencjalnie wieloma wywołaniami, inspekcją plików, zmianami, testami i korektami. Ostateczna nagroda może przyjść dopiero po wszystkim. Pierwotne badania wykorzystywały rozdzieloną architekturę i przypisywanie wkładu do zamiany złożonych trajektorii w przejścia treningowe oraz przyporządkowania decyzji późniejszym nagrodom.
Wersja 1.0 skupia się na parach żądanie–odpowiedź tworzonych przez harness, nie jednej uporządkowanej sekwencji tokenów. Raport wskazuje cztery problemy: ponowną tokenizację, dzielenie próby na próbki, normalizację straty i zmienne obciążenia backendu.
Harness często przechowuje tekst, ale RL potrzebuje dokładnych identyfikatorów tokenów próbkowanych w inferencji. Późniejsze odtworzenie może zmienić granice. Czytelny zapis tekstowy nie jest automatycznie wiernym materiałem treningowym.
Streszczenia, podagenci i powtarzane wywołania rozbijają próbę na nierówne próbki. Więcej fragmentów nie powinno czynić rolloutu ważniejszym. Średnia straty liczona tylko po próbkach może nadać większą wagę częstszym wywołaniom niż lepszej pracy.
Trzy wywołania wobec dwudziestu ilustrują problem. Więcej może oznaczać rozwlekłość, eksplorację lub ostrożne odzyskiwanie. Liczenie każdego jako osobnej trajektorii miesza te przyczyny. Przetwarzanie świadome rolloutu utrzymuje związek próbek przy obliczaniu przewag i strat.
Liczbę i długość poznaje się też dopiero po zakończeniu, podczas gdy topologia GPU i trening rozproszony wolą przewidywalne kształty. Raport przedstawia to jako kwestie badawcze, nie problemy zlikwidowane przez proxy.
Proxy zapewnia obserwowalną granicę modelu bez ujawniania każdej gałęzi. Sam ruch jednak nie wyjaśnia skutków narzędzi, ukrytych cache, niedeterministycznych usług czy zewnętrznych API. Zadanie, wywołania i nagrody muszą pozostać powiązane, a inny stan nadal wpływa na wynik.
Dwa wyniki kodowania o ograniczonym znaczeniu
Główny przykład to Qwen3.5-9B na SWE-bench Verified. Microsoft raportuje wzrost Pass@1 z 41,8% do 56,4% po RL z około 6000 przykładów: absolutnie 14,6 punktu procentowego, nie względne 14,6%.
Pass@1 pyta, czy pierwsza oceniona próba rozwiązuje zadanie. SWE-bench Verified używa ludzkiego filtrowania problemów z rzeczywistych repozytoriów. Wspólne porównanie wymaga zgodnych wersji i warunków oceny.
Później dodano Qwen3.5-35B-A3B: czyste RL na 1800 przykładów, wzrost z 47,8% do 61,6%. Oba pomiary pochodzą od projektu, nie z niezależnego audytu. Sprzęt, konfiguracja, filtrowanie zadań, nagrody i procedury wpływają na rezultat.
Potok kodowania zawiera przygotowanie danych, rollouty, skrypty i ochronę przed manipulacją nagrodą. To ułatwia kontrolę bardziej niż sama liczba, ale nie dowodzi odtworzenia poprawy przez niezależny zespół.
Wyniki wspierają wąski mechanizm: rzeczywisty harness tworzy dane bez przepisywania na pętlę trenera, a model poprawia się w raportowanych warunkach. Nie mierzą długiego utrzymania, osądu bezpieczeństwa ani współpracy z programistami.
Kodowanie daje wykonywalne informacje zwrotne. Testy często rozróżniają sprawną i niesprawną poprawkę. Sprzedaż, badania czy wiedza firmowa mogą nie mieć podobnie deterministycznych środowisk i wiarygodnych weryfikatorów, co ogranicza transfer.
Wsparcie może uczyć się zamykania zgłoszeń zamiast rozwiązań, badania zadowalania oceniającego mimo sprzecznych dowodów, automatyzacja wykorzystywania praw testowych. Agent może manipulować plikami, testami, stanem i usługami, nie tylko pisać myląco. Obrona uznaje ryzyko, nie usuwa potrzeby sprawdzania.
Lekka warstwa koordynuje ciężki system
Szybki start wymaga maszyny z GPU A100 i uruchamia Ray, verl, vLLM, serwer i kontroler. Inferencja, optymalizacja polityki, wykonanie rozproszone i harmonogram GPU pozostają poza małą liczbą linii kontroli.
Szybka integracja może więc oznaczać wciąż dużo pracy nad danymi, nagrodami, operacjami GPU, śledzeniem i analizą błędów. Laboratorium z klastrem może uznać framework za lekki; zespół bez infrastruktury RL może uznać proxy za najmniejszą część.
Natywne zadania Kubernetes niosą normalne kontenery, narzędzia i zależności do lokalnego, własnego lub chmurowego klastra. Kontroler uruchamia wiele prób, backend przetwarza wyniki. Nie wymaga to komercyjnego sandboxa, a prywatne repozytoria i narzędzia mogą zostać na własnej infrastrukturze.
Samodzielne zarządzanie przenosi odpowiedzialność. Trzeba chronić kontenery, poświadczenia, sieć, storage i prawa klastra. Eksploracyjne i nieudane próby wykonują polecenia i zmieniają repozytoria. Słaba izolacja może sięgnąć sekretów, usług wspólnych i obcych danych, z większą ekspozycją równoległą.
Proxy także jest wrażliwe. Prompty i odpowiedzi mogą zawierać kod, dokumenty i instrukcje wewnętrzne. Potrzebne są reguły retencji, dostępu i maskowania. MIT License obniża barierę eksperymentów, nie zapewnia zarządzanego bezpieczeństwa lub gwarancji operacyjnych.
Mały kod pomaga audytować planowanie i przepływ danych, ale zależności zmieniają się oddzielnie. Serwery modeli, backendy, komponenty rozproszone, kontenery i biblioteki sprzętu potrzebują zgodnych wersji.
Podobny podział dotyczy oceny. Testy wykonywalne są dobrym początkiem, otwarta praca potrzebuje wiarygodnych oceniających. Ludzie kosztują i zwalniają iterację, modele skalują z własnymi uprzedzeniami i podatnościami. Proxy nie robi z niemierzalnej pracy wiarygodnego celu RL.
Liczy się niezależne odtworzenie, nie wyższa pozycja
Pętle trenera pozostają użyteczne, gdy kontrola ułatwia optymalizację. Raport opisuje pokrewne podejścia verl, AReaL, slime i Polar, ale rollouty, inferencja, trening i algorytmy różnią się. Samo rozdzielenie wykonania nie czyni systemów zamiennymi.
Zachowanie kontekstu i odzyskiwania istniejącego agenta eliminuje kopię i pozwala badać faktyczne błędy. Zespół odróżnia model, narzędzie, nagrodę i politykę. Techniczna baza wiedzy może trzymać te decyzje z promptami, zmianami, nagrodami i notatkami; dokumentacja nie zastępuje eksperymentu kontrolowanego.
Niezależne integracje powinny ujawniać kod, konfigurację, debugowanie i poprawki specyficzne dla harnessu. Reprodukcje Qwen powinny podawać dane, compute, nagrody, ocenę, porażki, stabilność i wrażliwość między klastrami. Aktualizacje pakietów, stan repozytorium, narzędzia sieciowe i opóźnienia zmieniają trajektorie nawet przed próbkowaniem.
Szersze wyszukiwanie, retrieval i wykonywanie instrukcji sprawdzą szum nagród, fakty, preferencje i opóźnione rezultaty biznesowe. Kodowanie daje dziś najczytelniejszy dowód v1.0; aktywność GitHub pokazuje zainteresowanie, nie bezpieczną poprawę w produkcji.
Propozycja zachowuje harness, obserwuje model i relacje prób, a następnie trenuje bez drugiego agenta. Ogranicza duplikację, nie trudność. Wartość zależy od wiarygodnych nagród i niezależnych wyników rzeczywistych środowisk, przy widocznej odpowiedzialności za zasoby, otoczenie i bezpieczeństwo.
Źródła i materiały powiązane
Ogłoszenie Microsoft Research; wcześniejsza praca Agent Lightning; raport techniczny 1.0; materiał o technicznych bazach wiedzy; SWE-bench; szybki start; repozytorium Agent Lightning.