
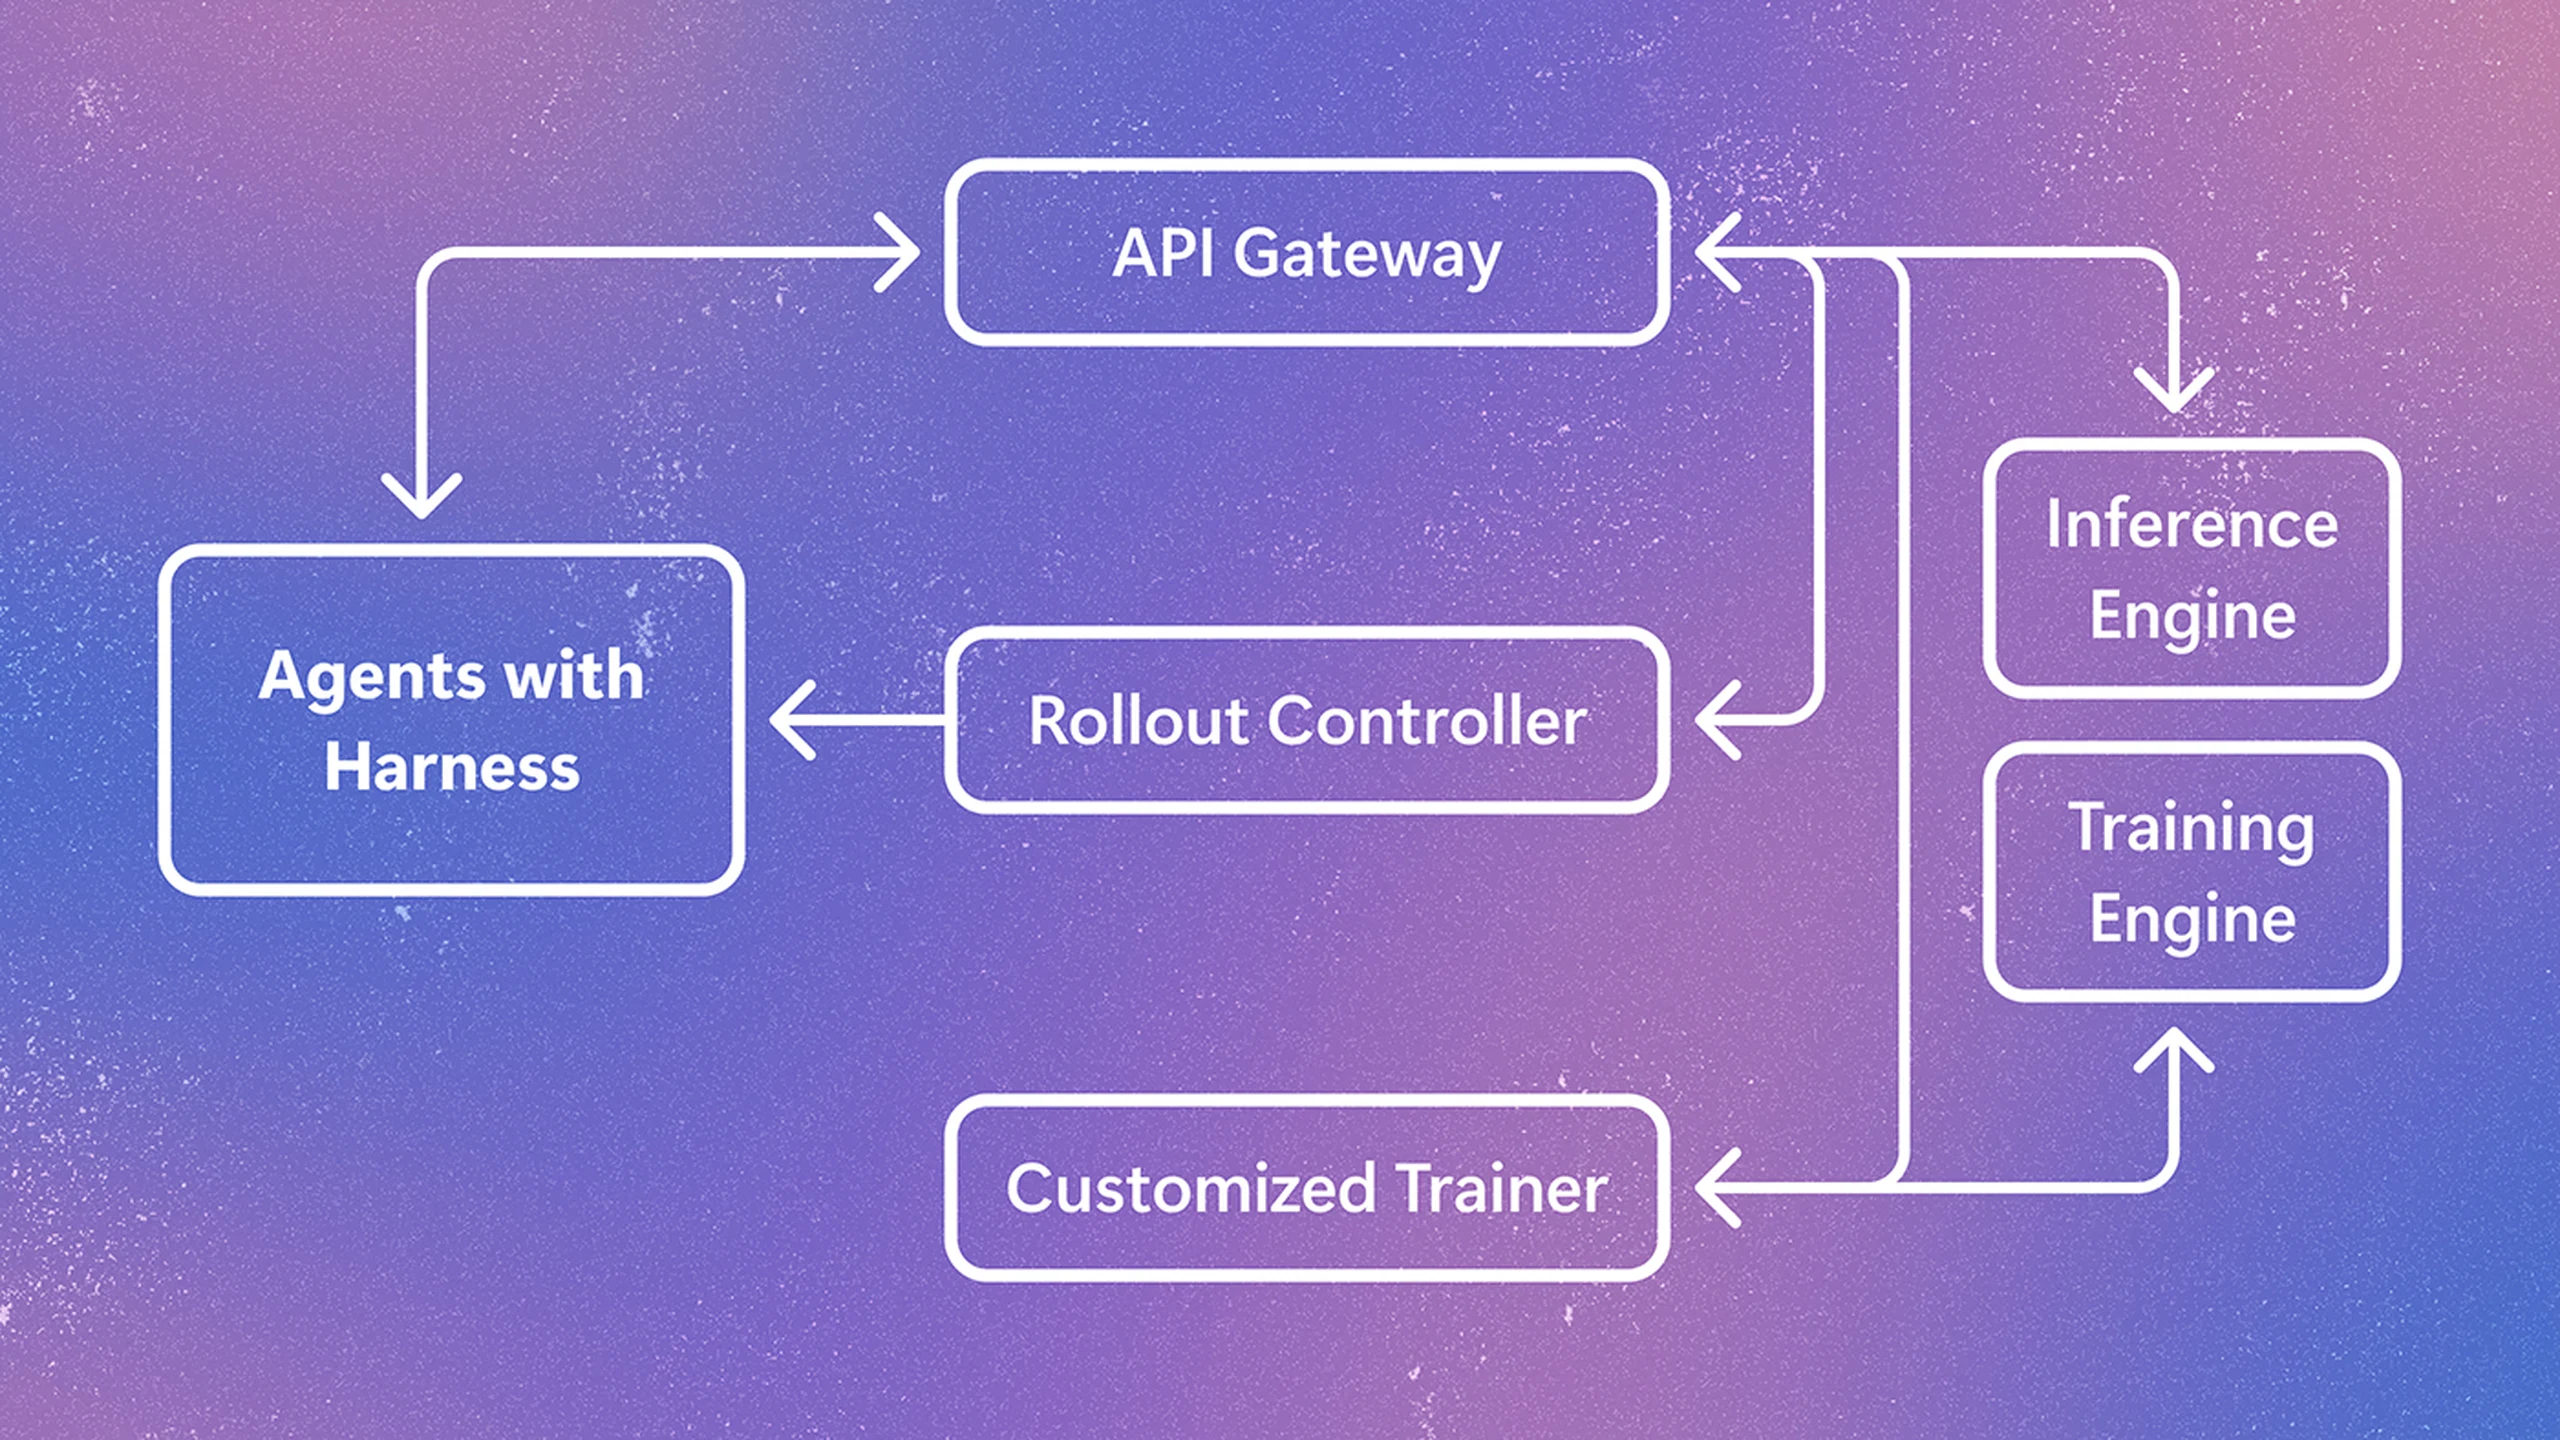
Um agente não é apenas um modelo escolhendo a próxima ação. O software ao redor resume histórico, delega a outro agente, tenta uma ferramenta novamente, muda prompts e determina o fim. Reproduzir isso no treinador arrisca otimizar um sistema diferente daquele usado pelas pessoas.
A Microsoft Research coloca essa incompatibilidade no centro do Agent Lightning v1.0. O framework open source refeito passa o tráfego do modelo por um proxy, mantendo a execução no harness existente. A Microsoft descreve cerca de 3.500 linhas de controle e grandes melhorias no SWE-bench. Uma camada pequena de integração não significa treinamento inteiro pequeno nem recompensas automaticamente confiáveis.
O ciclo produtivo permanece no experimento
Harness é o software ao redor do modelo: composição de contexto, ferramentas, memória, recuperação, subagentes e regras de parada. Na programação inclui navegar repositórios, editar arquivos, executar shell e testes. Suas escolhas afetam substancialmente o desempenho.
RL agêntico tradicional costuma colocar o ciclo ação-observação no treinador. Isso dá acesso direto a tokens, estados e transições e facilita lotes, depuração e otimização quando o treinador controla o rollout inteiro. O problema surge se o harness produtivo for mais complexo que a abstração.
A cópia de treinamento pode tokenizar diferente, omitir recuperação e simplificar ferramentas. Manter duas implementações acrescenta testes e coordenação de versões. A Microsoft cita mini-SWE-agent, OpenHands, OpenCode, Claude Code e Codex como exemplos de comportamento além de um ciclo ReAct básico.
O Agent Lightning redireciona o endpoint do modelo a um proxy compatível com OpenAI. O harness continua planejando, administrando contexto e executando ferramentas; o proxy registra solicitações e respostas com tarefa e recompensa. A Microsoft afirma que o código pode continuar igual. É a promessa de integração, não prova de configuração ou depuração zero em todo runtime.
A divisão fica explícita: equipe do agente controla execução, framework RL coleta dados e atualiza modelos, proxy é o contrato. Uma política treinada com sucesso volta ao mesmo sistema circundante, não a uma réplica só de treinamento.
Isso reduz uma fonte de desvio treinamento-serving, a diferença entre condições de otimização e produção. Não torna repositórios de benchmark ambientes reais de clientes, não alinha todas as permissões nem garante respostas idênticas das ferramentas. Usuários reais raramente fornecem recompensas tão claras quanto tarefas controladas.
Um rollout não é uma sequência organizada
Rollout é uma tentativa completa, potencialmente com várias chamadas, inspeção, edição, testes e revisões. A recompensa final pode chegar apenas ao término. O trabalho anterior usava arquitetura desagregada e atribuição de crédito para converter trajetórias complexas em transições de treino e relacionar decisões às recompensas posteriores.
A versão 1.0 olha para pares de solicitação-resposta produzidos pelo harness, não uma sequência única de tokens. O relatório identifica quatro questões: retokenização, divisão de uma tentativa em amostras, normalização da perda e cargas variáveis no backend.
O harness costuma guardar texto, mas RL precisa dos identificadores exatos amostrados na inferência. Reconstrução posterior pode mudar os limites. Uma trilha legível não é automaticamente um registro de treinamento fiel.
Resumo de contexto, subagentes e chamadas repetidas dividem uma tentativa em partes desiguais. Mais fragmentos não devem tornar um rollout mais importante. Calcular a perda só por quantidade de amostras pode dar peso maior a um harness que chama mais, não que trabalha melhor.
Três chamadas contra vinte ilustram isso. Mais chamadas podem significar verbosidade, exploração ou recuperação cuidadosa. Contar cada uma como trajetória independente mistura essas causas. O processamento orientado a rollout mantém amostras da tentativa ligadas no cálculo de vantagens e perdas.
Quantidade e comprimento também só são conhecidos depois do harness, enquanto topologia GPU e treinamento distribuído preferem formatos previsíveis. O relatório apresenta problemas de pesquisa, não dificuldades que o proxy fez desaparecer.
O proxy oferece uma fronteira observável sem expor cada ramificação. Mas tráfego sozinho não explica efeitos de ferramentas, caches ocultos, serviços não determinísticos e APIs externas. Tarefa, chamadas e recompensas precisam continuar conectadas, enquanto outros estados influenciam o resultado.
Dois ganhos de programação com significado limitado
O principal exemplo usa Qwen3.5-9B no SWE-bench Verified. A Microsoft reporta Pass@1 de 41,8% para 56,4% com RL e cerca de 6.000 exemplos: ganho absoluto de 14,6 pontos percentuais, não aumento relativo de 14,6%.
Pass@1 verifica se a primeira tentativa avaliada resolve. SWE-bench Verified usa problemas reais de repositórios filtrados por humanos. A comparação comum exige versões e condições equivalentes.
O repositório depois acrescentou Qwen3.5-35B-A3B: RL puro com 1.800 exemplos de 47,8% para 61,6%. Ambos são medições do projeto, não auditorias independentes. Hardware, configuração, filtragem, recompensas e avaliação influenciam o resultado.
O pipeline inclui preparação, rollouts, scripts e defesas contra exploração da recompensa. Isso torna a alegação mais inspecionável que um número isolado, mas não demonstra que equipes independentes reproduzam os ganhos.
O mecanismo apoiado é restrito: um harness de programação real fornece dados sem ser reescrito como ciclo do treinador, seguido de melhoria nas condições relatadas. Não mede manutenção prolongada, julgamento de segurança ou colaboração humana.
Programação ainda oferece feedback executável. Testes frequentemente distinguem patches bons e ruins. Vendas, pesquisa e conhecimento corporativo podem não ter ambientes tão determinísticos ou verificadores confiáveis, limitando a transferência da receita.
Suporte pode aprender a fechar tickets, não resolver; pesquisa pode agradar um avaliador ignorando contradições; automação pode explorar permissões só de teste. Ferramentas permitem manipular arquivos, testes, estados ou serviços para receber pontuação, não apenas escrever enganos. As defesas reconhecem o risco, não dispensam examiná-lo.
A camada leve coordena um sistema pesado
O início rápido exige uma máquina com A100 e inicia Ray, verl, vLLM, servidor e controlador. Inferência, otimização da política, execução distribuída e agendamento GPU permanecem fora da contagem compacta do controle.
Integrar rápido pode deixar muito trabalho em dados, recompensas, GPUs, acompanhamento de experimentos e análise de falhas. Laboratórios com clusters podem chamá-lo leve; equipes sem infraestrutura RL podem considerar o proxy a menor parte.
Jobs Kubernetes nativos levam contêiner, ferramentas e dependências normais a clusters locais, próprios ou de nuvem. O controlador inicia tentativas e o backend processa resultados. Não exige sandbox comercial e permite manter repositórios privados e ferramentas internas na infraestrutura já administrada.
Autogestão transfere responsabilidade. Contêineres, credenciais, rede, armazenamento e privilégios precisam ser seguros. Tentativas exploratórias e falhas executam shell e alteram repositórios. Isolamento fraco alcança segredos, serviços compartilhados e dados alheios, com exposição maior em paralelo.
O proxy também é sensível. Prompts e respostas podem conter código, documentos e instruções internas. Retenção, acesso e ocultação precisam corresponder a esse material. A licença MIT reduz barreiras experimentais, não oferece segurança gerenciada ou garantia operacional.
Código pequeno facilita auditoria do agendamento e fluxo, mas dependências evoluem separadamente. Servidores de modelos, backends, componentes distribuídos, imagens e bibliotecas de hardware precisam de versões compatíveis.
Avaliação tem divisão semelhante. Testes executáveis são bom começo. Trabalho aberto exige avaliadores críveis; pessoas aumentam custo e lentidão, modelos escalam com seus vieses e vulnerabilidades. Instrumentação não transforma tarefa imensurável em objetivo RL confiável.
Reprodução independente importa mais que classificação
Ciclos controlados pelo treinador continuam úteis onde o controle simplifica otimização. O relatório descreve abordagens relacionadas a verl, AReaL, slime e Polar, mas rollout, inferência, distribuição e algoritmos diferem. Separar execução não os torna intercambiáveis.
Preservar contexto e recuperação do agente evita cópia e deixa falhas reais examináveis. A equipe distingue modelo, interface, recompensa e política. Uma base técnica pesquisável pode guardar decisões com prompts, alterações, recompensas e notas; documentação não substitui experimento controlado.
Integrações independentes devem divulgar código, configuração, depuração e patches específicos. Reproduções Qwen devem informar dados, computação, recompensa, avaliação, falhas, estabilidade e sensibilidade entre clusters. Atualizações de pacotes, estado do repositório, ferramentas de rede e latência mudam trajetórias antes da amostragem.
Busca, recuperação e seguimento de instruções testarão feedback ruidoso, julgamento factual, preferências e resultados comerciais tardios. Programação hoje fornece a evidência mais clara da v1.0; atividade GitHub indica interesse, não melhoria segura em produção.
A proposta é focada: preservar o harness, observar chamadas e relações de rollout, treinar sem criar outro agente. Reduz duplicação, não dificuldade. O valor maior depende de recompensas confiáveis e resultados independentes em runtimes reais, com responsabilidades de computação, ambiente e segurança ainda visíveis.
Fontes e leitura relacionada
Anúncio Microsoft Research; artigo anterior Agent Lightning; relatório técnico 1.0; leitura sobre bases técnicas pesquisáveis; SWE-bench; início rápido; repositório Agent Lightning.