
エージェントは次の行動を選ぶよう求められたモデルだけではない。周辺ソフトウェアは履歴を要約し、別のエージェントへ委任し、ツールを再試行し、指示を変え、終了を判断する。その挙動を訓練エンジン内に再現すると、ユーザーが使うものと別のシステムを最適化しかねない。
Microsoft ResearchのAgent Lightning v1.0は、この不一致を設計の中心に置く。再設計されたオープンソース基盤はモデル通信をプロキシへ通し、実行は元のハーネスに任せる。Microsoftは制御層を約3,500行と説明し、大きなSWE-bench改善を報告する。統合層が小さくても、全訓練基盤が小さい、あるいは報酬が自動的に信頼できるとは意味しない。
配備済みループを実験に残す
ハーネスはモデル周辺のソフトウェアで、コンテキスト組み立て、ツール、記憶、復旧、サブエージェント、停止規則を担う。コーディングではリポジトリ探索、編集、シェル、テストも含み、その選択が性能を左右する。
従来のエージェントRLは行動・観測ループをトレーナー内に置くことが多い。トークン、状態、環境遷移へ直接触れられ、ロールアウト全体を所有する場合、バッチ化、デバッグ、最適化を簡単にする。問題は本番ハーネスが抽象化より複雑になった場合だ。
訓練用複製ではトークン化が異なり、復旧を省き、ツールを簡略化しうる。並行保守は試験と公開調整も増やす。Microsoftはmini-SWE-agent、OpenHands、OpenCode、Claude Code、Codexを、単純なReActループ以上の動作を持つ例として挙げる。
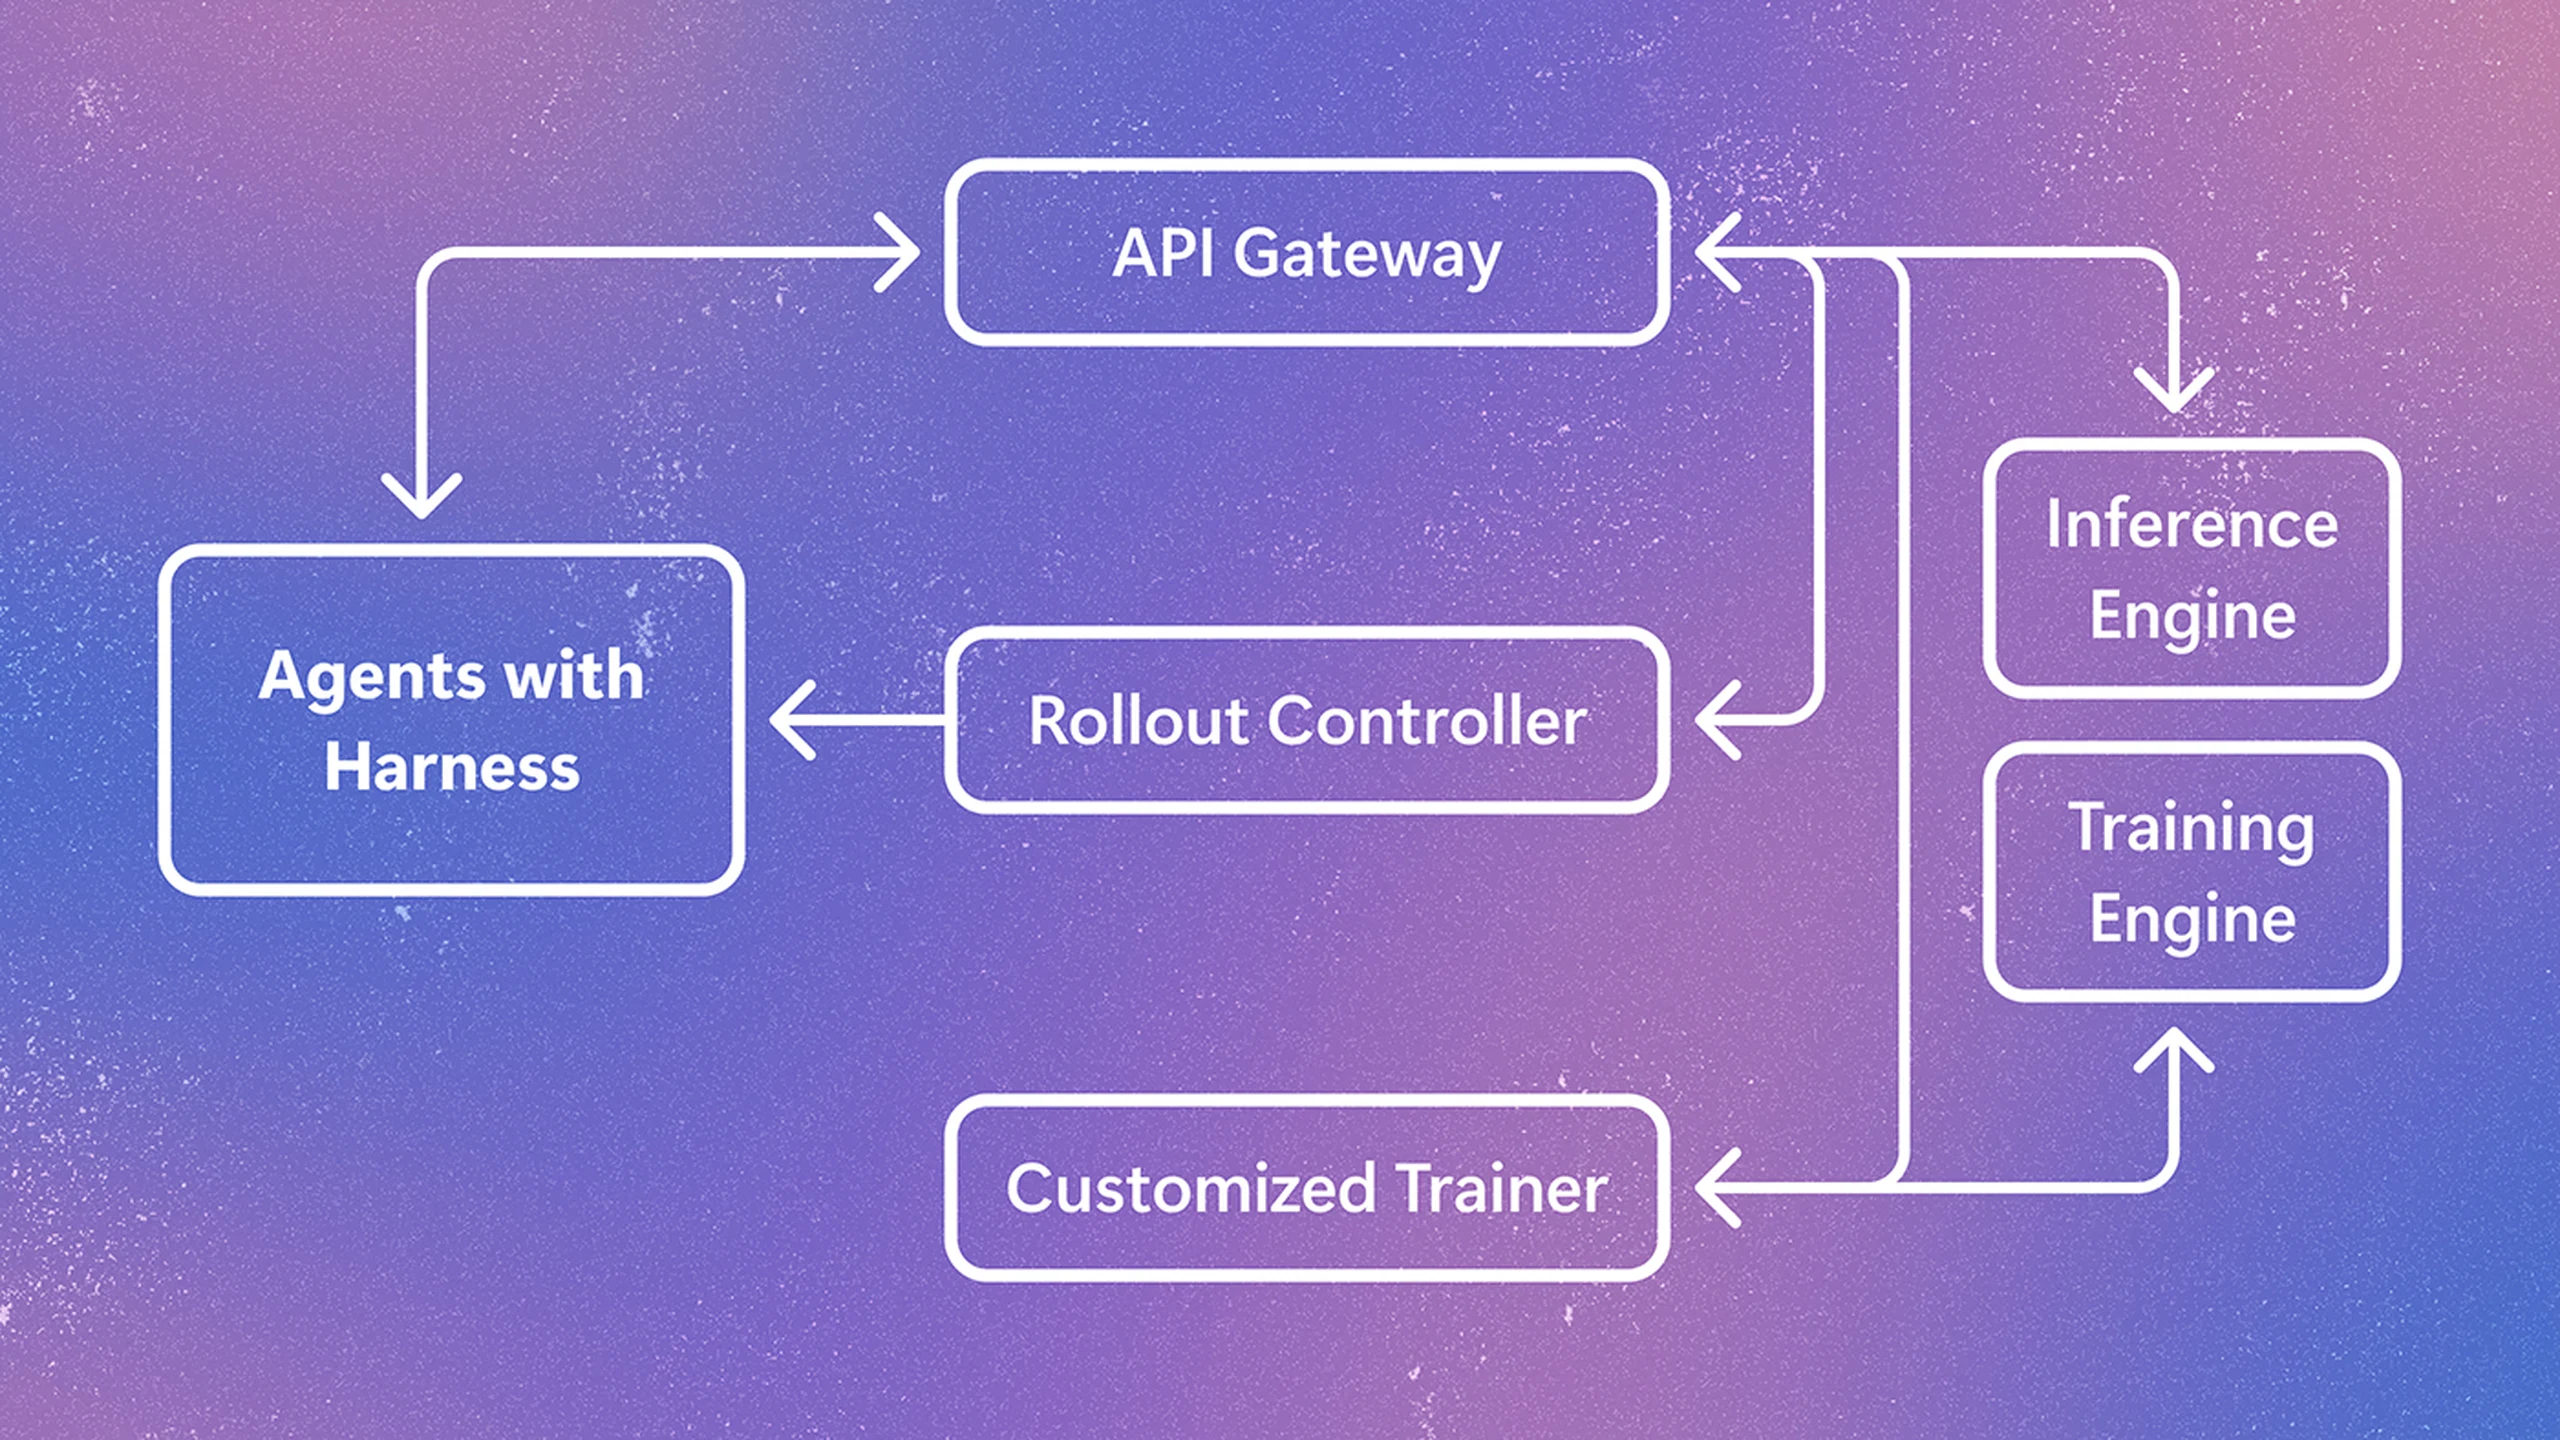
Agent Lightningではモデルの接続先をOpenAI互換プロキシへ変える。元のハーネスが計画、文脈管理、ツール実行を続け、プロキシが要求・応答を記録してタスクと報酬に結ぶ。Microsoftは既存ハーネスのコードを維持できるとするが、どの実行系も設定やデバッグがゼロという証明ではない。
責任は、エージェントチームが実行、RL基盤が収集とモデル更新、プロキシが両者の契約となる。成功した学習方策は訓練専用の複製でなく、同じ周辺システムへ戻る。
これは最適化と配備の条件差である訓練・推論の乖離を一つ減らす。しかし基準リポジトリを顧客環境に変えず、全サンドボックス権限やツール応答を同一にしない。実利用者も制御課題ほど明確な報酬をほとんど与えない。
一回の試行は整った一本の列ではない
ロールアウトはタスクの完全な一試行で、多数のモデル呼び出しとファイル確認、編集、試験、修正を含みうる。最終報酬は終了後にしか来ない場合もある。初期研究は分離構造と貢献度の割り当てで複雑な軌跡を訓練遷移にし、後の報酬に寄与した判断を扱った。
1.0は整ったトークン列を前提にせず、ハーネス由来の要求・応答対を観測する。技術報告は再トークン化、一試行のサンプル分割、損失正規化、変動するバックエンド負荷という四問題を挙げる。
ハーネスは通常テキストを保存するが、RLには推論時に実際にサンプルされた正確なトークンIDが要る。後で再構成すると境界が変わりうる。読みやすい記録が忠実な訓練データとは限らない。
要約、サブエージェント、反復呼び出しは一試行を不均等なサンプルへ分ける。断片の多い試行を自動的に重くすべきではない。サンプル数だけで損失を平均すると、良い仕事でなく呼び出しの多いハーネスを過大評価する。
3回と20回で解くエージェントを考えるとよい。多い理由は冗長さ、探索、慎重な復旧のいずれでもありうる。各呼び出しを独立軌跡と数えると混同する。ロールアウトを考慮した処理では、アドバンテージと損失の計算時も同一試行のサンプルを関連付ける。
数と長さもハーネス終了まで分からないが、GPU構成と分散訓練は予測できる形状を好む。報告はこれを研究課題とし、プロキシで消滅したとはしない。
全分岐の公開なしにモデル境界を観測できても、通信だけでツール副作用、隠れたキャッシュ、非決定サービス、外部APIは説明できない。タスクID、呼び出し、報酬を結び、他状態の影響も残る。
二つの改善が示す範囲
主要例はSWE-bench VerifiedのQwen3.5-9Bだ。約6,000訓練例のRLでPass@1が41.8%から56.4%へ上がったと報告する。絶対14.6ポイント増であり、相対14.6%増ではない。
Pass@1は最初に評価する試行で解決できたかを測る。SWE-bench Verifiedは実在リポジトリの課題を人が選別したものだ。共通比較になるのはバージョンと評価条件が揃う場合である。
後にQwen3.5-35B-A3Bの例が追加され、1,800例の純RLで47.8%から61.6%と報告された。どちらもプロジェクト測定で独立監査ではない。ハードウェア、構成、課題選別、報酬、評価方法が影響する。
パイプラインにはデータ準備、試行実行、訓練スクリプト、報酬ハッキング対策が含まれる。単独スコアより調べやすいが、独立チームの同等再現を保証しない。
結果が支えるのは、実際のコーディングハーネスを訓練器ループへ再実装せずデータ生成でき、報告条件でモデルが改善したという狭い機構だ。長期保守、安全判断、人との協働は測らない。
コードには実行可能なフィードバックもある。試験は動く修正と失敗を区別しやすい。営業、調査、企業知識業務には同じ決定的環境や検証器がない可能性があり、そのまま転用できない。
サポートが解決でなくチケット終了を学び、調査が矛盾を無視して採点器を喜ばせ、自動化が試験専用権限を悪用しうる。ツールでファイル、試験、状態、サービスを変える報酬ハッキングは、誤解させる文章だけに限らない。対策の存在はリスクを認めるもので、調査を不要にしない。
軽い制御層が重い全体を調整する
クイックスタートはA100 GPU搭載機を求め、Ray、verl、vLLM、サーバー、コントローラーを起動する。推論、方策最適化、分散実行、GPU配置は小さい制御層の行数に含まれない。
素早く接続できてもデータ、報酬、GPU運用、実験記録、失敗分析には多くの作業が残る。既存クラスタの研究者には軽量でも、RL基盤のないアプリチームにはプロキシが最小部分となりうる。
Kubernetesジョブは通常のコンテナ、ツール、依存関係をローカル、自主管理、クラウドで使える。制御器が複数試行を起動し、バックエンドが結果を処理する。商用サンドボックスを必須にせず、私有リポジトリと内部ツールを管理済み基盤に置ける。
自己管理は責任移転だ。コンテナ、資格情報、ネットワーク、保存、クラスタ権限を守る必要がある。探索や失敗試行もシェルを動かしリポジトリを変える。弱い隔離は秘密情報、共有サービス、無関係データへ及び、並列化で露出が増す。
プロキシも機密性が高い。要求・応答にソース、取得文書、内部指示が入り、保持、アクセス、マスキング方針が要る。MIT Licenseは実験の障壁を下げるだけで、運用や管理された安全を保証しない。
小さいコードは配置やデータ流の監査を助けるが、モデルサーバー、訓練バックエンド、分散要素、コンテナ、ハードウェアライブラリは別々に進化し、版整合が必要だ。
採点も同様だ。実行試験があれば良い出発点だが、自由な業務には信頼できる採点器が要る。人の審査は高く遅く、モデル採点は拡大できても偏りや脆弱性を持つ。通信計測は測れない課題を信頼できるRL目標に変えない。
順位より独立再現が試金石
直接制御が最適化を助ける場面では、トレーナー主導ループも有効だ。報告はverl、AReaL、slime、Polar関連の分離方式を述べるが、試行生成、推論、分散訓練、アルゴリズムは異なる。分離しただけで互換にはならない。
既存エージェントの文脈管理と復旧を残せば、複製を避け実際の失敗を調べられる。モデル、ツール、報酬、方針のどこかを切り分け、技術知識ベースへ指示、変更、報酬、実験メモと判断を記録できる。ただし記録は制御実験の代わりではない。
独立統合は変更コード、設定、デバッグ、専用パッチを示すべきだ。Qwen再現はデータ、計算、報酬、評価、失敗、安定性、クラスタ間の感度を報告したい。管理外のパッケージ更新、リポジトリ状態、通信ツール、遅延はサンプリング以前から軌跡を変える。
検索、情報取得、指示追従の広い研究は、雑音のある報酬、事実判断、好み、遅延した業務成果を試す。今はコーディングが1.0の最も明確な証拠で、GitHub活動は関心であって本番での安全改善ではない。
提案は、ハーネスを維持しモデル呼び出しと試行関係を観測して、二つ目のエージェントなしで学ぶことだ。重複は減らすが難しさは減らさない。広い価値は実運用系での信頼できる報酬と独立成果次第で、計算、環境、安全の責任は残る。
出典と関連資料
Microsoft Research発表;初期論文;1.0技術報告;検索可能な技術知識ベースの関連解説;SWE-bench;クイックスタート;Agent Lightningリポジトリ。