
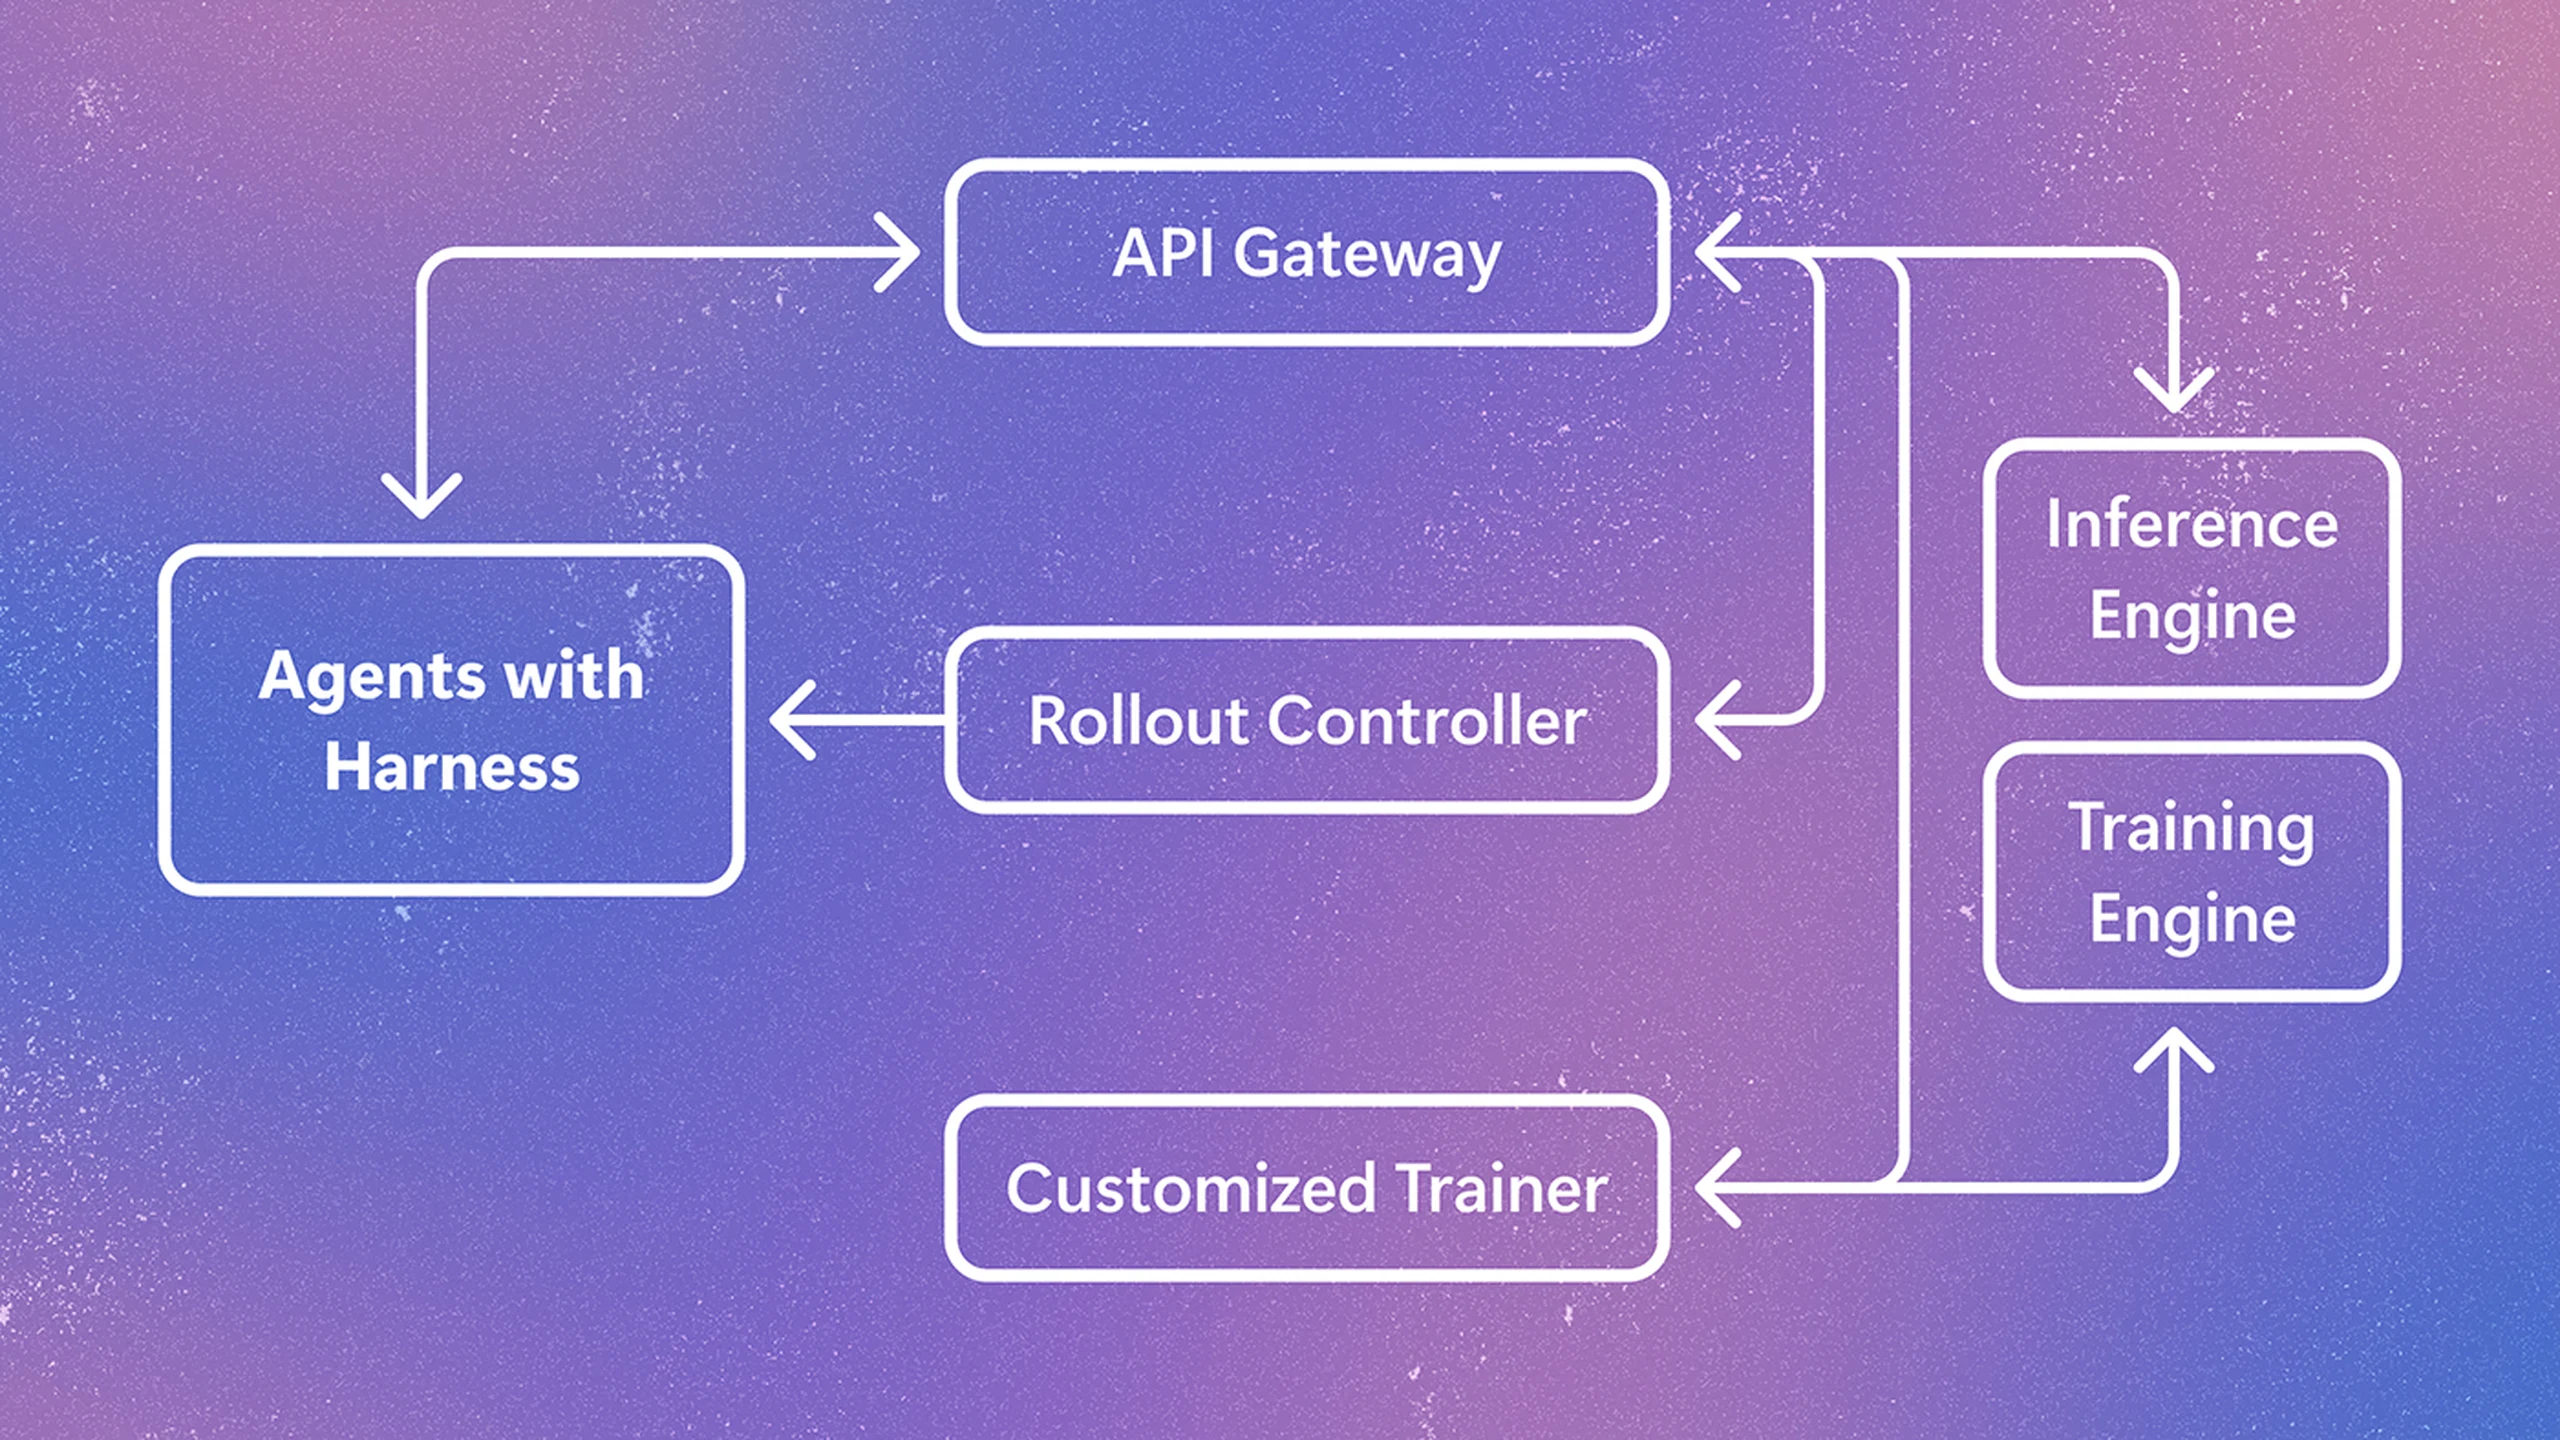
Un agent n’est pas simplement un modèle choisissant l’action suivante. Son logiciel environnant résume l’historique, délègue, réessaie un outil, modifie les prompts et décide d’arrêter. Recréer ces comportements dans l’entraîneur risque d’optimiser un système différent de celui réellement utilisé.
Microsoft Research place ce décalage au centre d’Agent Lightning v1.0. Le framework open source remanié fait passer le trafic du modèle par un proxy, tout en laissant l’exécution au harness existant. Microsoft décrit environ 3 500 lignes de contrôle et des gains SWE-bench importants. Une petite intégration ne signifie ni petite pile complète ni récompenses automatiquement fiables.
La boucle de production reste dans l’expérience
Le harness entoure le modèle : assemblage du contexte, outils, mémoire, récupération, sous-agents et règles d’arrêt. En programmation, il inclut navigation du dépôt, modifications, shell et tests. Ses choix influencent concrètement la performance.
Le RL agentique conventionnel place souvent la boucle action-observation dans l’entraîneur. L’accès direct aux tokens, états et transitions simplifie lots, débogage et optimisation lorsque celui-ci contrôle le rollout complet. La difficulté apparaît avec un harness de production plus complexe que cette abstraction.
Une copie d’entraînement peut tokeniser autrement, omettre la récupération ou simplifier les outils. La maintenance parallèle ajoute tests et coordination des versions. Microsoft cite mini-SWE-agent, OpenHands, OpenCode, Claude Code et Codex comme comportements dépassant une boucle ReAct simple.
Agent Lightning redirige plutôt le point de terminaison vers un proxy compatible OpenAI. Le harness garde planification, contexte et outils ; le proxy enregistre requêtes et réponses avec tâche et récompense. Selon Microsoft, le code existant peut rester inchangé. C’est l’affirmation d’intégration, non la preuve de configuration et débogage nuls pour tout runtime.
Le partage devient explicite : l’équipe d’agent possède l’exécution, le framework RL collecte et actualise le modèle, le proxy sert de contrat. Une politique entraînée avec succès revient au même environnement, pas à une réplique d’apprentissage.
Cela réduit une source de décalage entraînement-service, les conditions différentes entre optimisation et production. Cela ne transforme pas les dépôts de benchmark en environnements clients, n’aligne pas toutes les permissions et ne garantit pas des données d’outils identiques. Les vrais utilisateurs donnent rarement des récompenses aussi nettes qu’une tâche contrôlée.
Un rollout n’est pas une séquence bien rangée
Un rollout est une tentative complète, avec plusieurs appels possibles, inspections, modifications, tests et corrections. La récompense finale peut n’arriver qu’au terme. Les travaux initiaux utilisaient architecture désagrégée et attribution du crédit pour convertir des trajectoires complexes en transitions et relier décisions aux récompenses futures.
La version 1.0 observe les paires requête-réponse produites par le harness, pas une séquence unique propre. Le rapport identifie quatre problèmes : retokenisation, découpage en échantillons, normalisation de la perte et charges variables du backend.
Le harness stocke souvent du texte, alors que RL exige les identifiants exacts échantillonnés à l’inférence. Reconstruire ensuite peut déplacer les frontières. Une trace lisible n’est pas automatiquement un relevé fidèle pour l’entraînement.
Résumés, sous-agents et répétitions divisent une tentative en échantillons inégaux. Plus de fragments ne devrait pas la rendre plus importante. Une moyenne par seuls échantillons peut surpondérer les nombreux appels plutôt que le bon travail.
Trois appels contre vingt illustrent le problème. Davantage peut signifier verbosité, exploration ou récupération prudente. Compter chaque appel comme trajectoire indépendante mélange les causes. Le traitement conscient des rollouts garde les échantillons liés pour calculer avantages et pertes.
Nombre et longueur ne se connaissent qu’une fois terminé, alors que topologie GPU et apprentissage distribué préfèrent des formes prévisibles. Le rapport en fait des questions à étudier, pas des difficultés éliminées par le proxy.
Le proxy fournit une frontière observable sans exposer chaque branche. Le trafic seul n’explique toutefois pas effets des outils, caches cachés, services non déterministes et API externes. Tâche, appels et récompenses doivent rester liés, tandis que d’autres états influencent le résultat.
Deux gains de programmation au sens limité
L’exemple principal est Qwen3.5-9B sur SWE-bench Verified. Microsoft rapporte Pass@1 de 41,8 % à 56,4 % après RL avec environ 6 000 exemples : 14,6 points de pourcentage absolus, non 14,6 % relatifs.
Pass@1 demande si la première tentative évaluée résout la tâche. SWE-bench Verified utilise des problèmes réels filtrés par des humains. Un repère commun exige versions et conditions de test alignées.
Le dépôt ajoute ensuite Qwen3.5-35B-A3B : RL pur avec 1 800 exemples, de 47,8 % à 61,6 %. Les deux mesures viennent du projet, non d’audits indépendants. Matériel, configuration, filtrage, récompenses et procédures influencent le résultat.
Le pipeline comprend préparation, rollouts, scripts et protections contre l’exploitation de récompenses. Ces éléments rendent la thèse plus vérifiable qu’un score isolé, sans prouver la reproduction des gains par des équipes indépendantes.
Les résultats soutiennent un mécanisme précis : un vrai harness fournit des données sans devenir une boucle de l’entraîneur, puis le modèle progresse dans les conditions rapportées. Ils ne mesurent pas maintenance durable, jugement de sécurité ou collaboration avec des développeurs.
La programmation fournit aussi un retour exécutable. Les tests distinguent souvent correctifs fonctionnels et ratés. Vente, recherche et connaissance d’entreprise peuvent manquer d’environnements déterministes et de vérificateurs comparables, ce qui limite le transfert.
L’assistance pourrait apprendre à clore les tickets sans résoudre, la recherche satisfaire un correcteur en ignorant les contradictions, l’automatisation exploiter des droits de test. Les outils permettent de manipuler fichiers, tests, états ou services pour le score, pas seulement d’écrire un mensonge. Les protections reconnaissent le risque sans dispenser de l’examiner.
La couche légère coordonne un système lourd
Le démarrage rapide exige une machine A100 et lance Ray, verl, vLLM, serveur et contrôleur. Inférence, optimisation de politique, exécution distribuée et planification GPU restent hors du faible nombre de lignes de contrôle.
Une intégration rapide peut donc laisser beaucoup de travail en données, récompenses, GPU, suivi d’expériences et analyse des échecs. Un laboratoire avec cluster peut la trouver légère ; une équipe sans infrastructure RL voir le proxy comme la plus petite partie.
Les tâches Kubernetes natives transportent conteneur, outils et dépendances habituels sur clusters locaux, autogérés ou cloud. Le contrôleur lance des tentatives, le backend traite les résultats. Cela n’impose pas de sandbox commerciale et peut maintenir dépôts privés et outils internes sur l’infrastructure déjà gérée.
L’autogestion transfère la responsabilité. Conteneurs, identifiants, réseau, stockage et droits du cluster demandent protection. Exploration et échecs exécutent des commandes et modifient les dépôts. Une isolation faible atteint secrets, services partagés ou données étrangères, avec une exposition accrue en parallèle.
Le proxy est sensible aussi. Prompts et réponses peuvent contenir code, documents et instructions internes. Conservation, accès et masquage doivent convenir. La licence MIT facilite l’expérience, sans offrir sécurité gérée ni garantie d’exploitation.
Un petit code facilite l’audit de l’ordonnancement et des flux, mais les dépendances évoluent séparément. Serveurs de modèles, backends, composants distribués, images et bibliothèques matérielles exigent des versions compatibles.
L’évaluation connaît la même division. Des tests exécutables sont un bon départ ; un travail ouvert nécessite des correcteurs crédibles. Les humains coûtent et ralentissent, les modèles passent à l’échelle avec biais et failles. Le proxy ne rend pas une tâche non mesurable fiable pour RL.
La reproduction indépendante compte plus que le classement
Les boucles d’entraîneur restent utiles quand le contrôle simplifie l’optimisation. Le rapport décrit des approches liées à verl, AReaL, slime et Polar, mais rollout, inférence, distribution et algorithmes diffèrent. Séparer l’exécution ne les rend pas interchangeables.
Préserver contexte et récupération de l’agent évite une copie et rend les vrais échecs inspectables. L’équipe distingue modèle, interface, récompense et politique. Une base technique consultable peut conserver décisions, prompts, modifications, récompenses et notes ; documenter ne remplace pas une expérience contrôlée.
Les intégrations indépendantes devraient montrer code, configuration, débogage et correctifs spécifiques. Les reproductions Qwen devraient rapporter données, calcul, récompenses, évaluation, échecs, stabilité et sensibilité entre clusters. Mises à jour, état des dépôts, outils réseau et latence changent les trajectoires avant même l’échantillonnage.
Recherche, récupération et suivi d’instructions plus larges testeront retours bruités, jugement factuel, préférences et résultats commerciaux différés. Le codage est aujourd’hui la preuve la plus claire de la 1.0 ; l’activité GitHub montre l’intérêt, pas une amélioration sûre en production.
La proposition conserve le harness, observe appels et relations des tentatives et entraîne sans construire un deuxième agent. Elle réduit la duplication, pas la difficulté. La valeur plus large dépend de récompenses fiables et de résultats indépendants sur de vrais runtimes, avec responsabilités de calcul, d’environnement et de sécurité toujours visibles.
Sources et lectures connexes
Annonce Microsoft Research; travaux Agent Lightning initiaux; rapport technique 1.0; lecture sur les bases techniques consultables; SWE-bench; démarrage rapide; dépôt Agent Lightning.