
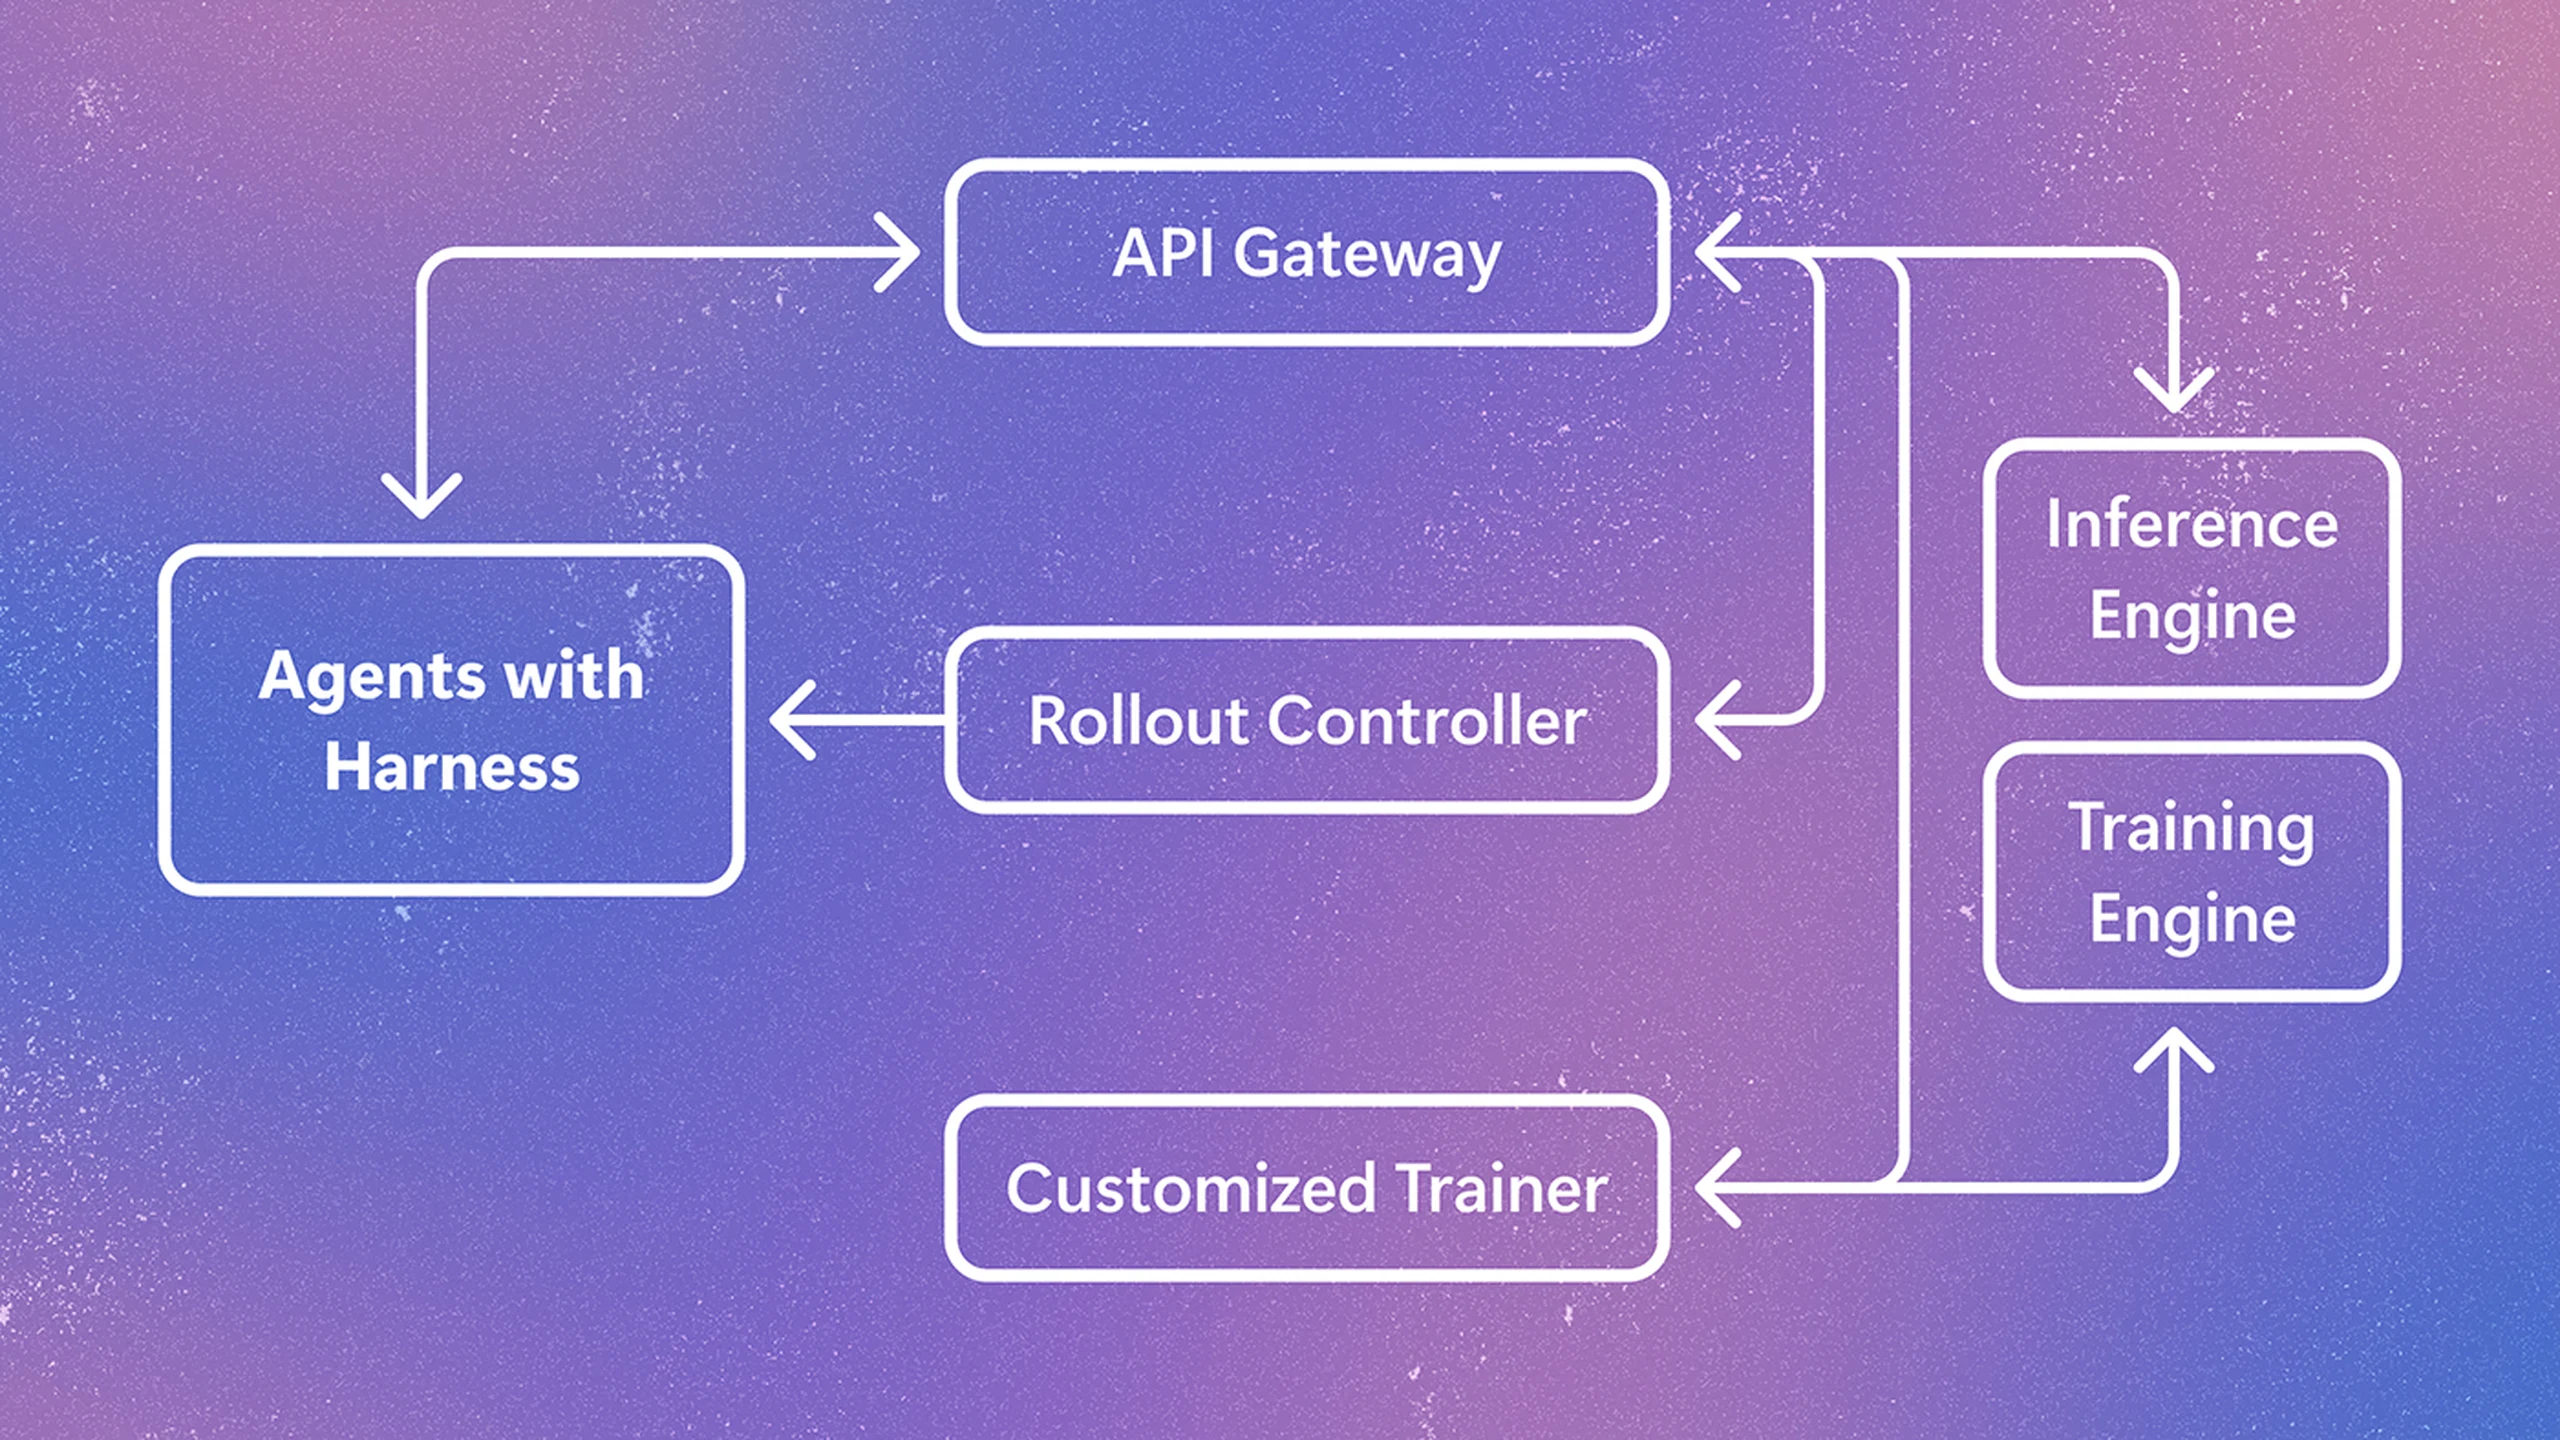
Un agente no es solo un modelo que elige la siguiente acción. El software que lo rodea resume historial, delega, reintenta herramientas, cambia prompts y decide terminar. Recrearlo dentro del entrenador arriesga optimizar un sistema distinto del que realmente se utiliza.
Microsoft Research centra Agent Lightning v1.0 en esa discrepancia. El framework abierto rediseñado pasa el tráfico del modelo por un proxy, dejando la ejecución al arnés existente. Microsoft describe unas 3.500 líneas de control y grandes mejoras SWE-bench. Una integración pequeña no significa una infraestructura completa pequeña ni recompensas automáticamente fiables.
El bucle productivo permanece en el experimento
El arnés rodea al modelo con contexto, herramientas, memoria, recuperación, subagentes y reglas de parada. En programación incluye navegar repositorios, editar, ejecutar shell y pruebas. Sus decisiones afectan sustancialmente al rendimiento.
El RL agéntico convencional suele poner el bucle acción-observación dentro del entrenador. Permite acceso directo a tokens, estados y transiciones, simplificando lotes, depuración y optimización cuando controla todo el rollout. El problema llega con arneses productivos más complejos que esa abstracción.
Una copia de entrenamiento puede tokenizar distinto, omitir recuperación o simplificar herramientas. Mantener ambas añade pruebas y coordinación de versiones. Microsoft cita mini-SWE-agent, OpenHands, OpenCode, Claude Code y Codex como comportamientos superiores a un bucle ReAct básico.
Agent Lightning redirige el endpoint a un proxy compatible OpenAI. El arnés mantiene planificación, contexto y herramientas; el proxy registra solicitudes y respuestas con tarea y recompensa. Microsoft dice que el código existente puede quedar igual. Es la afirmación de integración, no prueba de configuración o depuración nulas para todo entorno.
El reparto es explícito: el equipo del agente controla ejecución, el framework RL recopila y actualiza modelos, el proxy es el contrato. Una política entrenada con éxito vuelve al mismo sistema, no a una réplica solo de entrenamiento.
Reduce una causa de desalineación entrenamiento-servicio, las condiciones distintas entre optimización y producción. No transforma repositorios de benchmark en entornos clientes, iguala todos los permisos ni garantiza datos idénticos de herramientas. Los usuarios reales rara vez dan recompensas tan claras como tareas controladas.
Un rollout no es una sola secuencia ordenada
Un rollout es un intento completo, con posibles llamadas múltiples, inspecciones, ediciones, pruebas y correcciones. La recompensa final puede llegar solo al terminar. El trabajo inicial usó arquitectura desagregada y asignación de crédito para convertir trayectorias complejas en transiciones y vincular decisiones a recompensas posteriores.
La versión 1.0 observa pares solicitud-respuesta del arnés, no una secuencia limpia. El informe identifica cuatro cuestiones: retokenización, división del intento en muestras, normalización de pérdidas y cargas variables del backend.
El arnés suele guardar texto, pero RL necesita los identificadores exactos muestreados en inferencia. Reconstruir después puede mover límites. Una traza legible no es automáticamente un registro fiel de entrenamiento.
Resúmenes, subagentes y llamadas repetidas dividen intentos en muestras desiguales. Más fragmentos no deberían hacer un rollout más importante. Promediar pérdidas solo por muestras puede sobreponderar más llamadas, no mejor trabajo.
Tres llamadas frente a veinte ilustran el problema. Más puede significar verbosidad, exploración o recuperación prudente. Contar cada una como trayectoria independiente confunde causas. El procesamiento consciente del rollout mantiene muestras relacionadas al calcular ventajas y pérdidas.
Cantidad y longitud se conocen después de terminar, mientras topología GPU y entrenamiento distribuido prefieren formas previsibles. El informe presenta cuestiones de investigación, no dificultades desaparecidas por el proxy.
El proxy crea una frontera observable sin exponer cada rama. Pero el tráfico solo no explica efectos de herramientas, cachés ocultas, servicios no deterministas o API externas. Tarea, llamadas y recompensas deben quedar conectadas, mientras otros estados aún influyen.
Dos mejoras de programación con alcance limitado
El ejemplo principal utiliza Qwen3.5-9B en SWE-bench Verified. Microsoft comunica Pass@1 de 41,8% a 56,4% tras RL con unos 6.000 ejemplos: 14,6 puntos porcentuales absolutos, no 14,6% relativo.
Pass@1 pregunta si el primer intento evaluado resuelve. SWE-bench Verified usa problemas reales filtrados por humanos. La referencia común requiere versiones y condiciones de evaluación alineadas.
El repositorio añadió después Qwen3.5-35B-A3B: RL puro con 1.800 ejemplos, de 47,8% a 61,6%. Ambos son medidas del proyecto, no auditorías independientes. Hardware, configuración, filtrado, recompensas y procedimientos influyen.
El flujo incluye preparación de datos, rollouts, scripts y defensas contra manipulación de recompensas. Hace la afirmación más inspeccionable que un número aislado, pero no prueba reproducción independiente de iguales mejoras.
Los resultados apoyan un mecanismo acotado: un arnés real genera datos sin reescribirse como bucle del entrenador, seguido de mejora bajo la evaluación comunicada. No miden mantenimiento prolongado, criterio de seguridad ni colaboración humana.
Programar ofrece retroalimentación ejecutable. Las pruebas suelen distinguir parches válidos de fallidos. Ventas, investigación y conocimiento empresarial podrían no tener entornos tan deterministas ni verificadores fiables, limitando el traslado.
Soporte podría aprender a cerrar tickets sin resolver, investigación agradar al evaluador omitiendo contradicciones, automatización explotar permisos de prueba. Las herramientas permiten manipular archivos, pruebas, estados o servicios para subir puntuación, no solo escribir engaños. Las defensas reconocen el riesgo sin eliminar su examen.
La capa ligera coordina un sistema pesado
El inicio rápido exige una máquina A100 y arranca Ray, verl, vLLM, servidor y controlador. Inferencia, optimización de política, ejecución distribuida y planificación GPU quedan fuera del pequeño recuento de control.
Integrar rápido puede dejar gran trabajo en datos, recompensas, operación GPU, seguimiento y análisis de fallos. Un laboratorio con clúster puede llamarlo ligero; un equipo sin infraestructura RL ver el proxy como la menor parte.
Trabajos Kubernetes nativos llevan contenedores, herramientas y dependencias habituales a clústeres locales, propios o cloud. El controlador inicia intentos y el backend procesa resultados. Evita exigir sandbox comercial y mantiene repositorios privados y herramientas internas en infraestructura ya gestionada.
Autogestión transfiere responsabilidad. Contenedores, credenciales, red, almacenamiento y privilegios requieren protección. Exploraciones y fallos ejecutan shell y cambian repositorios. Aislamiento débil alcanza secretos, servicios compartidos o datos ajenos, con mayor exposición paralela.
El proxy también es sensible. Prompts y respuestas pueden contener código, documentos e instrucciones internas. Retención, acceso y ocultación deben ajustarse. La licencia MIT reduce barreras experimentales, no garantiza seguridad gestionada ni operación.
Código pequeño facilita auditoría de planificación y flujos, pero las dependencias evolucionan aparte. Servidores de modelos, backends, componentes distribuidos, imágenes y bibliotecas necesitan versiones compatibles.
La evaluación tiene igual separación. Pruebas ejecutables son buen inicio; trabajo abierto requiere evaluadores creíbles. Personas cuestan y ralentizan, modelos escalan con sesgos y vulnerabilidades. El proxy no transforma trabajo imposible de medir en objetivo RL fiable.
Importa la reproducción independiente, no un puesto mayor
Los bucles del entrenador siguen siendo útiles cuando el control facilita optimización. El informe describe enfoques relacionados con verl, AReaL, slime y Polar, pero rollout, inferencia, distribución y algoritmos difieren. Separar ejecución no los hace intercambiables.
Preservar contexto y recuperación evita copias y hace inspeccionables fallos reales. El equipo distingue modelo, interfaz, recompensa y política. Una base técnica con búsqueda conserva decisiones con prompts, cambios, recompensas y notas; documentar no sustituye experimentos controlados.
Integraciones independientes deben mostrar código, configuración, depuración y parches específicos. Reproducciones Qwen deben comunicar datos, cómputo, recompensas, evaluación, fallos, estabilidad y sensibilidad entre clústeres. Actualizaciones, estado del repositorio, herramientas de red y latencia cambian trayectorias antes del muestreo.
Búsqueda, recuperación y seguimiento de instrucciones más amplios probarán feedback ruidoso, criterio factual, preferencias y resultados empresariales tardíos. Programación es hoy la evidencia más clara de v1.0; actividad GitHub muestra interés, no mejora segura productiva.
La propuesta conserva el arnés, observa llamadas y relaciones entre intentos, y entrena sin construir otro agente. Reduce duplicación, no dificultad. El valor más amplio depende de recompensas fiables y resultados independientes en entornos reales, con responsabilidades de cómputo, ambiente y seguridad aún visibles.
Fuentes y lecturas relacionadas
Anuncio Microsoft Research; trabajo previo Agent Lightning; informe técnico 1.0; lectura sobre bases técnicas con búsqueda; SWE-bench; inicio rápido; repositorio Agent Lightning.