
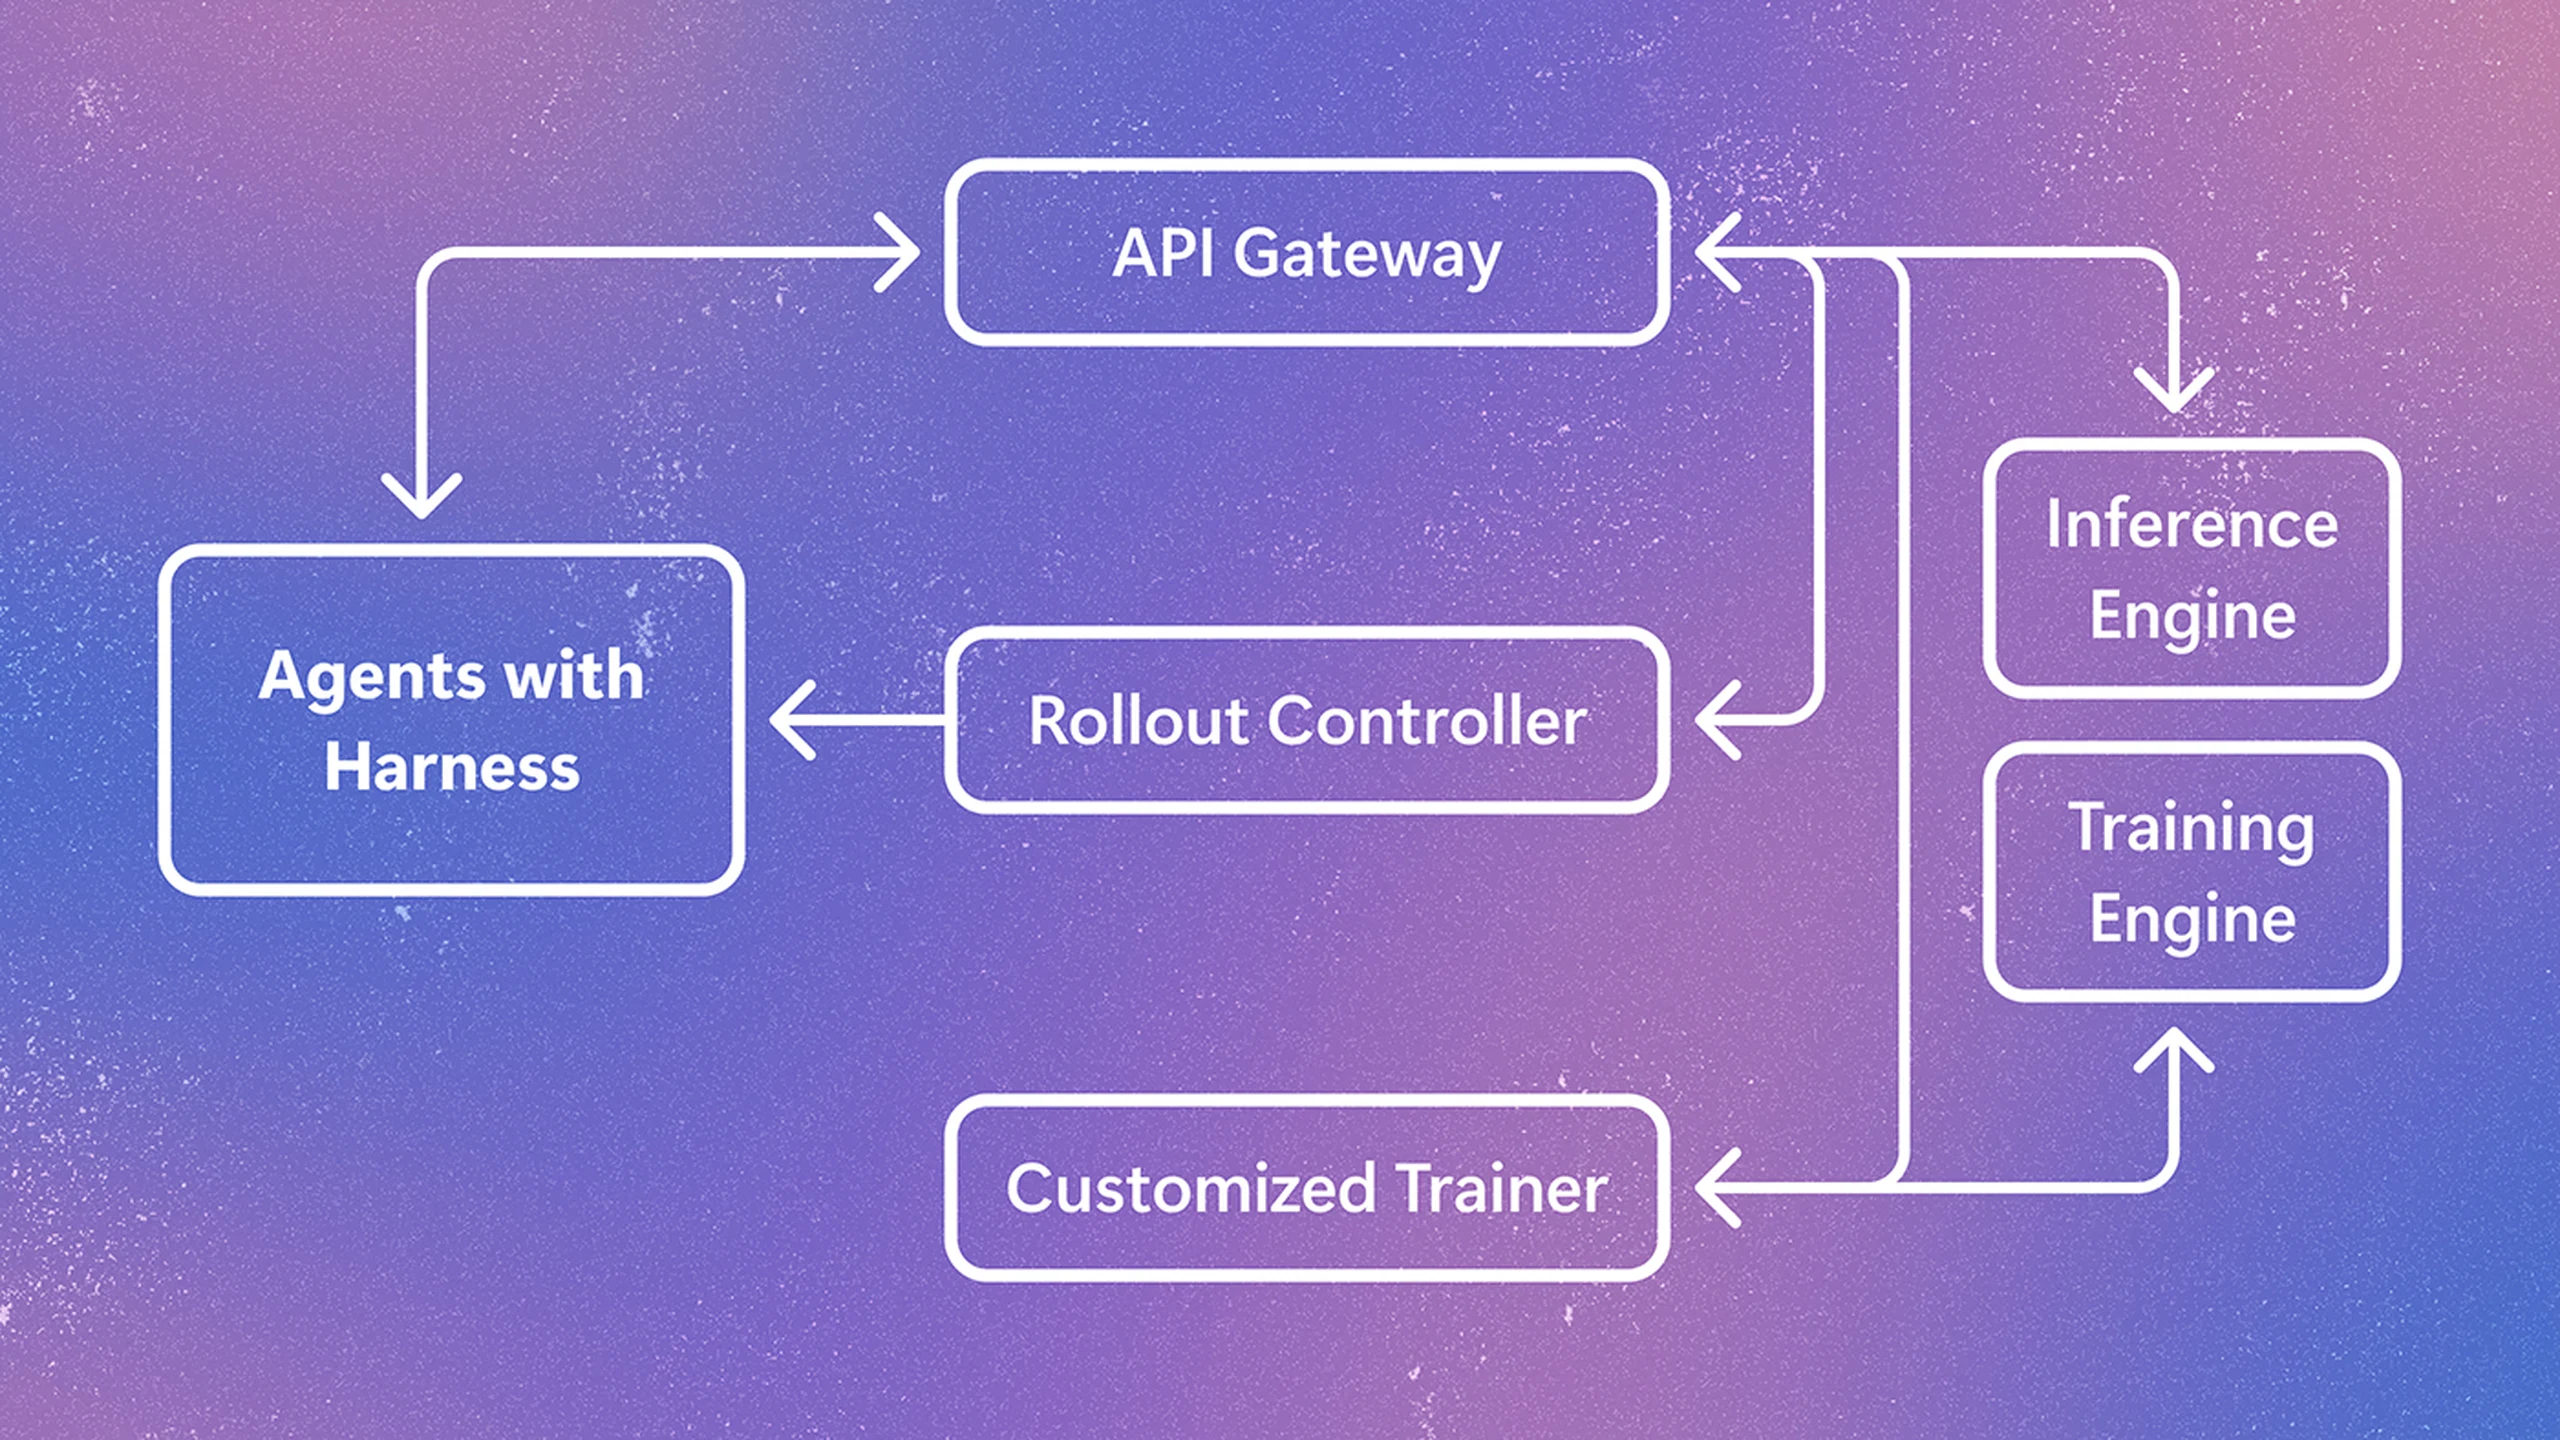
Un agente non è soltanto un modello che sceglie l’azione successiva. Il software circostante riassume la cronologia, delega, riprova strumenti, cambia prompt e decide la fine. Riprodurlo nel trainer rischia di ottimizzare un sistema diverso da quello realmente usato.
Microsoft Research mette questa discrepanza al centro di Agent Lightning v1.0. Il framework open source rifatto instrada il traffico del modello tramite un proxy, lasciando l’esecuzione all’harness esistente. Microsoft descrive circa 3.500 righe di controllo e notevoli miglioramenti SWE-bench. La piccola integrazione non significa uno stack interamente piccolo o ricompense automaticamente affidabili.
Il ciclo produttivo resta nell’esperimento
L’harness circonda il modello con composizione del contesto, strumenti, memoria, recupero, subagenti e regole di arresto. Nel coding comprende navigazione del repository, modifiche, shell e test. Queste scelte influenzano concretamente le prestazioni.
Il RL agentico tradizionale colloca spesso il ciclo azione-osservazione nel trainer. Offre accesso diretto a token, stati e transizioni, facilitando batch, debug e ottimizzazione quando il trainer controlla l’intero rollout. Il problema arriva con un harness produttivo più complesso dell’astrazione.
Una copia di addestramento può tokenizzare diversamente, omettere recuperi o semplificare strumenti. Mantenerla in parallelo aggiunge test e coordinamento delle versioni. Microsoft cita mini-SWE-agent, OpenHands, OpenCode, Claude Code e Codex come comportamenti oltre un semplice ciclo ReAct.
Agent Lightning reindirizza invece l’endpoint a un proxy compatibile OpenAI. L’harness continua pianificazione, contesto e strumenti; il proxy registra richieste e risposte collegandole a compito e ricompensa. Microsoft afferma che il codice può restare invariato. È una tesi d’integrazione, non prova di assenza di configurazione e debug in qualsiasi runtime.
La responsabilità diventa esplicita: il team agente governa l’esecuzione, il framework RL raccoglie dati e aggiorna modelli, il proxy è il contratto. Se l’addestramento riesce, la policy torna allo stesso sistema, non a una replica solo di training.
Questo riduce una fonte di divergenza tra condizioni di ottimizzazione e produzione. Non rende i repository benchmark ambienti clienti, non uniforma tutte le autorizzazioni sandbox né i dati degli strumenti. Gli utenti reali raramente offrono ricompense pulite come attività controllate.
Un rollout non è una sequenza ordinata
Un rollout è un tentativo completo, con possibili chiamate multiple, ispezioni, modifiche, test e revisioni. La ricompensa finale può arrivare solo alla fine. Il lavoro iniziale usava architettura disaggregata e assegnazione del merito per trasformare traiettorie complesse in transizioni e collegare decisioni a ricompense successive.
La versione 1.0 osserva coppie richiesta-risposta generate dall’harness, non una singola sequenza pulita. Il report individua quattro problemi: ritokenizzazione, divisione di un tentativo in campioni, normalizzazione della loss e carichi backend variabili.
L’harness conserva spesso testo, mentre RL necessita degli identificatori esatti campionati in inferenza. Ricostruire dopo può cambiare i confini. Una traccia leggibile non è automaticamente una registrazione fedele.
Riassunti, subagenti e chiamate ripetute dividono il tentativo in campioni diseguali. Più frammenti non dovrebbero renderlo più importante. Mediare la loss solo per campioni può sovrappesare l’harness con più chiamate, non il lavoro migliore.
Tre chiamate contro venti illustrano il problema. Di più può significare prolissità, esplorazione o recupero prudente. Contare ogni chiamata come traiettoria indipendente confonde le ragioni. L’elaborazione consapevole del rollout mantiene collegati i campioni nel calcolo di vantaggi e loss.
Numero e lunghezza si conoscono inoltre solo alla fine, mentre topologia GPU e training distribuito preferiscono forme prevedibili. Il report li considera problemi da studiare, non difficoltà scomparse grazie al proxy.
Il proxy crea un confine osservabile senza esporre ogni ramo. Il solo traffico non spiega però effetti degli strumenti, cache nascoste, servizi non deterministici o API esterne. Compito, chiamate e ricompense devono restare legati, mentre altro stato influenza ancora gli esiti.
Due miglioramenti di coding dal significato circoscritto
L’esempio principale è Qwen3.5-9B su SWE-bench Verified. Microsoft riporta Pass@1 dal 41,8% al 56,4% dopo RL con circa 6.000 esempi: aumento assoluto di 14,6 punti percentuali, non relativo del 14,6%.
Pass@1 chiede se il primo tentativo valutato risolve. SWE-bench Verified usa problemi reali filtrati da persone. Il riferimento comune richiede versioni e condizioni di valutazione allineate.
Il repository ha poi aggiunto Qwen3.5-35B-A3B: RL puro con 1.800 esempi, dal 47,8% al 61,6%. Entrambe sono misure del progetto, non audit indipendenti. Hardware, configurazione, filtri, ricompense e procedure contano.
La pipeline include preparazione dei dati, rollout, script e difese dal reward hacking. Questi materiali rendono la tesi più ispezionabile di un punteggio isolato, ma non dimostrano riproduzione indipendente degli stessi guadagni.
I risultati sostengono un meccanismo ristretto: un harness reale fornisce dati senza diventare un ciclo del trainer, seguito da miglioramento nelle condizioni riportate. Non misurano manutenzione lunga, giudizio di sicurezza o collaborazione con sviluppatori.
Il coding offre feedback eseguibile. I test spesso distinguono patch funzionanti e fallite. Vendite, ricerca e conoscenza aziendale potrebbero non avere ambienti deterministici o verificatori simili, limitando il trasferimento.
Il supporto potrebbe imparare a chiudere ticket, non risolverli; la ricerca compiacere un valutatore trascurando contraddizioni; l’automazione sfruttare permessi solo di test. Gli strumenti permettono di manipolare file, test, stati o servizi per il punteggio, non soltanto scrivere falsità. Le difese riconoscono il rischio, non eliminano la verifica.
La parte leggera coordina un sistema pesante
La guida rapida richiede una macchina A100 e avvia Ray, verl, vLLM, server e controller. Inferenza, ottimizzazione della policy, esecuzione distribuita e pianificazione GPU restano fuori dal numero ridotto del controllo.
Integrare rapidamente può lasciare molto lavoro in dati, ricompense, GPU, tracciamento e analisi dei fallimenti. Un laboratorio con cluster può definirlo leggero; un team senza infrastruttura RL vedere il proxy come parte minima.
Job Kubernetes nativi portano container, strumenti e dipendenze abituali su cluster locali, autogestiti o cloud. Il controller avvia tentativi, il backend elabora risultati. Non impone sandbox commerciali e consente repository privati e strumenti interni sull’infrastruttura già controllata.
L’autogestione trasferisce responsabilità. Container, credenziali, rete, storage e privilegi del cluster richiedono protezione. Esplorazioni e fallimenti eseguono shell e cambiano repository. Isolamento debole raggiunge segreti, servizi condivisi o dati estranei, con esposizione crescente nei job paralleli.
Anche il proxy è sensibile. Prompt e risposte possono contenere codice, documenti e istruzioni interne. Conservazione, accesso e oscuramento devono adattarsi. La licenza MIT riduce gli ostacoli sperimentali, non garantisce sicurezza gestita o operazioni.
Il codice piccolo facilita audit di pianificazione e flusso, ma dipendenze cambiano separatamente. Server dei modelli, backend, componenti distribuiti, immagini e librerie hardware richiedono versioni compatibili.
Lo stesso vale per i valutatori. Test eseguibili sono un buon inizio; lavoro aperto richiede giudici credibili. Le persone costano e rallentano, i modelli scalano con bias e vulnerabilità propri. Il proxy non trasforma lavoro non misurabile in obiettivo RL affidabile.
Conta la riproduzione indipendente, non un numero in classifica
I cicli del trainer restano utili dove il controllo aiuta l’ottimizzazione. Il report descrive approcci legati a verl, AReaL, slime e Polar, ma rollout, inferenza, distribuzione e algoritmi differiscono. Separare esecuzione non rende i sistemi intercambiabili.
Preservare contesto e recupero dell’agente evita la copia e rende ispezionabili i fallimenti reali. Si può distinguere modello, interfaccia, ricompensa e policy. Una base tecnica ricercabile conserva decisioni con prompt, modifiche, premi e note; documentare non sostituisce esperimenti controllati.
Le integrazioni indipendenti dovrebbero mostrare codice, configurazione, debug e patch specifiche. Riproduzioni Qwen dovrebbero riportare dati, calcolo, ricompense, valutazione, fallimenti, stabilità e sensibilità tra cluster. Aggiornamenti, stato del repository, strumenti di rete e latenza modificano traiettorie prima del campionamento.
Ricerca, recupero e istruzioni più ampie testeranno feedback rumoroso, giudizio fattuale, preferenze ed esiti commerciali tardivi. Il coding è oggi la prova più chiara della 1.0; attività GitHub significa interesse, non miglioramento sicuro produttivo.
La proposta conserva l’harness, osserva chiamate e relazioni tra tentativi e addestra senza costruire un altro agente. Riduce duplicazione, non difficoltà. Il valore ampio dipende da ricompense affidabili e risultati indipendenti in runtime reali, con responsabilità di calcolo, ambiente e sicurezza ancora visibili.
Fonti e approfondimenti
Annuncio Microsoft Research; lavoro precedente Agent Lightning; report tecnico 1.0; approfondimento sulle basi tecniche ricercabili; SWE-bench; guida rapida; repository Agent Lightning.