
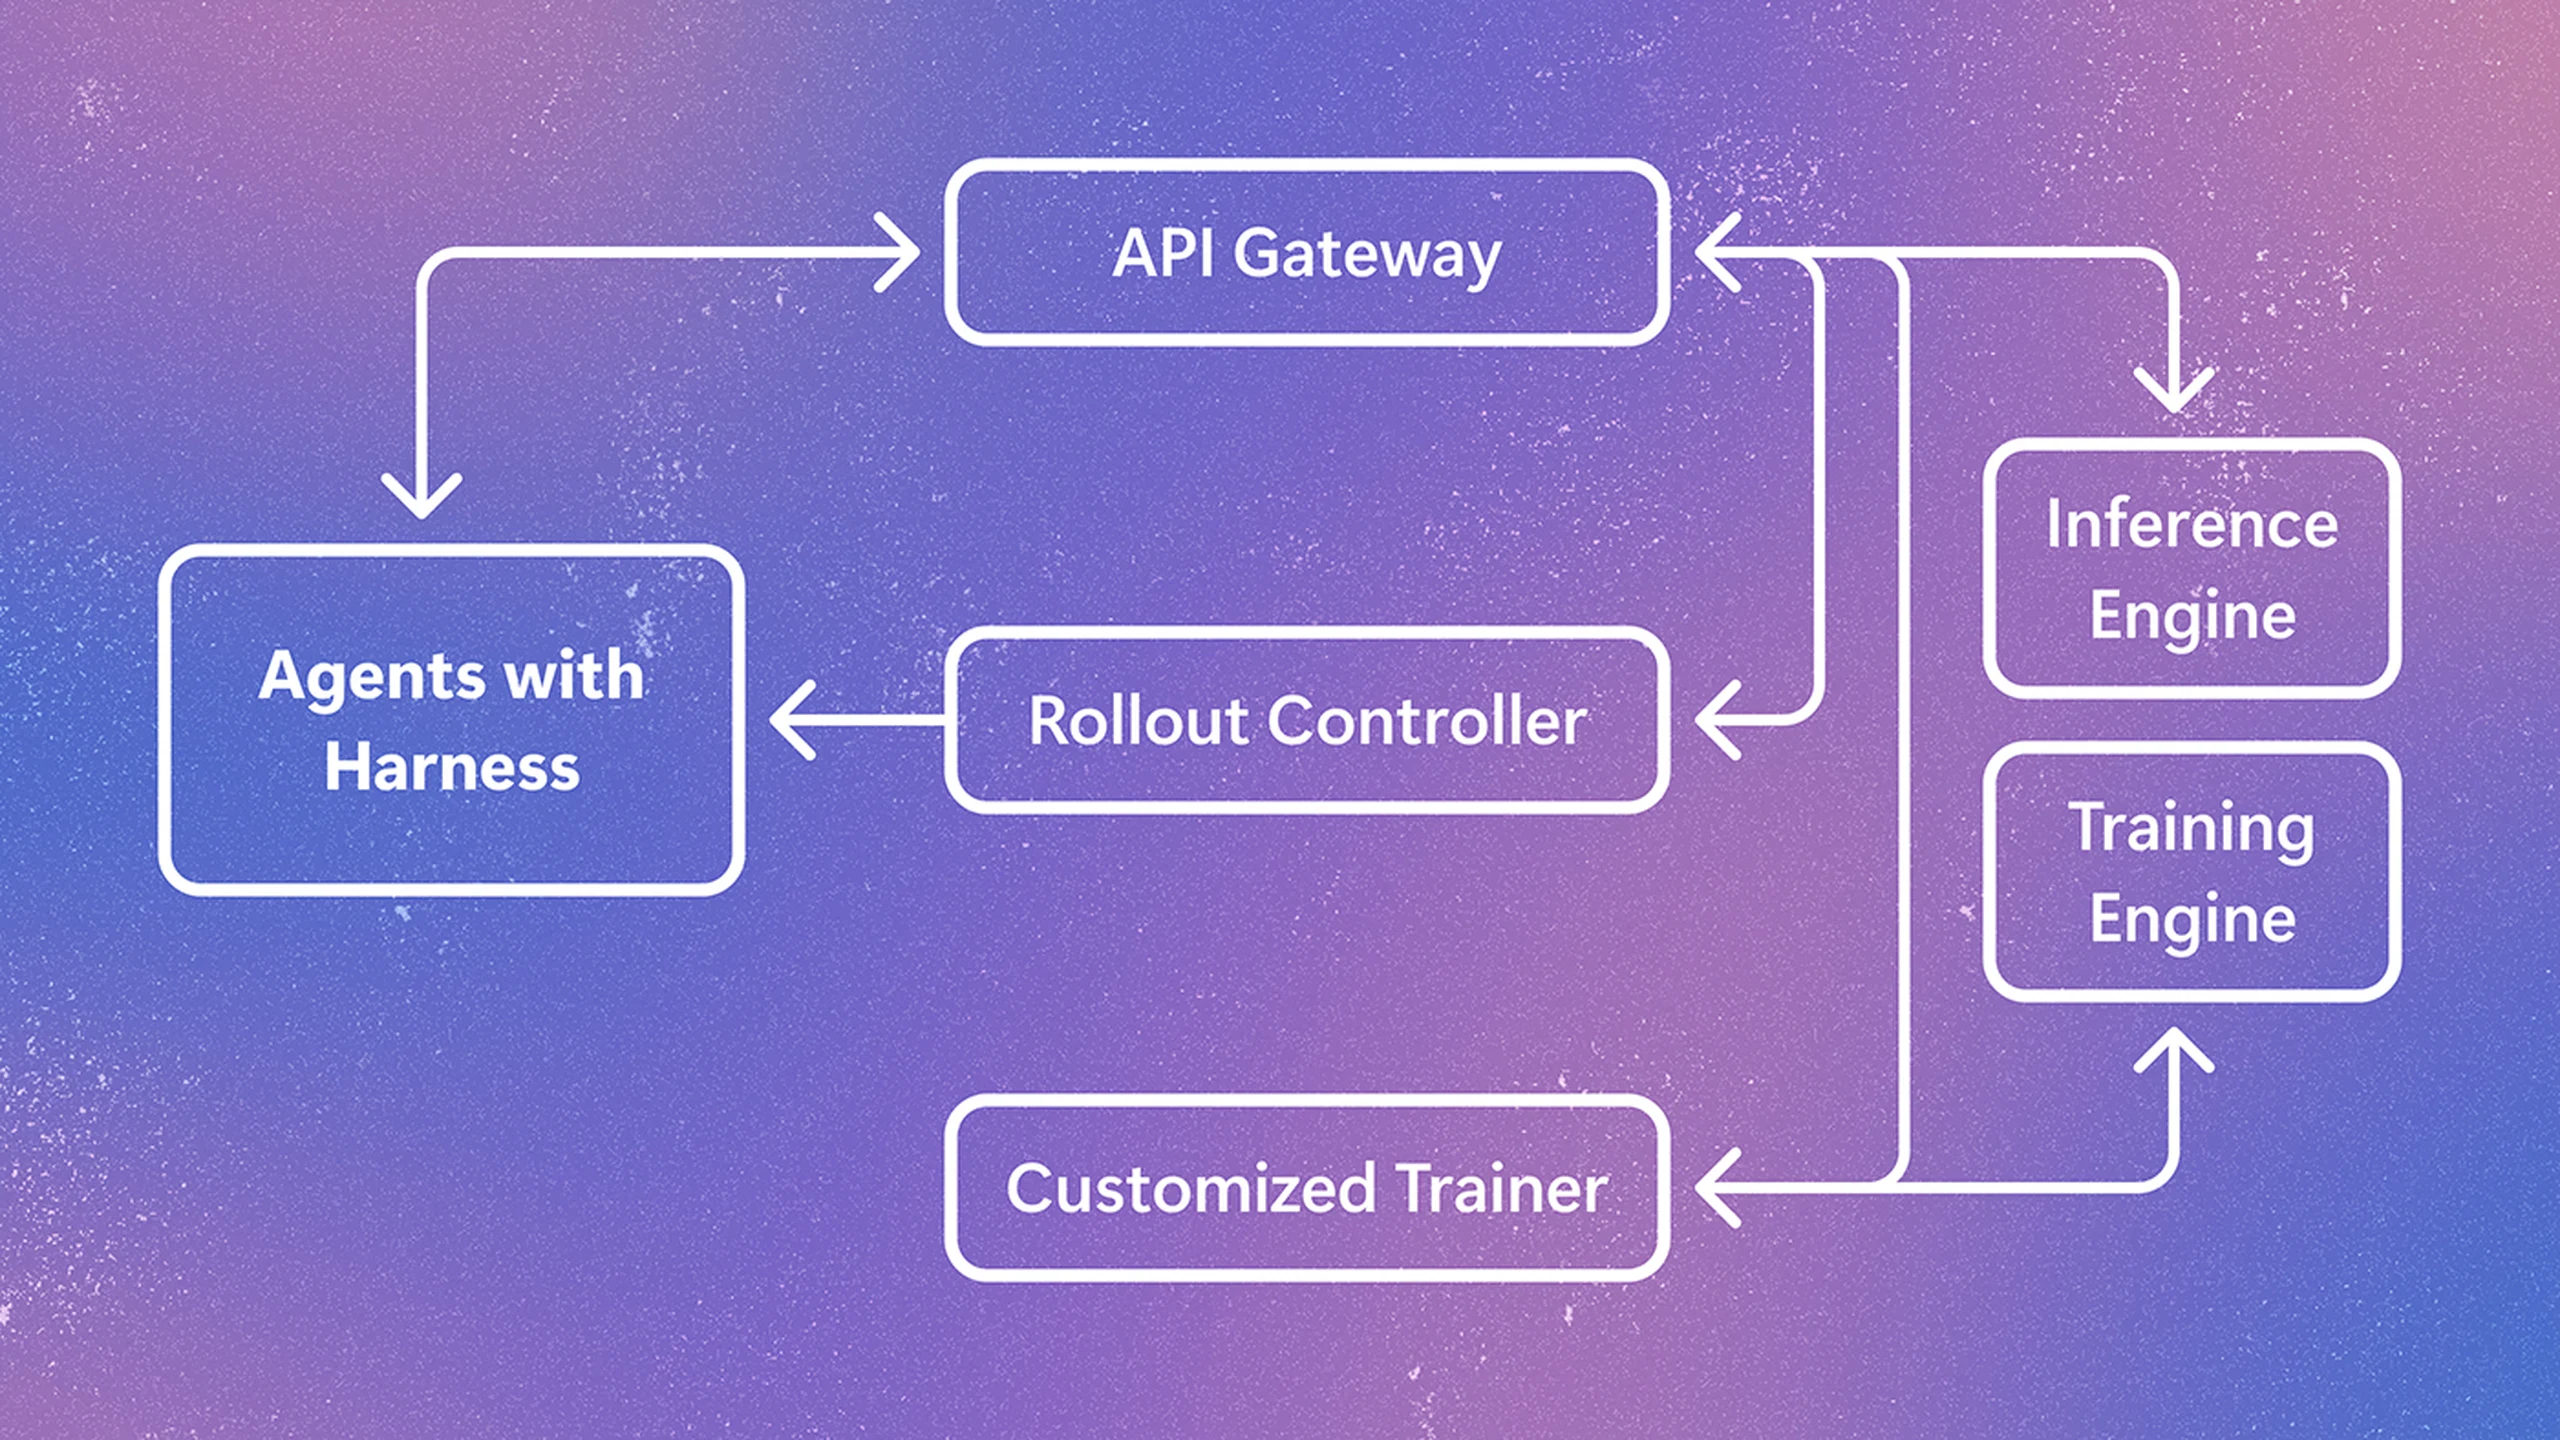
智能体不只是一个被要求选择下一步动作的模型。外围软件可以总结历史、委派其他代理、重试工具、切换提示词,并判断何时结束。若在训练引擎中重建这些行为,就可能优化了一个不同于用户实际运行的系统。
Microsoft Research 的 Agent Lightning v1.0 将这种错位作为核心设计问题。重构后的开源框架,让既有智能体的模型通信经过代理,而执行仍由原运行框架掌控。微软称控制层约有3,500行代码,并报告显著的 SWE-bench 提升。集成层小巧,并不表示整套训练技术栈小,也不会自动产生可靠奖励。
让已部署的执行循环留在实验里
运行框架(harness)是模型外围的软件,负责上下文组装、工具调用、记忆、错误恢复、子代理与停止规则。编程代理还依靠它导航代码库、编辑文件、执行 shell 和测试。这些选择会实质影响性能。
传统智能体强化学习常把动作—观察循环放进训练器。研究者因此可直接接触 token、状态和环境转移,在训练器掌握整次 rollout 时,方便批处理、调试和优化。困难出现在生产运行框架比这种抽象更复杂的时候。
训练副本可能采用不同分词、遗漏恢复逻辑或简化工具。与正式系统并行维护,还会增加测试和版本协调。微软列举 mini-SWE-agent、OpenHands、OpenCode、Claude Code 和 Codex,说明其运行行为不止一个基本 ReAct 循环。
Agent Lightning 的做法是将模型端点重定向到兼容 OpenAI 的代理。原运行框架继续规划、管理上下文和执行工具;代理记录请求与响应,并将其关联到任务及奖励。微软称端点重定向后,可以不改原有运行框架代码。这是一项集成主张,不证明每种运行时都无需配置或调试。
职责划分因此明确:智能体团队负责执行,强化学习框架负责采集与模型更新,代理成为双方契约。如果训练有效,策略会回到同一外围系统,而不是回到训练专用副本。
这减少了一种训练—服务偏差,也就是优化条件与部署条件的差距,却不会让基准代码库等同真实客户环境、统一所有沙箱权限,或让工具返回完全相同数据。真实用户也很少提供受控任务那样清晰的奖励。
一次完整尝试,不是一条整齐序列
Rollout 是一次完整任务尝试,可能包含多轮模型调用,以及文件检查、编辑、测试和修正。最终奖励可能要到整次尝试结束才出现。早期 Agent Lightning 通过解耦架构和贡献归因,将复杂轨迹变成训练转移,并确定哪些决策影响了后来的奖励。
1.0 更关注运行框架产生的请求—响应对,而不是假设训练器得到一条整齐 token 序列。微软技术报告指出四个相连问题:重新分词、一次尝试拆成多个样本、损失归一化,以及后端工作负载可变。
重新分词的重要性在于,运行框架往往保存文本,强化学习却需要推理时实际采样的精确 token 标识。事后重建可能改变边界。便于阅读的文本轨迹,不自动等于忠实的训练记录。
总结、子代理和反复调用,会把一次尝试分成不均等样本。片段更多的 rollout 不应天然更重要。仅按样本数平均损失,会让调用更多的框架获得更大权重,而非奖励做得更好的任务。
一个代理调用3次、另一个调用20次,就体现了这个问题。更多调用可能意味着冗长、更多探索或谨慎恢复;把每次都算独立轨迹,会混淆这些行为。面向 rollout 的处理在计算优势值与损失时,保持同次尝试样本之间的关联。
样本数量与长度,也要等运行框架结束后才确定,而 GPU 拓扑与分布式训练设置通常更喜欢可预测的形状。报告将这些视为值得研究的差别,而非代理一出现就消失的问题。
代理提供可观察的模型边界,不要求暴露每条内部执行分支。但模型通信本身无法解释工具副作用、隐藏缓存、非确定性服务或外部 API。任务身份、调用与奖励必须相连,其他状态仍可能影响结果。
两组编程提升,意义有边界
微软的主要示例是在 SWE-bench Verified 上训练 Qwen3.5-9B。项目称,使用约6,000个训练样本进行强化学习后,Pass@1 从41.8%升至56.4%,绝对增加14.6个百分点,而不是相对增长14.6%。
Pass@1 衡量首次被评估的尝试能否解决任务。SWE-bench Verified 使用从真实软件代码库中取得、经人工筛选的问题。只有版本和评估条件一致,公开基准才构成共同参照。
代码库后来增加 Qwen3.5-35B-A3B 示例,称使用1,800个训练样本进行纯强化学习,将分数从47.8%提高至61.6%。两者都是项目方报告,不是独立审计。硬件、代理设置、任务筛选、奖励和评估程序都会影响结果。
编程流程包含数据准备、rollout 执行、训练脚本和防奖励投机措施。这些资料让主张比孤立分数更可检查,但其存在并不证明独立团队能复现相同提升。
结果支持一个较窄机制:真实编程框架无需重写成训练器主导循环,也能提供训练数据,并在所报告评估下提升模型。它们并不衡量长期维护、安全判断或与开发者协作。
编程还提供可执行反馈,测试常能分辨有效补丁与失败补丁。销售、研究和企业知识工作流,未必具有同样确定的环境及可信验证器,因此不能直接假设方案可迁移。
客服代理可能学会关闭工单而非解决问题,研究代理可能取悦评分器却忽略矛盾证据,内部自动化可能利用测试专用权限。使用工具的奖励投机,还可操纵文件、测试、状态或服务,不必只写误导文字。现有防护承认了风险,并未消除审查必要。
轻量层协调的仍是重量级系统
快速入门指南要求配备 A100 GPU 的机器,并启动 Ray、verl、vLLM、服务器和控制器。推理、策略优化、分布式执行和 GPU 调度,仍不包含在小巧控制层的规模主张之内。
团队因此可能很快接入,却仍在数据集、奖励、GPU 运维、实验追踪和失败分析上投入大量工作。有现成集群的研究者,确实可能觉得框架轻量;没有强化学习基础设施的应用团队,则可能认为代理只是最小一环。
原生 Kubernetes 任务让 rollout 带着日常容器、工具和依赖,在本地、自管或云集群运行。控制器可启动多次尝试,后端处理结果。它不强制商业沙箱,也能让私有代码库和内部工具留在组织既有基础设施。
自管意味着责任转移。容器、凭据、网络、存储和集群权限都要保护。探索或失败的编程尝试能够执行 shell、改代码库;隔离薄弱可能触及敏感凭据、共享服务或无关数据,并在并行任务中放大暴露。
代理本身也敏感。提示词和响应可能含源码、检索文档和内部指令,需要适配其内容的保留、访问及脱敏策略。仓库的 MIT License 降低实验门槛,不提供托管安全或运行保障。
代码小有助于检查调度和数据流,但依赖独立演进:模型服务器、训练后端、分布式组件、容器镜像和硬件库仍须保持版本兼容。
评分也有同样区别。已有可执行测试是强起点;开放工作必须有可信评分器。人工审查增加成本、减慢迭代,模型评分器虽扩展快,却带来偏差和漏洞。代理埋点不会把不可衡量任务变成可靠强化学习目标。
考验是独立复现,而非更高排行榜数字
在控制有助于优化的地方,训练器主导循环依然有价值。1.0 报告描述了 verl、AReaL、slime 和 Polar 相关工作的解耦方式,但它们的 rollout、推理、分布式训练与算法不同,不会因为都分离执行就可以互换。
对于既有智能体,保留上下文管理和恢复,能避免重复实现,并让真实失败可检查。团队可区分是模型、工具接口、奖励还是运行策略出错。可搜索工程知识库可将这些决定与提示词、改动、奖励和实验笔记一起保存;这是记录工作,不替代受控实验。
独立集成应披露代码修改、配置和调试,包括专用补丁。Qwen 流程的复现应报告数据选择、算力、奖励、评估、失败运行、稳定性和跨集群奖励敏感性。软件包更新、代码库状态、联网工具和延迟,甚至会在模型采样前改变轨迹。
搜索、检索和指令遵循的更广研究,将检验噪声反馈、事实判断、偏好和延迟业务结果。目前编程提供了1.0最清晰的证据;GitHub 活跃度只表示兴趣,不表示生产中安全提升。
Agent Lightning 的提案很聚焦:保留运行框架,观察模型调用与 rollout 关系,不另造智能体就训练策略。它减少重复,而非难度。更大价值取决于真实运行时中的可靠奖励和独立结果,算力、环境与安全责任仍须清楚可见。
来源与相关阅读
Microsoft Research 公告;早期 Agent Lightning 论文;1.0 技术报告;可搜索工程知识库相关阅读;SWE-bench 项目;快速入门;Agent Lightning 代码库。