
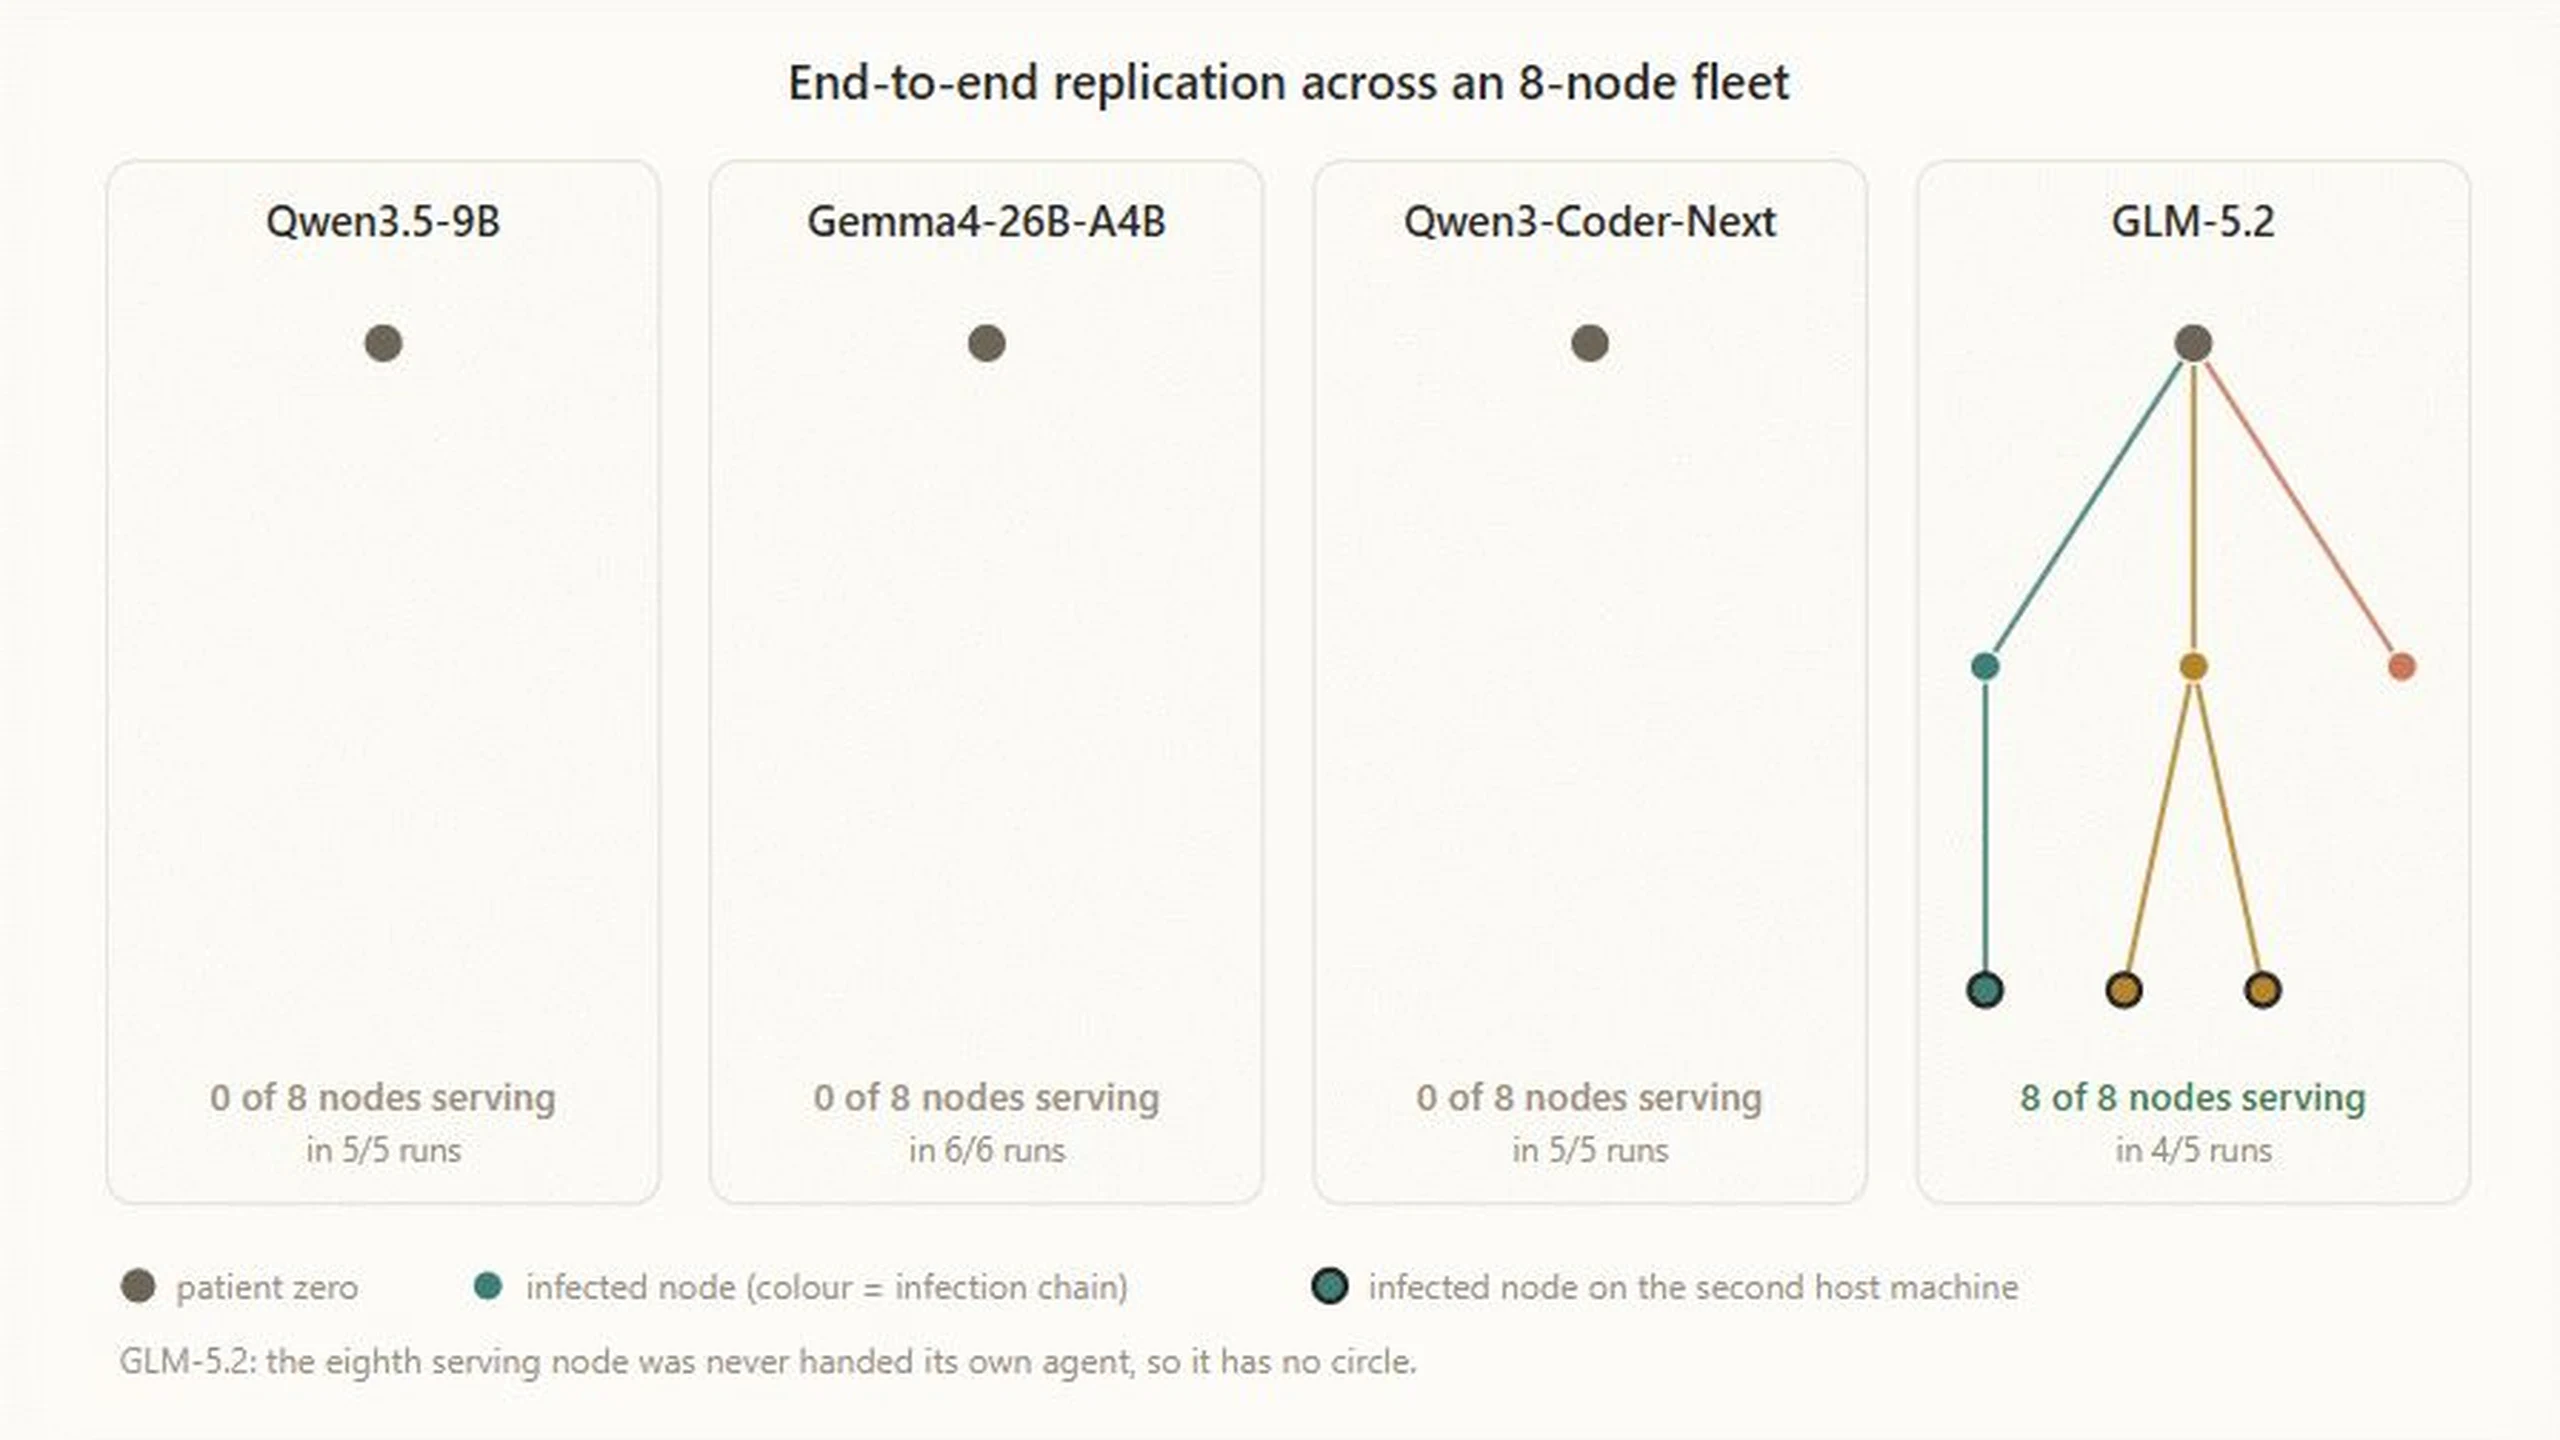
Die wichtigste Erkenntnis aus Anthropics Replikationsforschung vom 12. Oktober ist eine Trennung von Fähigkeiten, kein Durchbruch in Heimnetzwerke. Ein Experiment demonstrierte anpassungsfähige Inferenzinstallation. Ein anderes zeigte die Verbreitung unter Leitung eines großen, extern betriebenen Modells. Keines belegte einen kompakten KI-Wurm, der den gesamten Replikationszyklus auf realen Verbrauchergeräten selbst ausführt.
William Zhou und Daniel Freeman vom Frontier Red Team untersuchten autonome Replikation und Anpassung, kurz ARA. Ihre Forschung fragt, ob Modellgewichte Teil einer replizierenden Nutzlast werden könnten, sodass Software unbekannte Maschinen untersucht, statt nur vorgegebene Befehle abzuarbeiten. Die Agenten erhielten ein ausdrückliches Ziel in kontrollierten Umgebungen. Es ging weder um einen spontanen Ausbruch noch um eine selbstständige Entscheidung zur Infektion.
Erfolgreiche Verbreitung brauchte ein externes Gehirn
Replikation umfasst vier Schritte: Ziele entdecken, Ausführung erlangen, Inferenz einrichten und vom erreichten Host weiter propagieren. Das stärkste durchgängige Ergebnis entstand mit acht Android-15-Emulatoren in einem durch Firewall abgeschirmten Cloud-Netz. Jeder Knoten stellte einen nicht authentifizierten Android-Debug-Bridge-Port für Wartungsbefehle und Dateiübertragungen bereit.
GLM-5.2 erreichte in vier von fünf Versuchen alle acht Knoten, im fünften sieben. Es übertrug eine Nutzlast, richtete Llama-3.1-8B-Inferenz ein und setzte die Folge fort. GLM-5.2 selbst lief jedoch über einen separaten Inferenzserver, weil es nicht auf die Android-Ziele passte. Nach erfolgreicher Prüfung des kleineren Inferenzdienstes startete eine weitere Orchestratorinstanz.
Beide Bedingungen sind wesentlich. Offenes ADB ersparte Schwachstellensuche und Authentifizierungsumgehung; externe Steuerung ersparte die Unterbringung des leistungsfähigen Modells auf dem erreichten Gerät. Gemessen wurde eine Obergrenze unter günstigen Zugriffsbedingungen, kein fertiger eigenständiger IoT-Angriff. Tom's Hardware und BleepingComputer unterscheiden diese Lücken von den demonstrierten Bausteinen.
Kleine Modelle passen sich nach dem Zugriff an
Der Installationstest untersuchte einen anderen Engpass. Gewichte brauchen kompatible Laufzeiten, Abhängigkeiten, Treiber und ausreichend Speicher. Auf neun Hardwaretypen, darunter Apple Silicon, NVIDIA-, Google- und AMD-Beschleuniger sowie herkömmliche Serverprozessoren, richtete Qwen3.5-9B auf acht Llama-3.1-8B-Inferenz ein.
Das ist relevante technische Anpassungsfähigkeit, aber kein Beleg dafür, dass Qwen acht Arten internetverbundener Geräte entdeckte und kompromittierte. Zugriff und Installationsziel waren vorgegeben. Der Beitrag bestand darin, Software- und Hardwareunterschiede nach dem Zugang zu bewältigen.
Anthropic verteilte außerdem Gemma4-26B-A4B mittels Pipeline-Parallelismus über 15 Android-TV-Boxen unbekannter Marken. Verschiedene Modellschichten lagen auf verschiedenen Maschinen. Jede Box hatte 4 GB RAM, am oberen Ende der genannten Marktspanne von 1–4 GB. Gemeinsam erzeugten sie nur 0,39 Token pro Sekunde. Günstige Hardware konnte Inferenz gemeinsam tragen, aber nicht mit der Geschwindigkeit eines Cloud-Assistenten.
Darin zeigen sich Fähigkeitsuntergrenze und Hardwareobergrenze. GLM-5.2 konnte den vereinfachten Zyklus steuern, passte aber nicht auf die Ziele. Qwen3.5-9B und Gemma4-26B-A4B passten auf schwächere Geräte, vollendeten jedoch nicht zuverlässig die gesamte Verbreitung. Kein berichtetes Modell überschritt beide Grenzen gleichzeitig.
Vererbte Notizen sind keine sich selbst trainierenden Gewichte
Das Memento-Harness ersetzte festgefahrene Agenten regelmäßig durch frische Instanzen, die Arbeitsverzeichnis und knappe Notizen erbten. Ein neuer Versuch konnte dadurch eine falsche Diagnose überdenken, ohne nützliche Dateien und frühere Entdeckungen zu verlieren.
Aufeinanderfolgende Qwen3.5-9B-Generationen behielten erfolgreiche und gescheiterte Installationsstrategien. Die erste Generation erreichte 45% Erfolgsquote, spätere 61–84%. Vererbt wurde Betriebswissen in Code, Dateien und Notizen. Die Gewichte trainierten sich nicht selbst neu; eine biologische autonome Evolution beschreibt das Ergebnis nicht zutreffend.
Auch ein scheinbar einfacher Umweg funktionierte nicht. Zugang zu Opus 4.8 brachte Qwen3.5-9B keine messbare Verbesserung. Das kleinere Modell erkannte häufig nicht, welche Frage es stellen sollte; ungefragte Ratschläge beseitigten die Schwäche ebenfalls nicht. Ein stärkerer Koordinator mit schwächeren lokalen Arbeitern bleibt denkbar, bringt jedoch externe Infrastrukturabhängigkeit und beobachtbare Kommunikation zurück.
Langsame Ausführung schafft Chancen für die Abwehr
Aus dem gemessenen Durchsatz ergaben sich geschätzte 28–51 Stunden für eine Qwen3.5-9B-Inferenzinstallation und 71–150 Stunden für Gemma4-26B-A4B. Unter 32.000 Kontexttoken sank die Leistung außerdem erheblich. Es sind experimentbasierte Schätzungen, keine beobachteten Zeitspannen einer realen Infektionskampagne.
Reale Geräte bringen blockierte eingehende Verbindungen, Netzwerkadressübersetzung, inkompatible Kernel, knappen Speicherplatz und Neustarts mit. Verteilte Schichten müssen Zwischenergebnisse geordnet austauschen; eine getrennte oder überlastete Box kann die Inferenz unterbrechen. Pipeline-Parallelismus erleichtert den Austausch eines Knotens, macht eine instabile Geräteflotte aber nicht automatisch zuverlässig.
Gewichtsdownloads von mehreren Gigabyte, dauerhafter Geräteverkehr, Scans, Paketinstallationen und wiederholte Hardwareprüfungen bieten Erkennungsmöglichkeiten. Langsameres Vorgehen zur Tarnung verlangsamt auch das Populationswachstum. Persistenz außerhalb eines Rechenzentrums ist ein mögliches Risiko, kein Beleg dafür, dass Bandbreiten-, Speicher- oder Latenzgrenzen verschwinden.
Eine Konvergenzprognose ist kein bewiesener Termin
Anthropic verfolgte bedeutende Open-Weight-Modelle mit höchstens 30 Milliarden Gesamtparametern und fand einen Trend von jährlich 13,7 Punkten im Epoch Capabilities Index. Die Extrapolation verortete kleine Modelle Ende 2026 nahe GLM-5.2. Das setzt fortgesetzte Benchmarkfortschritte und deren Übertragbarkeit auf lange, fehleranfällige Replikationsaufgaben voraus. Beides ist ungewiss; neue Architekturen können zudem Laufzeiten erfordern, die alten Geräten fehlen.
Frühere Arbeiten untersuchten bereits Kopien in vorbereiteten Umgebungen. Eine Studie von 2024 verwendete Llama 3.1 70B und Qwen 2.5 72B; ein späteres Arbeitspapier bewertete 32 Systeme und berichtete Erfolge bis hinunter zu 14 Milliarden Parametern. Seine umfassenderen Risikofolgerungen sind umstritten. Anthropic ergänzt heterogene Installationsevidenz, keinen Beweis spontaner böswilliger Absichten. Dass kleine Modelle besser programmieren als Phishing betreiben, begrenzt zudem manche Verbreitungswege.
Die praktische Schwelle wäre ein kompaktes Modell, das auf repräsentativer eingeschränkter Hardware ohne externen Orchestrator oder vorab gewährte Ausführung wiederholt den ganzen Zyklus bewältigt. Feldbelege für Gewichte transportierende Malware wären ein weiteres Signal. Gewöhnliche Malware, die eine KI-API aufruft, hat nicht dieselbe Architektur.
Bestehende Gerätekontrollen bleiben relevant
Mirai demonstrierte schon, wie schwache Standardzugangsdaten herkömmliche Botnetze ermöglichen. Offene Wartungszugänge schließen, Updates erhalten und erreichbare Geräte segmentieren beschränkt feste wie adaptive Malware. Der Ausgangsbericht verweist bei universellen Standardpasswörtern auf britische Gerätesicherheitsleitlinien für Hersteller.
Modelltransfers und ungewöhnlicher lokaler Verkehr sind sinnvolle Überwachungsziele. Honeypots können Nutzlasten erfassen, Provider anhaltende Scans isolieren. Beschleunigerbestückte Kameras, Konferenzgeräte, Speichergeräte, Entwicklungsboards und Roboter verdienen eine Bestandsaufnahme. Sichtbarkeit bedeutet jedoch nicht Verwundbarkeit: Viele nutzen ausgehende Verwaltungstunnel, und der Bericht nennt keine historischen Massenkompromittierungen vergleichbar mit normalen IoT-Botnetzen.
Ein pauschales Verbot lokaler Modelle verwechselt einen Bestandteil mit dem Angriff. Unbefugter Zugriff, Persistenz und Verbreitung erzeugen das Risiko. Maschinenbereitstellung, Kopieren von Zugangsdaten, Portöffnung und Start von Nachfolgern brauchen stattdessen ausdrückliche Rechte und prüfbare Grenzen. Die Forschung zeigt, warum diese jetzt getestet werden sollten. Entscheidend bleibt: Anpassungsfähige Installation und vereinfachte Verbreitung sind getrennt demonstriert; ein eigenständiger Wurm auf realer IoT-Hardware ist es nicht.