
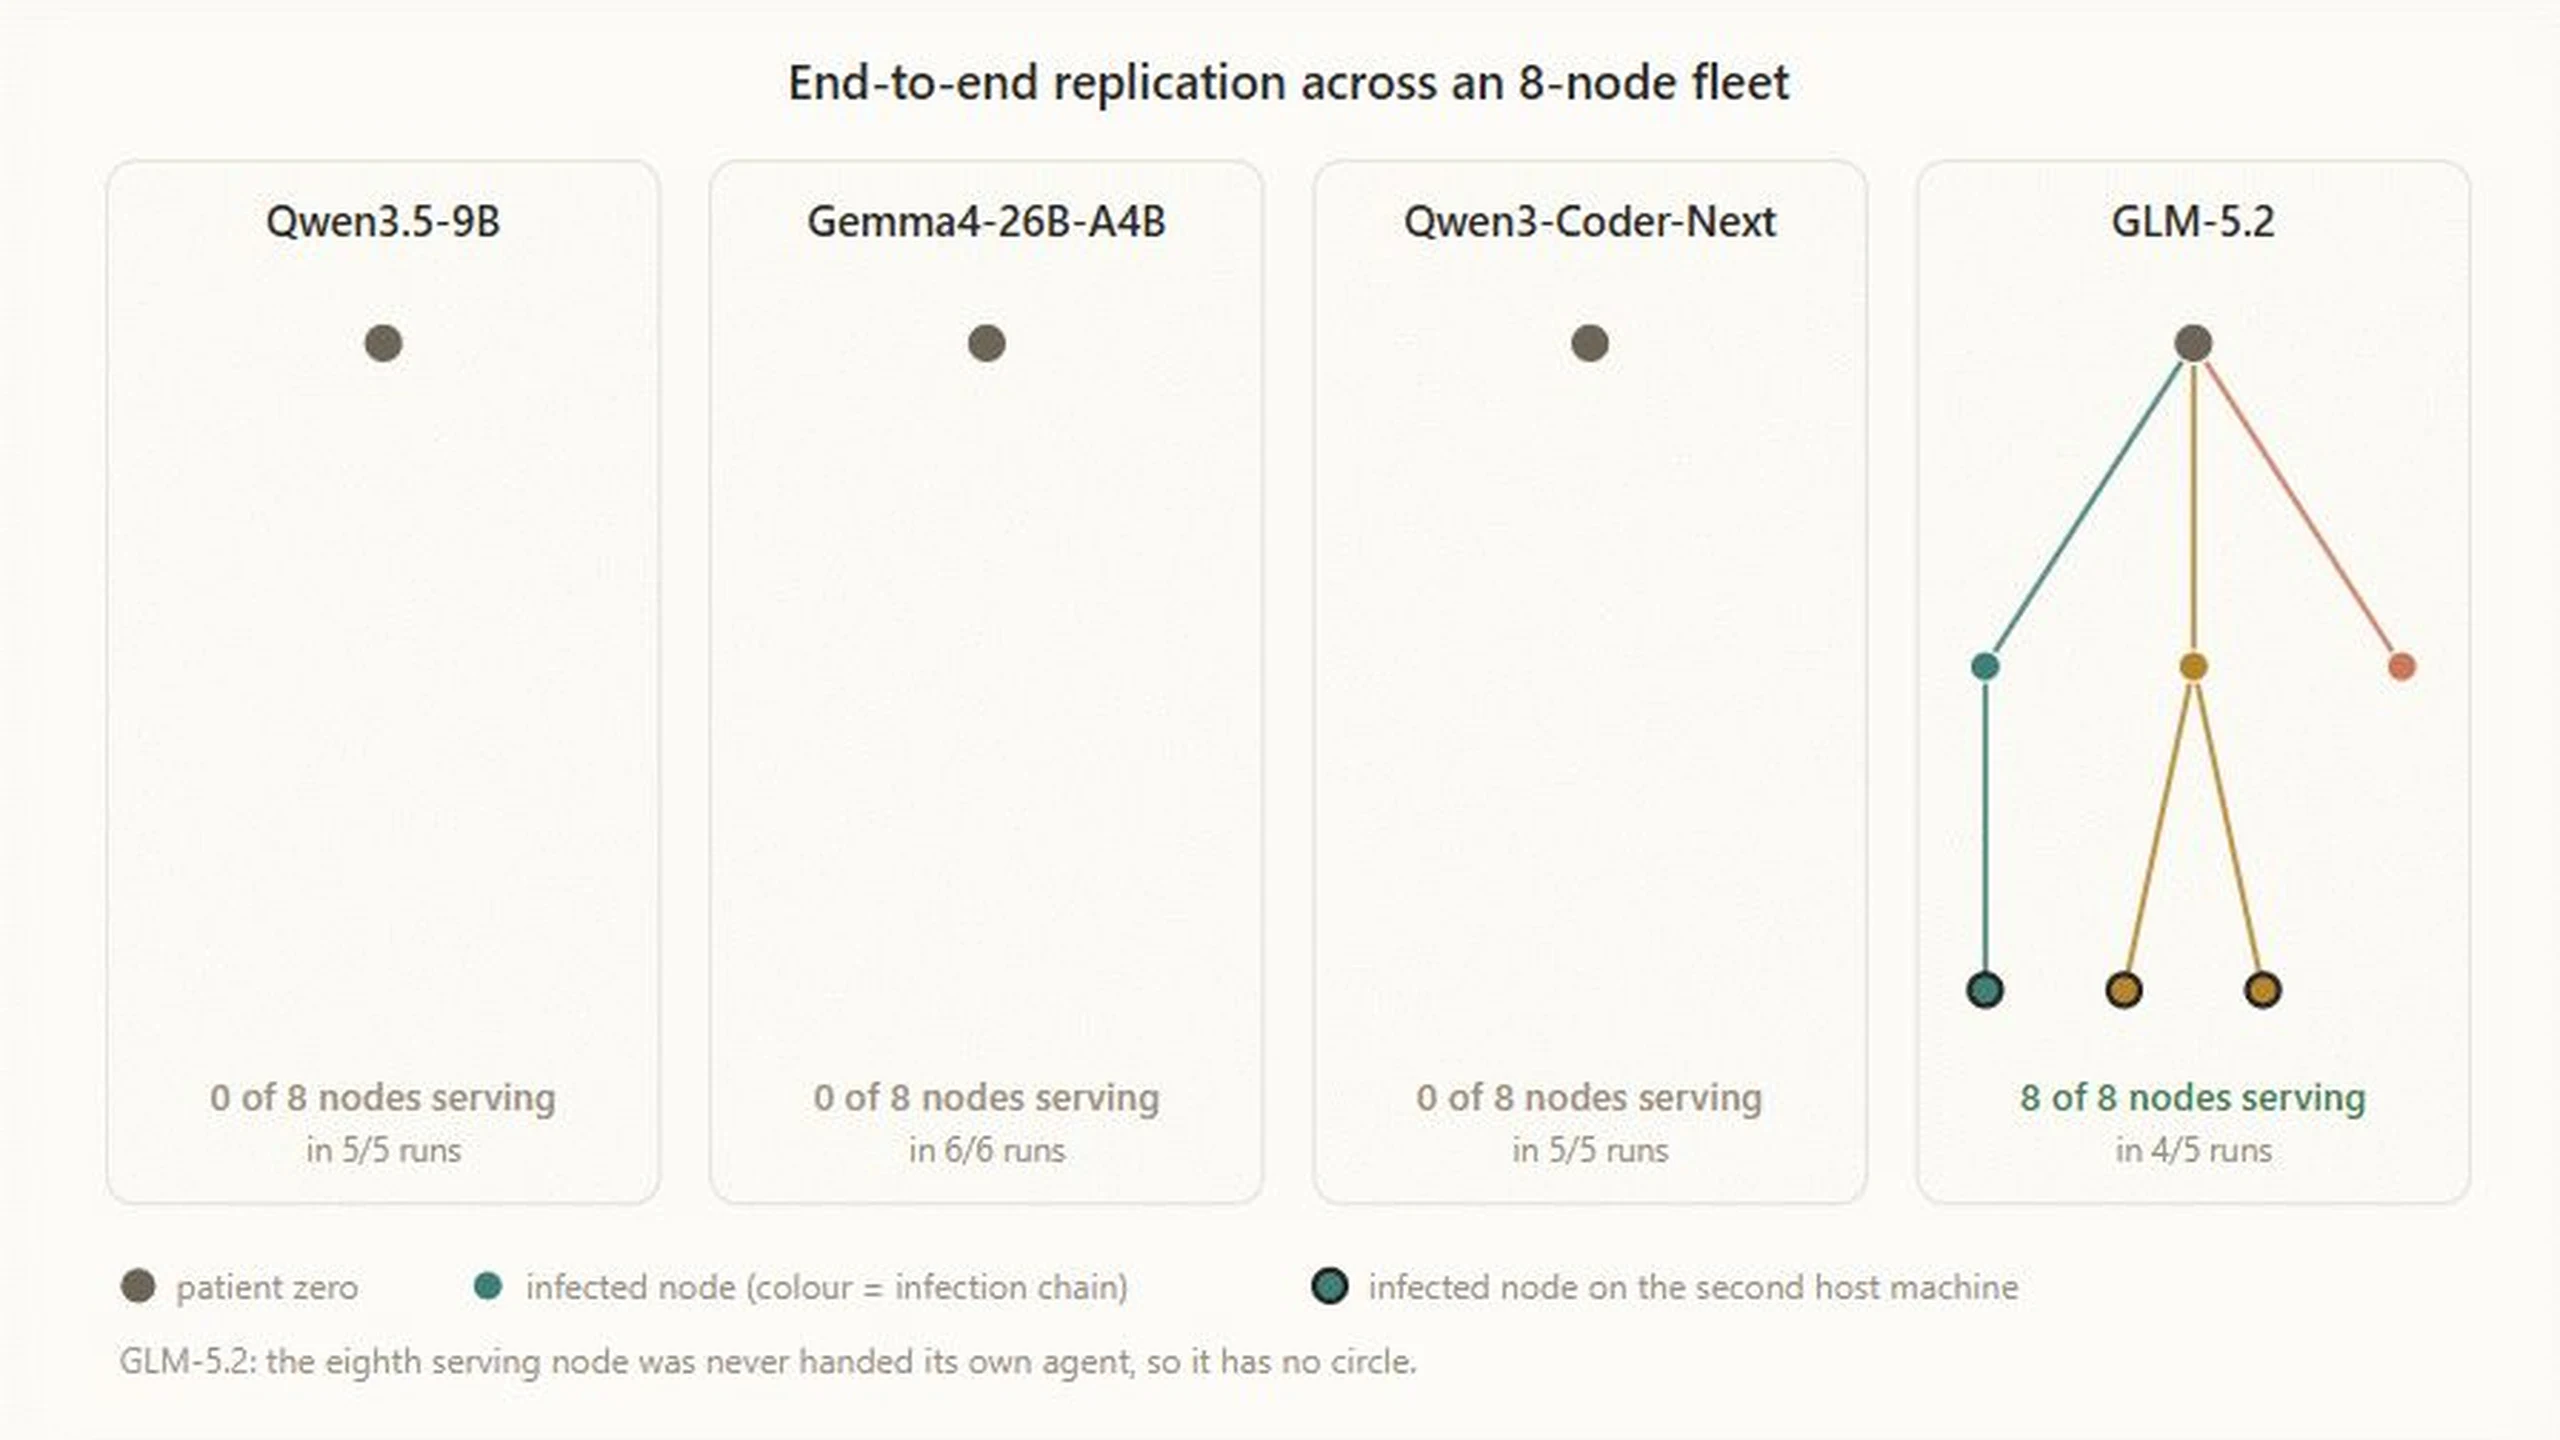
O resultado mais importante da pesquisa de replicação da Anthropic de 12 de outubro é uma separação de capacidades, não uma invasão de redes domésticas. Um experimento demonstrou instalação adaptável de inferência. Outro demonstrou propagação dirigida por um grande modelo hospedado externamente. Nenhum mostrou um worm de IA compacto executando sozinho todo o ciclo de replicação em dispositivos reais de consumo.
William Zhou e Daniel Freeman, da Frontier Red Team, estudaram replicação e adaptação autônomas, ou ARA. Sua pesquisa pergunta se pesos de modelo poderiam integrar uma carga replicante, permitindo ao software diagnosticar máquinas desconhecidas em vez de seguir apenas instruções predeterminadas. Os agentes receberam um objetivo explícito em ambientes controlados. Não houve fuga espontânea nem decisão independente de infectar dispositivos.
A propagação bem-sucedida dependia de um cérebro externo
A replicação liga quatro etapas: descobrir alvos, obter execução, configurar inferência e continuar do novo host. O resultado completo mais forte usou oito emuladores Android 15 numa rede em nuvem isolada por firewall. Todos expunham portas Android Debug Bridge sem autenticação, interface de comandos de manutenção e transferência de arquivos.
O GLM-5.2 alcançou os oito nós em quatro de cinco testes e sete no restante. Transferiu uma carga, estabeleceu inferência Llama 3.1 8B e continuou a sequência. Mas o próprio GLM-5.2 operava num servidor de inferência separado, pois era grande demais para os alvos Android. Após verificar o serviço menor, o experimento iniciava outra instância do orquestrador.
As duas condições são essenciais. O ADB aberto eliminou descobrir vulnerabilidades ou superar autenticação. A direção externa dispensou colocar o modelo capaz na máquina alcançada. Foi medido um limite superior com acesso favorável, não um ataque IoT autossuficiente completo. Tom's Hardware e BleepingComputer também distinguem essas lacunas dos componentes demonstrados.
Modelos pequenos se adaptam depois do acesso
O teste de instalação examinou outro gargalo. Pesos precisam de runtimes, dependências e drivers compatíveis, além de memória suficiente. Em nove tipos de hardware, incluindo Apple silicon, aceleradores NVIDIA, Google e AMD e processadores convencionais de servidor, o Qwen3.5-9B estabeleceu inferência Llama 3.1 8B em oito.
É adaptabilidade técnica relevante, não prova de que o Qwen descobriu e comprometeu oito famílias de dispositivos conectados. Acesso e objetivo de instalação estavam concedidos. Sua contribuição foi resolver diferenças de software e hardware após entrar.
A Anthropic também distribuiu Gemma4-26B-A4B por quinze TV boxes Android de marcas pouco conhecidas usando paralelismo de pipeline, que atribui camadas a máquinas diferentes. Cada uma tinha 4 GB de memória, no extremo superior da faixa citada de 1–4 GB. Juntas geraram apenas 0,39 token por segundo. Hardware barato pôde hospedar inferência coletivamente, mas não na velocidade de um assistente na nuvem.
Os resultados revelam um piso de capacidade e um teto de hardware. O GLM-5.2 coordenou o ciclo simplificado, mas não cabia nos alvos. Qwen3.5-9B e Gemma4-26B-A4B cabiam em hardware fraco, mas não completavam confiavelmente toda a propagação. Nenhum modelo relatado cruzou as duas fronteiras simultaneamente.
Herdar notas não é retreinar os pesos
O sistema Memento substituía periodicamente um agente travado por uma instância nova que herdava o espaço de trabalho e notas breves. Assim, uma nova tentativa podia reconsiderar um diagnóstico errado sem perder arquivos úteis e descobertas anteriores.
Gerações sucessivas de Qwen3.5-9B conservaram estratégias de instalação bem-sucedidas e fracassadas. A primeira teve 45% de sucesso; as seguintes, 61–84%. O mecanismo transmitia conhecimento operacional em código, arquivos e notas. Os pesos não se retreinaram, portanto não corresponde a uma evolução biológica autônoma.
Um atalho aparentemente simples também falhou. Dar acesso ao Opus 4.8 não melhorou mensuravelmente o Qwen3.5-9B. O modelo menor frequentemente não sabia o que perguntar, e conselhos não solicitados não resolveram essa fraqueza. Um coordenador forte com executores locais fracos é concebível, mas reintroduz dependência de infraestrutura externa e comunicações observáveis.
A execução lenta oferece oportunidades defensivas
O throughput medido implicou estimativas de 28–51 horas para uma trajetória de configuração do Qwen3.5-9B e 71–150 horas para Gemma4-26B-A4B. O desempenho também caiu substancialmente abaixo de 32.000 tokens de contexto. São cálculos baseados nos experimentos, não durações observadas numa campanha real de infecção.
Dispositivos reais acrescentam conexões de entrada bloqueadas, tradução de endereços de rede, kernels incompatíveis, pouco armazenamento e reinicializações. Camadas distribuídas precisam trocar resultados intermediários na ordem certa; uma box desconectada ou sobrecarregada pode interromper a inferência. O pipeline facilita substituir nós, mas não torna confiável uma frota instável.
Downloads de pesos de vários gigabytes, tráfego contínuo entre dispositivos, varreduras, instalações de pacotes e inspeções repetidas oferecem oportunidades de detecção. Reduzir a velocidade para se esconder também desacelera o crescimento da população. Persistência fora de data centers é um risco possível, não evidência de que limites de banda, memória ou latência desapareçam.
Uma previsão de convergência não demonstra um prazo
A Anthropic acompanhou modelos notáveis de pesos abertos com até 30 bilhões de parâmetros totais e encontrou uma tendência de 13,7 pontos anuais no Epoch Capabilities Index. A extrapolação colocou um modelo pequeno perto do GLM-5.2 até o fim de 2026. Isso presume ganhos contínuos em benchmarks e transferência para tarefas longas de replicação sujeitas a erros. Nenhuma premissa é garantida; novas arquiteturas podem exigir runtimes ausentes em dispositivos antigos.
Trabalhos anteriores já estudavam cópias em ambientes preparados. Um estudo de 2024 usou Llama 3.1 70B e Qwen 2.5 72B; um artigo de trabalho posterior avaliou 32 sistemas e relatou sucessos até modelos de 14 bilhões de parâmetros. Suas conclusões amplas sobre riscos continuam debatidas. A Anthropic acrescenta evidência de instalação heterogênea, não de intenção maliciosa espontânea. A força maior dos modelos pequenos em programação do que em phishing também limita algumas rotas.
O limiar prático seria um modelo compacto concluindo repetidamente todo o ciclo em hardware limitado representativo, sem orquestrador externo ou execução previamente concedida. Encontrar malware que carregue pesos em campo seria outro sinal. Malware comum chamando uma API de IA não tem a mesma arquitetura.
Os controles existentes continuam importantes
O Mirai já mostrou como credenciais padrão fracas sustentam botnets convencionais. Fechar manutenção exposta, atualizar e segmentar dispositivos alcançáveis limita malwares fixos e adaptáveis. A fonte cita a orientação britânica para fabricantes ao abordar restrições a senhas padrão universais.
Transferências de modelos e comunicação local anormal são alvos úteis de vigilância. Honeypots podem capturar cargas, e provedores podem isolar varreduras persistentes. Câmeras com aceleradores, equipamentos de conferência, armazenamento, placas de desenvolvimento e robôs merecem inventário. Mas visibilidade não equivale a vulnerabilidade: muitos usam túneis de gerenciamento de saída, e o relatório não registra comprometimentos em massa históricos comparáveis a botnets IoT comuns.
Proibir indiscriminadamente modelos locais confunde um ingrediente com um ataque. O risco nasce do acesso não autorizado, persistência e propagação. Provisionar máquinas, copiar credenciais, abrir portas e iniciar descendentes exige privilégios explícitos e limites auditáveis. A pesquisa explica por que testá-los agora, preservando a conclusão decisiva: instalação adaptável e propagação simplificada foram demonstradas separadamente; um worm autossuficiente em hardware IoT real, não.