
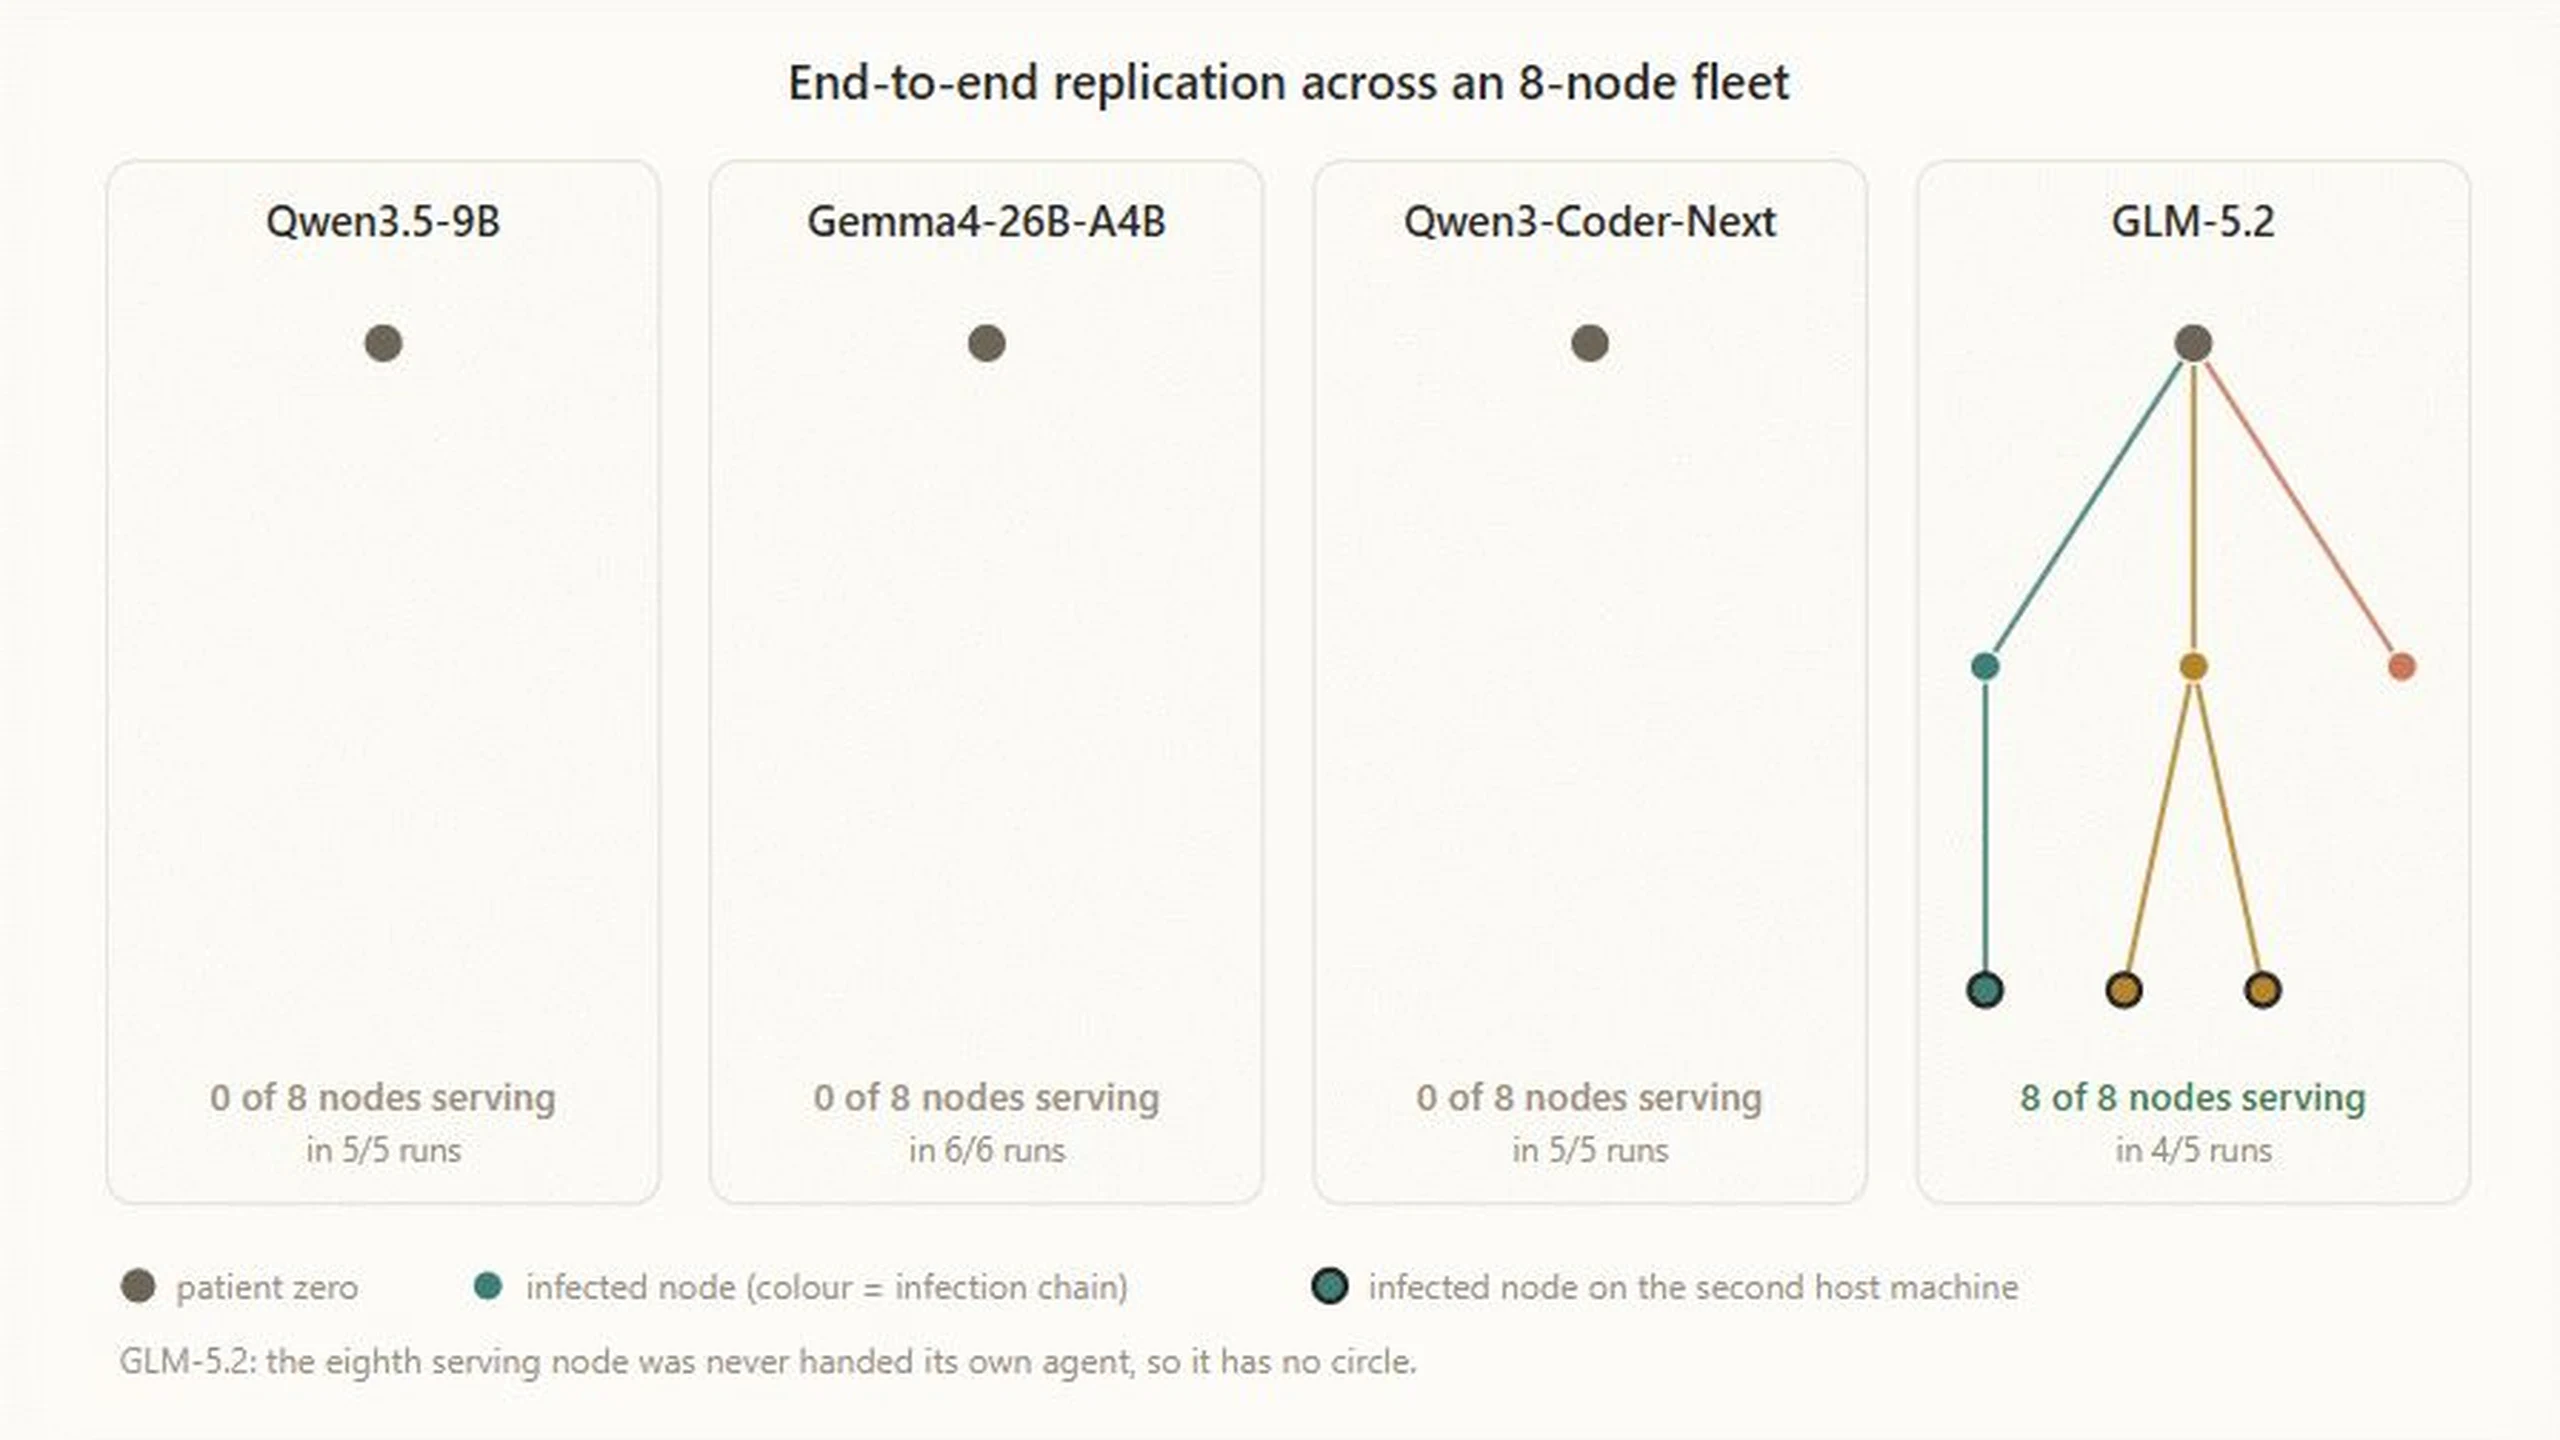
Il risultato più importante della ricerca Anthropic del 12 ottobre è una separazione delle capacità, non l’ingresso nelle reti domestiche. Un esperimento dimostra un’installazione adattabile dell’inferenza. Un altro mostra propagazione diretta da un grande modello ospitato esternamente. Nessuno mostra un worm IA compatto che esegue da solo l’intero ciclo di replicazione su veri dispositivi consumer.
William Zhou e Daniel Freeman del Frontier Red Team studiano replicazione e adattamento autonomi, ARA. La loro ricerca chiede se i pesi possano entrare in un payload replicante, consentendo al software di risolvere problemi su macchine sconosciute anziché seguire solo istruzioni prestabilite. Gli agenti hanno ricevuto un obiettivo esplicito in ambienti controllati. Non si è trattato di una fuga spontanea né della decisione indipendente di infettare dispositivi.
La propagazione riuscita richiedeva un cervello esterno
La replicazione collega quattro fasi: scoprire obiettivi, ottenere esecuzione, configurare inferenza e proseguire dal nuovo host. Il risultato completo più forte ha usato otto emulatori Android 15 in una rete cloud isolata da firewall. Tutti esponevano porte Android Debug Bridge senza autenticazione, un’interfaccia per manutenzione e trasferimento di file.
GLM-5.2 ha raggiunto tutti gli otto nodi in quattro prove su cinque e sette nell’ultima. Ha trasferito un payload, stabilito l’inferenza Llama 3.1 8B e continuato la sequenza. Ma GLM-5.2 stesso funzionava tramite un server di inferenza separato perché troppo grande per gli obiettivi Android. Dopo la verifica del servizio minore, l’esperimento avviava un’altra istanza dell’orchestratore.
Entrambe le condizioni sono essenziali. L’ADB aperto eliminava la ricerca di vulnerabilità o il superamento dell’autenticazione. La regia esterna evitava che il modello capace dovesse entrare nella macchina raggiunta. È un limite superiore con accesso favorevole, non un attacco IoT autosufficiente completo. Anche Tom's Hardware e BleepingComputer distinguono questi limiti dai componenti dimostrati.
I piccoli modelli si adattano dopo l’accesso
La prova d’installazione affrontava un’altra strozzatura. I pesi richiedono runtime, dipendenze e driver compatibili, oltre a memoria sufficiente. Su nove tipi di hardware, comprendenti Apple silicon, acceleratori NVIDIA, Google e AMD e processori server convenzionali, Qwen3.5-9B ha stabilito inferenza Llama 3.1 8B su otto.
È adattabilità tecnica significativa, non la prova che Qwen abbia scoperto e compromesso otto famiglie di dispositivi connessi. Accesso e obiettivo d’installazione erano forniti. Il contributo consisteva nel risolvere differenze software e hardware dopo l’ingresso.
Anthropic ha distribuito anche Gemma4-26B-A4B su quindici TV box Android di marche poco note. Il parallelismo a pipeline assegnava diversi strati del modello a macchine diverse. Ogni box aveva 4 GB di memoria, al limite superiore della fascia citata di 1–4 GB. Insieme generavano soltanto 0,39 token al secondo. Hardware economico poteva ospitare collettivamente inferenza, ma non alla velocità di un assistente cloud.
I risultati rivelano una soglia minima di capacità e un tetto hardware. GLM-5.2 coordinava il ciclo semplificato ma non entrava negli obiettivi. Qwen3.5-9B e Gemma4-26B-A4B entravano nell’hardware debole, ma non completavano affidabilmente l’intera propagazione. Nessun modello riportato superava entrambe le soglie insieme.
Ereditare appunti non significa riaddestrare i pesi
Il sistema Memento sostituiva periodicamente un agente bloccato con un’istanza nuova che ereditava spazio di lavoro e appunti concisi. Un nuovo tentativo poteva riconsiderare una diagnosi sbagliata senza perdere file utili e scoperte precedenti.
Generazioni successive di Qwen3.5-9B conservavano strategie d’installazione riuscite e fallite. La prima aveva successo nel 45% dei casi; le successive nel 61–84%. Il meccanismo trasmetteva conoscenze operative tramite codice, file e note. I pesi non si riaddestravano da soli: descriverlo come evoluzione biologica autonoma sarebbe scorretto.
Anche una scorciatoia apparentemente semplice non ha funzionato. L’accesso a Opus 4.8 non migliorava misurabilmente Qwen3.5-9B. Il modello piccolo spesso non riconosceva quale domanda porre, e i consigli non richiesti non risolvevano la debolezza. Un coordinatore forte con esecutori locali deboli resta concepibile, ma reintroduce dipendenza da infrastrutture esterne e comunicazioni osservabili.
La lentezza crea opportunità difensive
Il throughput misurato implicava stime di 28–51 ore per un percorso di configurazione Qwen3.5-9B e 71–150 ore per Gemma4-26B-A4B. Anche le prestazioni diminuivano sensibilmente sotto 32.000 token di contesto. Sono calcoli basati sugli esperimenti, non durate osservate in una vera campagna d’infezione.
I dispositivi reali aggiungono connessioni in entrata bloccate, traduzione degli indirizzi, kernel incompatibili, poco spazio e riavvii. Gli strati distribuiti devono scambiare risultati intermedi nell’ordine corretto; un box scollegato o sovraccarico può interrompere l’inferenza. La pipeline facilita la sostituzione dei nodi, ma non rende affidabile una flotta instabile.
Download di pesi da diversi gigabyte, traffico continuo tra dispositivi, scansioni, installazioni di pacchetti e controlli hardware ripetuti offrono occasioni di rilevamento. Rallentare per nascondersi rallenta anche la crescita della popolazione. La persistenza fuori dai data center è un rischio possibile, non la scomparsa dei limiti di banda, memoria e latenza.
Una previsione di convergenza non è una scadenza dimostrata
Anthropic ha seguito modelli open-weight rilevanti con non più di 30 miliardi di parametri totali, individuando una tendenza di 13,7 punti annui nell’Epoch Capabilities Index. L’estrapolazione avvicina un piccolo modello a GLM-5.2 entro fine 2026. Presuppone continui progressi nei benchmark e trasferimento a compiti di replicazione lunghi e soggetti a errori. Nessuna ipotesi è garantita; nuove architetture possono richiedere runtime assenti sui vecchi dispositivi.
Lavori precedenti studiavano già copie in ambienti preparati. Uno studio del 2024 usava Llama 3.1 70B e Qwen 2.5 72B; un successivo documento di lavoro valutava 32 sistemi e riportava successi fino a modelli da 14 miliardi di parametri. Le conclusioni generali sul rischio restano dibattute. Anthropic aggiunge prove di installazione eterogenea, non di intenzione maligna spontanea. La forza dei piccoli modelli nella programmazione rispetto al phishing limita inoltre alcune vie di propagazione.
La soglia pratica sarebbe un modello compatto che completi ripetutamente tutto il ciclo su hardware limitato rappresentativo, senza orchestratore esterno né esecuzione già concessa. Malware che trasporta pesi trovato nel mondo reale sarebbe un altro segnale. Un malware ordinario che chiama un’API IA non ha la stessa architettura.
I controlli esistenti rimangono importanti
Mirai ha già mostrato come credenziali predefinite deboli sostengano botnet convenzionali. Chiudere accessi di manutenzione esposti, aggiornare e segmentare dispositivi raggiungibili limita malware fissi e adattabili. La fonte cita le linee guida britanniche per i produttori sulle restrizioni alle password predefinite universali.
Trasferimenti di modelli e comunicazioni locali anomale sono utili bersagli di monitoraggio. Gli honeypot possono catturare payload e i provider isolare scansioni persistenti. Telecamere accelerate, apparecchi per conferenze, storage, schede di sviluppo e robot meritano un inventario. Visibilità non significa però vulnerabilità: molti usano tunnel di gestione in uscita, e il rapporto non registra compromissioni massive storiche comparabili alle normali botnet IoT.
Vietare indiscriminatamente i modelli locali confonde un ingrediente con un attacco. Il rischio nasce da accesso non autorizzato, persistenza e propagazione. Provisioning, copia di credenziali, apertura di porte e avvio di discendenti richiedono privilegi espliciti e limiti verificabili. La ricerca spiega perché testarli ora, conservando la conclusione decisiva: installazione adattabile e propagazione semplificata sono state dimostrate separatamente; un worm autosufficiente su vero hardware IoT non lo è stato.