
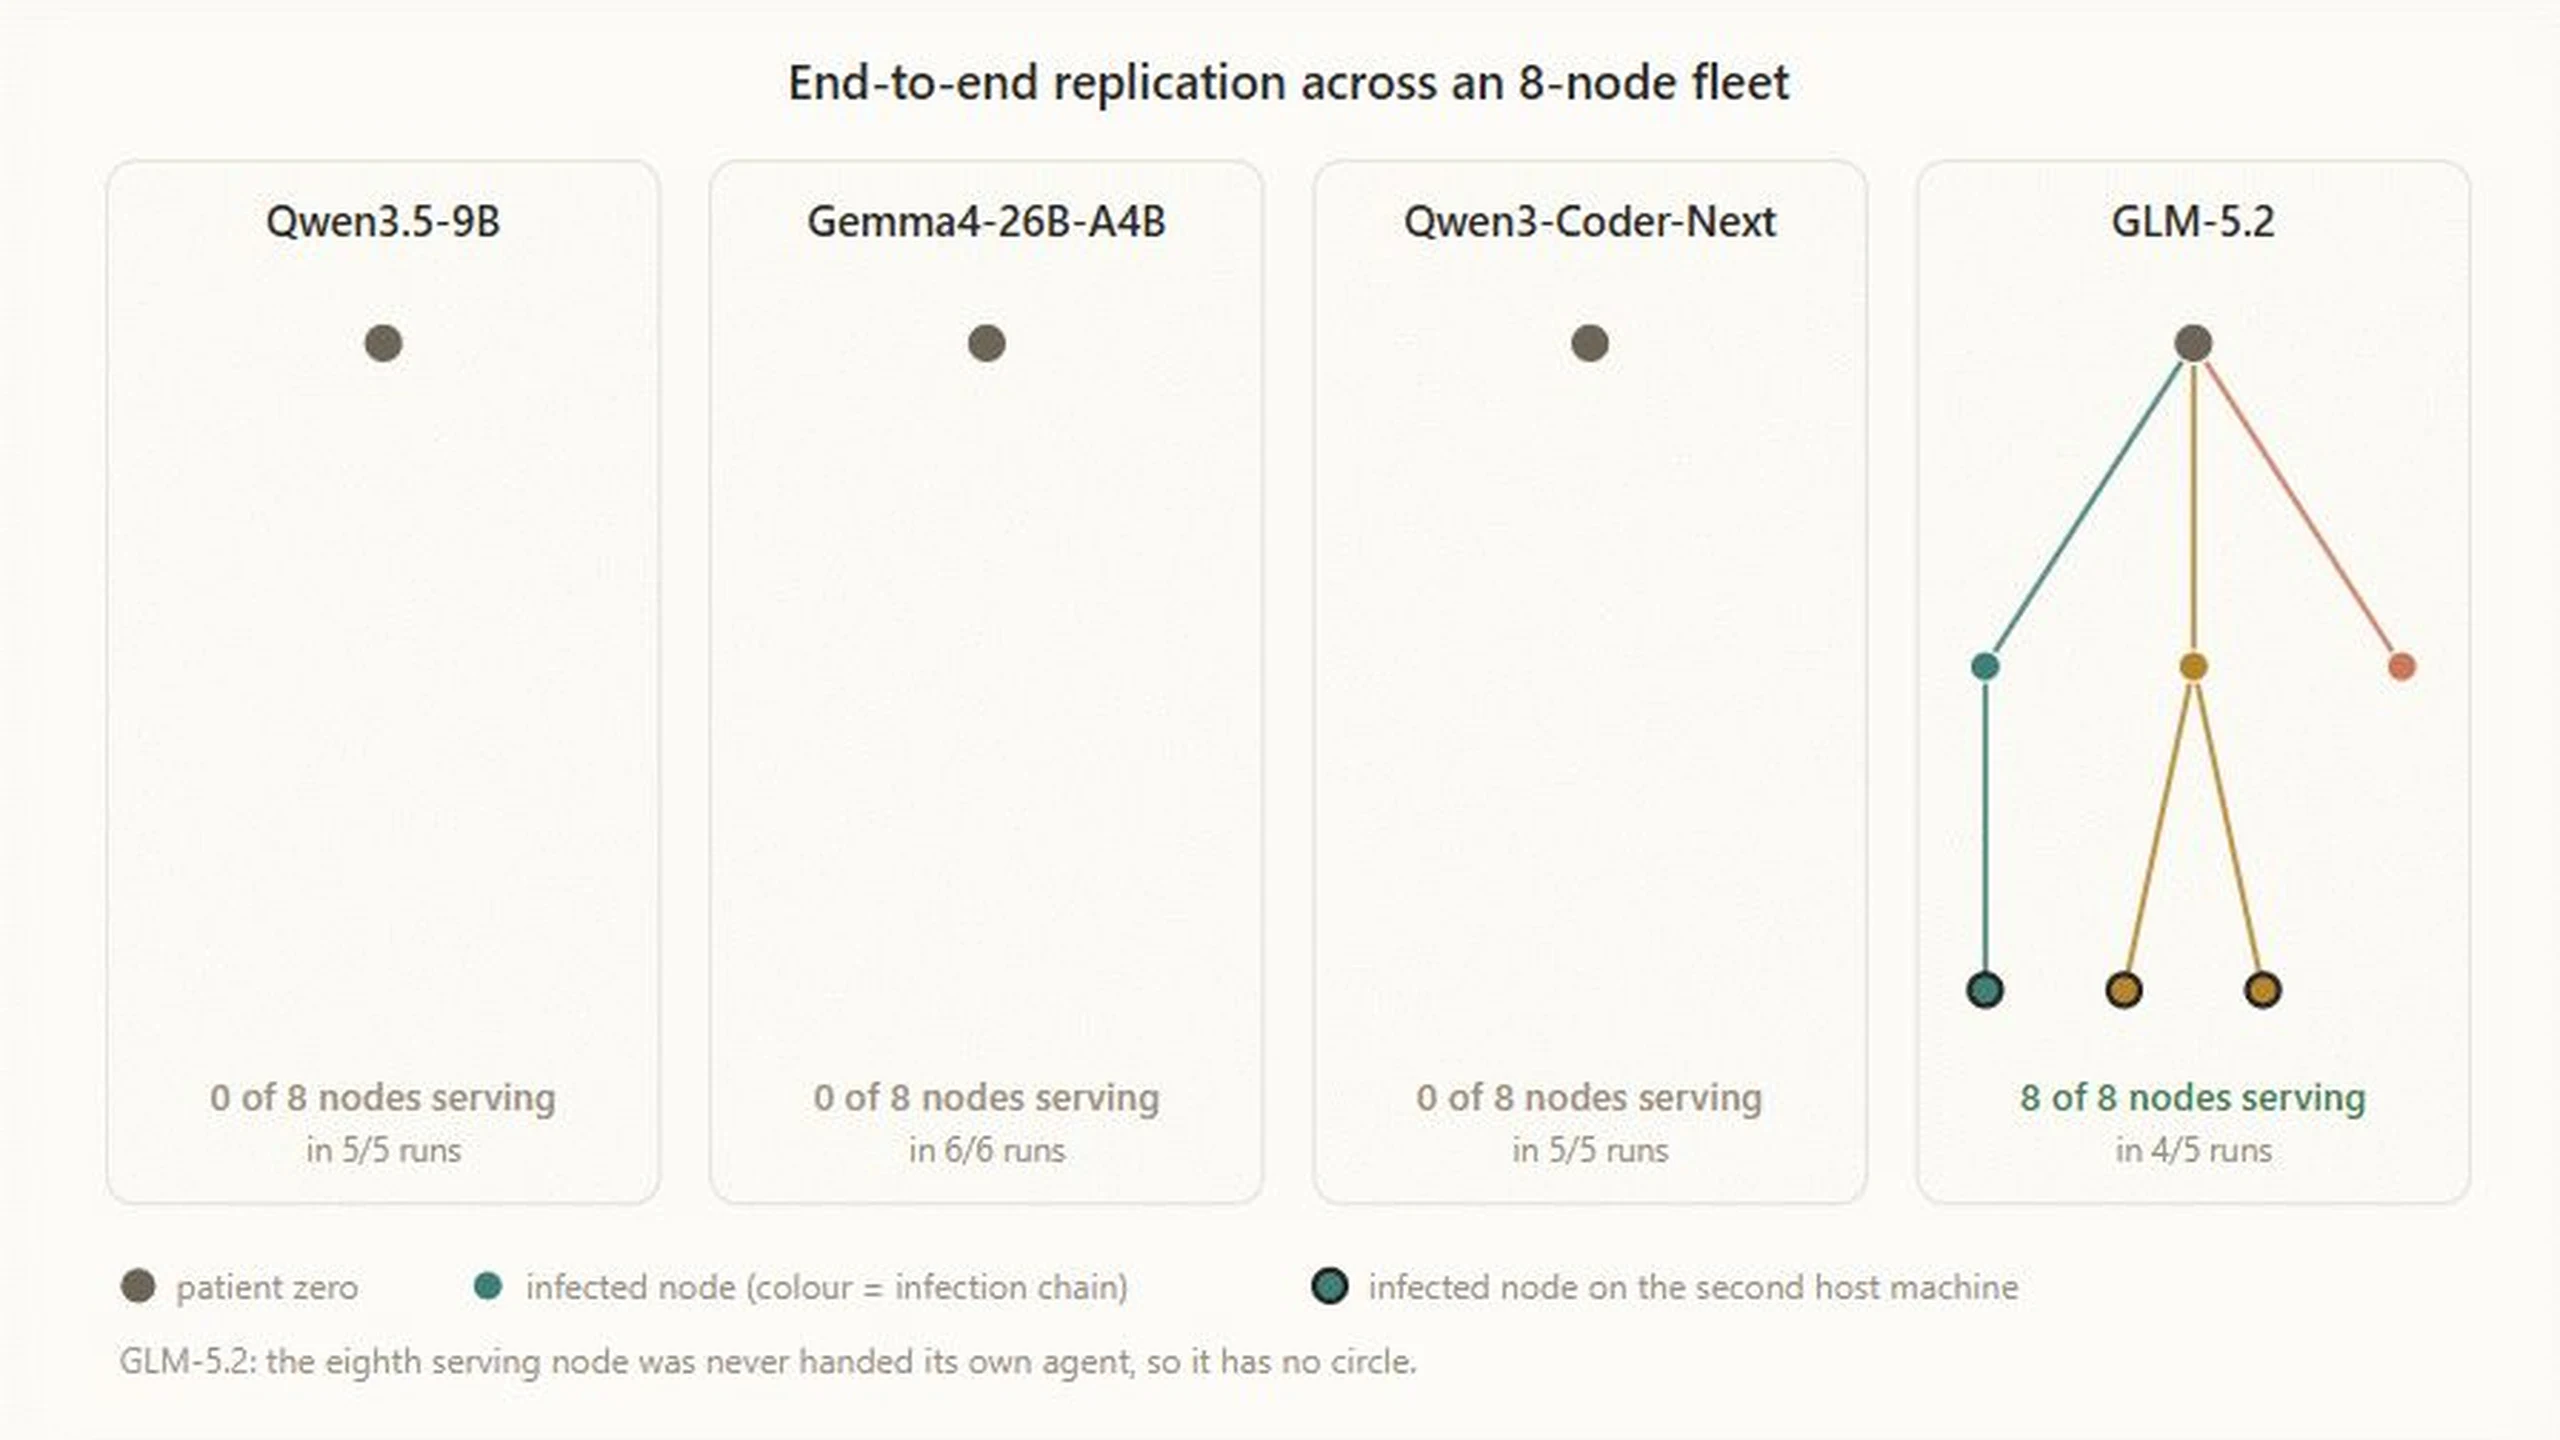
Najważniejszym wynikiem badań Anthropic z 12 października jest rozdzielenie zdolności, a nie przełamanie zabezpieczeń sieci domowych. Jeden eksperyment pokazał adaptacyjną instalację inferencji. Inny wykazał propagację kierowaną przez duży model działający poza urządzeniami. Żaden nie pokazał małego robaka AI samodzielnie wykonującego cały cykl replikacji na rzeczywistym sprzęcie konsumenckim.
William Zhou i Daniel Freeman z Frontier Red Team badali autonomiczną replikację i adaptację, ARA. Ich praca pyta, czy wagi modelu mogą stać się częścią replikującego się ładunku, pozwalając oprogramowaniu diagnozować obce maszyny zamiast wykonywać jedynie zaplanowane instrukcje. Agenci dostali wyraźny cel w kontrolowanych środowiskach. Nie była to samorzutna ucieczka ani niezależna decyzja o infekowaniu urządzeń.
Udana propagacja potrzebowała zewnętrznego mózgu
Replikacja obejmuje cztery powiązane etapy: znalezienie celów, uzyskanie wykonania kodu, skonfigurowanie inferencji i dalszą propagację z nowego hosta. Najmocniejszy wynik całego procesu uzyskano na ośmiu emulatorach Androida 15 w sieci chmurowej odizolowanej zaporą. Wszystkie udostępniały nieuwierzytelnione porty Android Debug Bridge do poleceń serwisowych i przesyłania plików.
GLM-5.2 dotarł do wszystkich ośmiu węzłów w czterech z pięciu prób, a do siedmiu w ostatniej. Przesyłał ładunek, uruchamiał inferencję Llama 3.1 8B i kontynuował sekwencję. Sam GLM-5.2 działał jednak przez oddzielny serwer inferencyjny, ponieważ nie mieścił się na celach z Androidem. Po sprawdzeniu mniejszej usługi uruchamiano następną instancję orkiestratora.
Oba warunki są kluczowe. Otwarte ADB usuwało potrzebę szukania podatności i pokonywania uwierzytelniania. Zewnętrzne sterowanie usuwało wymóg zmieszczenia zdolnego modelu na osiągniętej maszynie. To górna granica w korzystnych warunkach dostępu, nie gotowy samodzielny atak IoT. Tom's Hardware oraz BleepingComputer także oddzielają te braki od wykazanych elementów.
Małe modele adaptują się po uzyskaniu dostępu
Test instalacji dotyczył innego ograniczenia. Same wagi potrzebują zgodnego środowiska wykonawczego, zależności, sterowników i odpowiedniej pamięci. Na dziewięciu typach sprzętu, obejmujących Apple silicon, akceleratory NVIDIA, Google i AMD oraz zwykłe procesory serwerowe, Qwen3.5-9B uruchomił Llama 3.1 8B na ośmiu.
To istotna adaptacyjność techniczna, nie dowód odkrycia i przejęcia ośmiu rodzin urządzeń internetowych. Dostęp oraz cel instalacji były zapewnione. Zdolność polegała na rozwiązaniu różnic programowych i sprzętowych już po wejściu.
Anthropic rozproszył również Gemma4-26B-A4B na piętnastu niemarkowych przystawkach Android TV. Równoległość potokowa przypisywała różne warstwy modelu różnym maszynom. Każda miała 4 GB pamięci, czyli górną granicę podanego przedziału rynkowego 1–4 GB. Łącznie generowały tylko 0,39 tokena na sekundę. Tani sprzęt mógł wspólnie obsługiwać inferencję, lecz nie z szybkością asystenta chmurowego.
Wyniki ujawniają próg zdolności i limit sprzętowy. GLM-5.2 koordynował uproszczony cykl, ale nie mieścił się na celach. Qwen3.5-9B i Gemma4-26B-A4B mieściły się na słabszym sprzęcie, ale nie kończyły niezawodnie całej propagacji. Żaden opisany model nie przekroczył obu granic jednocześnie.
Dziedziczenie notatek nie jest trenowaniem wag
Mechanizm Memento okresowo zastępował zablokowanego agenta nową instancją dziedziczącą przestrzeń roboczą i zwięzłe notatki. Pozwalało to ponownie rozważyć błędną diagnozę bez utraty użytecznych plików i wcześniejszych odkryć.
Kolejne generacje Qwen3.5-9B zachowywały udane i nieudane strategie instalacji. Pierwsza osiągała 45% sukcesów, następne 61–84%. Dziedziczono wiedzę operacyjną w kodzie, plikach i notatkach. Wagi nie trenowały się ponownie, więc opis jako biologicznej autonomicznej ewolucji byłby mylący.
Nie zadziałał też pozornie prosty skrót. Dostęp Qwen3.5-9B do Opus 4.8 nie przyniósł mierzalnej poprawy. Mały model często nie rozpoznawał, o co zapytać, a nieproszone porady nie usuwały tej słabości. Silniejszy koordynator i słabsi lokalni wykonawcy są możliwi, ale oznaczają powrót zależności od infrastruktury zewnętrznej i obserwowalnej komunikacji.
Wolne działanie daje obronie szansę
Zmierzona przepustowość sugerowała 28–51 godzin dla procesu konfiguracji Qwen3.5-9B i 71–150 godzin dla Gemma4-26B-A4B. Wydajność wyraźnie spadała też poniżej okna 32 000 tokenów. To szacunki z eksperymentów, nie czas zaobserwowany w rzeczywistej kampanii infekcyjnej.
Prawdziwe urządzenia wprowadzają blokowane połączenia przychodzące, translację adresów, niezgodne jądra, mało miejsca i restarty. Rozproszone warstwy muszą wymieniać wyniki pośrednie we właściwej kolejności. Odłączona lub przeciążona przystawka może zatrzymać inferencję. Potok ułatwia zastępowanie węzła, ale nie czyni niestabilnej floty niezawodną.
Wielogigabajtowe pobrania wag, ciągły ruch między urządzeniami, skanowanie, instalacje pakietów i powtarzane kontrole sprzętu dają okazje wykrycia. Zwolnienie dla ukrycia działań spowalnia również wzrost populacji. Trwałość poza centrum danych jest możliwym ryzykiem, nie dowodem zniknięcia ograniczeń pasma, pamięci i opóźnień.
Prognoza zbieżności nie dowodzi terminu
Anthropic śledził znane modele o otwartych wagach i maksymalnie 30 miliardach wszystkich parametrów. Trend wynosił 13,7 punktu rocznie w Epoch Capabilities Index. Ekstrapolacja zbliżała mały model do GLM-5.2 pod koniec 2026 roku. Zakłada jednak dalszą poprawę benchmarków i przeniesienie jej na długie, podatne na błędy zadania replikacji. Żadna przesłanka nie jest pewna, a nowe architektury mogą potrzebować środowisk nieobecnych na starych urządzeniach.
Wcześniejsze prace badały już kopie w przygotowanych środowiskach. Badanie z 2024 roku wykorzystywało Llama 3.1 70B i Qwen 2.5 72B. Późniejszy artykuł roboczy oceniał 32 systemy i raportował sukcesy do 14 miliardów parametrów. Szersze wnioski o ryzyku pozostają sporne. Anthropic dodaje dowody heterogenicznej instalacji, nie spontanicznej złej intencji. Przewaga małych modeli w programowaniu nad phishingiem także ogranicza część dróg propagacji.
Praktycznym progiem byłby mały model wielokrotnie kończący cały cykl na reprezentatywnym ograniczonym sprzęcie, bez zewnętrznego orkiestratora i uprzednio przyznanego wykonania. Złośliwe oprogramowanie niosące wagi znalezione w praktyce byłoby oddzielnym sygnałem. Zwykły malware wywołujący API AI nie ma tej samej architektury.
Dotychczasowe zabezpieczenia nadal mają znaczenie
Mirai pokazał już, jak słabe domyślne poświadczenia utrzymują zwykłe botnety. Usunięcie wystawionego dostępu serwisowego, aktualizacje i segmentacja osiągalnych urządzeń ograniczają malware stały i adaptacyjny. Źródło wskazuje brytyjskie wytyczne bezpieczeństwa dla producentów, omawiając ograniczenia uniwersalnych haseł domyślnych.
Warto monitorować transfery modeli i nietypową komunikację lokalną. Honeypoty mogą przechwytywać ładunki, a operatorzy izolować uporczywe skanowanie. Kamery z akceleratorami, sprzęt konferencyjny, pamięci masowe, płytki deweloperskie i roboty wymagają inwentaryzacji. Widoczność nie oznacza jednak podatności: wiele korzysta z wychodzących tuneli zarządzania, a raport nie wskazuje historycznych masowych przejęć porównywalnych ze zwykłymi botnetami IoT.
Zakaz wszystkich lokalnych modeli myli składnik z atakiem. Ryzyko tworzą nieuprawniony dostęp, trwałość i propagacja. Przydzielanie maszyn, kopiowanie poświadczeń, otwieranie portów i uruchamianie potomków wymagają jawnych uprawnień oraz audytowalnych granic. Badania uzasadniają ich testowanie teraz, zachowując rozstrzygający wniosek: adaptacyjna instalacja i uproszczona propagacja zostały pokazane osobno; samodzielny robak na prawdziwym sprzęcie IoT nie został wykazany.