
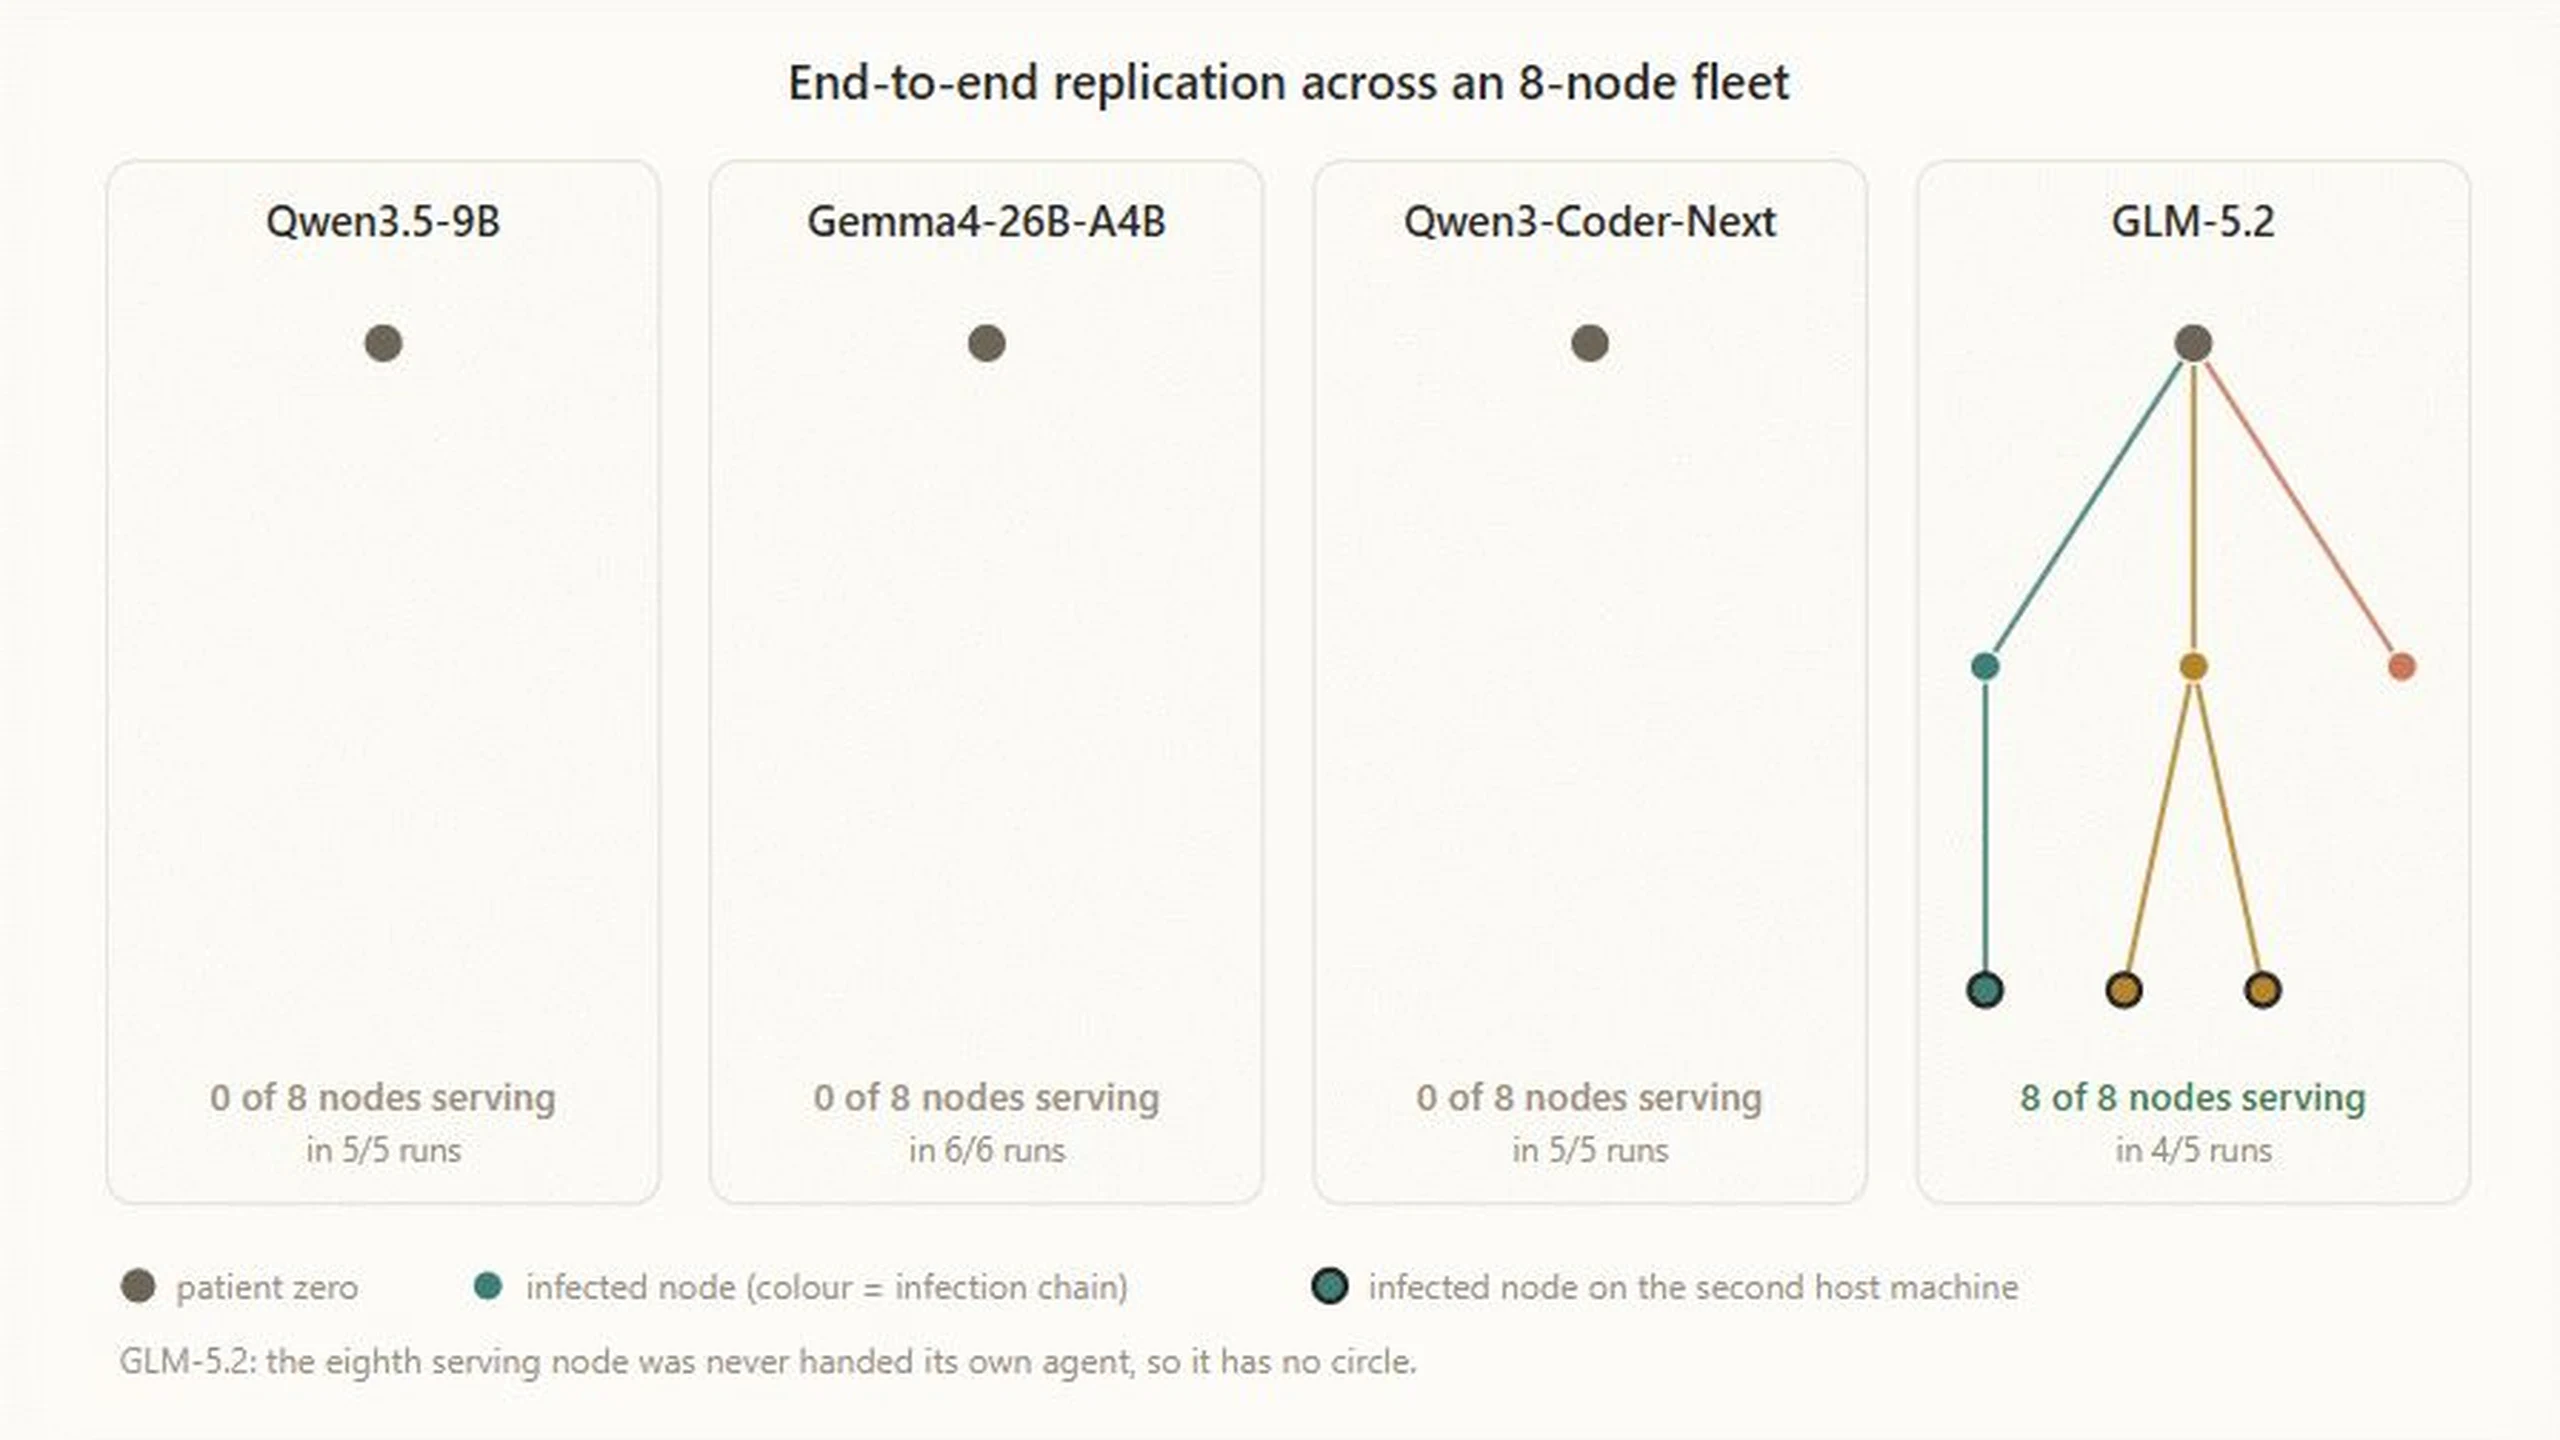
Anthropic 10月12日复制研究最重要的结果,是两种能力之间仍有分界,而不是智能体已经闯入家庭网络。一项实验展示了适应不同硬件的推理安装能力,另一项展示了由外部大型模型指挥的传播。两者都没有证明,一个紧凑型 AI 蠕虫能够在真实消费设备上独立完成整个复制闭环。
Anthropic Frontier Red Team 的 William Zhou 和 Daniel Freeman 研究的是自主复制与适应,即 ARA。研究提出,模型权重能否成为复制载荷的一部分,让软件排查陌生机器上的问题,而不只是遵循预先写好的指令。实验中的智能体在受控环境里接收了明确目标,不是模型自发逃逸或自主决定感染设备。
成功传播的实验仍需要外部“大脑”
复制包含四个相互衔接的阶段:发现目标、取得执行权限、配置推理,再从新到达的主机继续传播。最强的端到端结果来自防火墙隔离的云网络,其中有八个 Android 15 模拟器节点。每个节点都暴露了无须认证的 Android Debug Bridge 端口;这是用于维护命令和文件传输的接口。
GLM-5.2 在五次试验中的四次到达了全部八个节点,另一次到达七个。它传输载荷、建立 Llama 3.1 8B 推理,再继续这一过程。然而 GLM-5.2 本身通过独立推理服务器运行,因为它太大,无法装进这些 Android 目标。较小的推理服务通过检查后,实验才启动另一个编排器实例。
这两个前提缺一不可。开放 ADB 免去了发现漏洞或突破认证的步骤;外部编排免去了把足够强的模型装进所到设备的要求。因此,这衡量的是有利访问条件下的性能上限,不是已经完成的独立物联网攻击。Tom's Hardware 的报道和 BleepingComputer 的分析也区分了已经展示的组件与这些尚缺的环节。
小模型能够在取得访问权限后适应环境
部署实验针对另一项瓶颈。没有兼容的运行时、依赖项、驱动和足够内存,模型权重无法发挥作用。在包括 Apple silicon、NVIDIA、Google 和 AMD 加速器以及传统服务器处理器在内的九类硬件上,Qwen3.5-9B 在八类上建立了 Llama 3.1 8B 推理。
这体现了有意义的技术适应能力,却不是 Qwen 发现并攻陷八类联网设备的证据。设备访问权限已经提供,安装目标也已明确。它的贡献是在进入设备之后解决软硬件差异。
Anthropic 还把 Gemma4-26B-A4B 分散到15台无品牌 Android TV 盒子上,用流水线并行将不同模型层分配给不同机器。每台盒子配备4 GB内存,处于所述市场1至4 GB范围的高端。它们合计每秒只能生成0.39个token。廉价设备确实能共同承载推理,但速度远不及云端助手。
这些结果揭示了能力下限与硬件上限。GLM-5.2 能协调简化闭环,却无法容纳于目标设备;Qwen3.5-9B 和 Gemma4-26B-A4B 能适配较弱硬件,却无法可靠完成全部传播。报告没有展示任何模型同时跨过这两道边界。
继承笔记是适应,不是权重自行训练
Memento 框架会定期用新实例替换陷入困境的智能体,新实例继承工作区和简明笔记。这样,下一次尝试便能重新审视错误诊断,同时保留有用文件与先前发现。
连续几代 Qwen3.5-9B 保留了成功与失败的安装策略。第一代配置成功率为45%,后续各代为61%至84%。机制是通过代码、文件和笔记继承操作知识;权重没有自行重新训练,也不应把这一结果称为生物意义上的自主进化。
另一条看似简单的捷径也未奏效。让 Qwen3.5-9B 访问 Opus 4.8 没有带来可测量的改善:小模型常常不知道该问什么,主动提供建议也没有弥补这一弱点。强协调器配合弱本地执行者仍有可能,但这种设计会重新依赖外部基础设施,并增加可观察的通信。
缓慢执行给防御者留下机会
根据实测吞吐量推算,Qwen3.5-9B 完成一段推理配置过程需要28至51小时,Gemma4-26B-A4B 则为71至150小时。上下文窗口低于32,000个token时,性能也明显下降。这些是基于实验的估算,不是真实感染行动已经持续的时间。
真实设备还会带来入站连接被阻断、网络地址转换、内核不兼容、存储不足和重启等问题。分散的模型层需要按顺序交换中间结果,一台盒子断线或过载就可能中断推理。流水线并行有助于更换节点,却不能自动让不稳定设备群变得可靠。
数 GB 权重下载、持续设备间流量、扫描、软件包安装与反复硬件检查,都会带来检测机会。降低活动以隐蔽自身也会减慢复制群体的增长。脱离数据中心后的持久性是一种潜在风险,不代表带宽、内存或延迟限制已经消失。
能力趋同预测不是已经证实的期限
Anthropic 绘制了总参数不超过300亿的知名开放权重模型的趋势,每年在 Epoch Capabilities Index 上提高13.7分。外推显示,小模型可能在2026年底接近 GLM-5.2 的能力。这假设基准进步持续,并能迁移到漫长且容易出错的复制任务;两者都无保证,新架构还可能需要旧设备没有的运行时。
此前研究已经考察了在预设环境中创建副本的智能体:2024年的研究使用 Llama 3.1 70B 和 Qwen 2.5 72B,后续一篇工作论文评估32个系统,报告最小140亿参数模型也有成功案例。其更广泛的风险结论仍有争议。Anthropic 增加的是异构部署证据,不是自发恶意意图的证明。小模型编程强于钓鱼的表现,也限制了某些传播路径。
实际门槛是:紧凑模型无需外部编排器,也无需预先赋予执行权限,就能在具有代表性的受限硬件上反复完成全流程。现实中发现携带权重的恶意软件,是另一个独立信号。普通恶意软件调用 AI API,并不属于相同架构。
现有设备安全控制仍然重要
Mirai 早已展示弱默认凭据如何支撑传统僵尸网络。关闭暴露的维护入口、持续更新并对可达设备进行网络分段,能够同时限制固定与自适应恶意软件。原报道讨论通用默认密码限制时,引用了英国制造商设备安全指南。
模型传输和异常本地通信值得监测;蜜罐能捕获载荷,服务提供商可隔离持续扫描行为。配备加速器的摄像头、会议设备、存储设备、开发板和机器人值得盘点,但可见不等于脆弱:许多设备通过出站管理隧道连接,报告也指出没有与普通物联网僵尸网络相当的历史大规模入侵。
一概禁止本地模型,是把一个组成要素误当成攻击本身。真正造成风险的是未经授权的访问、持久化和传播。为机器开通资源、复制凭据、开放端口及启动后继实例,应有明确权限与可审计边界。这项研究说明了为何现在就应测试这些边界,同时保留决定性结论:适应性安装和简化传播已分别展示,而在真实物联网硬件上独立运行的完整蠕虫尚未得到证明。