
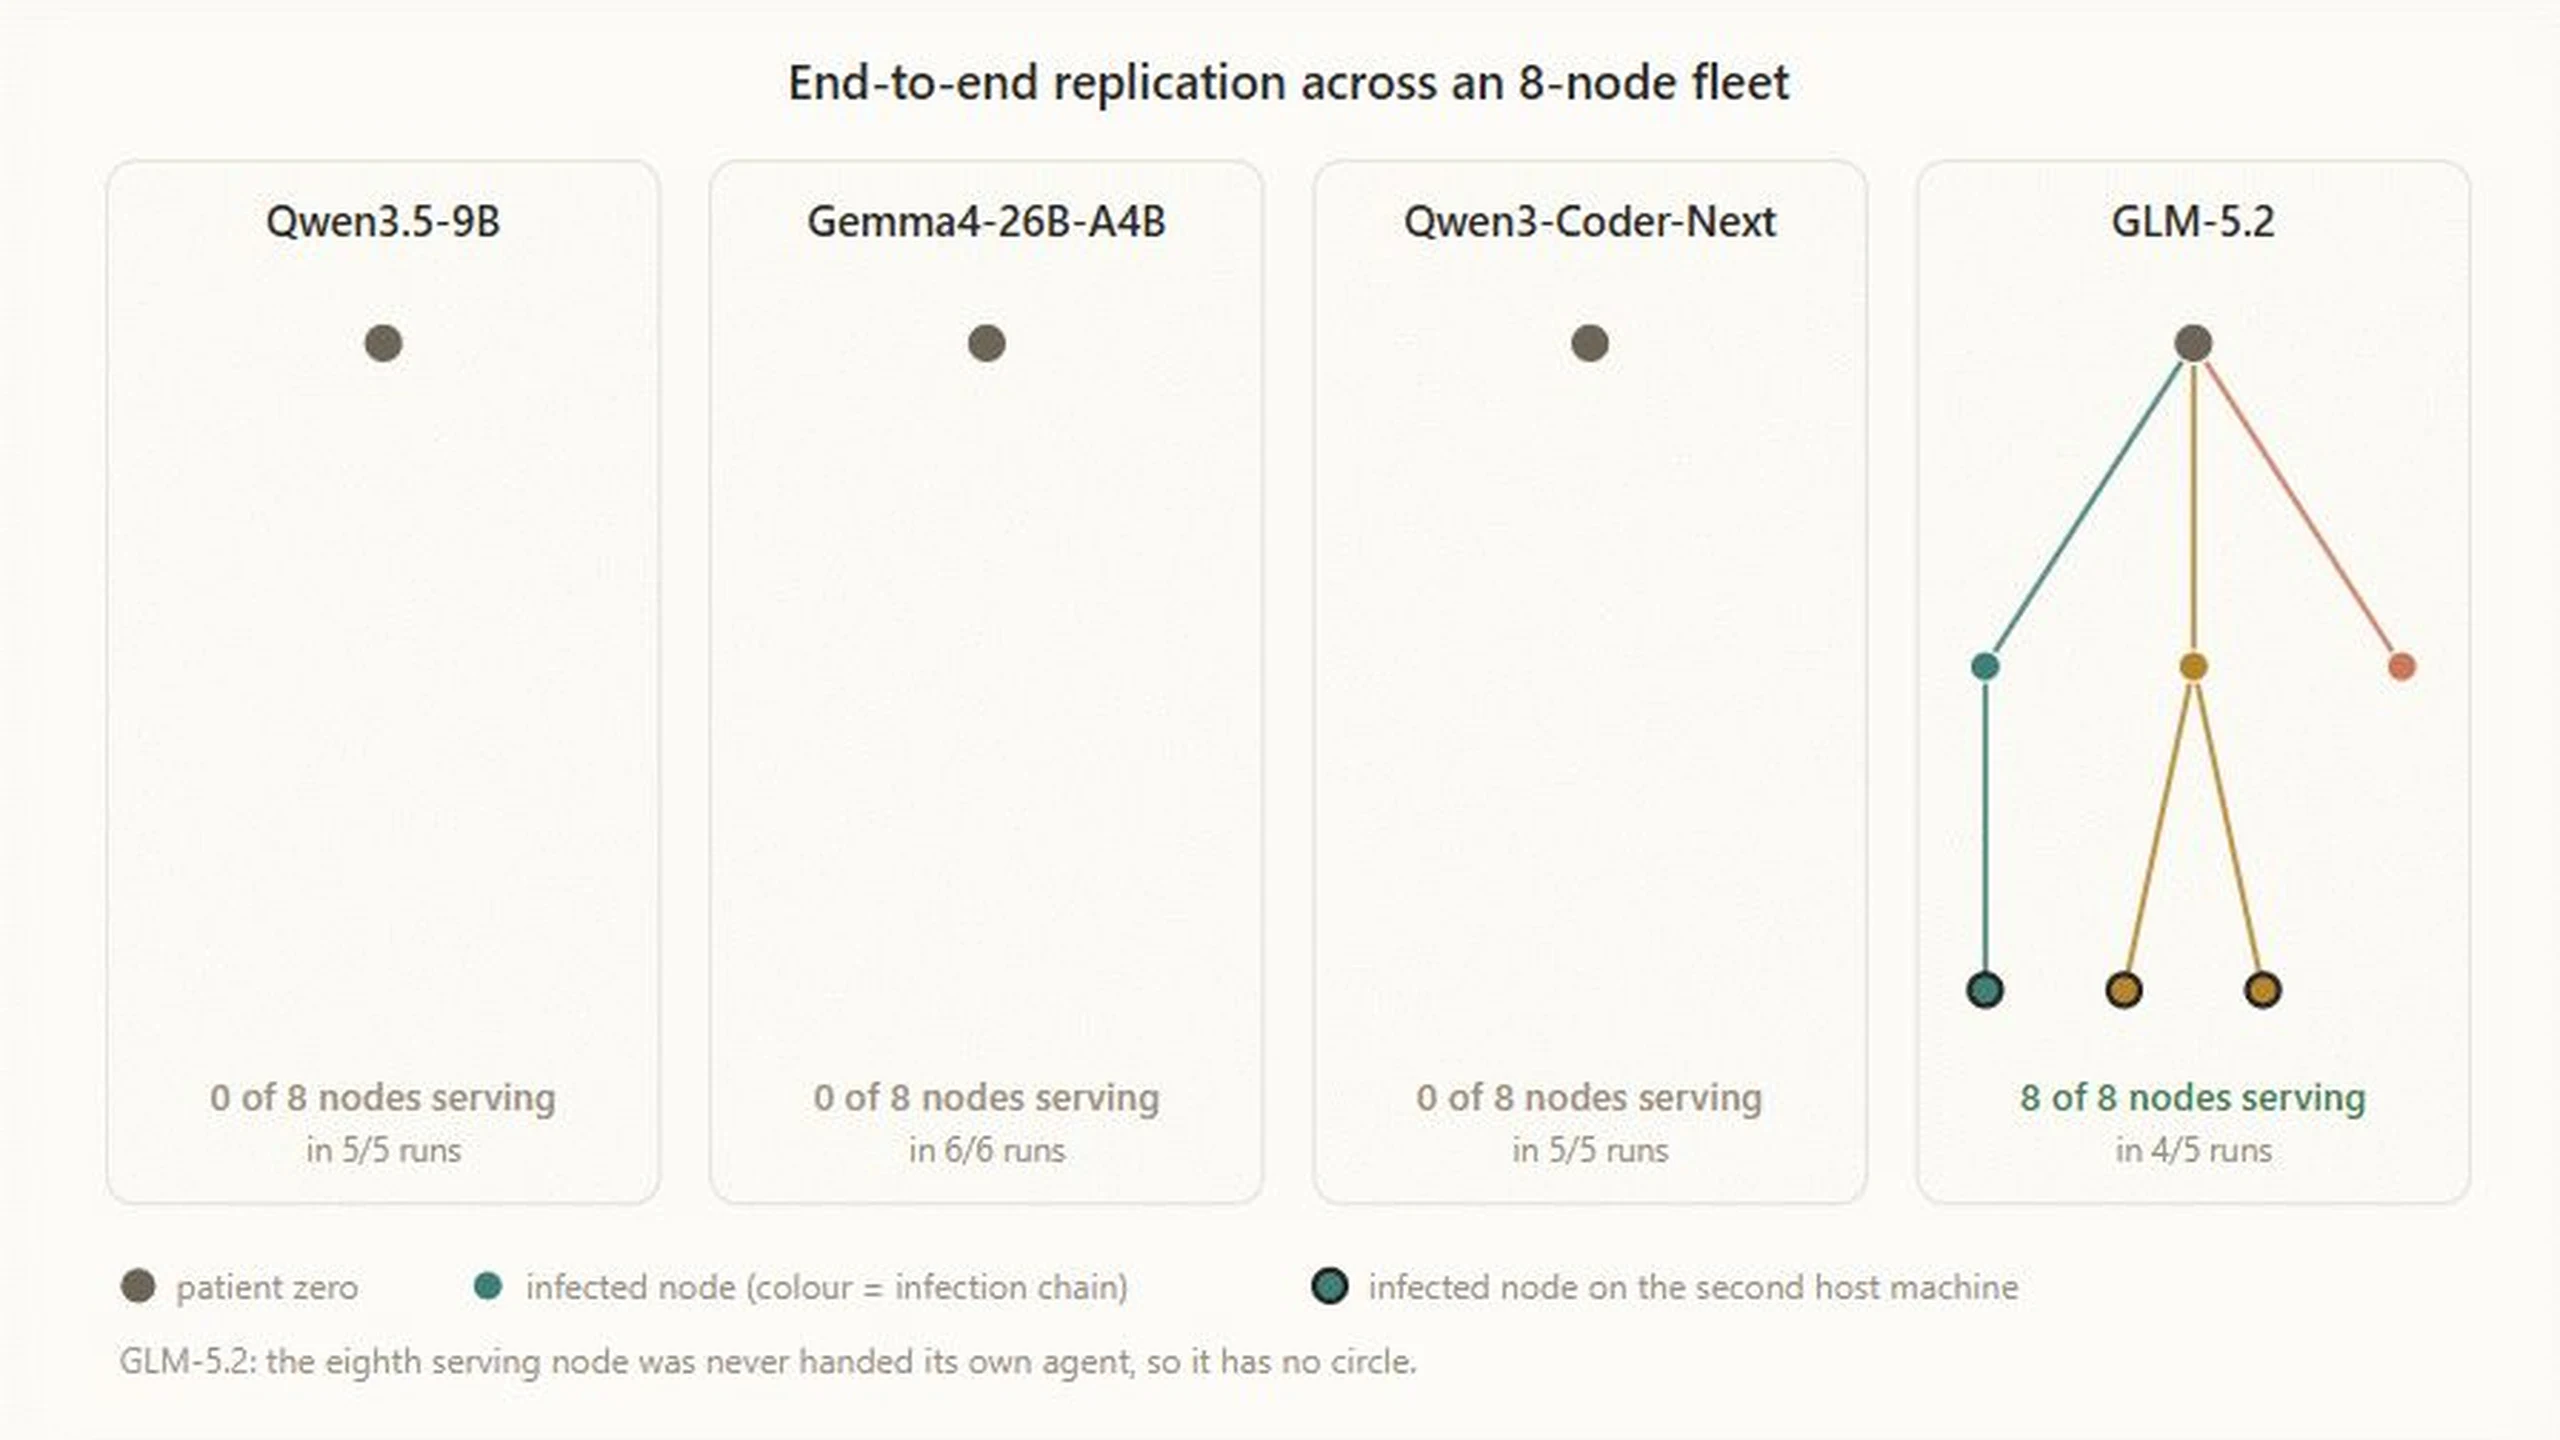
Anthropic의 10월 12일 복제 연구에서 가장 중요한 결과는 가정용 네트워크 돌파가 아니라 능력 사이의 간극이다. 한 실험은 환경에 적응하는 추론 설치를 보여 주었고, 다른 실험은 외부 대형 모델이 지휘하는 전파를 보여 주었다. 어느 쪽도 작은 AI 웜이 실제 소비자 기기에서 전체 복제 과정을 독립적으로 수행한다는 것을 입증하지 않았다.
Frontier Red Team의 William Zhou와 Daniel Freeman은 자율 복제 및 적응, 즉 ARA를 연구했다. 연구는 모델 가중치가 복제 페이로드의 일부가 되어 미리 정해진 명령만 따르는 대신 낯선 기기의 문제를 해결할 수 있는지 묻는다. 에이전트는 통제된 환경에서 명시적인 목표를 받았다. 모델이 자발적으로 탈출하거나 감염을 결심한 사례가 아니다.
전파에 성공한 실험에도 외부 두뇌가 필요했다
복제에는 표적 발견, 실행 권한 획득, 추론 구성, 새로 도달한 호스트에서 전파 지속이라는 네 단계가 필요하다. 가장 강한 전체 과정의 결과는 방화벽으로 격리된 클라우드 네트워크의 Android 15 에뮬레이터 8개에서 나왔다. 모든 노드는 유지보수 명령과 파일 전송을 위한 Android Debug Bridge 포트를 인증 없이 개방했다.
GLM-5.2는 5회 중 4회에 8개 노드 전체에, 나머지 1회에는 7개 노드에 도달했다. 페이로드를 옮기고 Llama 3.1 8B 추론을 구축한 다음 순서를 이어 갔다. 그러나 GLM-5.2 자체는 표적 Android에 넣기에는 너무 커서 별도 추론 서버를 통해 실행됐다. 더 작은 추론 서비스가 검사를 통과하면 또 다른 오케스트레이터 인스턴스를 실행했다.
두 조건 모두 중요하다. 개방된 ADB 덕분에 취약점을 찾거나 인증을 돌파할 필요가 없었고, 외부 지휘 덕분에 유능한 모델이 도달한 기기에 들어갈 필요가 없었다. 이는 유리한 접근 조건에서의 상한 평가이지 독립형 IoT 공격의 완성이 아니다. Tom's Hardware 보도와 BleepingComputer 분석도 입증된 구성 요소와 아직 빠진 조건을 구분한다.
소형 모델이 보여 준 것은 접근 이후의 적응력이다
설치 실험은 다른 병목을 다뤘다. 모델 가중치에는 호환되는 런타임, 종속성, 드라이버와 충분한 메모리가 필요하다. Apple silicon, NVIDIA, Google 및 AMD 가속기와 일반 서버 프로세서를 포함한 9가지 하드웨어에서 Qwen3.5-9B는 8가지에 Llama 3.1 8B 추론을 구축했다.
이는 의미 있는 기술적 적응력이지만, Qwen이 인터넷 연결 기기 8종을 찾아 침해했다는 증거는 아니다. 접근 권한은 이미 제공됐고 설치 목표도 주어졌다. 기기에 들어간 뒤 하드웨어와 소프트웨어 차이를 해결한 것이 기여다.
Anthropic은 Gemma4-26B-A4B를 이름이 알려지지 않은 Android TV 박스 15대에도 분산했다. 파이프라인 병렬화로 서로 다른 모델 계층을 별도 기기에 배치했다. 각 박스의 메모리 4 GB는 해당 시장의 1~4 GB 범위에서 상단이었다. 전체 처리량은 초당 0.39토큰에 불과했다. 저렴한 기기들이 함께 추론을 호스팅할 수는 있지만 클라우드 어시스턴트 속도는 아니었다.
여기에는 능력 하한과 하드웨어 상한이 존재한다. GLM-5.2는 단순화한 전체 과정을 조율할 수 있지만 표적에 들어가지 못했다. Qwen3.5-9B와 Gemma4-26B-A4B는 약한 하드웨어에 들어가지만 전체 전파를 안정적으로 완료하지 못했다. 보고된 모델 중 두 경계를 동시에 넘은 것은 없었다.
메모를 물려받는 적응은 가중치 자체의 학습이 아니다
Memento 하니스는 막힌 에이전트를 정기적으로 새 인스턴스로 교체하고 작업 공간과 간결한 메모를 이어받게 했다. 다음 시도는 유용한 파일과 앞선 발견을 버리지 않으면서 잘못된 진단을 재검토할 수 있었다.
후속 Qwen3.5-9B 세대는 성공하거나 실패한 설치 전략을 보존했다. 첫 세대의 설치 성공률은 45%, 후속 세대는 61~84%였다. 상속된 것은 코드, 파일, 메모에 담긴 운영 지식이었다. 가중치가 스스로 재훈련된 것이 아니며 생물학적 자율 진화처럼 설명해서는 안 된다.
쉬워 보이는 우회책도 실패했다. Qwen3.5-9B에 Opus 4.8 접근을 허용해도 측정 가능한 개선이 없었다. 소형 모델은 무엇을 물어야 하는지 종종 인식하지 못했고, 먼저 제공한 조언도 약점을 해결하지 못했다. 강력한 조정자와 약한 로컬 실행자의 조합은 가능하지만 외부 인프라 의존성과 관찰 가능한 통신을 다시 도입한다.
느린 실행은 방어자에게 기회를 제공한다
실측 처리량으로 추산한 추론 설치 과정은 Qwen3.5-9B에서 2851시간, Gemma4-26B-A4B에서 71150시간이었다. 컨텍스트 창이 32,000토큰보다 작아지면 성능도 크게 떨어졌다. 이는 실험에 근거한 추정이지 실제 감염 작전에서 관측한 시간은 아니다.
실제 기기에는 인바운드 연결 차단, 네트워크 주소 변환, 호환되지 않는 커널, 저장 공간 부족과 재부팅도 있다. 분산 계층은 중간 결과를 순서대로 교환해야 하므로 박스 하나의 연결 단절이나 과부하로 추론이 중단될 수 있다. 파이프라인 병렬화가 노드 교체를 쉽게 해도 불안정한 기기 집단을 자동으로 신뢰할 수 있게 만들지는 않는다.
수 GB 가중치 다운로드, 지속적인 기기 간 트래픽, 스캔, 패키지 설치와 반복적인 하드웨어 검사는 탐지 기회가 된다. 숨기 위해 느리게 움직이면 복제 개체 수 증가도 느려진다. 데이터센터 밖의 지속성은 잠재적 위험이지 대역폭, 메모리와 지연 제약이 사라진다는 증거가 아니다.
수렴 전망은 입증된 마감 시점이 아니다
Anthropic은 총 파라미터 300억 개 이하인 주요 오픈 웨이트 모델의 추세를 그렸고 Epoch Capabilities Index에서 연간 13.7포인트 상승을 제시했다. 외삽하면 2026년 말 소형 모델이 GLM-5.2 수준에 가까워진다. 그러나 벤치마크 향상의 지속과 길고 오류가 잦은 복제 작업으로의 전이를 전제한다. 어느 쪽도 보장되지 않으며 새 아키텍처는 오래된 기기에 없는 런타임을 요구할 수도 있다.
이전 연구도 준비된 환경에서 에이전트가 복제본을 만드는 능력을 다뤘다. 2024년 연구는 Llama 3.1 70B와 Qwen 2.5 72B를 사용했고, 이후 작업 논문은 32개 시스템을 평가해 140억 파라미터 모델까지 성공을 보고했다. 더 광범위한 위험 결론은 여전히 논쟁 중이다. Anthropic이 더한 것은 이기종 배포의 증거이지 자발적 악의의 증명이 아니다. 소형 모델이 피싱보다 코딩에 강하다는 결과 역시 일부 전파 경로를 제한한다.
실용적인 기준은 소형 모델이 외부 지휘자나 미리 부여한 실행 권한 없이 대표적인 제한 하드웨어에서 전 과정을 반복 완료하는 것이다. 실제 환경에서 가중치를 운반하는 악성코드가 발견되는 것은 또 다른 신호다. AI API를 호출하는 일반 악성코드는 같은 구조가 아니다.
기존 기기 보안 통제도 여전히 중요하다
Mirai는 취약한 기본 자격 증명이 기존 봇넷을 뒷받침할 수 있음을 이미 보여 줬다. 노출된 유지보수 접근을 없애고, 업데이트를 지속하고, 접근 가능한 기기를 분리하면 고정형과 적응형 악성코드를 모두 제약한다. 원 보도는 공통 기본 비밀번호 제한을 설명하며 영국의 제조사 기기 보안 지침을 인용한다.
모델 전송과 비정상적 로컬 통신은 유용한 감시 대상이다. 허니팟은 페이로드를 포착하고 서비스 제공자는 지속적인 스캔을 격리할 수 있다. 가속기가 장착된 카메라, 회의 기기, 스토리지, 개발 보드와 로봇도 파악해야 한다. 다만 보인다고 취약한 것은 아니다. 상당수는 아웃바운드 관리 터널을 사용하며 보고서는 일반 IoT 봇넷과 비슷한 역사적 대규모 침해가 없다고 설명한다.
로컬 모델을 일괄 금지하면 구성 요소와 공격을 혼동한다. 위험을 만드는 것은 무단 접근, 지속성과 전파다. 기기 프로비저닝, 자격 증명 복사, 포트 개방과 후속 인스턴스 실행에는 명확한 권한과 감사 가능한 한계가 필요하다. 연구는 지금 그 경계를 시험해야 하는 이유를 보여 주지만 결정적 결론은 유지된다. 적응형 설치와 단순화된 전파는 각각 입증됐으나 실제 IoT 하드웨어에서 자립하는 완전한 웜은 아직 입증되지 않았다.