
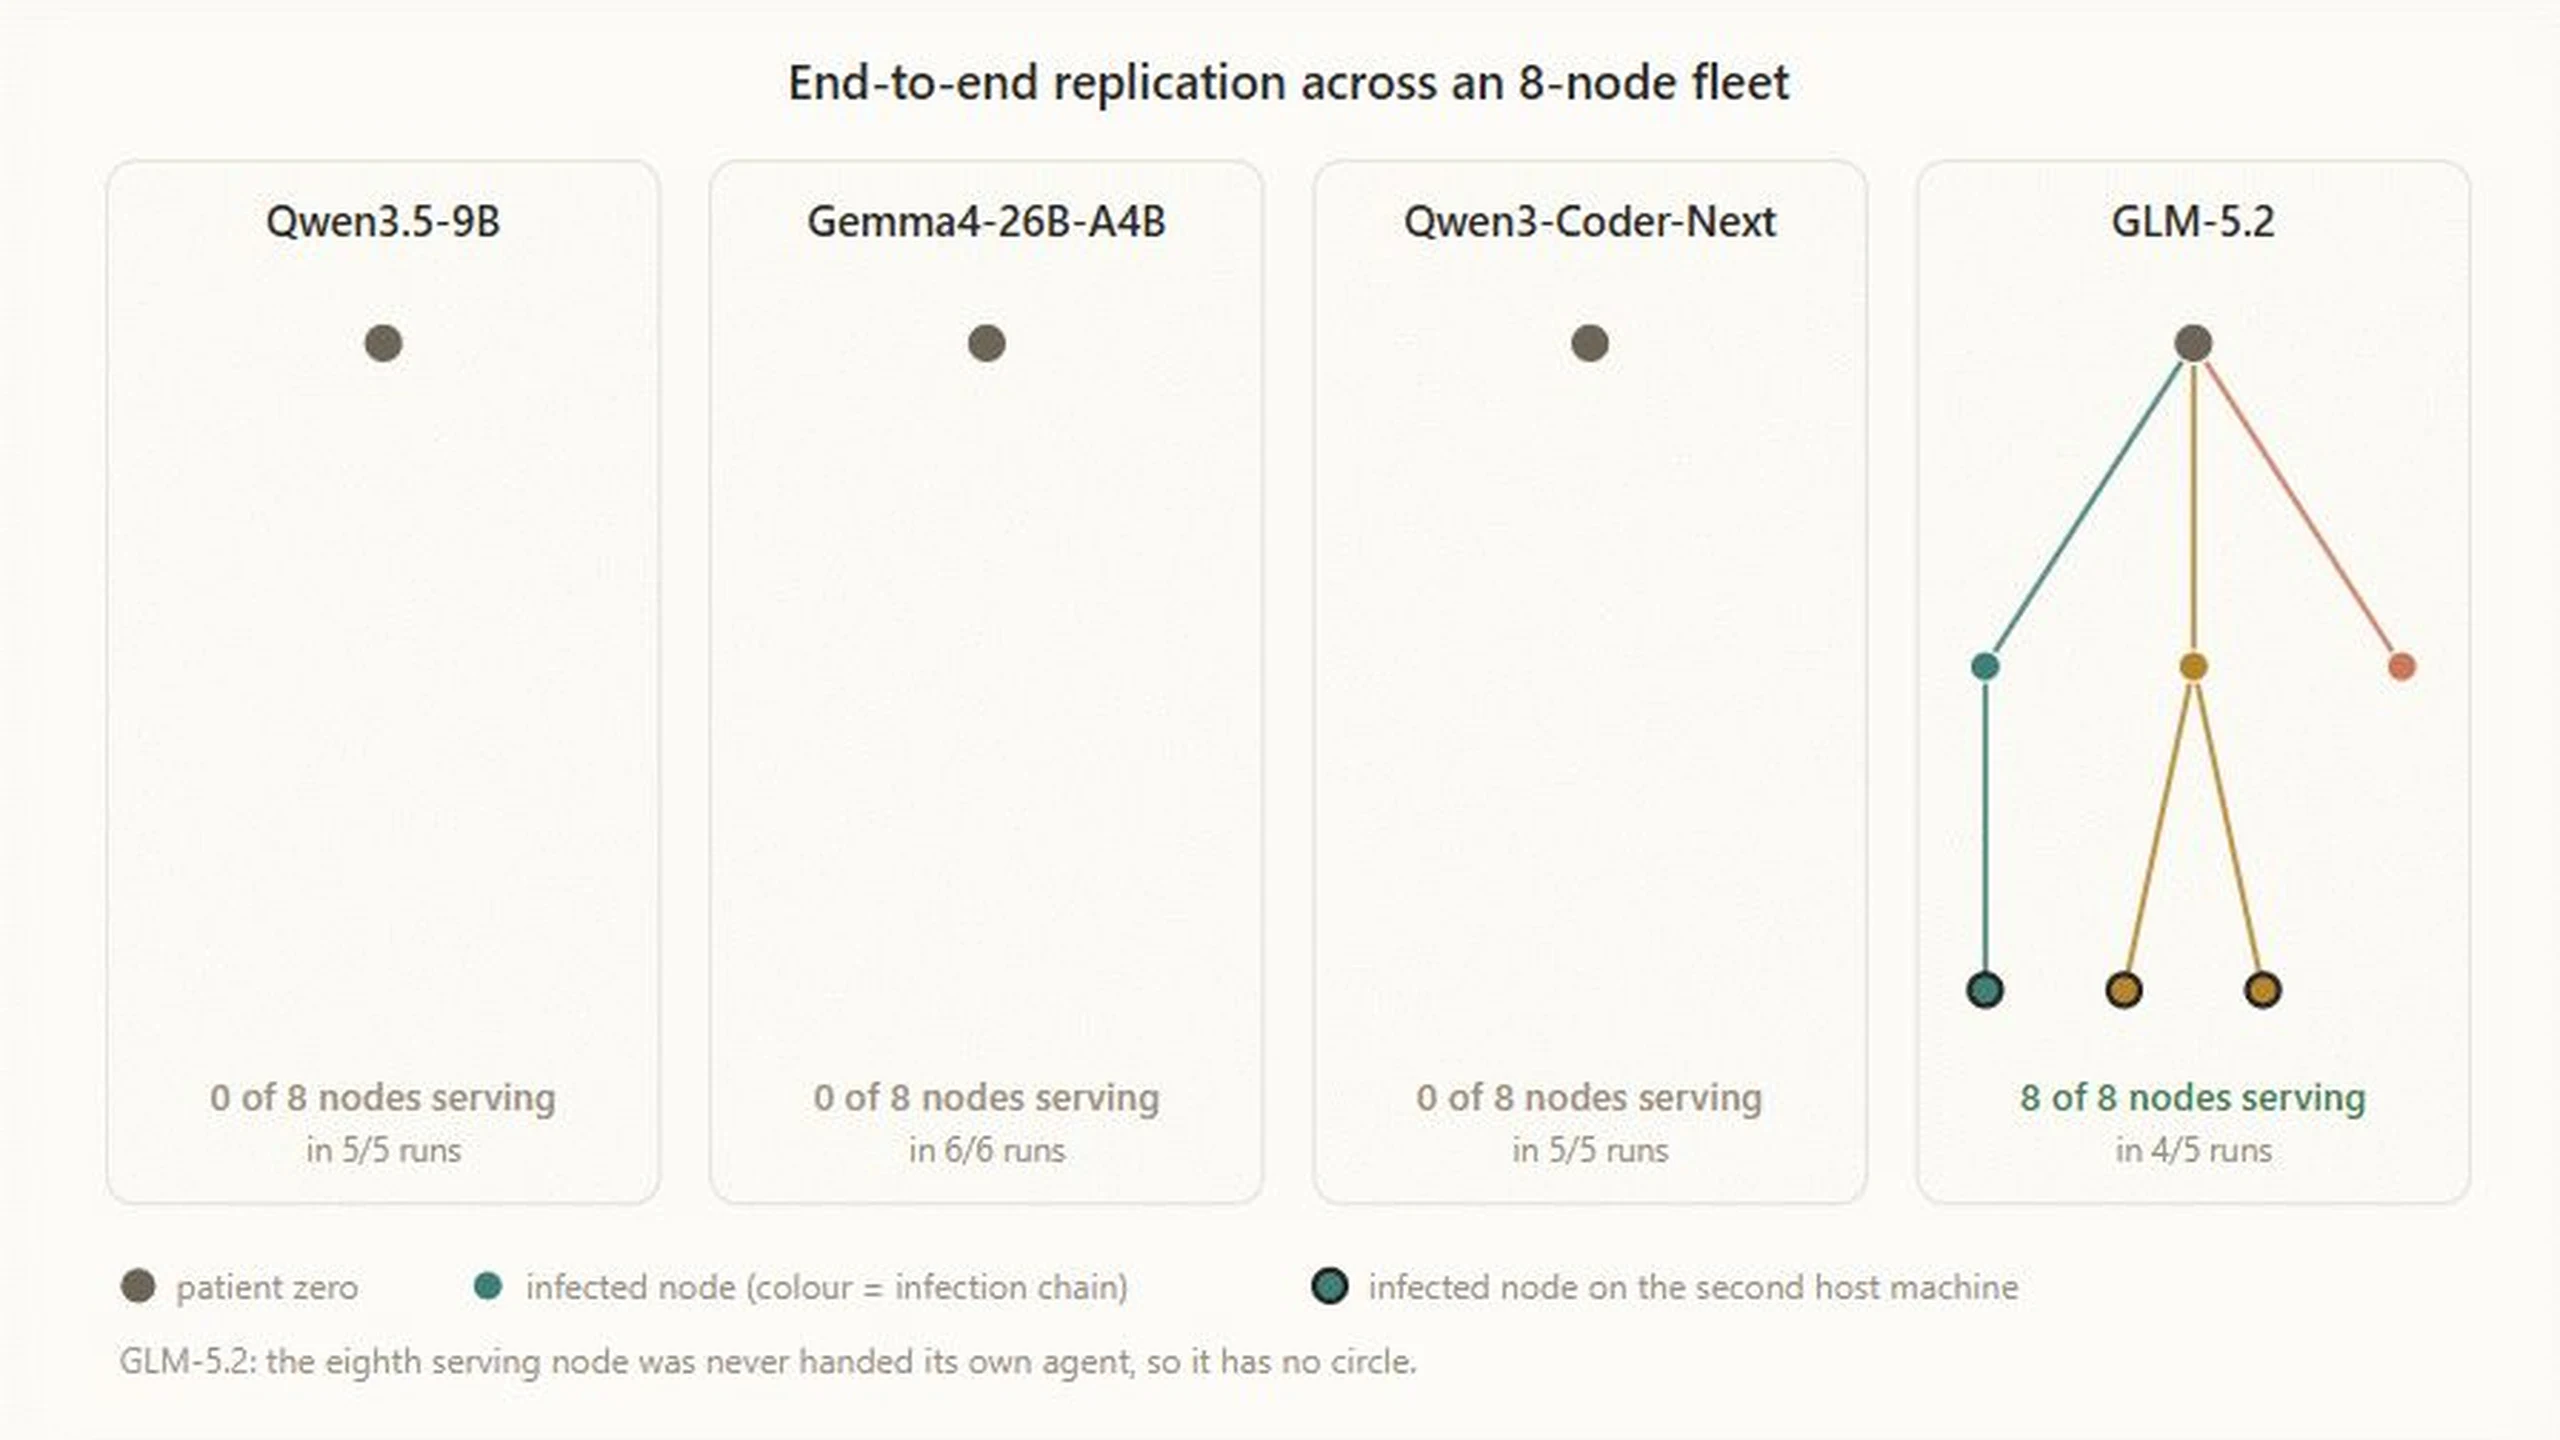
Le résultat essentiel des recherches d’Anthropic du 12 octobre est une séparation des capacités, et non une percée dans les réseaux domestiques. Une expérience démontre une installation adaptable de l’inférence. Une autre montre une propagation dirigée par un grand modèle hébergé à l’extérieur. Aucune ne montre un petit ver IA exécutant seul toute sa réplication sur de vrais appareils grand public.
William Zhou et Daniel Freeman, de la Frontier Red Team, étudient la réplication et l’adaptation autonomes, ou ARA. Leur recherche demande si des poids de modèle pourraient intégrer une charge réplicative, permettant au logiciel de dépanner des machines inconnues plutôt que de suivre uniquement des instructions prédéfinies. Les agents ont reçu un objectif explicite dans des environnements contrôlés. Ce n’était ni une évasion spontanée ni une décision autonome d’infecter des appareils.
La propagation réussie dépendait d’un cerveau externe
La réplication relie quatre étapes : découvrir les cibles, obtenir l’exécution, configurer l’inférence et repartir du nouvel hôte. Le meilleur résultat de bout en bout utilise huit émulateurs Android 15 dans un réseau cloud protégé par pare-feu. Chaque nœud expose un port Android Debug Bridge sans authentification, interface de commandes de maintenance et de transfert de fichiers.
GLM-5.2 atteint les huit nœuds dans quatre essais sur cinq, et sept dans le dernier. Il transfère une charge, établit l’inférence Llama 3.1 8B et poursuit la séquence. Mais GLM-5.2 fonctionne lui-même sur un serveur d’inférence distinct, car il est trop gros pour les cibles Android. Après validation du petit service d’inférence, une autre instance d’orchestration est lancée.
Ces deux conditions sont essentielles. L’ADB ouvert supprime la recherche de vulnérabilités et le franchissement de l’authentification. L’orchestration externe évite de faire tenir le modèle compétent sur la machine atteinte. C’est une borne supérieure dans des conditions d’accès favorables, pas un assaut IoT autonome achevé. Tom's Hardware et BleepingComputer distinguent aussi ces lacunes des composants démontrés.
Les petits modèles s’adaptent après l’accès
Le test d’installation traite un autre obstacle. Les poids ont besoin d’un environnement d’exécution, de dépendances et de pilotes compatibles, ainsi que d’assez de mémoire. Sur neuf types de matériel, notamment Apple silicon, les accélérateurs NVIDIA, Google et AMD et des processeurs serveur classiques, Qwen3.5-9B établit l’inférence Llama 3.1 8B sur huit.
C’est une réelle adaptabilité technique, pas la preuve que Qwen a découvert et compromis huit familles d’appareils connectés. L’accès et l’objectif d’installation étaient fournis. Sa contribution consiste à résoudre les différences logicielles et matérielles après l’entrée.
Anthropic répartit aussi Gemma4-26B-A4B sur quinze boîtiers Android TV de marques peu connues. Le parallélisme de pipeline attribue différentes couches à différentes machines. Chaque boîtier possède 4 Go de mémoire, en haut de la fourchette de 1 à 4 Go citée pour ce marché. Ensemble, ils produisent seulement 0,39 jeton par seconde. Le matériel bon marché peut héberger collectivement l’inférence, mais sans la vitesse d’un assistant cloud.
Ces résultats révèlent un plancher de capacité et un plafond matériel. GLM-5.2 coordonne la boucle simplifiée mais ne tient pas sur les cibles. Qwen3.5-9B et Gemma4-26B-A4B tiennent sur du matériel faible, mais n’accomplissent pas fiablement toute la propagation. Aucun modèle rapporté ne franchit simultanément les deux limites.
Hériter de notes n’est pas réentraîner les poids
Le dispositif Memento remplace périodiquement un agent bloqué par une nouvelle instance qui hérite de son espace de travail et de notes concises. Une nouvelle tentative peut ainsi remettre en cause un mauvais diagnostic sans perdre les fichiers utiles et les découvertes précédentes.
Les générations successives de Qwen3.5-9B conservent les stratégies d’installation réussies et échouées. La première réussit dans 45% des cas ; les suivantes atteignent 61–84%. Le mécanisme transmet des connaissances opérationnelles dans le code, les fichiers et les notes. Les poids ne se réentraînent pas : parler d’évolution biologique autonome serait trompeur.
Un raccourci apparemment simple échoue également. L’accès à Opus 4.8 n’apporte aucune amélioration mesurable à Qwen3.5-9B. Le petit modèle ne sait souvent pas quelle question poser, et les conseils non sollicités ne corrigent pas cette faiblesse. Un coordinateur puissant avec des exécutants locaux plus faibles reste envisageable, mais réintroduit une dépendance externe et des communications observables.
La lenteur offre une occasion aux défenseurs
Le débit mesuré implique une estimation de 28–51 heures pour une trajectoire d’installation avec Qwen3.5-9B, contre 71–150 heures pour Gemma4-26B-A4B. Les performances se dégradent aussi nettement sous 32 000 jetons de contexte. Ce sont des estimations expérimentales, pas les durées observées d’une véritable campagne d’infection.
Des appareils réels ajoutent connexions entrantes bloquées, traduction d’adresses réseau, noyaux incompatibles, stockage limité et redémarrages. Les couches distribuées doivent échanger les résultats intermédiaires dans l’ordre ; un boîtier déconnecté ou saturé peut interrompre l’inférence. Le pipeline facilite le remplacement d’un nœud sans rendre fiable une flotte instable.
Des téléchargements de plusieurs gigaoctets de poids, un trafic interappareils soutenu, les scans, les installations de paquets et les inspections matérielles répétées créent des occasions de détection. Ralentir pour se dissimuler freine aussi la croissance de la population. La persistance hors d’un centre de données est un risque possible, pas la disparition des contraintes de bande passante, de mémoire et de latence.
Une convergence prévue n’est pas une échéance démontrée
Anthropic suit des modèles à poids ouverts notables de trente milliards de paramètres totaux au maximum, avec une tendance de 13,7 points annuels sur l’Epoch Capabilities Index. L’extrapolation rapproche un petit modèle de GLM-5.2 fin 2026. Elle suppose la poursuite des progrès et leur transfert aux longues tâches de réplication sujettes aux erreurs. Rien ne le garantit ; de nouvelles architectures peuvent aussi exiger des environnements absents des anciens appareils.
Des travaux antérieurs examinaient déjà la création de copies dans des environnements préparés. Une étude de 2024 utilisait Llama 3.1 70B et Qwen 2.5 72B ; un document de travail ultérieur évaluait 32 systèmes et rapportait des succès jusqu’à quatorze milliards de paramètres. Ses conclusions générales sur les risques restent débattues. Anthropic ajoute des preuves d’installation hétérogène, pas d’intention malveillante spontanée. La supériorité des petits modèles en programmation plutôt qu’en hameçonnage limite également certaines voies.
Le seuil pratique serait un petit modèle accomplissant répétitivement toute la boucle sur du matériel contraint représentatif, sans orchestration externe ni exécution préaccordée. Des logiciels malveillants transportant des poids observés sur le terrain constitueraient un autre signal. Un malware ordinaire appelant une API IA n’a pas la même architecture.
Les contrôles existants restent importants
Mirai a déjà montré comment de faibles identifiants par défaut soutiennent des botnets classiques. Fermer les accès de maintenance exposés, maintenir les mises à jour et segmenter les appareils accessibles contraint les malwares fixes comme adaptatifs. Le reportage initial cite les recommandations britanniques aux fabricants concernant les restrictions sur les mots de passe universels par défaut.
Les transferts de modèles et les communications locales anormales sont utiles à surveiller. Des honeypots peuvent capturer les charges ; les opérateurs peuvent isoler les scans persistants. Caméras accélérées, équipements de conférence, stockage, cartes de développement et robots méritent un inventaire. Mais visibilité n’est pas vulnérabilité : beaucoup utilisent des tunnels de gestion sortants et le rapport ne relève pas de compromis massifs historiques comparables aux botnets IoT ordinaires.
Interdire tous les modèles locaux confond un ingrédient et une attaque. Accès non autorisé, persistance et propagation créent le risque. Provisionnement, copie d’identifiants, ouverture de ports et lancement de descendants exigent plutôt des privilèges explicites et des limites auditables. La recherche montre pourquoi les tester maintenant, tout en maintenant sa conclusion décisive : installation adaptable et propagation simplifiée ont été démontrées séparément ; un ver autonome sur de vrais appareils IoT ne l’a pas été.