
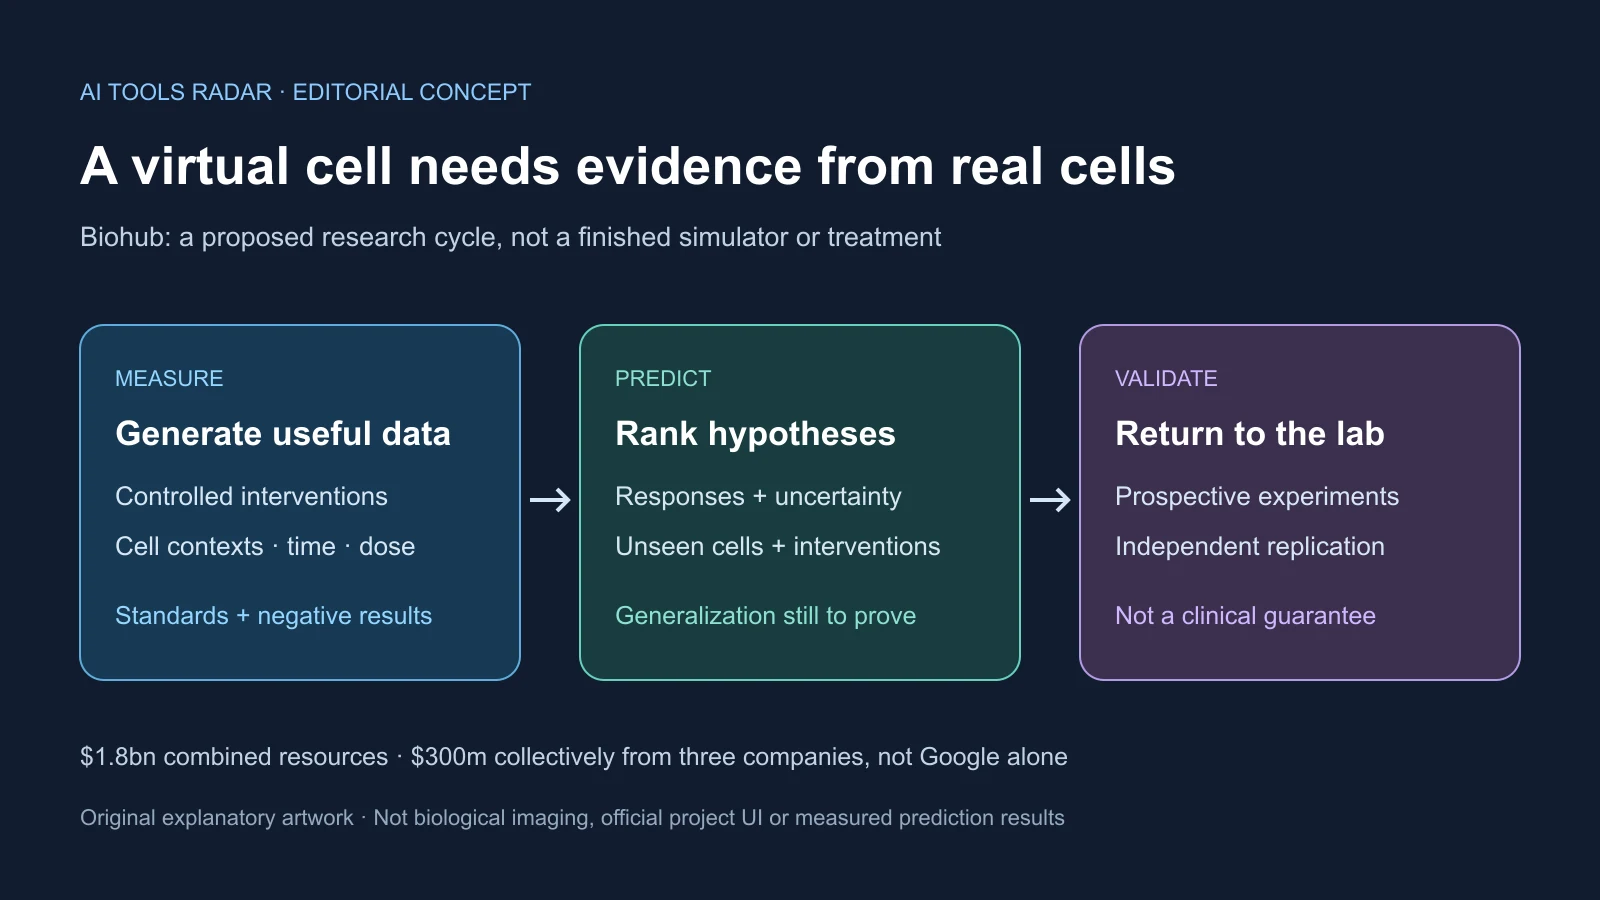
Biohubs erweiterte Virtual Biology Initiative setzt darauf, dass biologische KI mehr Laborevidenz braucht, nicht nur ein größeres Modell. Das am 7. Oktober 2026 angekündigte Programm verbindet Google DeepMind, Meta, Isomorphic Labs, Bundesbehörden und Forschungsinstitute, um teure Daten darüber zu erzeugen, wie lebende Zellen auf Eingriffe reagieren.
Die genannten 1,8 Milliarden Dollar umfassen Finanzierung, vorhandene Daten, Rechenleistung und Messtechnik. Es ist keine einzelne Bargeldrunde. Die Unternehmensinvestition von 300 Millionen kommt gemeinsam von drei Firmen, nicht allein von Google. Auch eine fertige virtuelle Zelle wird nicht vorgestellt: großer Datensatz und zuverlässige Vorhersagemodelle bleiben Ziele.
Vier Ressourcenströme statt eines austauschbaren Geldtopfs
DeepMind, Meta und die Alphabet-Firma Isomorphic Labs investieren zusammen 300 Millionen Dollar ohne veröffentlichte Aufteilung. Das Energieministerium plant über fünf Jahre mehr als 500 Millionen für Messung, Bildgebung, Modellierung, Rechnen und Datenerhebung über seine nationalen Labore.
NIH koordiniert Datenbestände, die aus früheren Bundesinvestitionen von mehr als 500 Millionen entstanden sind. Biohub will sie für KI standardisieren. Das bedeutet keinen zusätzlichen neuen NIH-Barbeitrag derselben Höhe.
Biohub versprach bereits beim Start im April 2026 weitere 500 Millionen, davon 400 Millionen für neue Messtechnik wie Mikroskopie, Kryoelektronentomografie und Eingriffe in biologische Systeme verschiedener Größenordnungen. Gemeinsam sind dies unterschiedliche Ressourcen, nicht durchweg neue Finanzmittel.
Die von Mark Zuckerberg und Priscilla Chan gegründete Organisation nennt Allen Institute, Broad Institute, Gladstone Institutes, Human Cell Atlas, Human Protein Atlas und Wellcome Sanger Institute. Nvidia liefert Computertechnik und Expertise. Gemeinsame Standards, Kennungen und ein zentraler Zugang sind Kernaufgaben, keine Verwaltungskosmetik.
Andere Versuchsdesigns, Labels, Geräte und Qualitätskontrollen können dem Modell das Labor statt relevanter Biologie beibringen. Koordinierte Experimente, Metadaten und kompatible Verarbeitung müssen mitwachsen. Wissenschaftschef Alex Rives erwartet den ersten großen Datensatz in etwa einem Jahr, um Oktober 2027, und genaue Modelle binnen fünf Jahren. Es sind Ziele ohne bislang universell festgelegten Genauigkeitsmaßstab.
Was vor der Vorhersage gemessen werden muss
Eine virtuelle Zelle kann ein fokussiertes Vorhersageprogramm statt einer realistischen Animation oder universellen Simulation sein. Fragen betreffen Genabschaltung, Wirkstoffe, Nährstoffe oder krankheitsbezogene Bedingungen und deren Einfluss auf Moleküle und Verhalten.
Ausgaben reichen von Genaktivität zu Proteinen, Struktur, Signalen und beobachtbaren Reaktionen. Benötigt werden gepaarte Messungen vor und nach kontrollierten Eingriffen über Zelltypen, Bedingungen, Dosen und Zeitpunkte. Öffentliche Sammlungen enthalten Hunderte Millionen Beobachtungen; Rives hält Milliarden und später Billionen für nötig.
Menge genügt nicht. Eine Billion schlecht dokumentierter Werte kann Verzerrung vergrößern. Räumliche Transkriptomik bewahrt die Gewebeposition molekularer Aktivität, Kryoelektronentomografie zeigt dreidimensionale innere Strukturen, Perturbationsscreens messen genetische und Umweltreaktionen. Es sind verschiedene Ebenen, keine austauschbaren Verfahren.
Geplant ist die Verbindung von Molekülen, Zellen, Gewebe und Organismen. DeepMinds Pushmeet Kohli betont eine offene standardisierte Gemeinschaftsressource experimenteller Antworten. AlphaFolds Struktur- und Interaktionserfahrung ist relevant, aber eine dynamische ganze Zelle ist nicht nur ein größeres Proteinstrukturproblem.
Ein Alzheimer-Team könnte Eingriffe nach Wirkung und Unsicherheit ordnen und dann reale Experimente auswählen. Das Labor liefert weiterhin die entscheidende Messung; neue Resultate verbessern das Modell und die nächste Auswahl. Dieses aktive Lernen soll Experimente besser wählen, nicht abschaffen.
Generalisierung bleibt schwierig. Eine Zelllinie repräsentiert nicht unbedingt primäres menschliches Gewebe, eine Dosis nicht eine andere. Spender, Entwicklung, Krankheit, Nachbarzellen, Nahrung und Vorbehandlung verändern Verhalten. Eng nützliche Modelle können einer universellen Simulation vorausgehen.
Gemeinsame Infrastruktur bietet privaten Vorsprung
Biohub will die Ressource letztlich der Wissenschaft öffnen. Laut Rives erhalten staatlich finanzierte Daten keine privaten Sperrfristen. Unternehmensfinanzierte Daten dürfen kommerzielle Geldgeber vorab nutzen; die Dauer wurde nicht veröffentlicht.
Der Anreiz kann teure Experimente finanzieren, lässt finanzstarke Partner aber Modelle und Methoden vor Universitäten oder kleinen Biotechfirmen entwickeln. Spätere Offenheit beseitigt den Zeitvorteil nicht.
Isomorphic Labs betreibt ausdrücklich Wirkstoffforschung, wo Perturbationsdaten Ziele und Substanzen unterstützen könnten. DeepMind bringt Biologie-KI-Erfahrung ein. Metas direkter Geschäftspfad ist weniger klar, trotz eigener Forschung und Zuckerbergs Verbindung. Die Zusammenarbeit beendet kommerziellen Wettbewerb nicht.
Glaubwürdigkeit hängt von Sperrfrist, Lizenz, Metadaten, Downloadbedingungen und negativen Ergebnissen ab. Modelle müssen auch wirkungslose Eingriffe lernen, nicht nur interessante publizierte Reaktionen. Datenkarten brauchen Methoden, Spender und Kontexte, Grenzen und Qualitätsprüfungen sowie erreichbare Korrekturwege.
Stabile Kennungen, archivierte Versionen und dauerhafter Zugriff sichern Reproduzierbarkeit. Offene Dateien bedeuten keine erschwingliche Rechenleistung für Hochschulen; Nvidia entscheidet damit auch keine Zuteilung. Zugang, Rechnen, Modellfreigaben und Datenschutz bestimmen, ob es geteilte Infrastruktur oder später veröffentlichter Firmenbesitz wird.
Proprietäre Daten konzentrieren Fähigkeiten und begrenzen Kontrolle, reine öffentliche Finanzierung könnte weniger Kapital oder Tempo gewinnen. OpenAIs Stiftung mit biologisch-medizinischen Daten und Anthropics Laboraktivität zeigen ebenfalls den strategischen Wert. Der Test betrifft Governance, nicht Google gegen Meta.
Bestehende Benchmarks trennen Geld von Genauigkeit
Arcs erster Wettbewerb verlangte Genexpressionsvorhersagen nach Genunterdrückung in menschlichen embryonalen Stammzellen: etwa 300.000 Einzelzellprofile und 300 Perturbationen. Über 5.000 Personen aus 114 Ländern registrierten sich, über 1.200 Teams reichten ein, mehr als 300 beendeten die finale Runde.
Arc berichtete, dass Modelle einfache Baselines nicht durchgängig in jeder Metrik übertrafen. Führende Systeme verbesserten Perturbationsunterscheidung und Erkennung veränderter Gene, mischten aber Deep Learning mit klassischen statistischen Merkmalen. Reines End-to-End-Lernen löste die Aufgabe nicht. Das beweist keine Unmöglichkeit, sondern die Grenze vertrauter Daten als Ersatz für unbekannte Biologie.
Der Wettbewerb 2026 verlangt Antworten in sechs Zelllinien ohne deren Perturbationsbeispiele im Training, ein wissenschaftsnäheres Zero-Shot-Szenario. STATE lernte aus Beobachtungen von 167 Millionen Zellen sowie Perturbationen von über 100 Millionen in 70 menschlichen Kontexten. Selbst das deckt biologische Möglichkeiten nur dünn ab.
Genexpression ist nicht der einzige Endpunkt. Proteinort, Form, Stoffwechsel, Giftigkeit und Zellkommunikation können ohne klare Transkriptionssignatur wechseln. Zielgene ordnen kann nützlich sein, während klinische Vorhersage ungeeignet bleibt. Fragen brauchen verschiedene Modelle, Modalitäten und Unsicherheit.
Ein Fünfjahresziel muss unbekannte Zelltypen, Eingriffe, Labore, Bedingungen und Fehlertoleranz definieren. Unabhängige Labore mit anderen Geräten und Proben sollten reproduzieren. Eine prospektive Studie mit modellgewählten Experimenten und besseren Entscheidungen ist stärker als Animation oder rückblickende Rangliste.
Die nächsten Meilensteine sind Belege, keine Therapie
Beim ersten Datensatz zählen Zelltypen, Eingriffe, Dosen, Zeiten, Spender, negative Resultate, Rohdaten und Metadaten, nicht nur Umfang. Verzögerte oder enge Freigabe schwächt den Zeitplan; Standards und Interoperabilität können dennoch wertvoll sein, selbst wenn eine universelle Zelle länger braucht.
Tests müssen über Auswendiglernen und Laborartefakte hinaus zu fremdem Gewebe, Chemie, längeren Zeiten und weiteren Messungen gehen. Prospektiver unabhängiger Labornutzen zählt. Schnellere Arzneientwicklung bleibt bis zur Prüfung eine Hypothese; Toxizität, Herstellung, Studien und Zulassung verschwinden nicht.
Schließlich braucht es Zugangsvorschriften: Vorabpartner, Fristen, Veröffentlichung jedes Datensatzes und Fehlerbehebung. Sie ermöglichen faire Vergleiche statt selektiver Vermarktung als breite biologische Intelligenz.
Nahe Ergebnisse für Forschung und Biotechnologie sind Daten, Standards, Instrumente und Versuchsmodelle, keine neue Behandlung im nächsten Jahr. Biohub finanziert die physische Arbeit, die KI nicht aus dem Netz sammeln kann. Erste Freigabe, unabhängige prospektive Tests und wirksame Governance werden zeigen, ob daraus verlässliche gemeinsame Wissenschaft wird.
Quellen
Biohub-Erweiterung · Finanzierungs- und Zugangsbedingungen · Biologischer Datenengpass · Arc-Wettbewerbsergebnisse · Arc-Zellprogramm · Definitionen virtueller Zellen · Ursprünglicher Bericht