
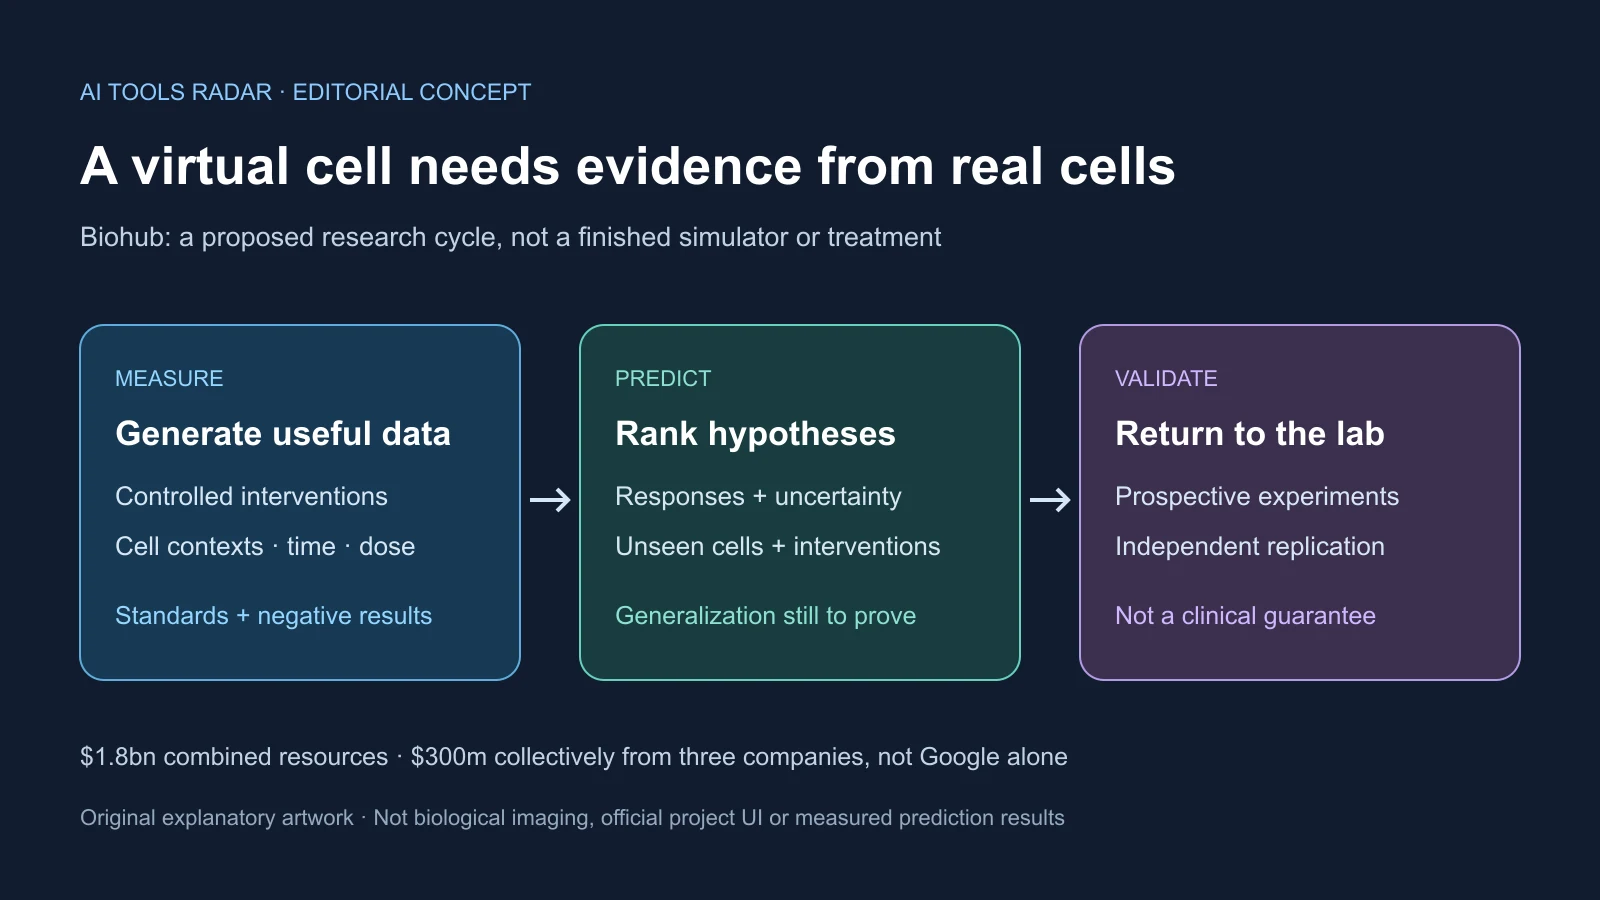
Biohub扩展Virtual Biology Initiative,押注生物AI下一步需要更多实验室证据,而不只是更大的模型。2026年10月7日公布的计划,把Google DeepMind、Meta、Isomorphic Labs、联邦机构和科学组织聚在一起,承担生成活细胞干预响应数据的昂贵工作。
声明的18亿美元包含资金、既有数据、计算和测量技术,不是一轮现金融资;其中3亿美元企业投入由三家公司共同提供,不是Google单独出资。公告也不是已经完成的虚拟细胞:首个大型数据集及可靠预测模型仍是未来目标。
四类资源,并非可以互换的一笔钱
Google DeepMind、Meta及Alphabet旗下Isomorphic Labs共同投入3亿美元,未公布各自份额。能源部计划五年投入超过5亿美元,利用国家实验室支持测量、成像、建模、计算及数据收集。
NIH将协调由此前超过5亿美元联邦投入形成的数据库和数据集,Biohub拟将它们标准化用于AI训练。这不是NIH再次投入同额新现金。
Biohub在2026年四月启动计划时已承诺5亿美元,其中4亿美元用于先进显微镜、冷冻电子断层扫描及多尺度生物系统改造工具等新测量技术。合起来是组合资源承诺,而非同一类新增资金。
由Mark Zuckerberg与Priscilla Chan创办的非营利机构,列出Allen Institute、Broad Institute、Gladstone Institutes、Human Cell Atlas、Human Protein Atlas及Wellcome Sanger Institute等伙伴,Nvidia提供计算技术和专长。共同标准、标识符和中央入口也是核心工作,不是行政装饰。
实验设计、标签、仪器及质控不同,可能让模型学到“哪个实验室测的”,而不是有意义的生物变化。协调实验、元数据与兼容处理必须伴随规模。科学负责人Alex Rives预计首个大型数据集约一年后、即2027年十月左右出现,伙伴以五年内准确预测为目标。这些是愿景,目前没有统一准确性标准来判定成功。
预测细胞之前,先要测什么
虚拟细胞可以是聚焦的预测程序,不一定是逼真动画或万能模拟器。有用问题包括沉默某个基因、加入化合物、改变营养或疾病相关环境,怎样改变分子活动和行为。
目标不止基因表达,还包括蛋白、结构、信号与可观察响应。训练需要受控改变前后的配对观测,并跨细胞类型、条件、剂量和时间重复。现有公开集合有数亿次细胞观测;Rives认为可靠预测需要数十亿,最终达到数万亿。
数量不够。记录不佳的万亿测量可能放大偏差。空间转录组保留分子活动在组织中的位置;冷冻电子断层扫描提供细胞内部结构的精细三维视图;扰动筛查测量基因或环境改变后的响应。它们描述不同层次,不能彼此取代。
拟议协调覆盖分子、细胞、组织与个体。DeepMind的Pushmeet Kohli强调,开放、标准化的实验响应数据公地是基础。AlphaFold的蛋白结构与相互作用经验有关,但动态整细胞并非简单放大的蛋白结构问题。
例如研究阿尔茨海默病通路的团队,可按预测影响和不确定性排列干预,再选择真实实验。实验室仍作出决定性测量,模型从新结果学习,帮助选择下一个信息量大的测试。这种主动学习追求更好选实验,而不是取消实验。
泛化仍是障碍。培养细胞系不一定代表原代人体组织,一个剂量也不代表另一个。供体、发育、疾病、邻居细胞、营养和既往治疗都改变行为。共享数据可能先支撑范围较窄但有用的模型,而非马上产生通用模拟器。
共享基础设施,也包含企业先发优势
Biohub说资源最终向科学界开放。Rives称,政府资助数据没有私人禁运期,企业资助数据则让商业出资方在公开前暂时提前使用;公告没有披露期限。
激励可以支付昂贵实验,却也让资金充足的伙伴在大学和小型生技公司获得数据前先训练模型、发展方法。最终开放不能消除时间差。
Isomorphic Labs明确经营药物发现,扰动数据可支持靶点与化合物研究;DeepMind带来生物AI经验。Meta直接商业路径较不明确,但有生物建模研究及Zuckerberg与Biohub的联系。合作是共享资源策略,不是商业竞争终结。
可信度取决于禁运期、许可、元数据、下载限制与阴性结果。模型要学会干预没有显著作用,而非只看到被选中发表的有趣结果。数据说明应涵盖方法、供体与背景、局限和质控;外部研究者也需要能用的纠错渠道。
稳定标识符、归档版本和长期访问关系到复现。公开文件不保证学术团队负担得起计算,Nvidia参与也没有解决分配。访问规则、算力、模型发布与隐私保障,会决定它是共享设施还是延迟公开的企业资源。
两种极端都不完美:专有数据集中能力、限制审查;纯公共资助可能难以获得相当投资或速度。OpenAI基金会资助医学和生物数据、Anthropic拓展实验室生物研究,也显示实验数据具有战略性。核心检验是治理,不是Google胜过Meta。
既有基准说明,资金不等于准确
Arc Institute首届虚拟细胞挑战要求预测人胚胎干细胞中抑制基因后的表达变化,包含约30万个单细胞谱和300种扰动。114个国家超过5000人报名,1200多个团队提交,超过300队完成最终参赛。
Arc报告模型未在所有指标上稳定胜过简单基线。领先系统改善了扰动区分与变化基因识别,但结合深度学习与经典统计特征,纯端到端学习尚未解决任务。这不证明不可能,而是说明熟悉数据的成功不能代替陌生生物情境表现。
2026年挑战提高到六种细胞系,训练未提供其扰动响应,是更接近科研使用的零样本设置。Arc的STATE模型利用覆盖1.67亿细胞的观测数据,以及跨70种人体背景、超过1亿细胞的扰动数据学习。如此规模仍只稀疏覆盖生物可能性。
基因表达准确也不是唯一终点。蛋白定位、形状、代谢、毒性及细胞沟通可变化,却没有明显转录特征。模型可有助排列基因靶点,却不适合临床预测。问题不同,需要不同模型、模态和不确定性估计。
因此,五年准确目标须定义未见细胞、干预、实验室、条件和容错。不同仪器及样本的独立实验室应复现结果。让模型预先选择实验并改善实际决策的前瞻研究,比漂亮可视化或回顾排行榜更强。
下一里程碑是公开证据,不是治疗承诺
首批数据应按细胞、干预、剂量、时间点、供体、阴性结果、原始测量及元数据评价,不只看量。发布狭窄或延迟会削弱模型时间表,但即使通用细胞更久才实现,共同标识符和互操作标准仍可能有价值。
基准进步必须越过记忆和实验室特征,覆盖陌生组织、化学干预、较长时间及表达之外的测量。前瞻、独立的实验收益才是重要结果。更快药物研发仍是待测假设,临床开发还包括毒性、制造、试验和监管审查。
最后需要公开访问规则:谁得到提前期、持续多久、各数据何时开放、如何纠错。这决定机构能否公平比较模型,而不是把选择性成绩营销成广泛生物智能。
对科研和生技公司,近期产物是数据、标准、仪器与实验模型,不是明年新治疗。Biohub的重要性在于资助AI不能从互联网抓取的物理工作。首批发布、独立前瞻测试及可执行治理,将说明它能否变成可靠共享科学。
来源
Biohub扩展公告 · 资金与访问条款报道 · 生物数据瓶颈 · Arc挑战结果 · Arc虚拟细胞计划 · 虚拟细胞定义 · 原始报道