
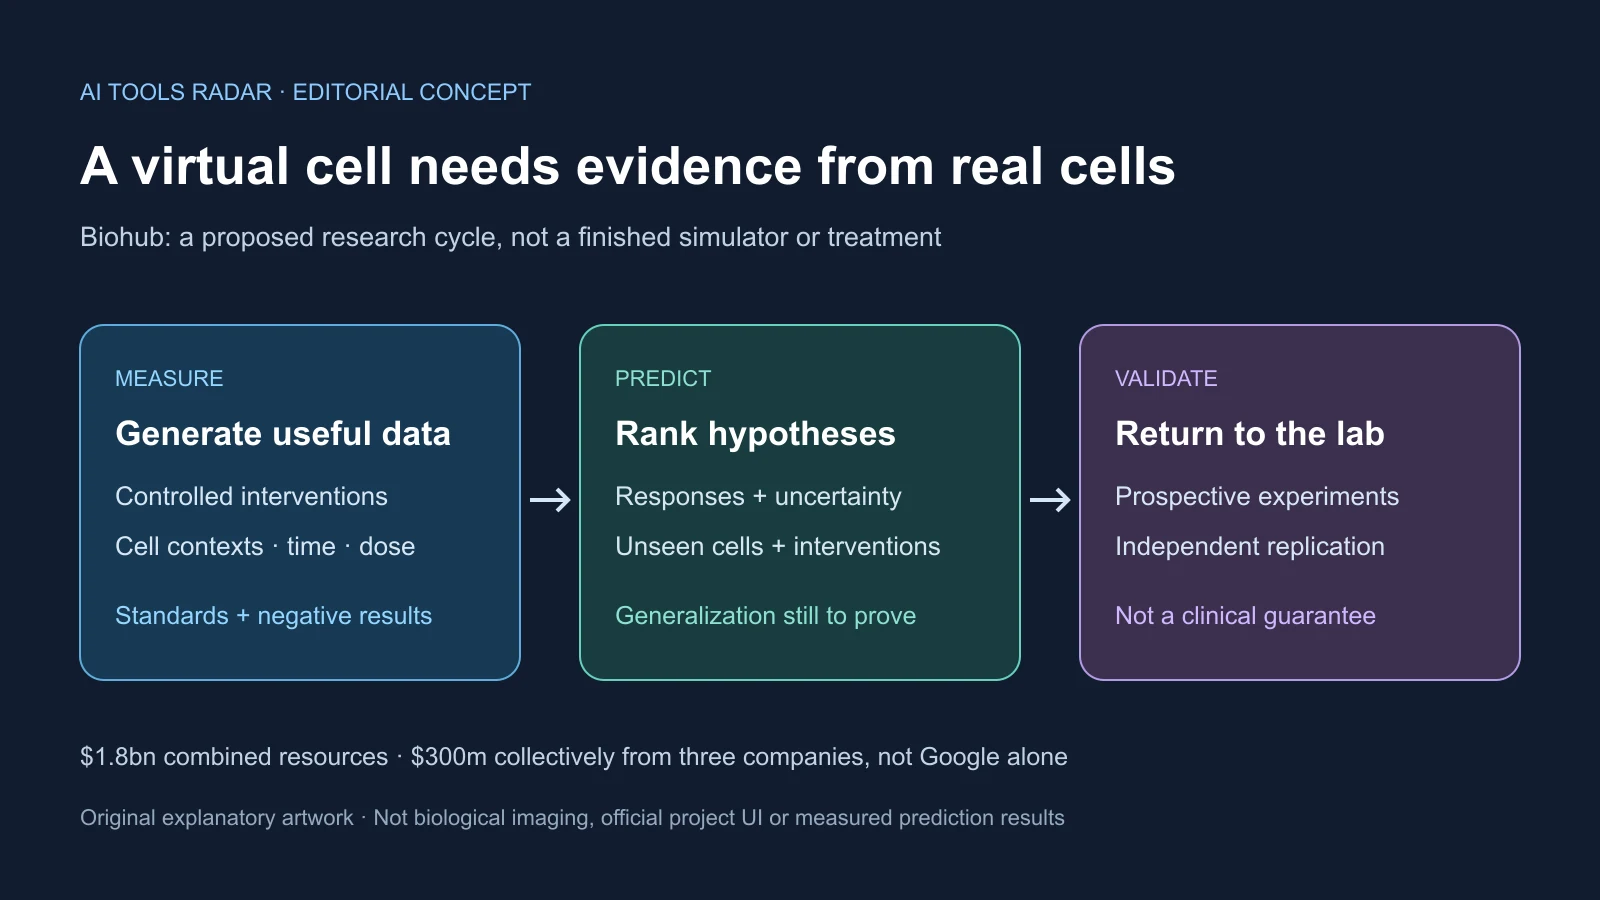
La Virtual Biology Initiative ampliata di Biohub scommette che il prossimo progresso dell’IA biologica richieda prove di laboratorio, non solo modelli maggiori. Il programma del 7 ottobre 2026 riunisce Google DeepMind, Meta, Isomorphic Labs, agenzie federali e istituti per produrre costosi dati sulle risposte delle cellule viventi agli interventi.
Gli 1,8 miliardi di dollari dichiarati comprendono fondi, dati esistenti, calcolo e misurazione. Non sono un unico round in contanti. I 300 milioni aziendali vengono collettivamente da tre società, non soltanto Google. Non è una cellula virtuale completata: il primo grande dataset e modelli affidabili restano obiettivi.
Quattro risorse, non un’unica cassa
DeepMind, Meta e Isomorphic Labs di Alphabet investono insieme 300 milioni senza ripartizione pubblica. Il Dipartimento dell’Energia prevede oltre 500 milioni in cinque anni per misure, immagini, modelli, calcolo e raccolta nei laboratori nazionali.
NIH coordinerà archivi e dati prodotti da precedenti investimenti federali superiori a 500 milioni. Biohub li standardizzerà per l’IA. Non è un nuovo ulteriore contributo monetario NIH dello stesso importo.
Biohub aveva impegnato 500 milioni al lancio di aprile 2026, di cui 400 per microscopia avanzata, criotomografia elettronica e modifica di sistemi biologici a varie scale. Il totale riunisce risorse diverse, non solo denaro nuovo.
L’organizzazione di Mark Zuckerberg e Priscilla Chan cita Allen Institute, Broad Institute, Gladstone Institutes, Human Cell Atlas, Human Protein Atlas e Wellcome Sanger Institute. Nvidia offre tecnologia e competenza di calcolo. Standard, identificatori e accesso centrale sono lavoro scientifico, non decorazione amministrativa.
Disegni, etichette, strumenti e qualità differenti possono insegnare al modello quale laboratorio misura invece della biologia. Esperimenti coordinati, metadati e trattamento compatibile devono crescere con la scala. Alex Rives attende il grande dataset tra circa un anno, intorno a ottobre 2027, e modelli accurati entro cinque. Sono mete senza un criterio universale già definito.
Prima di prevedere bisogna misurare
La cellula virtuale può essere un programma mirato, non animazione o simulatore universale. Le domande riguardano silenziamento genetico, composti, nutrienti o malattia e l’effetto su attività molecolare e comportamento.
Gli output includono espressione, proteine, struttura, segnali e risposte. Servono coppie prima e dopo modifiche controllate, ripetute per cellule, condizioni, dosi e tempo. Gli archivi pubblici hanno centinaia di milioni di osservazioni; Rives parla di miliardi e poi migliaia di miliardi.
La quantità non basta. Mille miliardi di misure poco documentate possono amplificare distorsioni. La trascrittomica spaziale mantiene la posizione nel tessuto, la criotomografia mostra strutture interne tridimensionali e gli screening di perturbazione misurano reazioni genetiche o ambientali. Sono strati diversi, non sostituti.
Il progetto unisce molecole, cellule, tessuti e organismi. Pushmeet Kohli di DeepMind sottolinea un patrimonio aperto e standardizzato di risposte sperimentali. AlphaFold offre esperienza su struttura e interazioni, ma la cellula dinamica non è soltanto un problema proteico più grande.
Un gruppo sull’Alzheimer potrebbe ordinare interventi per effetto e incertezza prima dell’esperimento. Il laboratorio resta decisivo; il modello apprende dal risultato e sceglie il prossimo test informativo. L’apprendimento attivo migliora la scelta, non elimina gli esperimenti.
Generalizzare resta difficile. Una linea coltivata non rappresenta necessariamente tessuto umano primario, né una dose un’altra. Donatore, sviluppo, malattia, vicini, nutrienti e terapie precedenti cambiano le risposte. Modelli utili circoscritti possono precedere la simulazione universale.
L’infrastruttura comune offre un vantaggio privato
Biohub promette apertura finale alla scienza. Secondo Rives, dati pubblicamente finanziati non avranno embargo privato. Quelli aziendali daranno ai finanziatori un periodo anticipato, di durata non annunciata.
L’incentivo paga esperimenti costosi, ma permette a partner ricchi di costruire modelli e metodi prima di università e piccole biotecnologie. L’apertura successiva non cancella il vantaggio temporale.
Isomorphic Labs opera nella scoperta di farmaci, dove perturbazioni aiutano bersagli e composti. DeepMind porta esperienza biologica. Il percorso commerciale diretto di Meta è meno chiaro pur con ricerca e legame di Zuckerberg. Collaborazione non significa fine della concorrenza.
Credibilità dipende da embargo, licenza, metadati, download e risultati negativi. Il modello deve imparare assenza di effetto, non solo risposte interessanti pubblicate. Le schede devono indicare metodi, donatori, contesti, limiti e controlli, con correzioni accessibili agli esterni.
Identificatori stabili, versioni archiviate e accesso duraturo sostengono riproducibilità. File aperti non pagano il calcolo accademico; Nvidia non definisce già l’allocazione. Accessi, risorse, modelli e privacy decidono se sarà infrastruttura condivisa o un bene aziendale pubblicato dopo.
Dati proprietari concentrano capacità e limitano controllo, finanziamento soltanto pubblico può non attirare capitale o velocità equivalenti. La fondazione OpenAI con dati medici e biologici e l’attività di laboratorio Anthropic mostrano la strategicità. Conta il governo, non Google contro Meta.
I benchmark separano denaro e accuratezza
Il primo concorso Arc prevedeva espressione dopo soppressione di geni nelle staminali embrionali umane: circa 300.000 profili di singole cellule e 300 perturbazioni. Oltre 5.000 persone da 114 paesi si sono registrate, oltre 1.200 gruppi hanno inviato risultati e più di 300 completato la fase finale.
Arc ha riferito che i modelli non superavano costantemente basi semplici in ogni metrica. I migliori distinguevano perturbazioni e geni modificati, ma mescolavano deep learning e caratteristiche statistiche classiche. End-to-end puro non risolveva. Non prova impossibilità, ma il limite di dati noti come prova per biologia ignota.
Il concorso 2026 chiede risposte in sei linee senza quelle perturbazioni nel training, un caso zero-shot più vicino alla scienza. STATE ha appreso da osservazioni di 167 milioni di cellule e perturbazioni di oltre 100 milioni in 70 contesti umani. Anche così la copertura resta sparsa.
L’espressione non è l’unico esito. Posizione delle proteine, forma, metabolismo, tossicità e comunicazione possono cambiare senza firma trascrizionale evidente. Ordinare bersagli può essere utile pur non consentendo previsione clinica. Servono modelli, misure e incertezze diverse.
Cinque anni di obiettivo richiedono definire cellule, interventi, laboratori, condizioni nuovi e errore tollerabile. Laboratori indipendenti con strumenti e campioni diversi devono riprodurre. Una prova prospettica che seleziona esperimenti e migliora decisioni vale più di immagini o classifiche retrospettive.
I prossimi traguardi sono prove, non terapie
Il primo dataset va giudicato per cellule, interventi, dosi, tempi, donatori, negativi, misure grezze e metadati, non dimensione. Uscita stretta o tardiva indebolisce il calendario; standard e interoperabilità valgono anche se la cellula universale tarda.
I test devono oltrepassare memoria e artefatti verso tessuti ignoti, chimica, tempi lunghi e misure oltre l’espressione. Conta beneficio sperimentale prospettico indipendente. Farmaci più rapidi restano ipotesi; tossicità, produzione, studi e regolazione restano.
Occorre pubblicare partner con priorità, periodi, date di apertura e correzioni. Ciò permette confronti equi, non marketing di risultati scelti come vasta intelligenza biologica.
Per scienza e biotecnologie i prodotti vicini sono dati, standard, strumenti e modelli sperimentali, non una cura l’anno prossimo. Biohub finanzia lavoro fisico che l’IA non raccoglie dal web. Primo rilascio, test indipendenti e governo efficace mostreranno se nascerà scienza condivisa affidabile.
Fonti
Espansione Biohub · Finanziamento e accesso · Carenza di dati biologici · Risultati del concorso Arc · Programma Arc · Definizioni di cellula virtuale · Resoconto originale