
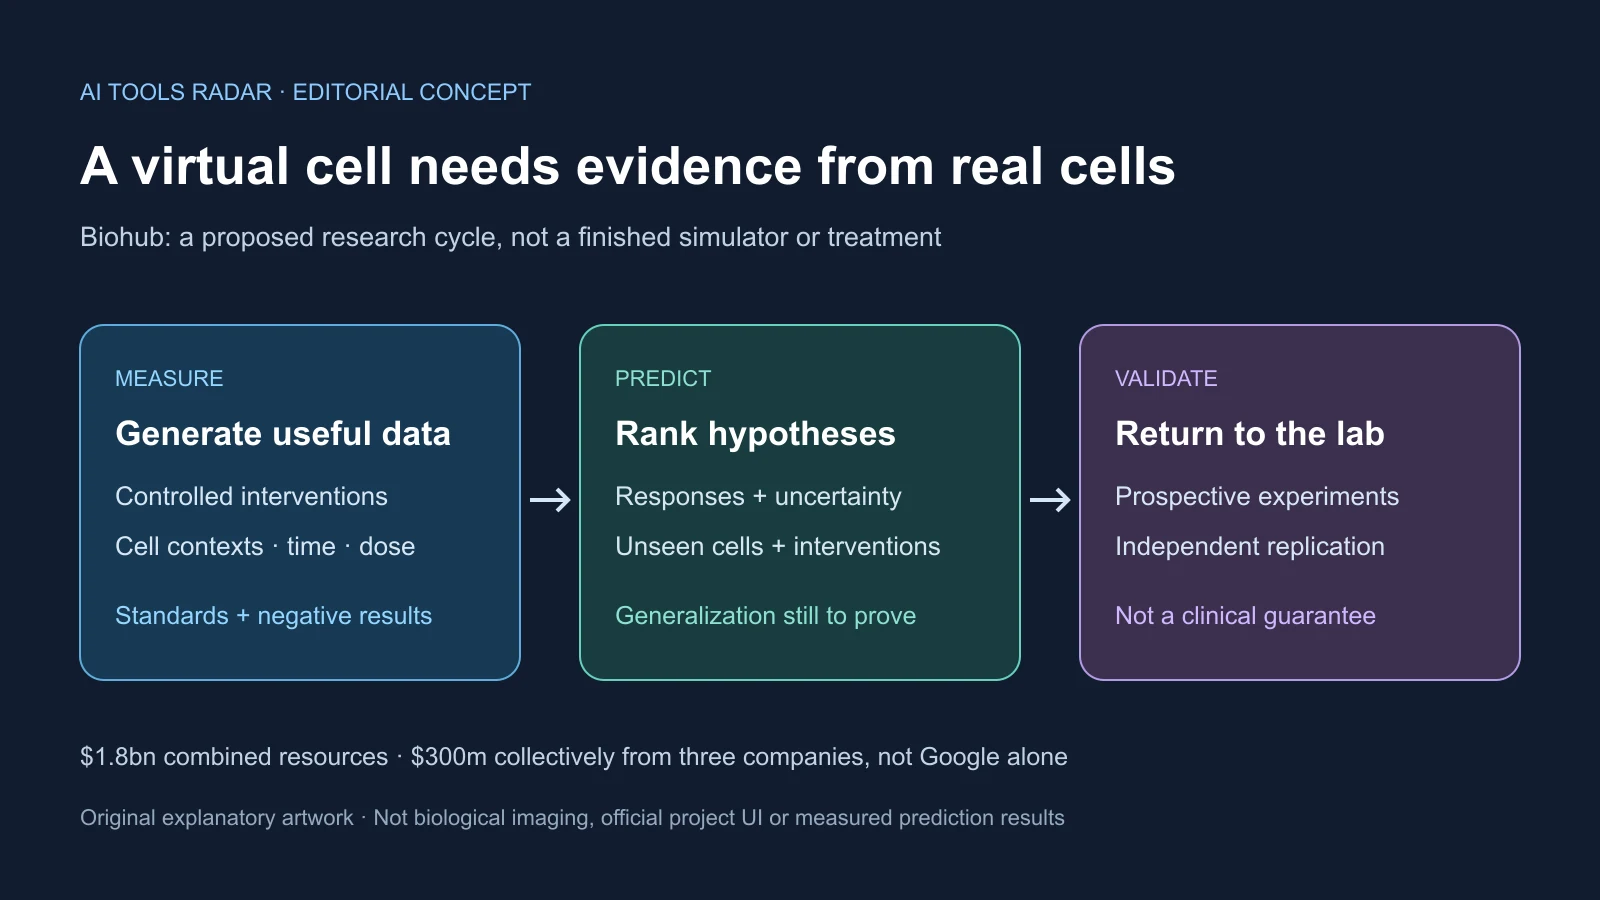
Biohubが拡大するVirtual Biology Initiativeは、生物AIの次の前進に必要なのはモデルの巨大化だけでなく実験の証拠だという賭けである。2026年10月7日発表の計画は、Google DeepMind、Meta、Isomorphic Labs、連邦機関、科学機関を集め、生きた細胞が介入へどう反応するかの高価なデータ生成を支える。
18億ドルという額は資金、既存データ、計算、測定技術を含む。単一の現金融資ではなく、企業投資3億ドルはGoogle単独でなく3社共同だ。完成した仮想細胞の発表でもない。最初の大規模データと信頼できる予測モデルは将来の目標だ。
交換可能でない四つの資源
DeepMind、Meta、Alphabet傘下Isomorphic Labsの3億ドルは内訳未公表。エネルギー省は5年で5億ドル超を計画し、国立研究所を通じ測定、画像、モデル、計算、収集を支える。
NIHは過去の5億ドル超の連邦投資で作られた保存庫とデータを調整し、BiohubがAI用に標準化する。同額の新たなNIH現金拠出ではない。
Biohubは2026年4月の開始時に5億ドルを約束し、うち4億ドルを先端顕微鏡、クライオ電子線トモグラフィー、多尺度で生物系を改変する技術に充てた。合計は種類の違う資源の約束で、すべて新資金ではない。
Mark ZuckerbergとPriscilla Chanが設立した非営利組織はAllen Institute、Broad Institute、Gladstone Institutes、Human Cell Atlas、Human Protein Atlas、Wellcome Sanger Instituteなどを挙げ、Nvidiaは計算技術と専門知識を提供する。共通標準、ID、中央入口も核心である。
設計、ラベル、機器、品質管理が違うと、モデルは生物でなく測った研究所を学びかねない。共同実験、メタデータ、互換処理が規模に伴う必要がある。科学責任者Alex Rivesによれば初回大規模データは約1年後の2027年10月ごろ、精度の高いモデルは5年以内が目標。普遍的な精度基準による成功判定はまだない。
予測前に測定すべきこと
仮想細胞は精密な動画や万能模擬装置ではなく、限定した予測プログラムでもよい。遺伝子抑制、化合物、栄養変更、病的環境が分子活動と行動をどう変えるかが問いになる。
出力は遺伝子発現だけでなくタンパク質、構造、信号、観測できる反応だ。制御した変化の前後を対で測り、細胞、条件、用量、時間を変えて反復する。公開集積は数億の観測だが、Rivesは信頼できる予測には数十億、最終的に数兆が必要とした。
量だけでは不十分で、記録の悪い兆単位データは偏りを拡大する。空間トランスクリプトミクスは組織内位置を保ち、クライオ電子線トモグラフィーは内部構造の詳細な三次元像、摂動スクリーニングは遺伝子や環境変更後の反応を得る。別の層を表し、代替ではない。
分子、細胞、組織、個体をまたぐ連携が構想される。DeepMindのPushmeet Kohliは標準化された開放的な実験応答コモンズを基盤とした。AlphaFoldの構造・相互作用経験は関連しても、動的な全細胞は大きなタンパク質問題だけではない。
アルツハイマー経路の研究なら、影響と不確実性で介入を順位付けして実験を選べる。決定的測定は研究室が行い、結果をモデルへ戻して次の有益な試験を選ぶ。能動学習の狙いは実験の選び方改善で、廃止ではない。
一般化が障害だ。培養株は初代ヒト組織を、一用量は別用量を代表しない。提供者、発達、病気、隣接細胞、栄養、過去治療も影響する。共有データから限定的で有用なモデルが万能模擬装置より先に生まれ得る。
共有基盤には企業の先行利用もある
Biohubは最終的に科学界へ開くという。Rivesによれば政府資金データには私的な公開猶予を設けず、企業資金のデータは出資企業が一時的に先行利用する。期間は未公表だ。
高価な実験を支える誘因だが、大学や小規模バイオ企業より先に有力企業がモデルと方法を作れる。最終公開は時間差を消さない。
Isomorphic Labsは創薬事業で標的と化合物評価に使え、DeepMindは生物AI経験を持つ。Metaの直接商用経路は明確でないが生物モデル研究とZuckerbergの関係がある。共有戦略であって商業競争の終わりではない。
信頼性は猶予期間、ライセンス、メタデータ、取得制限、陰性結果に依存する。効果がない介入も学ぶ必要があり、興味深い結果だけの公開は偏る。データカードには方法、提供者と条件、限界、質管理を含め、外部の訂正窓口も要る。
安定ID、保存版、永続アクセスは再現に重要だ。公開ファイルでも大学が計算費用を払えるとは限らず、Nvidia参加だけで配分は決まらない。アクセス、計算、モデル公開、プライバシーが、共有基盤か遅れて開く企業資産かを決める。
専有データは能力を集中し検証を制限する一方、完全公的資金は投資や速度を集めにくい可能性がある。OpenAI財団の医学生物データ支援やAnthropicの実験室活動も実験データの戦略性を示す。争点はGoogle対Metaでなく統治だ。
既存試験は資金と精度の違いを示す
Arc Instituteの最初の課題はヒト胚性幹細胞の遺伝子抑制後の発現変化で、約30万単細胞プロファイルと300摂動を使った。114カ国5000人超が登録、1200超のチームが提出し300超が最終提出した。
Arcは全指標で単純基準を一貫して上回らなかったと報告した。上位は摂動の区別と変化遺伝子識別を改善したが、深層学習と古典的統計特徴を混ぜていた。純粋な端から端の学習では未解決だった。不可能という意味ではなく、既知データの成功は未知生物の代わりにならない。
2026年は訓練で摂動応答を示さない6細胞株へ難度を上げ、研究に近いゼロショットを問う。STATEは1億6700万細胞の観測と、70のヒト文脈で1億超の細胞の摂動から学んだ。それでも生物の可能性を疎に覆うにとどまる。
発現精度だけが終点でない。タンパク質位置、形態、代謝、毒性、細胞間通信は明確な転写変化なしでも変わる。標的順位付けに有用でも臨床予測に不適切なことがある。問いごとのモデル、測定、不確実性が必要だ。
5年目標には未知の細胞、介入、研究所、条件、許容誤差の定義が要る。違う装置と試料の独立研究所が再現すべきだ。モデルが先に実験を選び判断を改善する前向き研究は、美しい表示や過去データの順位より強い証拠になる。
次は公開証拠であり治療の約束ではない
最初のデータは量だけでなく細胞、介入、用量、時点、提供者、陰性、生測定、メタデータで判断する。狭い・遅い公開は日程を弱めるが、万能細胞が遅れても標準と互換性には価値がある。
未知組織、化学介入、長い時間、発現以外へ評価を広げ、記憶と研究所固有特徴を超える必要がある。前向きで独立した実験上の利益が重要だ。創薬加速は検証前の仮説で、毒性、製造、試験、規制審査は残る。
先行権を持つ相手、期間、各データ公開時期、訂正法も公表すべきだ。これにより公平比較ができるか、選んだ成績を広範な生物知能と売るだけかが変わる。
研究とバイオ企業への近い成果はデータ、標準、機器、実験モデルで、来年の新治療ではない。Biohubの意義はネット収集できない物理作業を支える点にある。最初の公開、独立前向き試験、実効性ある統治が共有科学の信頼性を示す。
情報源
Biohub拡張発表 · 資金とアクセス条件の報道 · 生物データの不足 · Arcコンテスト結果 · Arc仮想細胞計画 · 仮想細胞の定義 · 元の報道