
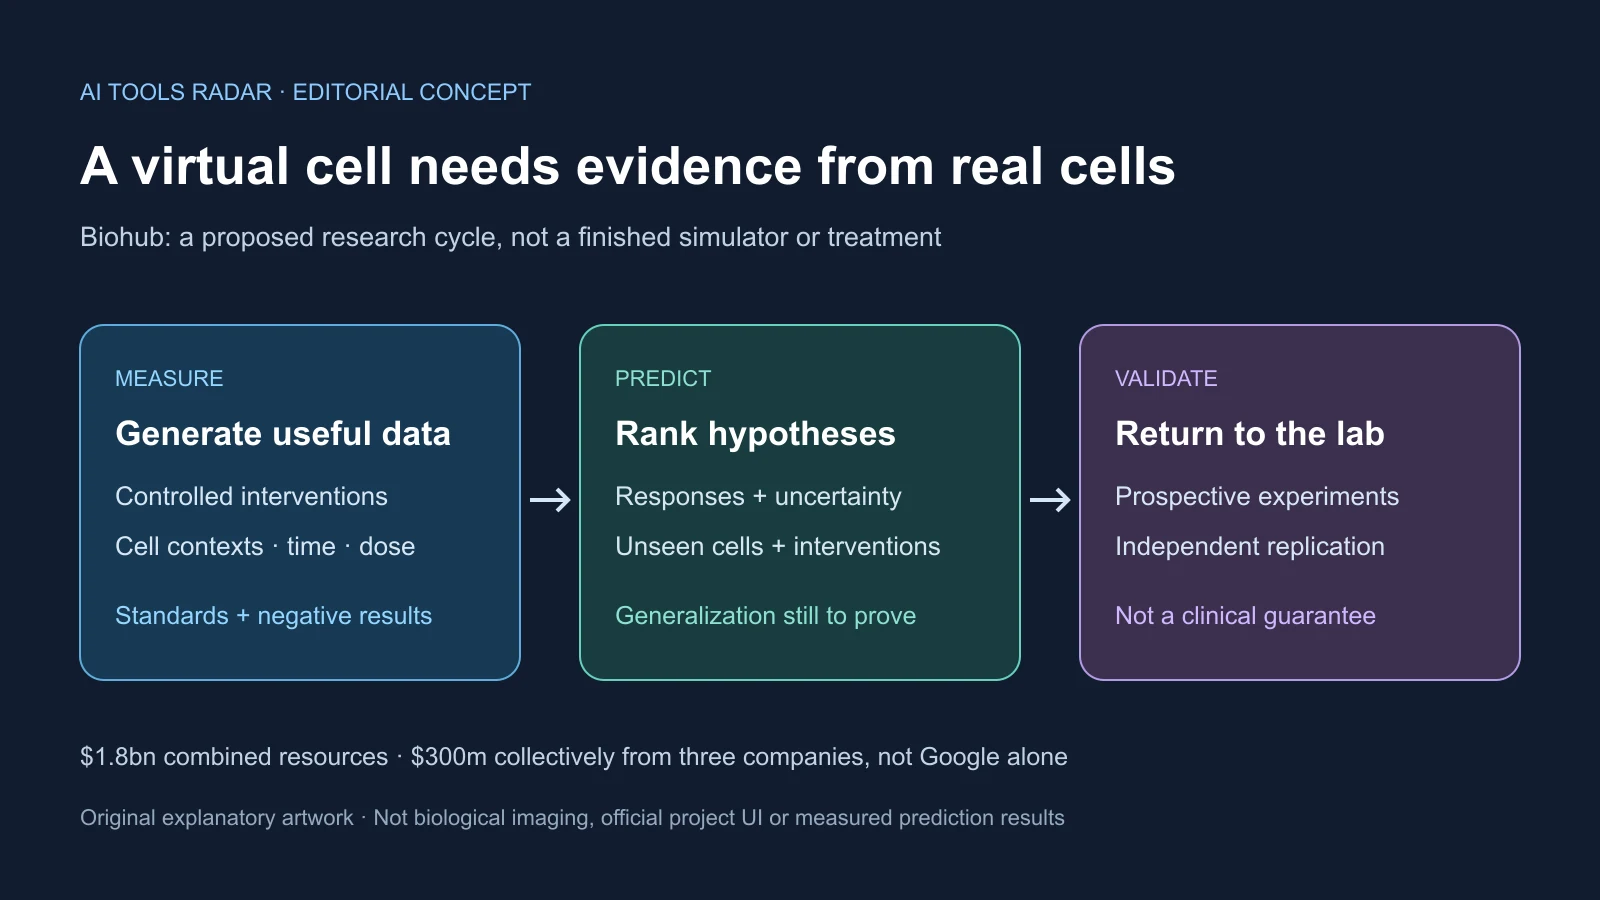
Rozszerzona Virtual Biology Initiative Biohub zakłada, że kolejny postęp biologicznej AI wymaga dowodów laboratoryjnych, nie tylko większego modelu. Program ogłoszony 7 października 2026 r. łączy Google DeepMind, Meta, Isomorphic Labs, agencje federalne i instytuty wokół kosztownego tworzenia danych o reakcjach żywych komórek na interwencje.
Deklarowane 1,8 mld USD obejmuje finansowanie, istniejące dane, obliczenia i pomiary. Nie jest jedną rundą gotówkową. Korporacyjne 300 mln pochodzi wspólnie od trzech firm, nie od samego Google. Nie ogłoszono też gotowej komórki: duży zbiór i wiarygodne modele są celami na przyszłość.
Cztery rodzaje zasobów zamiast jednego worka pieniędzy
DeepMind, Meta i należące do Alphabet Isomorphic Labs wspólnie inwestują 300 mln bez podziału kwot. Departament Energii planuje ponad 500 mln przez pięć lat na pomiary, obrazowanie, modelowanie, obliczenia i zbieranie danych w laboratoriach narodowych.
NIH skoordynuje repozytoria i zbiory powstałe dzięki wcześniejszym inwestycjom federalnym ponad 500 mln USD. Biohub chce je standaryzować dla AI. To nie nowa dodatkowa wpłata NIH tej samej wysokości.
Biohub przy starcie w kwietniu 2026 r. zobowiązał się do 500 mln, z czego 400 mln na nowe pomiary: zaawansowaną mikroskopię, kriotomografię elektronową i modyfikowanie układów biologicznych w wielu skalach. Razem to różne zasoby, nie wyłącznie nowa gotówka.
Organizacja założona przez Marka Zuckerberga i Priscillę Chan wskazała Allen Institute, Broad Institute, Gladstone Institutes, Human Cell Atlas, Human Protein Atlas i Wellcome Sanger Institute. Nvidia dostarczy technologię obliczeniową i wiedzę. Standardy, identyfikatory i centralny dostęp są częścią badań, nie ozdobą administracyjną.
Różne projekty, etykiety, aparatura i kontrola jakości mogą nauczyć model laboratorium zamiast biologii. Ze skalą muszą rosnąć skoordynowane eksperymenty, metadane i zgodne przetwarzanie. Alex Rives oczekuje dużego zbioru za około rok, koło października 2027, i dokładnych modeli w pięć lat. To cele bez uniwersalnego kryterium sukcesu.
Co trzeba zmierzyć przed przewidywaniem
Wirtualna komórka może oznaczać wąski program predykcyjny, nie animację ani uniwersalny symulator. Pytania dotyczą wyciszenia genu, związku chemicznego, odżywiania lub warunków choroby i ich wpływu na aktywność oraz zachowanie.
Wyjścia obejmują ekspresję genów, białka, strukturę, sygnały i reakcje. Potrzeba sparowanych pomiarów przed kontrolowaną zmianą i po niej, powtarzanych dla typów komórek, warunków, dawek i czasu. Publiczne zbiory mają setki milionów obserwacji; Rives mówi o miliardach, a docelowo bilionach.
Ilość nie wystarcza. Bilion źle udokumentowanych pomiarów może powiększyć błąd. Transkryptomika przestrzenna zachowuje miejsce w tkance, kriotomografia daje szczegółową strukturę trójwymiarową, a przesiewowe perturbacje mierzą reakcję na geny i środowisko. To inne warstwy, nie zamienniki.
Plan obejmuje cząsteczki, komórki, tkanki i organizmy. Pushmeet Kohli z DeepMind podkreślał otwarty standardowy zasób odpowiedzi eksperymentalnych. Doświadczenie AlphaFold ze strukturą i oddziaływaniami białek jest istotne, lecz dynamiczna komórka nie jest po prostu większym problemem struktury.
Zespół choroby Alzheimera mógłby ustawiać interwencje według efektu i niepewności, wybierając eksperyment. Decydujący pomiar nadal robi laboratorium; model uczy się z wyniku i wybiera następny informacyjny test. Aktywne uczenie poprawia wybór eksperymentów, nie usuwa ich.
Uogólnianie pozostaje trudne. Linia hodowlana nie reprezentuje pierwotnej tkanki ludzkiej, dawka innej dawki. Dawca, rozwój, choroba, sąsiedzi, składniki i wcześniejsze leczenie zmieniają reakcje. Wąsko przydatne modele mogą wyprzedzić uniwersalną symulację.
Wspólna infrastruktura daje prywatny start wcześniej
Biohub obiecuje ostateczne otwarcie dla nauki. Według Rivesa dane publicznie finansowane nie mają prywatnego embarga; finansowane korporacyjnie dadzą fundatorom czasowy wcześniejszy dostęp. Długości nie ogłoszono.
Bodziec opłaca drogie eksperymenty, ale pozwala bogatym partnerom budować modele i metody przed uczelniami i małymi firmami biotechnologicznymi. Późniejsze otwarcie nie znosi przewagi czasowej.
Isomorphic Labs prowadzi odkrywanie leków, gdzie perturbacje pomagają celom i związkom. DeepMind ma doświadczenie biologicznej AI. Bezpośrednia droga komercyjna Meta jest mniej jasna mimo badań i więzi Zuckerberga. Współpraca nie kończy konkurencji.
Wiarygodność zależy od embarga, licencji, metadanych, ograniczeń pobierania i wyników negatywnych. Model musi poznać brak efektu, nie tylko ciekawe opublikowane wyniki. Karty zbiorów powinny opisywać metody, dawców, kontekst, ograniczenia i jakość, a zewnętrzni badacze potrzebują korekt.
Stabilne identyfikatory, archiwalne wersje i trwały dostęp podtrzymują odtwarzalność. Otwarte pliki nie dają uczelniom środków na obliczenia; udział Nvidii nie ustala przydziału. Dostęp, zasoby, modele i prywatność zdecydują, czy to wspólna infrastruktura czy później ujawniony zasób firm.
Dane własnościowe koncentrują możliwości i ograniczają kontrolę, a czysto publiczny projekt może nie przyciągnąć podobnych pieniędzy i tempa. Finansowanie medycznych danych przez fundację OpenAI i laboratoryjna działalność Anthropic też pokazują strategiczność. Test dotyczy zarządzania, nie Google przeciw Meta.
Istniejące testy oddzielają pieniądze od dokładności
Pierwszy konkurs Arc przewidywał ekspresję po tłumieniu genów w ludzkich embrionalnych komórkach macierzystych: około 300 tys. profili pojedynczych komórek i 300 perturbacji. Zarejestrowało się ponad 5000 osób ze 114 krajów, zgłosiło ponad 1200 zespołów, a ponad 300 skończyło finał.
Arc podał, że modele nie wygrywały stale z prostymi bazami we wszystkich metrykach. Najlepsze lepiej rozróżniały perturbacje i zmienione geny, lecz mieszały głębokie uczenie z klasycznymi cechami statystycznymi. Samo end-to-end nie rozwiązało zadania. Nie oznacza to niemożliwości, lecz ograniczenie znanych danych jako dowodu dla nieznanej biologii.
W 2026 r. zadanie obejmuje sześć linii bez udostępnionych w treningu perturbacji, bliższy nauce wariant zero-shot. STATE uczył się z obserwacji 167 mln komórek i perturbacji ponad 100 mln w 70 ludzkich kontekstach. Nawet to rzadko pokrywa możliwości biologiczne.
Ekspresja nie jest jedynym końcem. Lokalizacja białek, kształt, metabolizm, toksyczność i komunikacja mogą się zmienić bez wyraźnej sygnatury transkrypcji. Ranking celów może być użyteczny bez przydatności klinicznej. Pytania potrzebują innych modeli, pomiarów i niepewności.
Cel pięciu lat wymaga definicji nowych komórek, interwencji, laboratoriów, warunków i tolerancji błędów. Niezależne zespoły z inną aparaturą i próbkami powinny powtarzać. Prospektywne wybieranie eksperymentów przez model i lepsze decyzje to mocniejsze dowody niż obraz lub ranking retrospektywny.
Kolejne etapy to dowody, nie terapia
Pierwszy zbiór trzeba oceniać według komórek, interwencji, dawek, czasu, dawców, wyników negatywnych, surowych pomiarów i metadanych, nie rozmiaru. Wąski lub późny zbiór osłabi harmonogram; standardy i zgodność mogą mieć wartość mimo opóźnionej uniwersalnej komórki.
Testy muszą wyjść poza zapamiętywanie i artefakty do obcych tkanek, chemii, długiego czasu i pomiarów poza ekspresją. Liczy się niezależna prospektywna korzyść. Szybsze leki są hipotezą do sprawdzenia; pozostają toksyczność, produkcja, badania i regulacje.
Trzeba opublikować partnerów z pierwszeństwem, okresy, daty otwarcia i poprawki. To umożliwi uczciwe porównanie zamiast sprzedawania wybranych wyników jako szerokiej inteligencji biologicznej.
Bliskie produkty dla nauki i biotechnologii to dane, standardy, aparatura i modele eksperymentalne, nie terapia za rok. Biohub finansuje fizyczną pracę, której nie da się pobrać z sieci. Pierwsze dane, niezależne testy i skuteczne zarządzanie pokażą, czy powstanie wiarygodna wspólna nauka.
Źródła
Rozszerzenie Biohub · Warunki finansowania i dostępu · Brak danych biologicznych · Wyniki konkursu Arc · Program wirtualnej komórki Arc · Definicje wirtualnej komórki · Pierwotna relacja