
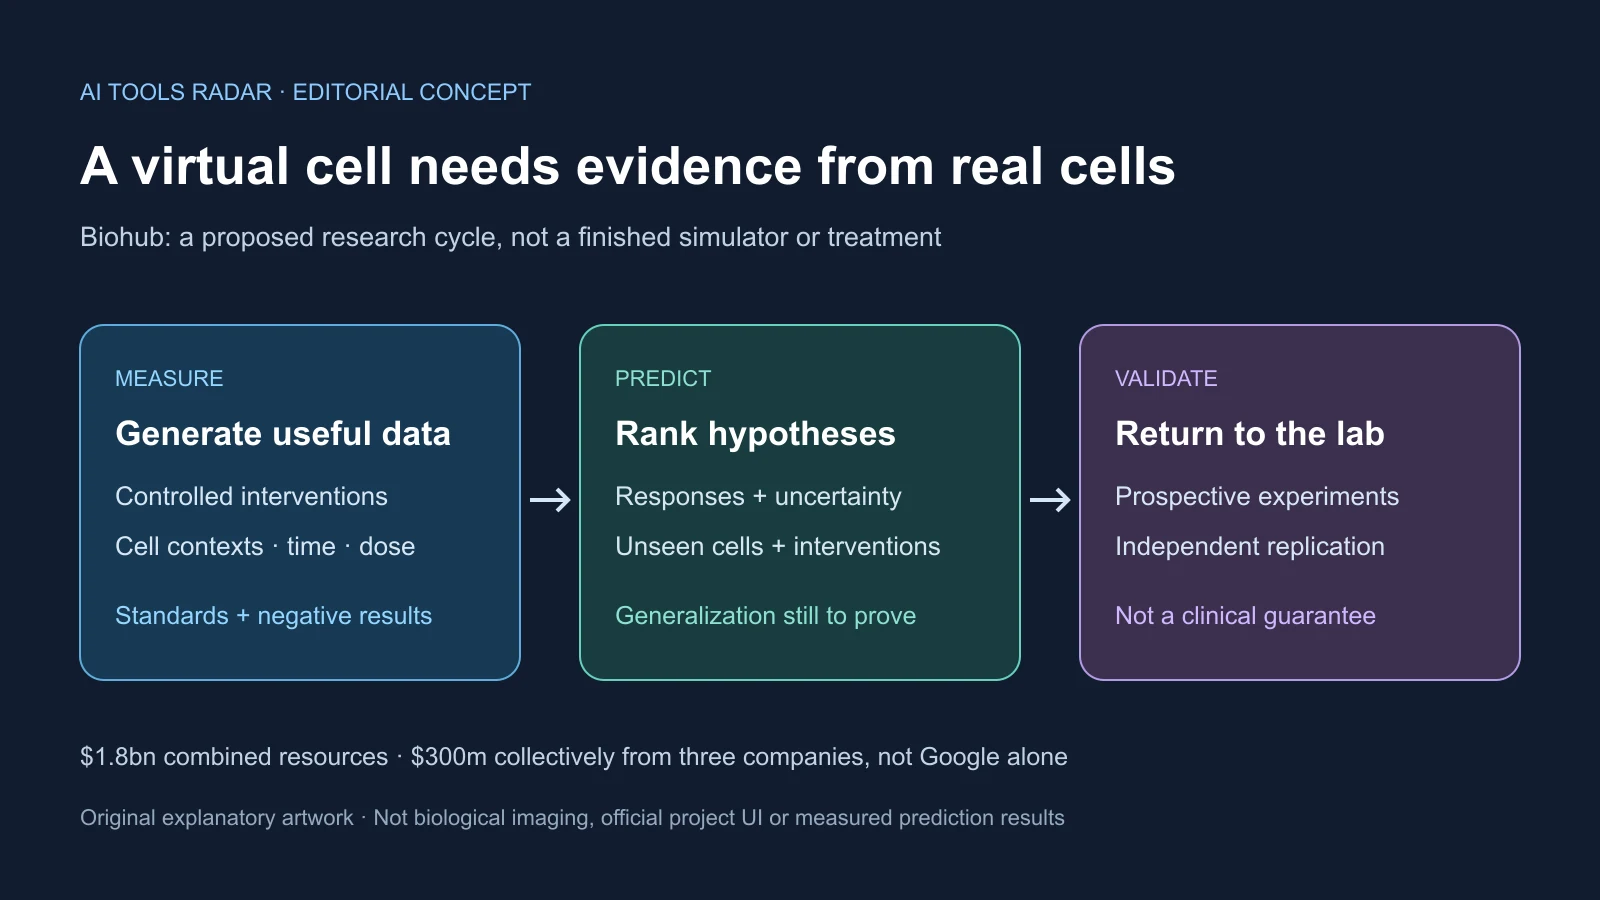
La Virtual Biology Initiative élargie de Biohub parie que le prochain progrès de l’IA biologique exige des preuves de laboratoire, pas seulement un modèle plus grand. Annoncé le 7 octobre 2026, le programme réunit Google DeepMind, Meta, Isomorphic Labs, agences fédérales et instituts pour produire des données coûteuses sur la réponse des cellules vivantes aux interventions.
Les 1,8 milliard de dollars annoncés comprennent financement, données existantes, calcul et mesure. Ce n’est pas une levée unique en espèces. Les 300 millions privés viennent ensemble de trois entreprises, pas de Google seul. Aucune cellule virtuelle achevée n’est annoncée : grand jeu de données et modèles fiables sont des objectifs futurs.
Quatre ressources, pas une caisse interchangeable
DeepMind, Meta et Isomorphic Labs d’Alphabet investissent 300 millions ensemble sans répartition publiée. Le département de l’Énergie prévoit plus de 500 millions sur cinq ans pour mesures, images, modèles, calcul et collecte dans ses laboratoires nationaux.
Le NIH coordonnera des répertoires et données issus de plus de 500 millions d’investissements fédéraux antérieurs. Biohub veut les standardiser pour l’IA. Ce n’est pas un nouvel apport monétaire NIH de même montant.
Biohub avait engagé 500 millions au lancement d’avril 2026, dont 400 pour microscopie avancée, cryotomographie électronique et modification de systèmes à plusieurs échelles. Le total rassemble des ressources différentes, pas uniquement de l’argent neuf.
L’organisation de Mark Zuckerberg et Priscilla Chan cite Allen Institute, Broad Institute, Gladstone Institutes, Human Cell Atlas, Human Protein Atlas et Wellcome Sanger Institute. Nvidia apporte calcul et expertise. Normes, identifiants et accès central sont du travail scientifique, pas un décor administratif.
Plans, étiquettes, instruments et contrôles différents peuvent apprendre au modèle quel laboratoire mesure plutôt que la biologie. Expériences coordonnées, métadonnées et traitements compatibles doivent accompagner l’échelle. Alex Rives attend le grand jeu dans un an environ, vers octobre 2027, et des modèles précis sous cinq ans. Ce sont des cibles sans critère universel déjà défini.
Mesurer avant de prédire
Une cellule virtuelle peut être un programme ciblé, pas une animation réaliste ou un simulateur universel. Les questions concernent suppression de gènes, composés, nutriments ou conditions de maladie et leur effet moléculaire et comportemental.
Les sorties incluent expression, protéines, structure, signaux et réactions. Il faut des mesures appariées avant et après changements contrôlés, répétées par cellules, conditions, doses et temps. Les collections publiques couvrent des centaines de millions d’observations ; Rives parle de milliards puis de milliers de milliards.
La quantité ne suffit pas. Mille milliards de mesures mal documentées amplifient les biais. La transcriptomique spatiale conserve la localisation tissulaire ; la cryotomographie montre les structures internes en trois dimensions ; les criblages de perturbation mesurent les réponses génétiques et environnementales. Ce sont des couches distinctes.
Le programme lie molécules, cellules, tissus et organismes. Pushmeet Kohli de DeepMind souligne un commun ouvert et standardisé des réponses expérimentales. AlphaFold apporte une expérience de structure et d’interactions, mais la cellule dynamique n’est pas simplement un problème protéique agrandi.
Une équipe Alzheimer pourrait classer les interventions selon effet et incertitude avant l’expérience. Le laboratoire fait toujours la mesure décisive ; le modèle apprend et aide à choisir le prochain test informatif. L’apprentissage actif améliore le choix sans supprimer l’expérience.
Généraliser reste difficile. Une lignée ne représente pas forcément un tissu humain primaire, ni une dose une autre. Donneur, développement, maladie, voisins, nutriments et traitements antérieurs changent la réponse. Des modèles étroits utiles peuvent précéder la simulation universelle.
L’infrastructure commune offre une avance privée
Biohub promet une ouverture finale aux scientifiques. Selon Rives, les données financées publiquement n’auront pas d’embargo privé. Les données privées donneront aux financeurs un accès temporaire anticipé, de durée non annoncée.
L’incitation paie des expériences chères mais permet aux partenaires riches de créer modèles et méthodes avant universités et petites biotechnologies. L’ouverture ultérieure n’efface pas l’avance.
Isomorphic Labs découvre des médicaments, où les perturbations peuvent aider cibles et composés. DeepMind a une expérience biologique. La voie commerciale directe de Meta est moins nette malgré recherches et lien de Zuckerberg. La coopération ne termine pas la concurrence.
La crédibilité dépend d’embargos, licences, métadonnées, téléchargements et résultats négatifs. Le modèle doit apprendre l’absence d’effet, pas seulement les réponses intéressantes publiées. Les fiches doivent décrire méthodes, donneurs, contextes, limites et qualité, avec correction accessible aux chercheurs extérieurs.
Identifiants stables, versions archivées et accès durable servent la reproductibilité. Les fichiers ouverts ne paient pas le calcul universitaire ; Nvidia ne règle pas déjà l’allocation. Accès, calcul, modèles et confidentialité décideront entre infrastructure partagée et actif privé publié plus tard.
Les données propriétaires concentrent les capacités et limitent l’examen ; un financement seulement public pourrait attirer moins de capitaux ou de vitesse. La fondation OpenAI finançant données médicales et biologiques, et l’activité de laboratoire Anthropic, montrent leur importance stratégique. Le test est la gouvernance, pas Google contre Meta.
Les tests existants séparent argent et précision
Le premier défi Arc prédisait l’expression après inhibition de gènes dans des cellules souches embryonnaires humaines : environ 300 000 profils de cellules individuelles et 300 perturbations. Plus de 5 000 personnes de 114 pays se sont inscrites, plus de 1 200 équipes ont soumis et plus de 300 achevé leur participation finale.
Arc rapporte que les modèles ne dépassaient pas régulièrement les références simples sur toutes les métriques. Les meilleurs distinguaient perturbations et gènes modifiés en mélangeant apprentissage profond et caractéristiques statistiques classiques. Le bout en bout pur n’avait pas résolu la tâche. Ce n’est pas une impossibilité, mais la limite des données familières comme preuve sur l’inconnu.
Le défi 2026 demande les réactions de six lignées sans leurs réponses aux perturbations dans les données d’entraînement, une situation zéro-shot plus proche de la recherche. STATE a appris sur 167 millions de cellules observées et plus de 100 millions perturbées dans 70 contextes humains. Même ainsi, la couverture demeure clairsemée.
L’expression n’est pas le seul résultat. Localisation protéique, forme, métabolisme, toxicité et communication changent sans signature transcriptionnelle évidente. Classer des cibles peut aider sans convenir à la clinique. Les questions nécessitent modèles, mesures et incertitudes différents.
Cinq ans d’objectif exigent cellules, interventions, laboratoires, conditions inédites et erreur tolérée définis. Des laboratoires indépendants avec d’autres instruments et échantillons doivent reproduire. Une étude prospective où le modèle choisit les expériences et améliore les décisions vaut plus qu’une image ou un classement rétrospectif.
Les prochaines étapes sont des preuves, pas des traitements
Le premier jeu doit être jugé sur cellules, interventions, doses, temps, donneurs, négatifs, mesures brutes et métadonnées, pas le volume seul. Une sortie étroite ou tardive affaiblit le calendrier ; normes et interopérabilité valent même si la cellule universelle tarde.
Les tests doivent dépasser mémoire et artefacts vers tissus inconnus, chimie, temps longs et mesures autres que l’expression. L’avantage prospectif indépendant compte. Accélérer les médicaments reste une hypothèse ; toxicité, fabrication, essais et réglementation demeurent.
Il faut publier partenaires prioritaires, durées, dates d’ouverture et corrections. Cela permet une comparaison équitable, pas de vendre des résultats choisis comme large intelligence biologique.
Les produits proches pour science et biotechnologie sont données, normes, instruments et modèles expérimentaux, pas un traitement l’an prochain. Biohub finance le travail physique que l’IA ne trouve pas sur le Web. Première publication, tests indépendants et gouvernance effective diront s’il devient science commune fiable.
Sources
Extension Biohub · Conditions financières et d’accès · Manque de données biologiques · Résultats du défi Arc · Programme cellulaire Arc · Définitions de cellule virtuelle · Article original