
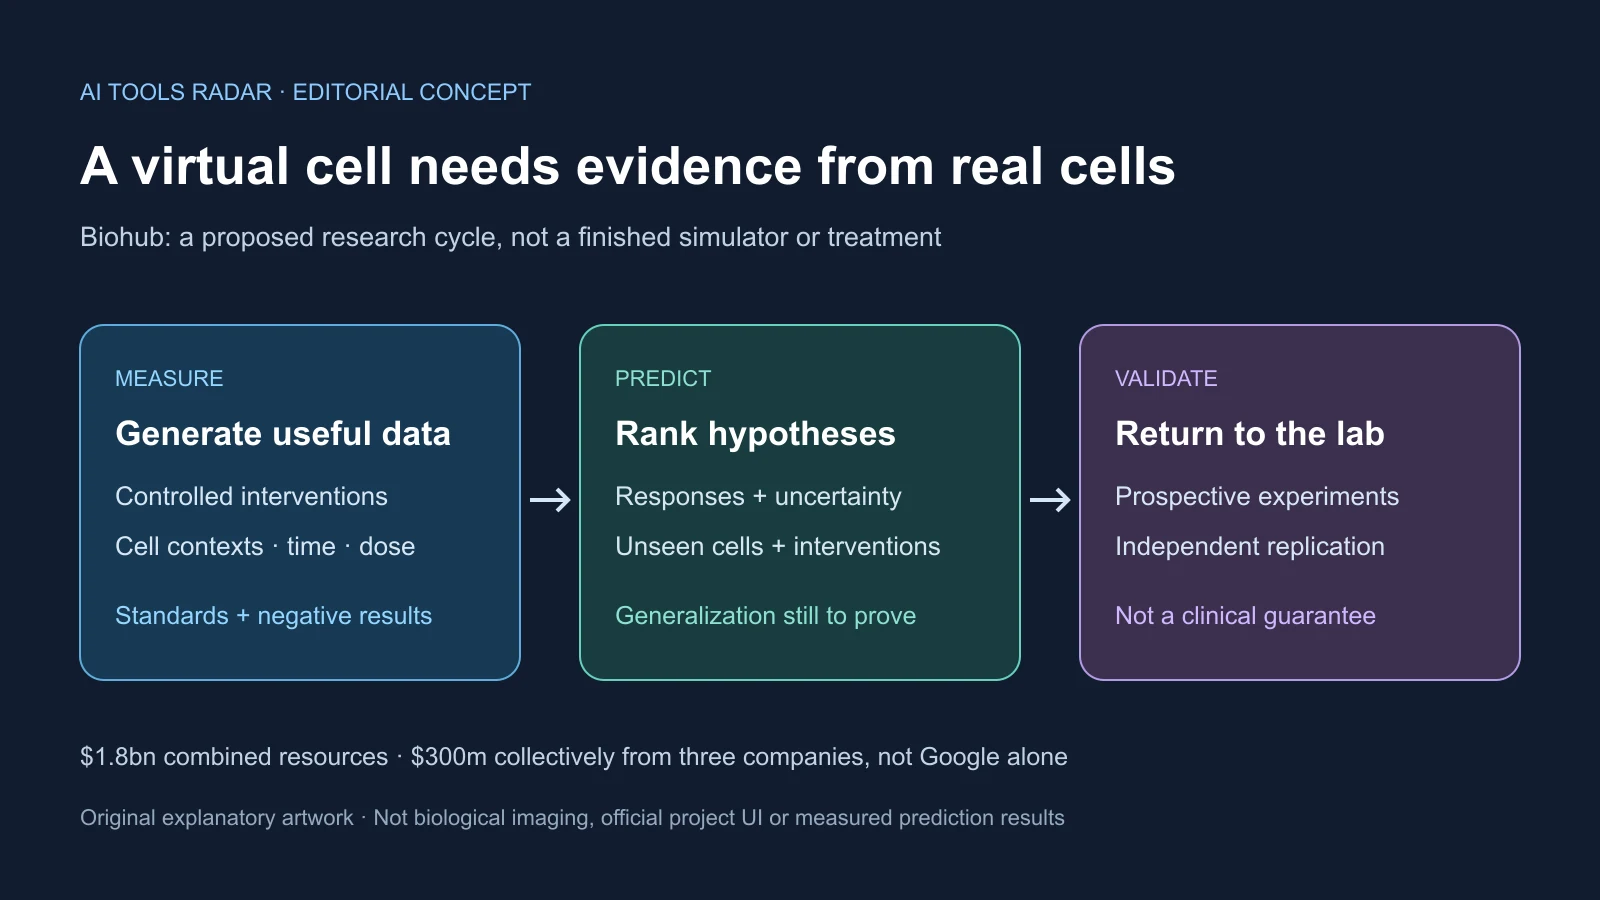
A Virtual Biology Initiative ampliada da Biohub aposta que o próximo avanço da IA biológica exige evidência de laboratório, não apenas um modelo maior. Anunciado em 7 de outubro de 2026, o programa reúne Google DeepMind, Meta, Isomorphic Labs, agências federais e institutos na tarefa cara de produzir dados sobre como células vivas respondem a intervenções.
Os US$ 1,8 bilhão declarados incluem financiamento, dados existentes, computação e medição. Não são uma rodada única em dinheiro. Os US$ 300 milhões corporativos são coletivos de três empresas, não do Google sozinho. Tampouco foi anunciada uma célula pronta: o primeiro grande conjunto e modelos confiáveis são metas futuras.
Quatro fluxos de recursos, não um único caixa
DeepMind, Meta e Isomorphic Labs, da Alphabet, investirão juntas US$ 300 milhões, sem divisão divulgada. O Departamento de Energia planeja mais de US$ 500 milhões em cinco anos para medição, imagens, modelagem, computação e coleta pelos laboratórios nacionais.
O NIH coordenará repositórios e dados produzidos por mais de US$ 500 milhões de investimentos federais anteriores. A Biohub pretende padronizá-los para IA. Não é mais uma contribuição nova do NIH em dinheiro no mesmo valor.
A Biohub comprometeu US$ 500 milhões no lançamento de abril de 2026, dos quais US$ 400 milhões para microscopia avançada, criotomografia eletrônica e modificação de sistemas biológicos em várias escalas. O total reúne recursos diferentes, não só financiamento novo.
A organização fundada por Mark Zuckerberg e Priscilla Chan citou Allen Institute, Broad Institute, Gladstone Institutes, Human Cell Atlas, Human Protein Atlas e Wellcome Sanger Institute. A Nvidia fornecerá tecnologia computacional e conhecimento. Padrões, identificadores e acesso central fazem parte do trabalho científico.
Projetos, rótulos, instrumentos e qualidade diferentes podem ensinar ao modelo qual laboratório mediu em vez de biologia relevante. Experimentos coordenados, metadados e processamento compatível precisam acompanhar a escala. Alex Rives espera o primeiro conjunto grande em aproximadamente um ano, perto de outubro de 2027, e modelos precisos em cinco anos. São objetivos sem um critério universal já definido de sucesso.
O que medir antes de prever
Uma célula virtual pode ser um programa preditivo específico, não uma animação ou simulador universal. As perguntas envolvem silenciar genes, adicionar compostos, mudar nutrientes ou condições de doença e prever atividade molecular e comportamento.
Os resultados incluem expressão gênica, proteínas, estrutura, sinalização e reações observáveis. Exigem pares antes e depois de mudanças controladas, repetidos por células, condições, doses e tempo. Coleções públicas têm centenas de milhões de observações; Rives fala em bilhões e, futuramente, trilhões.
Quantidade não basta. Um trilhão de medidas mal documentadas amplia vieses. Transcriptômica espacial preserva a posição no tecido, criotomografia oferece estruturas internas tridimensionais detalhadas, e ensaios de triagem por perturbação medem respostas genéticas ou ambientais. São camadas distintas, não substitutas.
O plano liga moléculas, células, tecidos e organismos. Pushmeet Kohli, da DeepMind, destacou um acervo aberto e padronizado de respostas experimentais. A experiência do AlphaFold com estruturas e interações é relevante, mas a célula dinâmica não é apenas um problema maior de proteína.
Uma equipe de Alzheimer poderia ordenar intervenções por efeito e incerteza antes de escolher experimentos. O laboratório continua fazendo a medição decisiva; o modelo aprende com ela e ajuda a escolher o próximo teste informativo. Aprendizado ativo melhora seleção, não elimina experimentos.
Generalizar continua difícil. Uma linhagem não representa necessariamente tecido humano primário, nem uma dose outra. Doador, desenvolvimento, doença, vizinhança, nutrientes e tratamento anterior alteram respostas. Modelos estreitos úteis podem chegar antes do simulador universal.
Infraestrutura compartilhada também dá vantagem privada
A Biohub promete abertura final à ciência. Segundo Rives, dados públicos não terão embargo privado. Dados corporativos darão aos financiadores acesso temporário antes da publicação; a duração não foi anunciada.
O incentivo paga experiências caras, mas permite que parceiros ricos criem modelos e métodos antes de universidades e pequenas biotecnologias. Abertura posterior não apaga o tempo ganho.
A Isomorphic Labs atua explicitamente em descoberta de medicamentos, com dados úteis a alvos e compostos. A DeepMind tem experiência em IA biológica. A rota comercial direta da Meta é menos clara, apesar da pesquisa e vínculo de Zuckerberg. Cooperação não encerra competição.
A credibilidade depende de embargo, licença, metadados, downloads e resultados negativos. O modelo precisa aprender ausência de efeito, não apenas respostas interessantes publicadas. Fichas devem trazer métodos, doadores, contextos, limites e controles; pesquisadores externos precisam de correções utilizáveis.
Identificadores estáveis, versões arquivadas e acesso durável apoiam reprodução. Arquivos abertos não garantem dinheiro para computação acadêmica; participação da Nvidia não define alocação. Acesso, processamento, modelos e privacidade dirão se é infraestrutura comum ou ativo empresarial publicado depois.
Dados proprietários concentram capacidade e limitam escrutínio, enquanto financiamento só público pode não conseguir capital ou ritmo equivalentes. A fundação da OpenAI financiando dados médicos e biológicos e a atividade laboratorial da Anthropic mostram a importância estratégica. O teste é governança, não Google contra Meta.
Testes existentes separam dinheiro de precisão
O primeiro desafio Arc previa expressão após supressão de genes em células-tronco embrionárias humanas: cerca de 300 mil perfis de células individuais e 300 perturbações. Mais de 5 mil pessoas de 114 países se registraram, mais de 1.200 equipes enviaram e mais de 300 concluíram as submissões finais.
A Arc relatou que os modelos não superaram consistentemente bases simples em todas as métricas. Os melhores distinguiram perturbações e genes alterados, combinando aprendizado profundo e características estatísticas clássicas. End-to-end puro não resolveu. Isso não prova impossibilidade, mas o limite de dados conhecidos como substituto da biologia desconhecida.
O desafio de 2026 pede respostas em seis linhagens sem suas perturbações no treino, cenário zero-shot mais próximo da pesquisa. STATE aprendeu de observações de 167 milhões de células e perturbações de mais de 100 milhões em 70 contextos humanos. Mesmo assim a cobertura é esparsa.
Expressão não é o único desfecho. Localização de proteínas, forma, metabolismo, toxicidade e comunicação podem mudar sem assinatura transcricional clara. Ordenar alvos pode ser útil sem servir para previsão clínica. Perguntas exigem modelos, modalidades e incertezas diferentes.
A meta de cinco anos precisa definir células, intervenções, laboratórios, condições inéditas e tolerância ao erro. Laboratórios independentes com equipamentos e amostras diferentes devem reproduzir. Um estudo prospectivo em que o modelo escolhe experimentos e melhora decisões é mais forte que imagem bonita ou ranking retrospectivo.
Os próximos marcos são provas, não tratamento
O primeiro conjunto deve ser avaliado por células, intervenções, doses, tempos, doadores, negativos, medidas brutas e metadados, não só tamanho. Publicação estreita ou atrasada enfraquece o cronograma; padrões e interoperabilidade ainda podem valer mesmo sem célula universal rápida.
Os testes devem ir além de memorização e artefatos para tecidos desconhecidos, química, tempo longo e medidas além de expressão. Benefício experimental prospectivo independente é o que importa. Medicamentos mais rápidos continuam hipótese; toxicidade, fabricação, ensaios e regulação permanecem.
É preciso publicar parceiros com prioridade, períodos, datas de abertura e correções. Isso permite comparação justa em vez de vender resultados escolhidos como inteligência biológica ampla.
O produto próximo para ciência e biotecnologia é dado, padrão, instrumento e modelo experimental, não tratamento no ano seguinte. A Biohub financia trabalho físico que a IA não coleta da internet. Primeira publicação, testes independentes e governança efetiva mostrarão se surge ciência compartilhada confiável.
Fontes
Expansão Biohub · Termos de financiamento e acesso · Gargalo de dados biológicos · Resultados do desafio Arc · Programa de célula virtual Arc · Definições de célula virtual · Reportagem original