
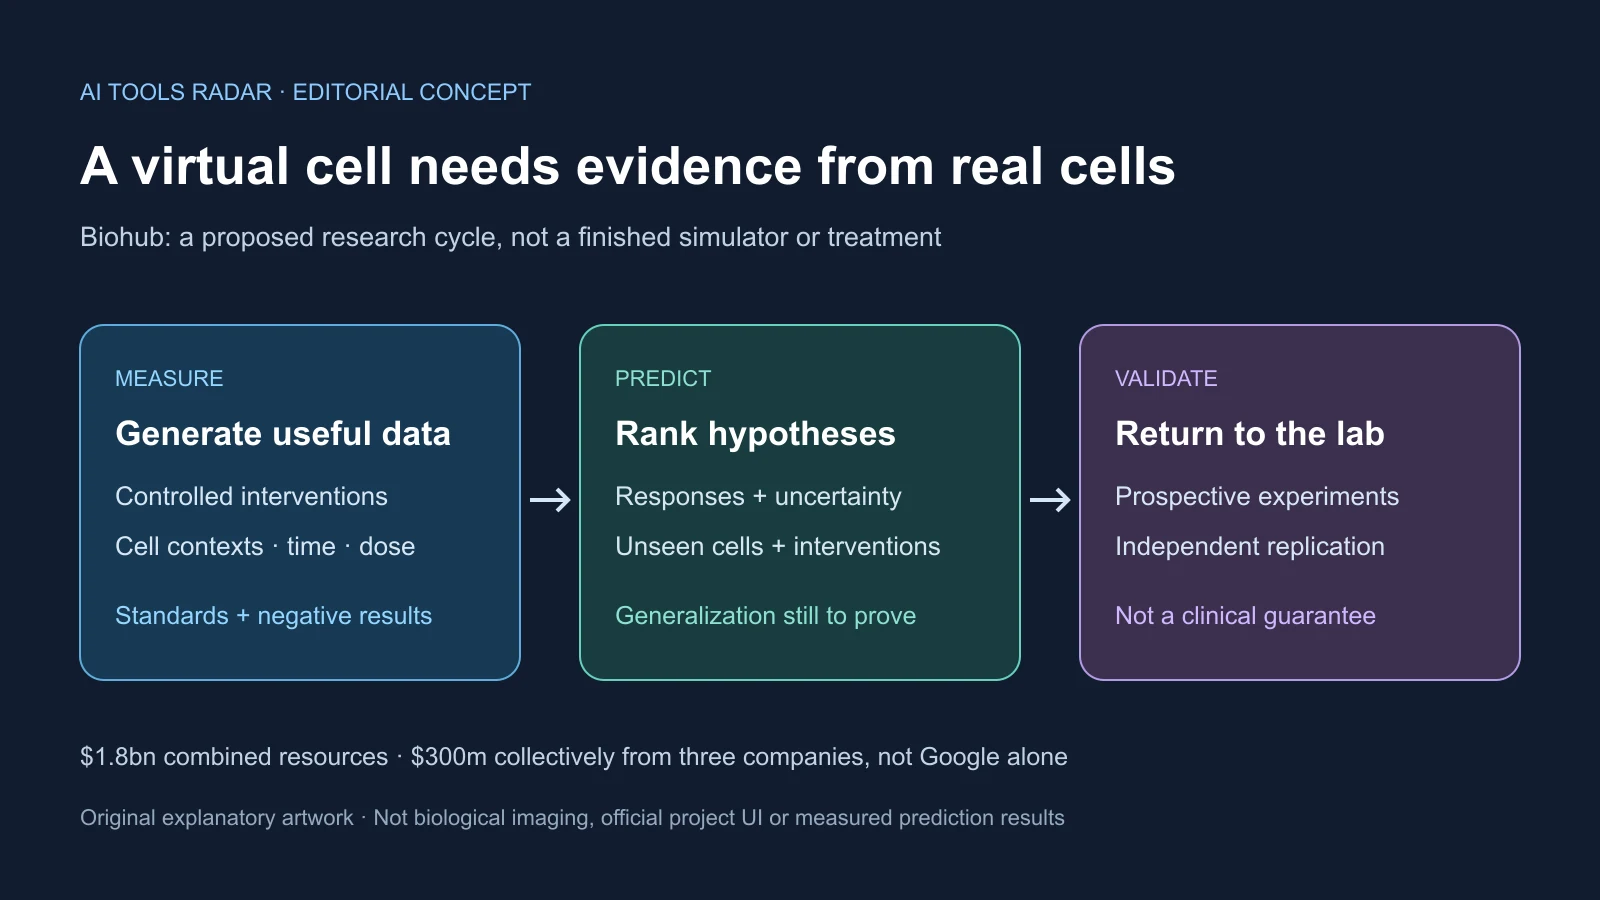
Biohub의 확대된 Virtual Biology Initiative는 다음 생물학 AI 발전에 더 큰 모델뿐 아니라 실험 증거가 필요하다는 투자다. 2026년 10월 7일 발표한 계획은 Google DeepMind, Meta, Isomorphic Labs, 연방 기관과 연구소를 묶어 살아 있는 세포가 개입에 반응하는 데이터를 비싸게 생산하는 일을 지원한다.
18억 달러는 자금, 기존 데이터, 계산과 측정 기술을 포함한다. 한 번의 현금 투자가 아니다. 기업 3억 달러는 Google 단독이 아니라 세 회사가 함께 낸다. 완성된 가상 세포 발표도 아니다. 첫 대규모 데이터와 신뢰할 예측 모델은 미래 목표다.
서로 바꿔 쓸 수 없는 네 자원
DeepMind, Meta와 Alphabet의 Isomorphic Labs가 공동 3억 달러를 투자하며 개별 금액은 밝히지 않았다. 에너지부는 5년간 5억 달러 이상을 국립 연구소의 측정, 영상, 모델, 계산과 수집에 투입할 계획이다.
NIH는 과거 5억 달러 이상 연방 투자로 만들어진 저장소와 데이터를 조정한다. Biohub는 AI 학습용으로 표준화하려 한다. 같은 금액의 새 NIH 현금이 추가되는 것이 아니다.
Biohub는 2026년 4월 시작 때 5억 달러를 약속했고 4억 달러를 첨단 현미경, 극저온 전자 단층촬영과 여러 규모의 생물 시스템 개변 기술에 배정했다. 합계는 서로 다른 자원이지 모두 새 돈이 아니다.
Mark Zuckerberg와 Priscilla Chan이 설립한 조직은 Allen Institute, Broad Institute, Gladstone Institutes, Human Cell Atlas, Human Protein Atlas와 Wellcome Sanger Institute 등을 열거했다. Nvidia는 계산 기술과 전문성을 제공한다. 공통 표준, 식별자와 중앙 접근도 핵심 과학 작업이다.
다른 설계, 표지, 기기와 품질관리는 모델이 생물학 대신 어느 연구소가 측정했는지 학습하게 할 수 있다. 규모와 함께 실험 조정, 메타데이터와 호환 처리가 필요하다. Alex Rives는 첫 대형 데이터를 약 1년 뒤인 2027년 10월 무렵, 정확한 모델은 5년 내로 예상했다. 보편적 성공 정확도 기준이 정해진 완료 이정표는 아니다.
예측 전에 측정해야 하는 것
가상 세포는 사실적인 영상이나 만능 모사기가 아니라 좁은 예측 프로그램일 수 있다. 유전자 억제, 약물, 영양과 질병 환경이 분자 활동·행동을 어떻게 바꾸는지가 질문이다.
출력은 유전자 발현, 단백질, 구조, 신호와 관측 반응을 포함한다. 통제된 변경 전후의 짝지은 측정을 세포 종류, 조건, 용량과 시간에 따라 반복해야 한다. 공개 집합은 수억 관측이지만 Rives는 수십억, 궁극적으로 수조가 필요하다고 말했다.
양만으로는 안 된다. 기록이 부족한 조 단위 측정은 편향을 키운다. 공간 전사체는 조직 내 위치를 보존하고, 극저온 전자 단층촬영은 세포 내부의 정밀한 3차원 구조를, 교란 스크리닝은 유전·환경 변경의 반응을 측정한다. 서로 다른 층이지 대체재가 아니다.
분자, 세포, 조직과 개체를 연결하려는 계획이다. DeepMind의 Pushmeet Kohli는 개방적·표준화된 실험 반응 공유 기반을 강조했다. AlphaFold의 구조·상호작용 경험은 관련되지만 동적 전체 세포가 단순히 더 큰 단백질 구조 문제는 아니다.
알츠하이머 경로 팀은 효과와 불확실성으로 개입 순위를 정해 실험할 수 있다. 결정적 측정은 여전히 연구실이 하고 모델은 결과를 배워 다음 유익한 시험을 선택한다. 능동 학습은 실험 선택 개선이지 실험 제거가 아니다.
일반화는 여전히 어렵다. 배양 세포주는 일차 인체 조직을, 한 용량은 다른 용량을 대표하지 않는다. 기증자, 발달, 질병, 이웃 세포, 영양과 과거 치료가 행동을 바꾼다. 좁게 유용한 모델이 범용 시뮬레이터보다 먼저 나올 수 있다.
공유 기반에도 기업의 선점이 있다
Biohub는 최종적으로 과학계에 개방한다고 한다. Rives에 따르면 정부 자금 데이터에는 사적 공개 유예가 없고 기업 데이터는 투자자에게 일시 선행 접근을 준다. 기간은 공개하지 않았다.
비싼 실험을 지원하는 유인이지만 자금력 있는 파트너가 대학과 소형 바이오 기업보다 먼저 모델·방법을 개발할 수 있다. 나중 개방은 시간 차이를 없애지 않는다.
Isomorphic Labs는 약물 발견 사업에서 표적·화합물에 활용할 수 있고 DeepMind는 생물학 AI 경험이 있다. Meta의 직접 상업 경로는 연구와 Zuckerberg 연결에도 덜 명시적이다. 협력이 경쟁을 끝내지는 않는다.
신뢰성은 유예, 라이선스, 메타데이터, 다운로드와 음성 결과에 달렸다. 모델은 흥미로운 양성 결과뿐 아니라 개입이 의미 없었던 경우도 배워야 한다. 데이터 설명에는 방법, 기증자, 맥락, 한계와 품질을 담고 외부 수정 통로가 있어야 한다.
안정적 ID, 보관 버전과 지속 접근은 재현을 지킨다. 공개 파일이 학계 계산비를 해결하지 않고 Nvidia 참여도 배분을 결정하지 않는다. 접근, 계산, 모델 공개와 개인정보가 공유 기반인지 늦게 공개되는 기업 자산인지 정한다.
독점 데이터는 능력을 집중하고 검토를 막지만 완전 공공 자금은 같은 투자·속도를 얻기 어려울 수 있다. OpenAI 재단의 의학·생물 데이터 지원과 Anthropic의 실험실 활동도 전략성을 보여준다. 핵심은 Google 대 Meta가 아니라 운영 규칙이다.
기존 시험은 돈과 정확성의 차이를 보여준다
첫 Arc 도전은 인간 배아줄기세포의 유전자 억제 후 발현을 예측했다. 약 30만 단일 세포 프로필과 300개 교란을 포함했다. 114개국 5,000명 이상이 등록하고 1,200개 넘는 팀이 제출했으며 300개 넘는 팀이 최종 참가를 마쳤다.
Arc는 모든 지표에서 단순 기준선을 일관되게 넘지 못했다고 보고했다. 상위 시스템은 교란 구별과 변화 유전자 식별을 개선했지만 딥러닝에 고전 통계 특징을 섞었다. 순수 종단 간 학습은 해결하지 못했다. 불가능의 증거가 아니라 익숙한 데이터 성공이 낯선 생물학을 대체하지 못한다는 뜻이다.
2026년은 학습에 교란 응답이 제공되지 않은 여섯 세포주의 예측으로 높아져 연구에 가까운 제로샷을 본다. STATE는 1억 6,700만 세포 관측과 70개 인간 맥락의 1억 이상 세포 교란에서 배웠다. 그래도 가능한 생물학을 드물게 덮을 뿐이다.
발현 정확성만 목표가 아니다. 단백질 위치, 모양, 대사, 독성과 통신은 뚜렷한 전사 신호 없이 바뀔 수 있다. 표적 순위에는 유용해도 임상 예측에는 부적절할 수 있다. 질문별 모델, 측정과 불확실성이 필요하다.
5년 목표는 낯선 세포, 개입, 연구소, 조건과 허용 오류를 정의해야 한다. 다른 기기·샘플의 독립 연구소가 재현해야 한다. 모델이 먼저 실험을 골라 실제 결정을 개선하는 전향 연구는 멋진 시각화나 과거 순위보다 강하다.
다음 이정표는 증거이지 치료 약속이 아니다
첫 데이터는 양만 아니라 세포, 개입, 용량, 시간, 기증자, 음성 결과, 원시 측정과 메타데이터로 평가해야 한다. 좁거나 지연되면 일정이 약해지지만 범용 세포가 늦어도 표준과 호환성은 유용할 수 있다.
평가는 암기·연구소 특징을 넘어 낯선 조직, 화학, 긴 시간과 발현 밖 측정으로 가야 한다. 독립적 전향 실험 이익이 중요하다. 빠른 신약은 아직 가설이며 독성, 제조, 임상시험과 규제 검토는 남는다.
우선 접근 파트너, 기간, 공개 날짜와 오류 수정도 밝혀야 한다. 그래야 선택한 점수를 광범위 생물 지능으로 판매하는 대신 공정 비교가 가능하다.
가까운 산출물은 데이터, 표준, 기기와 실험 모델이지 내년 치료제가 아니다. Biohub는 AI가 인터넷에서 모으지 못하는 물리 작업을 지원한다. 첫 공개, 독립 시험과 실효성 있는 운영이 믿을 만한 공유 과학이 될지 보여준다.
출처
Biohub 확장 발표 · 자금·접근 조건 보도 · 생물학 데이터 병목 · Arc 경진대회 결과 · Arc 가상 세포 계획 · 가상 세포 정의 · 원래 보도