
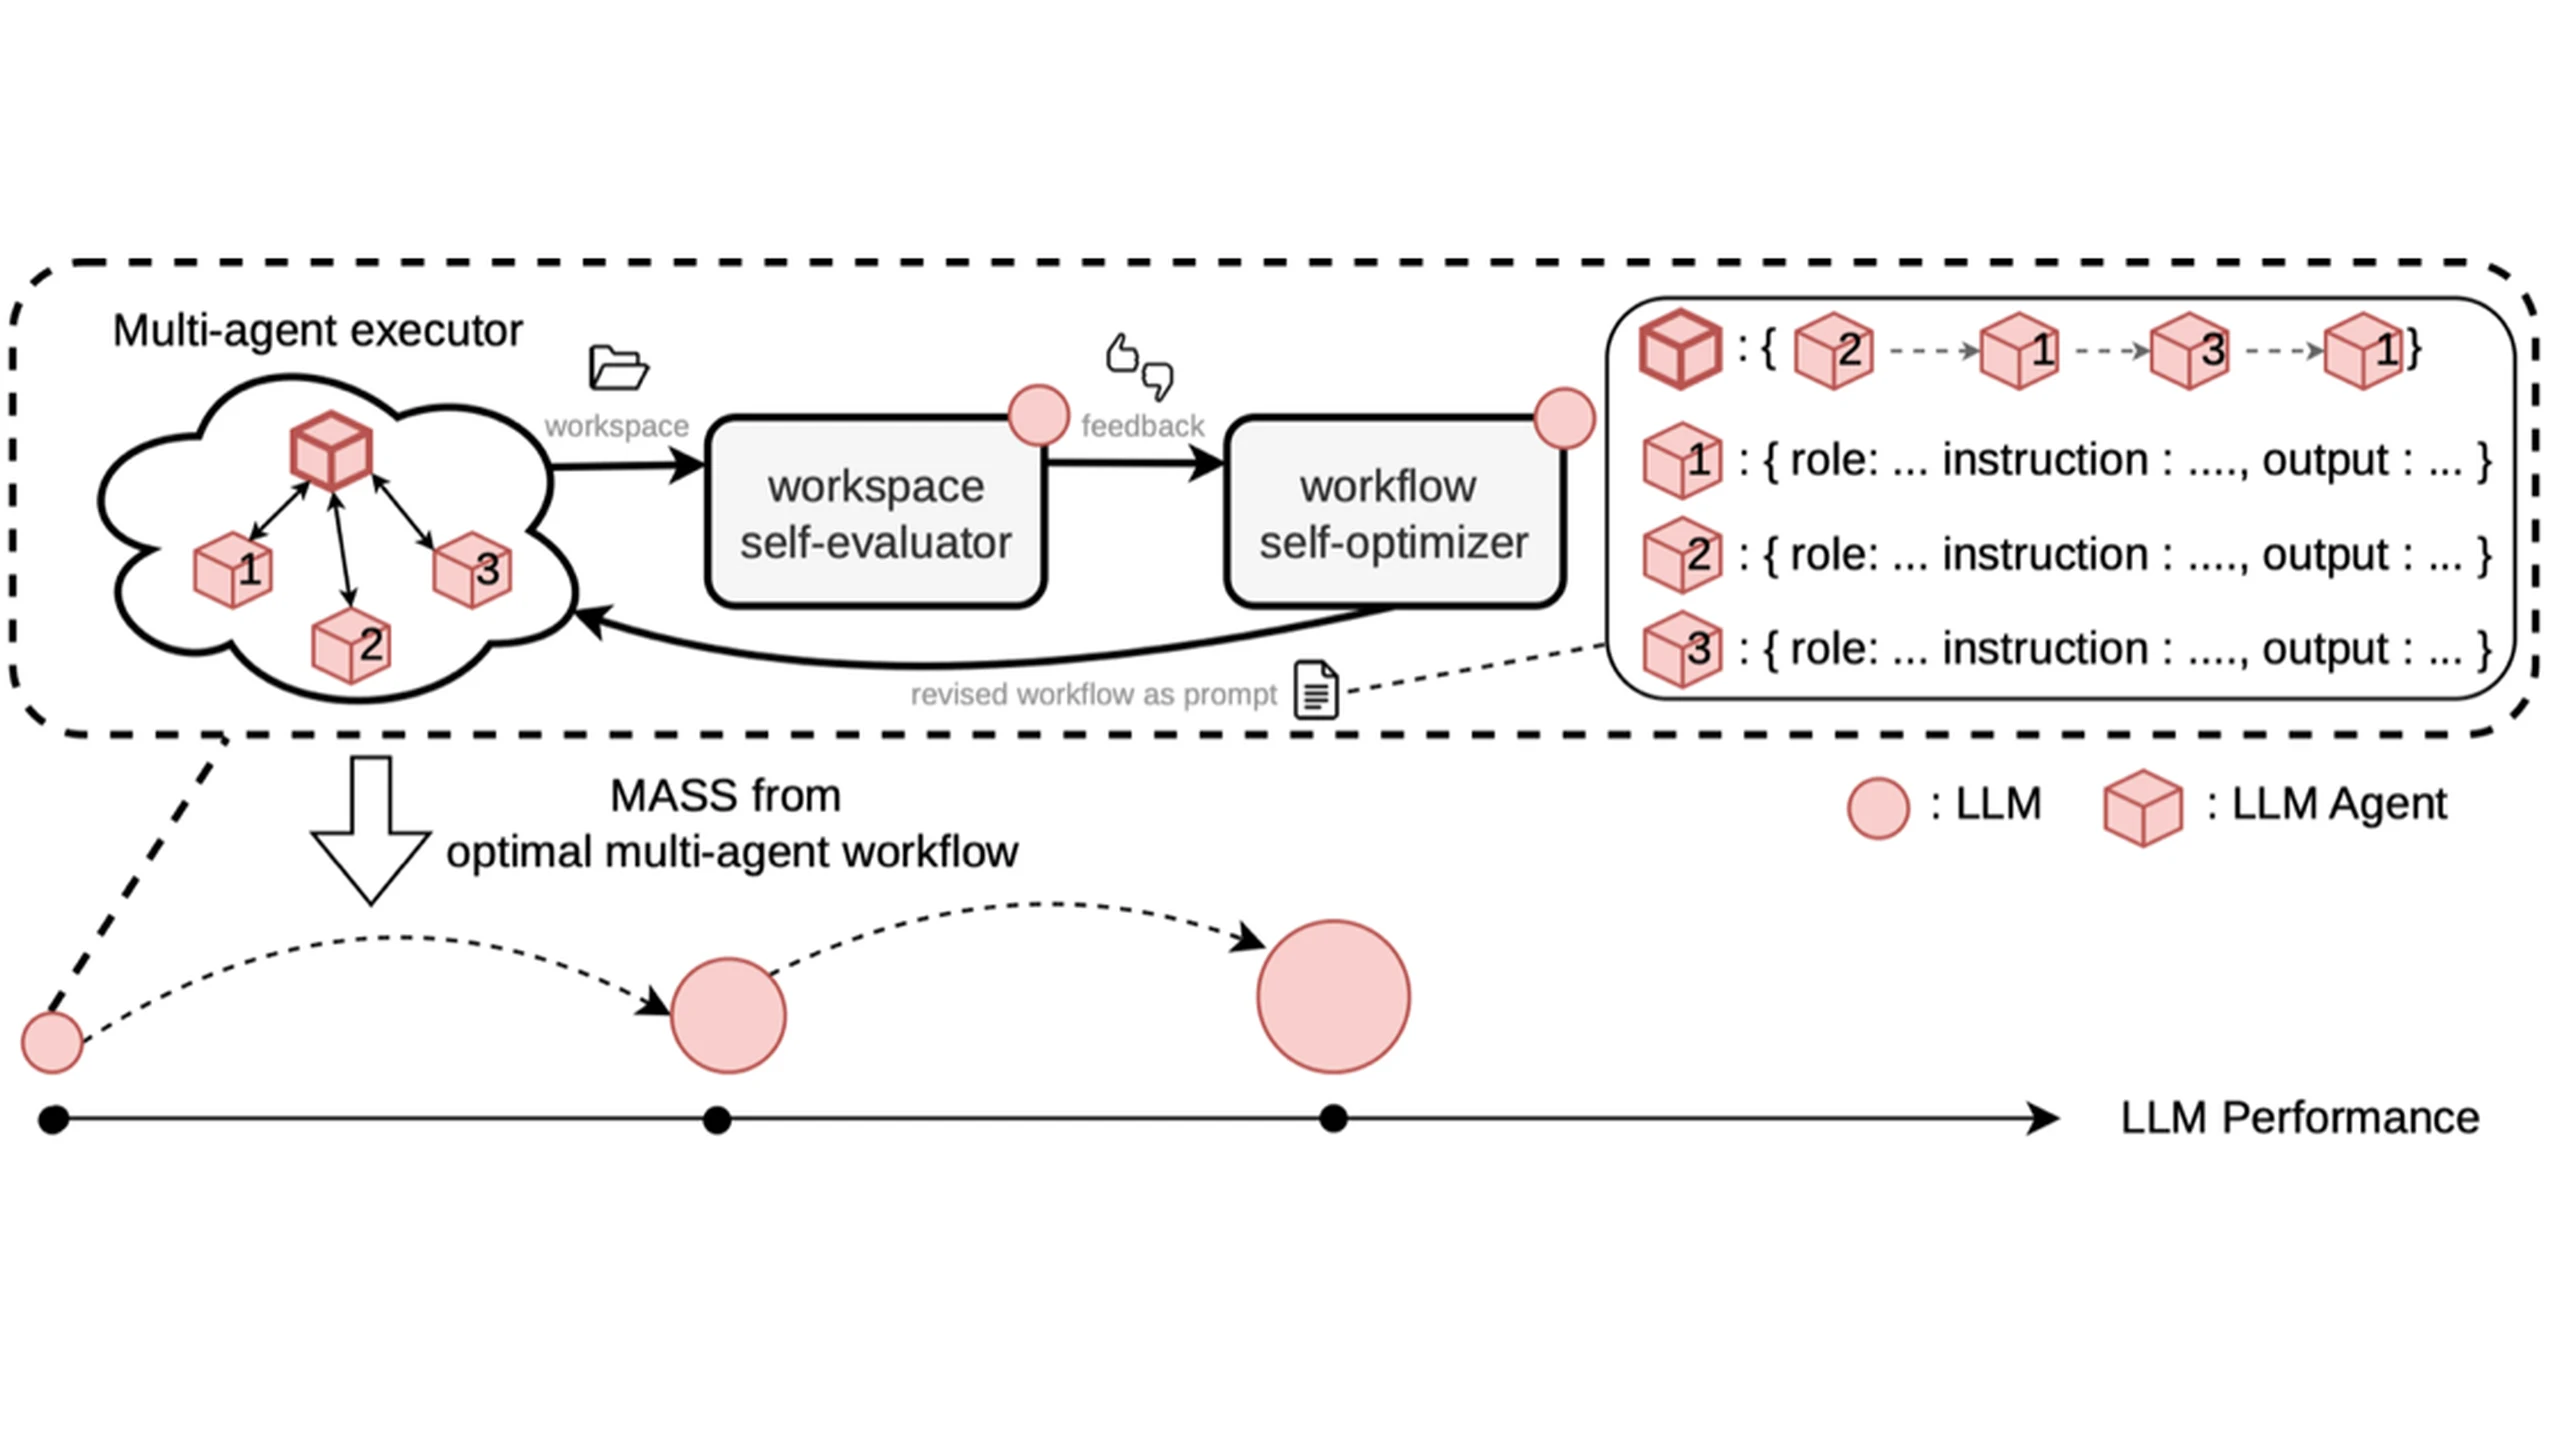
Sakana AIは、多数の同一モデルのコピーが研究を実施し、評価し、選別した実行履歴を共通の次世代モデルの学習データにするMulti-Agent Self-Supervision(MASS)を2サイクル完了した。実験上の改善は報告されたが、一様ではない。研究ベンチマークは向上し、ソフトウェア工学の2指標は低下した。これは限定された事後学習であり、自律的な知能爆発の証拠ではない。
2026年10月8日提出の論文と公開実装には、タスクのプロンプト、学習設定、評価ツール、パイプライン文書が含まれる。一方、「再帰的」という名称だけでは解決しない限界も明確だ。完了したのは2サイクルで、課題集合は小さく、実行者・最適化者・評価者を兼ねるモデルが同じ誤りを繰り返し得る。
チームの成果をモデル更新へ変える
通常のマルチエージェント推論は、モデルの複数インスタンスに作業を分け、重みを変えずに出力を統合する。MASSはメッセージ、ツール呼び出し、中間成果物、結果を学習用の軌跡として保存する。別々のインスタンスが仕事を分担するが、全て同じモデルを共有し、独立に訓練された専門家ではない。
内側のループは重みを固定し、プロンプトで定義された良いワークフローを探す。そこには役割、指示、出力契約、通信の順序が含まれる。各学習課題には現在最良のワークフローがあり、候補チームの成果をモデルがそれと比較し、最適化者が評価を使って変更を提案する。
選択したワークフローは課題ごとに18回実行する。モデルによる一対比較をBradley–Terryモデルで得点に変換し、最大16軌跡を残す。15軌跡は学習用、1軌跡は検証用だ。微調整前にオーケストレーターの最初の学習プロンプトからワークフロー本文を除き、与えられた計画の模写ではなく、課題から組織方法を推測させる。
外側のループは低ランク適応LoRAで一部のパラメーターを微調整する。統括役とサブエージェント双方の会話が学習対象となり、更新モデルが次回も3役に戻る。前世代が後継のデータ生成と選択を助ける意味で「再帰的」と呼べる。ただし構造、課題、最適化方法、ベンチマーク、計算設備、サイクルの区切りは人間が決めている。
研究成果の改善と転移の境界
基盤はコーディングエージェント環境のQwen3.6-27Bだ。合成課題は金融、ロボティクス、薬学の12件で、全てコード、定量分析、報告書を要求する。9件を学習用に指定したが、実際にデータを提供したのは8件だった。各領域1件ずつ、計3件は微調整、検証、チェックポイント選択から完全に除外した。
GPT-5.5とClaude Opus 4.8は完成した作業領域を比較する外部判定者で、学習ループの教師ではない。保留した3課題では、基盤モデルに対する勝率が第1世代53.9%、第2世代69.9%だった。第2世代は第1世代に60.8%で勝った。学習課題での対基盤勝率は65.6%と82.5%であり、より強い学習内の結果と保留課題の証拠を区別する必要がある。
公開研究ベンチマークでは、第2世代の出力トークン当たり得点が基盤の1.2~1.6倍だったと報告する。MLR-Benchは1.71から2.25へ、論文提出率は57%から76%へ上昇した。ScienceAgentBenchは28.8%から31.7%、AstaBench E2E-Hardは0.053から0.067へ改善し、後者の報告書提出率は50%から76%になった。DSBenchは0.473から0.482への小幅な変化にとどまる。高い効率比でも、この絶対得点差が大幅改善に変わるわけではない。
ソフトウェア工学は逆方向だった。Terminal-Bench 2.0は0.375から0.352、SWE-bench Verifiedは0.626から0.611へ低下した。出力トークン当たり得点も基盤の0.96倍と0.94倍である。全般的に強くなったとは言えない。
研究報告、定量的証拠、コードが訓練の中心で、リポジトリーのデバッグや端末操作ではなかったという課題の適合性が説明候補となる。Sakanaはソフトウェア工学課題の追加を提案するが、効果は未検証で、既存能力への干渉もあり得る。転移試験では新領域と従来能力の保持を両方確認すべきだ。
効率指標に含まれない費用
学習比較では、複数エージェントの学生モデルが2,880万の教師あり学習トークンで68.3%の勝率に達した。最大の単一エージェント学生は4,200万トークンで64%だった。31%少ない教師ありトークンで良い結果を得たのであり、モデル開発総費用を31%削減した証明ではない。
選択前の生成量はチームの方が平均約2.4倍だった。外部判定者は単独出力との比較の85.1%でチームを選び、履歴長が近い10組でもチームは80%で勝った。協調と選別が有用な例を作る示唆はあるが、ワークフローと検証指示も異なるため、委任だけの効果を分離してはいない。
出力トークン当たり得点は生産的な出力の指標で、全工程ではない。ワークフロー探索、反復実行、比較、データ生成、評価にも計算が必要で、教師ありトークン総数は入力トークンや上流の費用を除く。MASSが示すのは選別済み学習データの密度であり、開発全体の効率には完全な会計が必要だ。
人格設定より情報の契約
探索が変えるのは役割、指示、契約、通信順序だ。契約は返すべき証拠や成果物を定め、通信順序は他の担当へ渡す時点や再確認の経路を定める。複数のコピーに研究者、批評家、編集者を演じさせるより具体的である。
金融の例では、データ準備、特徴量構築、モデリング、バックテスト、監査、照合、報告を分担する。データ担当は過去の判断に未来情報が漏れたかを明示する。優れたバックテストが当時利用できない情報を使っただけ、という実際の失敗を対象にしている。
Sakanaの文章分析では、課題情報は役割や一般指示より、契約と通信順序へ集中していった。ただし比較により8件または9件だけの標本であり、相互情報量は実行中の全メッセージではなくワークフロー本文を測っている。機構の手掛かりであって、広範な因果証明ではない。
先行するマルチエージェント討論研究は回答と批評の交換による改善を調べた。MASSは選択した集団行動を重みに移す。統括履歴は分解と調整、個別担当の履歴は限定された仕事を教える。検索可能な技術知識基盤も検査できる証拠と判断を残す組織的意義を示すが、MASSの独立検証ではない。
最適化者と判定者が共有する限界
同一モデルの3役は恒常的に強い教師への依存を減らす一方、相関した失敗を作る。実行者の誤解を評価者が褒め、次世代がより自信を持って学ぶ可能性がある。無作為抽出と専門分担は行動の変化を生むが、独立した学習履歴や判断を保証しない。
Sakanaのプロジェクト解説は共通の盲点を安全上の問題とする。3世代を通じた内部・外部判定の一致率は73%から93%へ上がった。対象課題での好材料だが正しさの証明ではない。判定者は前提を共有し、整った報告を好み、現実の実験でしか分からない誤りを見逃し得る。
最適化者の能力も制約だった。基盤Qwenを実行者に残す比較で、GPT-5.5を評価者だけにすると改善は限定的だった。評価者と最適化者の両方にすると、5回以内の探索で全12課題の勝つワークフローを発見した。同質構成は最終的に12件中11件で発見したが、最大13回を要した。良い批評を良い工程に変換できなければ、正確な評価だけでは足りない。
探索自体も不安定で、良い反復後に急な退行が生じた。元記事が紹介するコミュニティの批判は、再帰的という名称と2回で終了した理由を問うた。人間が定めた境界内の反復探索と教師あり微調整という解釈が適切であり、自由な自己書き換えや無期限の進歩を示したわけではない。
能力とともに監督も改善する必要
自動的な成功判定がない研究は自己確認に陥りやすい。筋の通った報告にも概念的誤りや反証の欠落があり、動くコードが間違った目的を実装することもある。モデルの合意だけで科学的新規性、戦略判断、価値、安全を決められない。
OpenAIの監視可能性研究は、推論履歴が行動と最終回答以上の情報を示す一方、監視は不完全で、エージェントと監視者双方に依存するとする。MASSの豊かな軌跡は検査機会と隠れ場所を増やす。可視の推論の最適化は、実際の動作を直さず説得的説明だけを報酬化し得る。
Anthropicの再帰的自己改善の議論も監督、妥当性確認、検証を重視する。外部モデル、専門家、実行可能テスト、信頼できるデータ経路、敵対的評価、時間を置いた現実検証が独立した確認となるが、全ての失敗を覆うものはない。複数モデルの一致も共通の偏りかもしれない。
次の決定的試験は、サイクル追加、従来能力を失わない転移、意図的に入れた共通盲点からの回復だ。外部判定者が失敗を見つけるだけでなく、ループ自体が工程を改め、欠陥軌跡を学習から外す必要がある。現時点でMASSは、範囲を限定し証拠を重視する研究チームから濃い学習信号が得られることを示す。無限の再帰的進歩や、重大な判断から人の確認を除く根拠ではない。