
Sakana AI 已完成两轮多智能体自监督(MASS):同一模型的多个实例生成研究成果、评价成果,再把选中的执行轨迹用于训练共享模型的下一代版本。报告展示了实际实验收益,但结果并不均匀:研究基准进步,两项软件工程基准却退步。这是受限的后训练实验,不是自主智能爆炸的证据。
2026 年 10 月 8 日提交的论文和开源实现提供了任务提示、训练配置、评估工具和流程文档,便于检验实验。同时,“递归”一词背后的问题也很清楚:目前只有两个完整周期、规模很小的任务集,而且同一模型担任执行者、优化者和评价者,可能在各环节重复相同错误。
把团队成果转化为模型更新
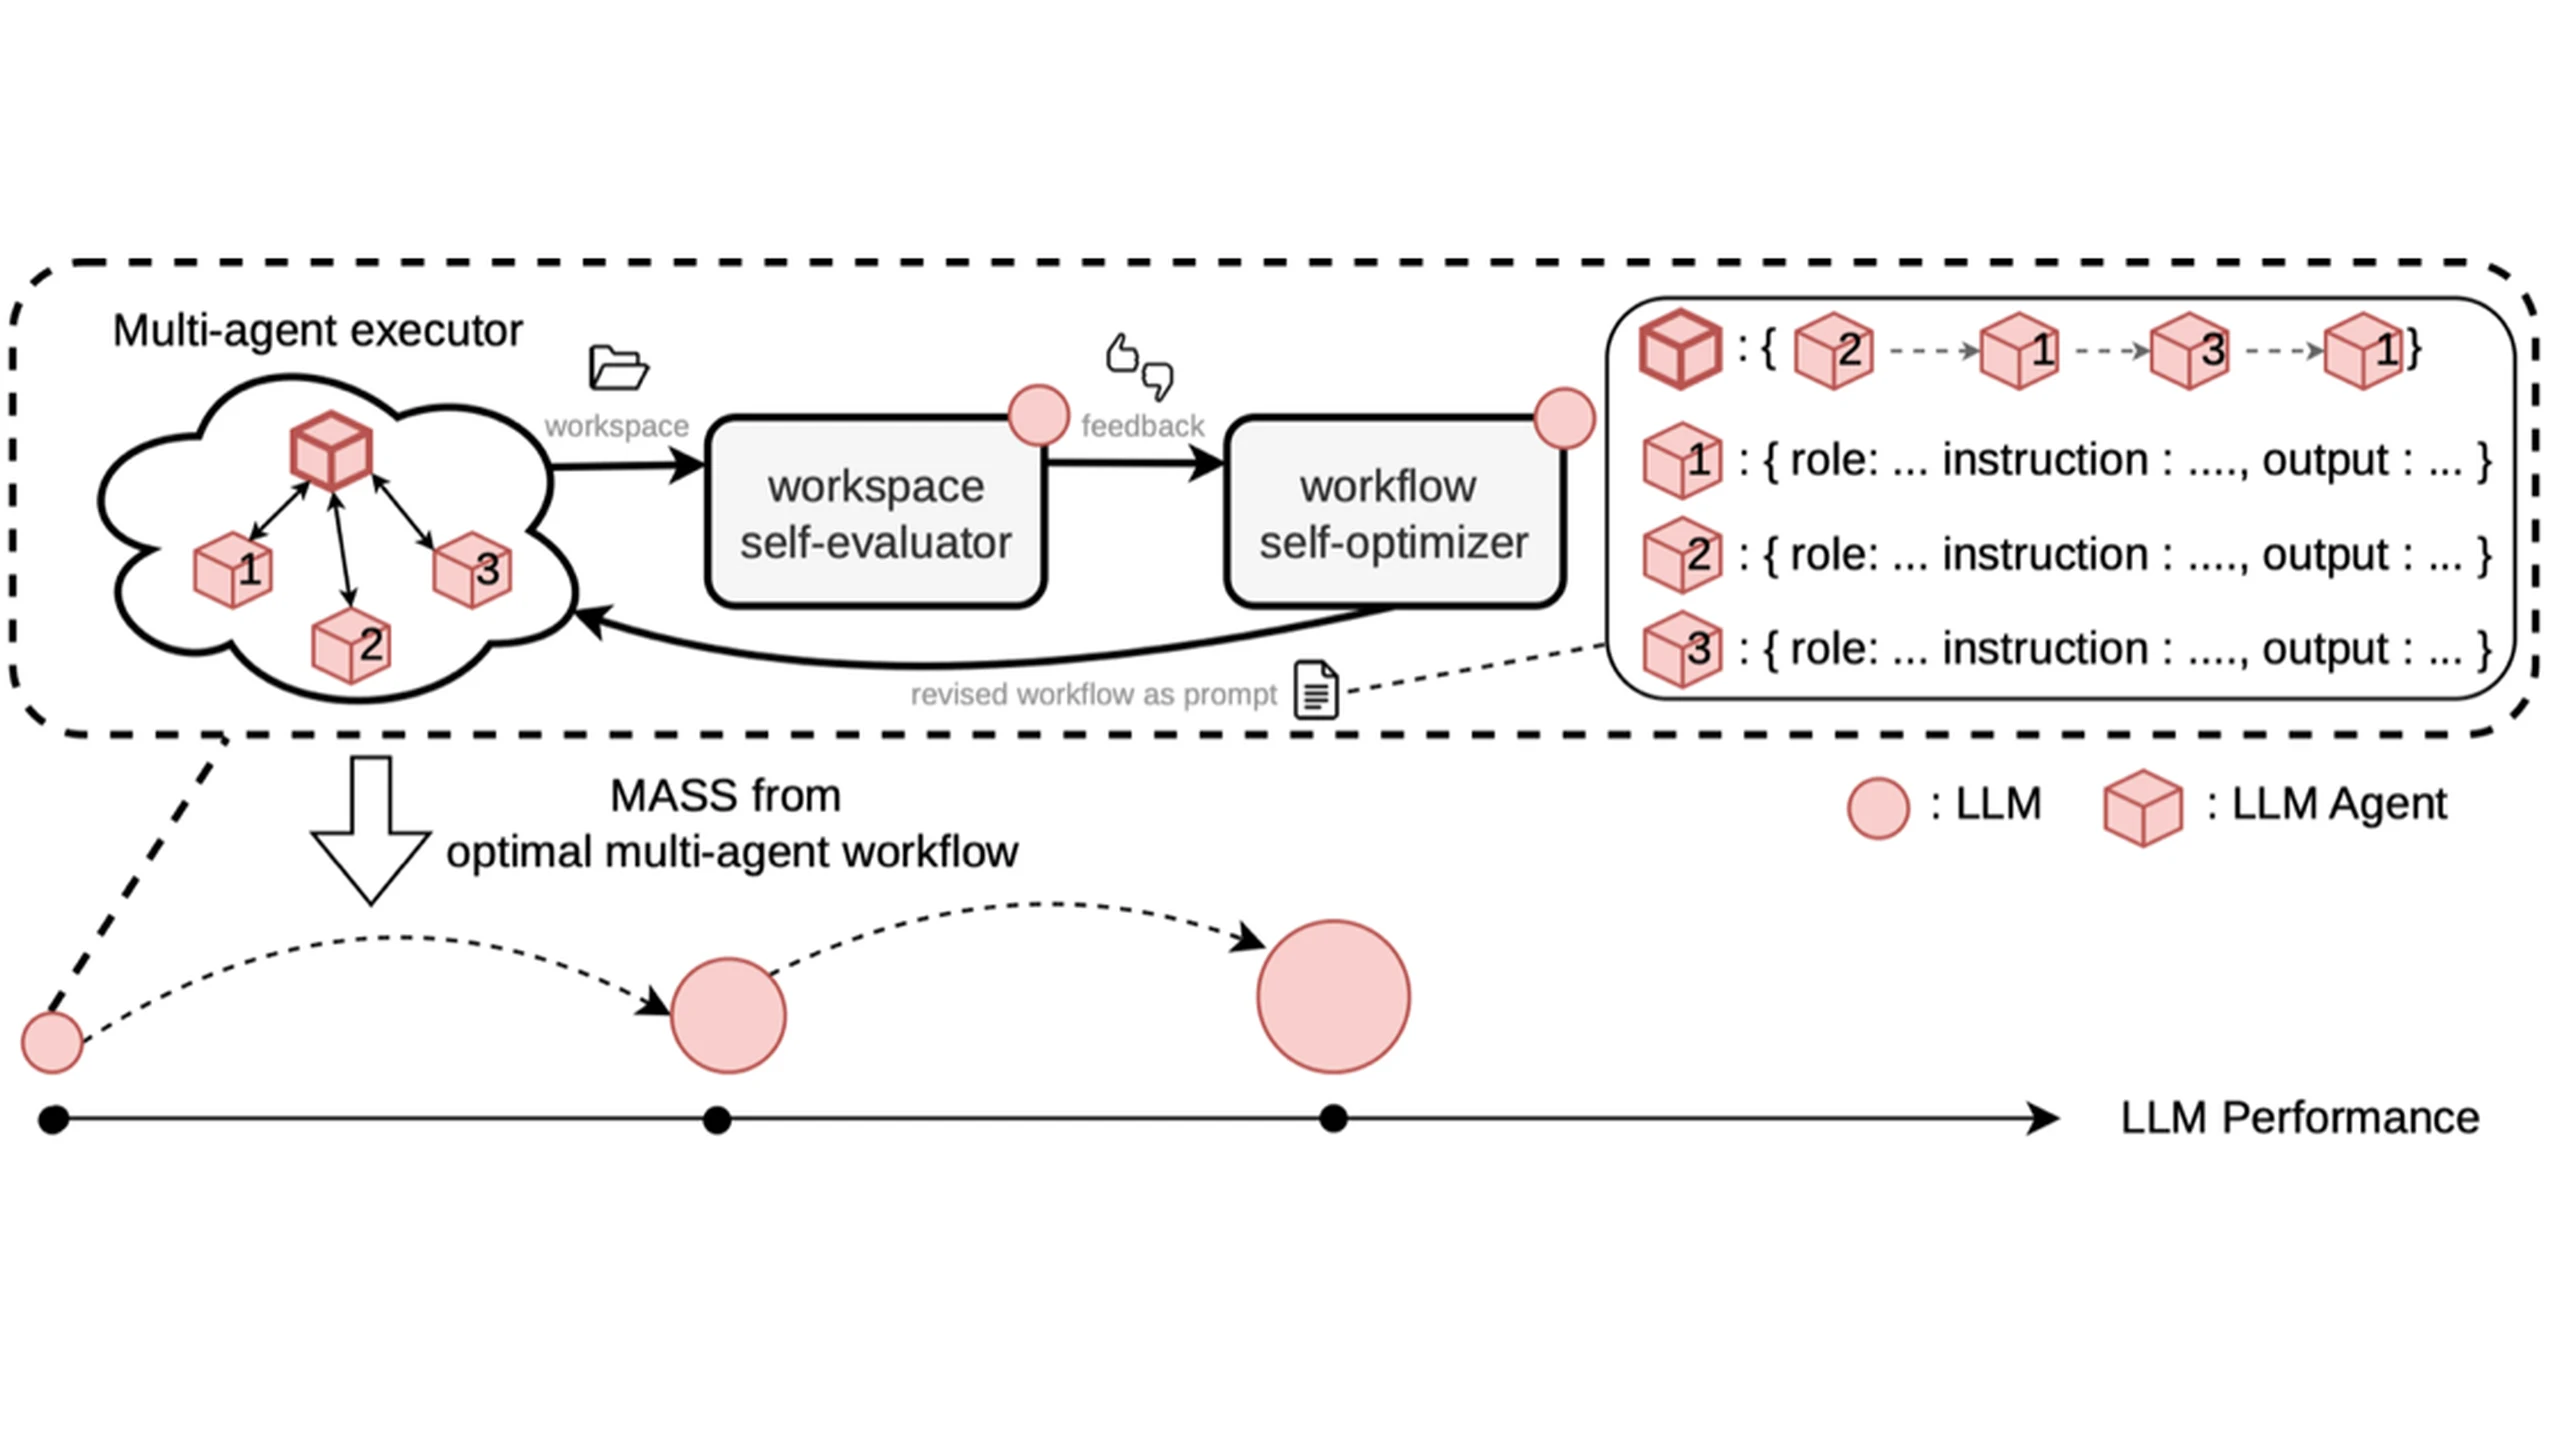
普通多智能体推理会把任务分给多个实例并汇总结果,但不改变底层权重。MASS 则保存消息、工具调用、中间产物和结果,把它们作为训练轨迹。不同实例承担不同工作,却共享同一个模型,并不是分别训练的独立专家。
内循环保持权重不变,搜索由提示定义的更好工作流。工作流规定角色、指令、输出契约和通信跳转。每个训练任务都有当前最优工作流;候选团队执行任务后,模型将其工作区与当前最优方案比较,优化者依据评价提出修改。
选定工作流后,MASS 为每个任务运行 18 次。模型通过成对比较给工作区排序,Bradley–Terry 模型把偏好转换成分数。每个任务最多保留 16 条轨迹:15 条可供训练,1 条留作验证。微调前会从编排器的初始训练提示中移除工作流文字,使模型从任务推断如何组织工作,而不只是照抄现成方案。
外循环采用低秩适配 LoRA,只微调有限的一组参数。编排器和子智能体的对话都是训练目标,更新后的模型再回到三种角色参与下一轮。称其为递归有其依据,因为上一代参与生成和选择下一代的数据;但架构、任务、优化程序、基准、计算设施和周期边界仍由人定义。
研究进步与明确的迁移边界
基座是编码智能体环境中的 Qwen3.6-27B。合成任务集包含金融、机器人和药学领域的 12 项研究任务,每项都要求代码、定量分析和书面报告。9 项原定用于训练,最终实际贡献数据的是 8 项;另外 3 项各来自一个领域,完全排除在微调、验证和检查点选择之外。
GPT-5.5 和 Claude Opus 4.8 是对完整工作区进行比较的外部裁判,不是训练循环的监督者。在 3 项留出任务上,第一轮模型相对基座的胜率为 53.9%,第二轮为 69.9%;第二轮对第一轮的胜率为 60.8%。训练任务上,两轮相对基座的胜率分别为 65.6% 和 82.5%。训练结果更强,因此不能把它与留出任务证据混为一谈。
公开研究基准中,Sakana 称第二轮每输出 token 的得分为基座的 1.2—1.6 倍。MLR-Bench 从 1.71 升至 2.25,论文交付率从 57% 升至 76%;ScienceAgentBench 从 28.8% 升至 31.7%;AstaBench E2E-Hard 从 0.053 升至 0.067,报告交付率从 50% 升至 76%;DSBench 仅从 0.473 升至 0.482。效率比值较高,不会让最后这个很小的绝对变化变成大幅得分增长。
软件工程却向相反方向变化。Terminal-Bench 2.0 从 0.375 降至 0.352,SWE-bench Verified 从 0.626 降至 0.611;每输出 token 得分分别为基座的 0.96 倍和 0.94 倍。因此,不能说新模型在所有方面都更强。
任务匹配是合理解释:训练主要围绕研究报告、定量证据和代码,而非代码仓库调试或终端操作。Sakana 提议加入软件工程任务,但效果尚未验证,也可能干扰原有能力。真正的迁移测试必须同时检查新领域表现和旧能力是否保留。
效率数字没有计入什么
一组训练比较中,多智能体学生模型处理 2,880 万监督 token 后达到 68.3% 胜率;规模最大的单智能体学生模型处理 4,200 万后达到 64%。这意味着监督 token 少 31% 而结果更好,不代表模型开发总成本已降低 31%。
筛选前,团队平均生成的 token 约为单智能体的 2.4 倍。外部裁判在 85.1% 的比较中偏好团队成果;在 10 对轨迹长度相近的样本中,团队仍有 80% 胜率。这支持协作与筛选能产生有价值样本,但比较并未隔离委派的单独作用,因为工作流与验证指令也有差异。
每输出 token 得分衡量的是输出效率,不是完整流程成本。工作流搜索、重复执行、比较、数据生成和评估都消耗额外计算;监督 token 总数也不含输入 token 及若干上游开支。因此,MASS 支持的是“选中训练数据更密集”的结论,整体开发效率仍需要完整核算。
信息契约比角色人设更重要
工作流搜索修改角色、指令、契约和跳转。契约说明智能体必须返回什么证据或产物;跳转规定信息何时传给另一智能体或返回审核。这比让几个副本分别扮演研究员、批评者和编辑更具体。
在金融案例中,智能体分别负责数据准备、特征构建、建模、回测、审计、对账和报告。数据智能体必须说明历史决策是否泄漏使用了未来信息。这个要求针对真实失误:漂亮的回测可能只是利用了当时尚不可知的数据。
Sakana 对工作流文字的分析发现,任务信息逐渐集中在契约和通信顺序,而非角色与通用指令。按不同比较,样本只有 8 或 9 项任务,互信息估计描述的是工作流文字,不是执行中所有消息。因此,这是机制线索,不是广泛因果证明。
此前的多智能体辩论研究考察交换答案与批评带来的提升。MASS 则把选中的集体行为写进权重:编排器轨迹教分解与协调,子智能体轨迹教有边界的具体任务。可检索的工程知识库也体现了保存可检查证据与决策的组织原则,但它不是 MASS 的独立实验验证。
优化者与裁判共享局限
同一模型承担三种角色,减少了对长期更强教师的依赖,却也造成相关性错误。执行者误解任务,评价者可能奖励该误解,下一代又可能更自信地学会它。随机采样和专门分工产生行为差异,并不等于独立训练经历或独立判断。
Sakana 的项目介绍把共享盲点列为安全问题。三代模型中,内部与外部裁判的一致率从 73% 升至 93%。这是这些任务上的积极信号,不是正确性证明:裁判可能共享假设,或偏好精美报告,却漏掉必须靠现实实验发现的错误。
优化者能力也是瓶颈。在保留基座 Qwen 执行任务的测试中,只让 GPT-5.5 评价,改进有限;让它同时评价和优化,则在 5 次搜索迭代内为全部 12 项任务找到胜出工作流。同质循环最终为 12 项中的 11 项找到胜出方案,但最多需要 13 次迭代。优化者若不能把好批评转化成更好流程,仅有准确评价并不够。
搜索也不稳定:优秀迭代之后可能骤然退步。原稿引用的社区批评质疑“递归”命名,也追问为何两轮就停止。更准确的理解是在人为设定的边界内反复搜索工作流并监督微调,而不是不受限的自我改写,也未证明进步能无限持续。
监督必须随能力一起进步
没有自动成功判据的研究尤其容易自我确认。逻辑连贯的报告仍可能有概念错误、遗漏反证,或在能运行的代码里实现错误目标。模型共识不能独自裁定科学新颖性、战略判断、价值或安全问题。
OpenAI 的可监测性研究发现,推理轨迹比动作和最终答案提供更多线索,但监测并不完整,也同时取决于智能体和监测者。MASS 的丰富轨迹增加检查机会,也增加藏错空间。直接优化可见推理,可能只奖励更有说服力的解释,而未修正底层行为。
Anthropic 对递归自我改进的讨论同样强调监督、验证和核查。独立检查可以包括外部模型、领域专家、可执行测试、可信数据管线、对抗评估以及延后的现实验证。没有一种覆盖全部失误;多个模型一致也可能源自共同偏见。
决定性后续测试应包括更多周期、保留原能力的跨领域迁移,以及从故意设置的共同盲点中恢复。不能仅靠外部裁判抓住错误;循环本身应修改工作流,并避免把缺陷轨迹用于训练。目前,MASS 证明了有边界、重证据的研究团队可产生高密度学习信号,尚未证明无限递归进步,也不足以取消重大决策中的人工审核。