
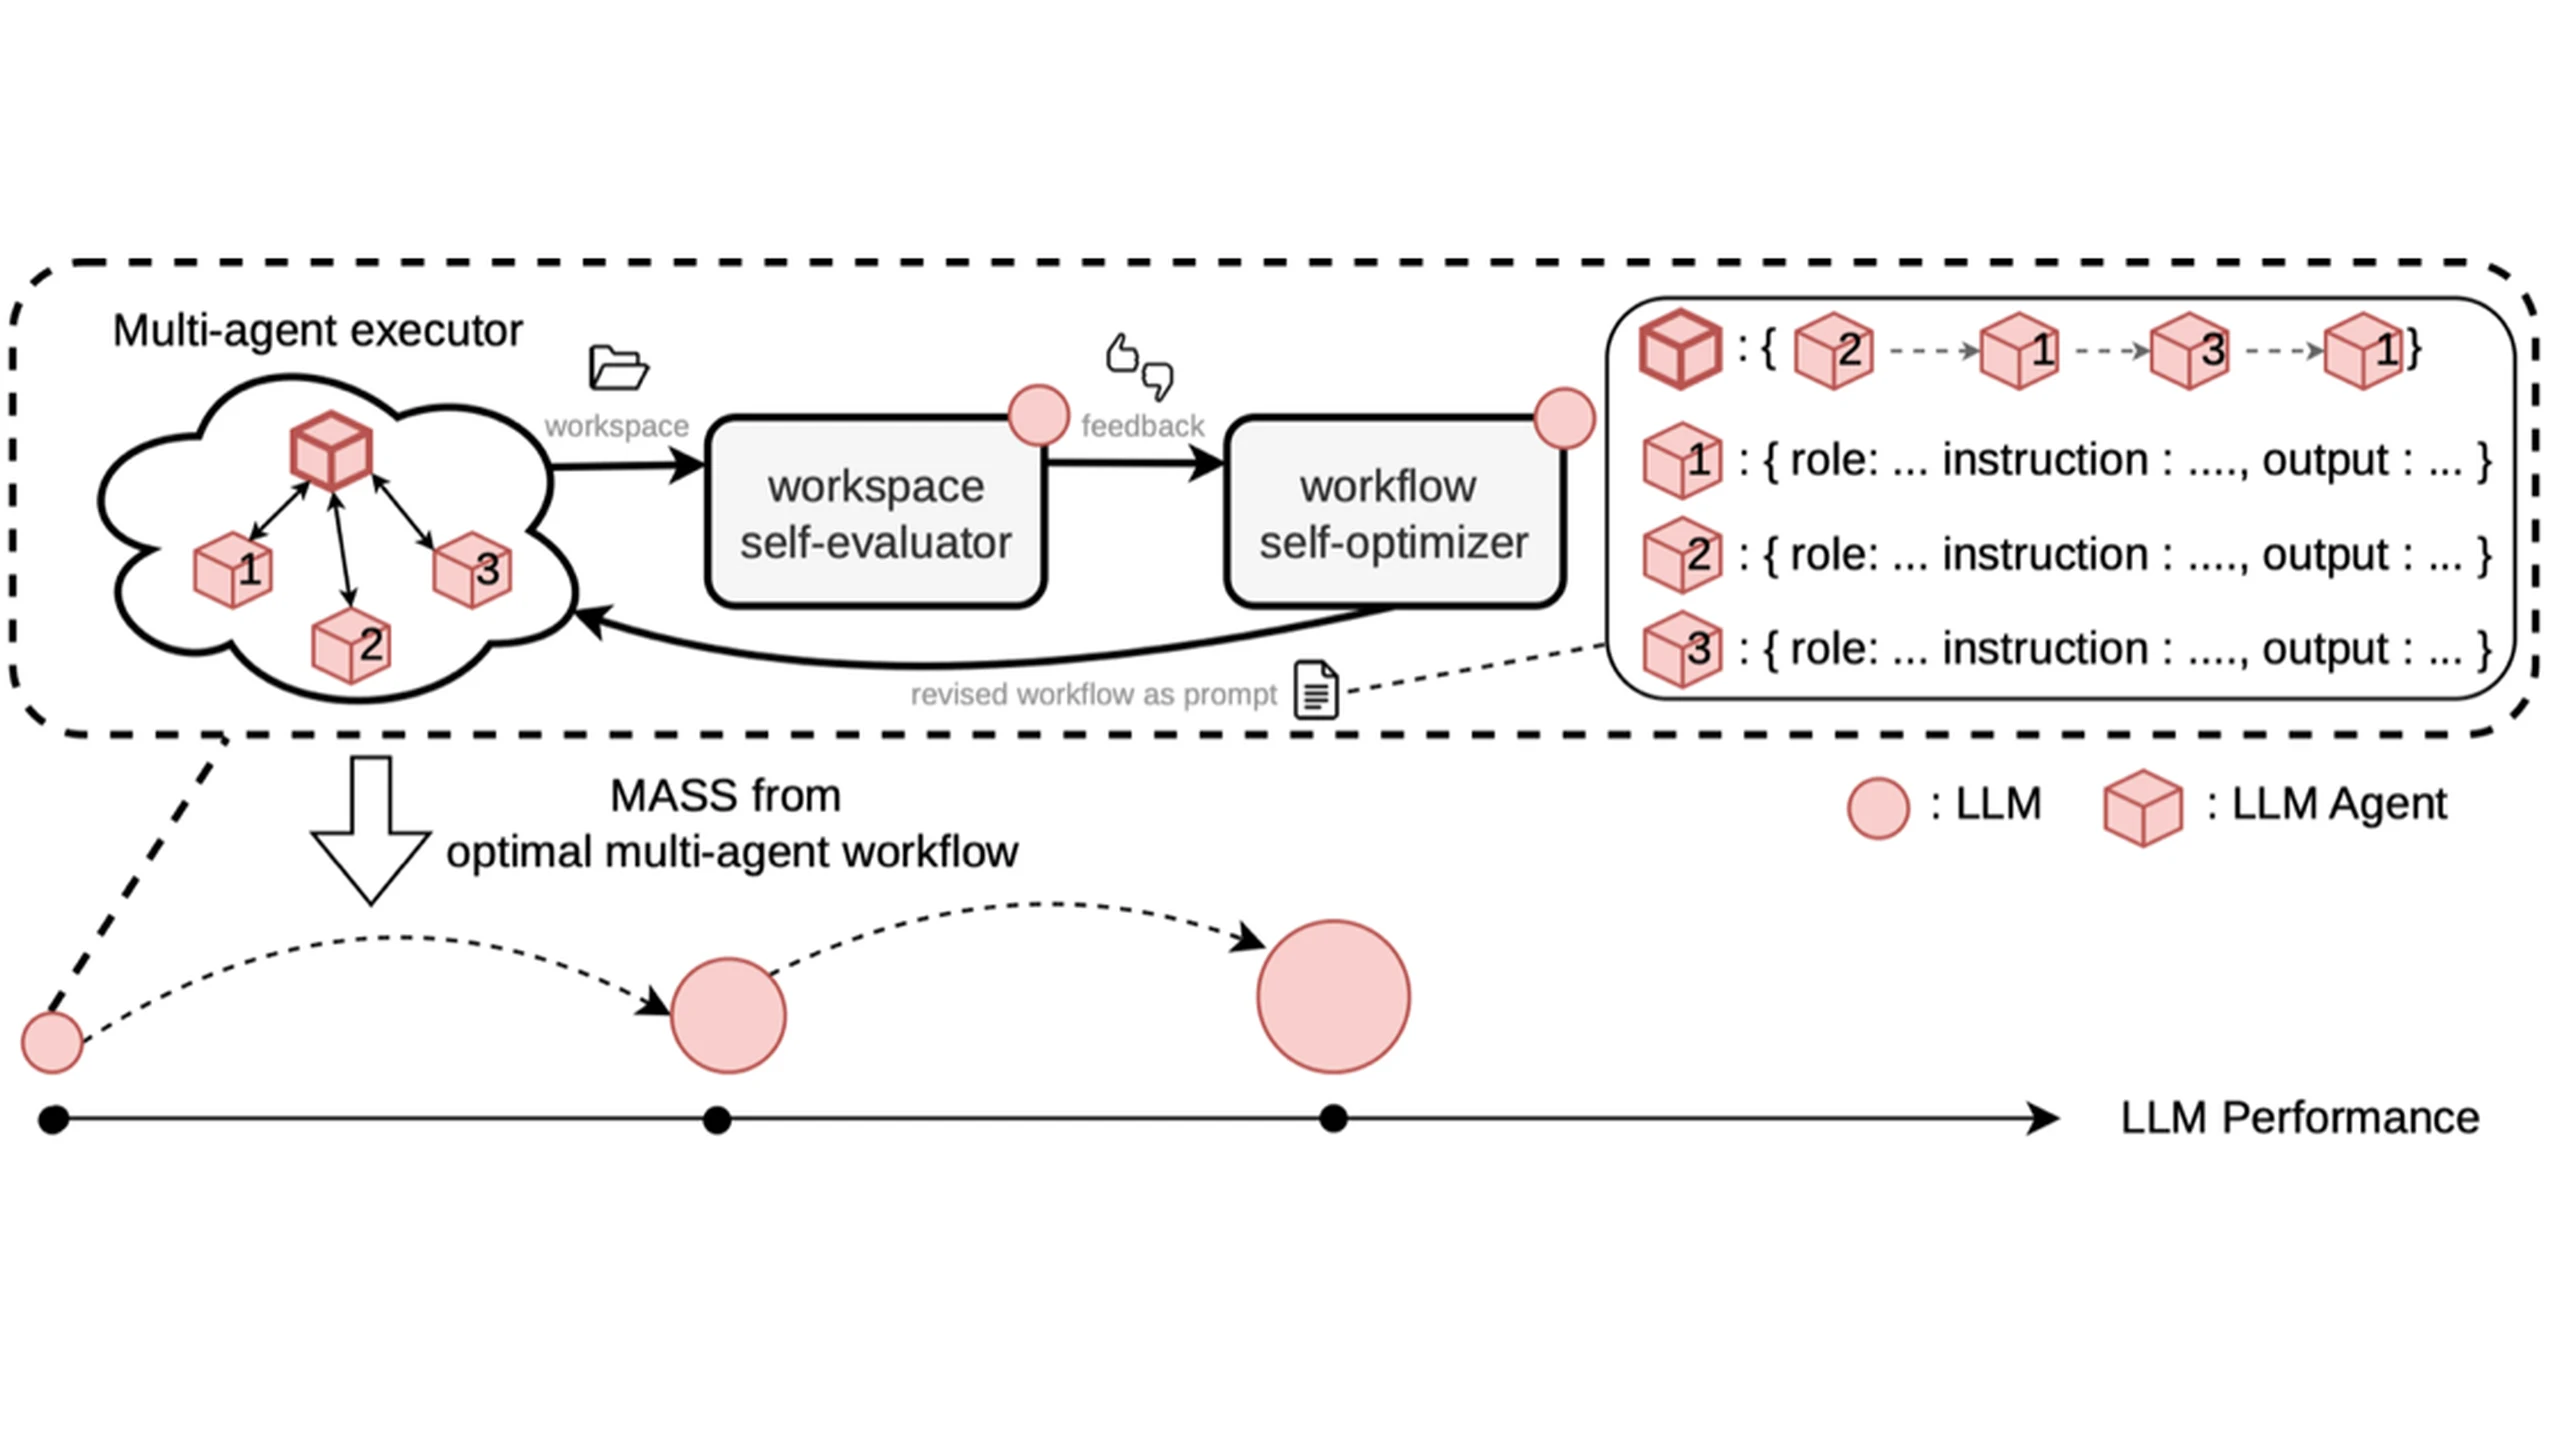
Sakana AI ha completato due cicli di Multi-Agent Self-Supervision, o MASS: copie dello stesso modello producono ricerche, le giudicano e trasformano le traiettorie selezionate in dati di addestramento per il successore comune. I miglioramenti riportati sono risultati sperimentali, ma disomogenei: avanzano i benchmark di ricerca, arretrano due prove di ingegneria del software. Si tratta di post-addestramento circoscritto, non della prova di un’esplosione autonoma dell’intelligenza.
L’articolo presentato l’8 ottobre 2026 e l’implementazione aperta includono prompt, configurazioni di addestramento, strumenti di valutazione e documentazione della pipeline. Rendono visibili anche i limiti dell’etichetta “ricorsivo”: soltanto due cicli completi, poche attività e un modello che può riprodurre lo stesso errore come esecutore, ottimizzatore e valutatore.
Dal lavoro del team all’aggiornamento del modello
Nell’inferenza multi-agente ordinaria più istanze si dividono un compito e riuniscono gli output senza modificare i pesi. MASS conserva invece messaggi, chiamate agli strumenti, prodotti intermedi e risultati come traiettorie di addestramento. Istanze separate svolgono lavori diversi, ma condividono il modello: non sono esperti addestrati indipendentemente.
Il ciclo interno mantiene fissi i pesi e cerca un workflow migliore definito tramite prompt. Il flusso specifica ruoli, istruzioni, contratti di output e passaggi di comunicazione. Ogni compito di addestramento ha un workflow campione. Un team candidato esegue il compito, il modello confronta il suo spazio di lavoro con quello del campione e l’ottimizzatore propone una revisione sulla base del giudizio.
Selezionato un workflow, MASS lo esegue 18 volte per compito. Confronti a coppie del modello ordinano gli spazi di lavoro; un modello Bradley–Terry converte le preferenze in punteggi. Vengono conservate fino a 16 traiettorie: 15 possono fornire esempi di addestramento, una serve alla validazione. Prima della messa a punto, il testo del workflow viene rimosso dal prompt iniziale dell’orchestratore, affinché deduca l’organizzazione dal compito anziché copiare il piano ricevuto.
Il ciclo esterno usa l’adattamento a basso rango, LoRA, per aggiornare un insieme limitato di parametri. Le conversazioni dell’orchestratore e dei sottoagenti sono entrambe obiettivi di addestramento. Il modello aggiornato torna poi nei tre ruoli. “Ricorsivo” è difendibile perché una generazione contribuisce ai dati della successiva. Gli esseri umani definiscono ancora architettura, attività, ottimizzazione, benchmark, infrastruttura e confini dei cicli.
Progressi nella ricerca e un netto limite al trasferimento
La base è Qwen3.6-27B in un ambiente per agenti di programmazione. La suite sintetica comprende 12 ricerche in finanza, robotica e farmacia, ciascuna con codice, analisi quantitativa e relazione. Nove erano destinate all’addestramento, ma otto hanno effettivamente prodotto dati. Tre, una per settore, sono state escluse da messa a punto, validazione e scelta dei checkpoint.
GPT-5.5 e Claude Opus 4.8 hanno giudicato dall’esterno gli spazi di lavoro completati, senza supervisionare il ciclo di addestramento. Nei tre compiti riservati, il modello del primo ciclo vince il 53,9% dei confronti con la base, quello del secondo il 69,9%. Il secondo batte il primo nel 60,8% dei casi. Sui compiti di addestramento, le vittorie contro la base sono rispettivamente 65,6% e 82,5%. Questi risultati più forti devono restare distinti dalle prove fuori addestramento.
Nei benchmark pubblici di ricerca, Sakana riporta punteggi per token di output pari a 1,2–1,6 volte la base dopo il secondo ciclo. MLR-Bench passa da 1,71 a 2,25, mentre la consegna di articoli sale dal 57% al 76%. ScienceAgentBench cresce dal 28,8% al 31,7%. AstaBench E2E-Hard passa da 0,053 a 0,067 e la consegna di rapporti dal 50% al 76%. DSBench cambia soltanto da 0,473 a 0,482: un migliore rapporto di efficienza non trasforma questa piccola variazione assoluta in un grande aumento del punteggio.
Il software segue la direzione opposta. Terminal-Bench 2.0 scende da 0,375 a 0,352 e SWE-bench Verified da 0,626 a 0,611. I rapporti per token sono 0,96 e 0,94 volte la base. Il modello non è quindi uniformemente più forte.
Una spiegazione plausibile è l’allineamento dei compiti: nell’addestramento prevalevano relazioni, prove quantitative e codice, non debug di repository o operazioni da terminale. Aggiungere attività software potrebbe aiutare, come suggerisce Sakana, ma non è ancora verificato e potrebbe interferire con capacità esistenti. I test di trasferimento devono controllare sia i nuovi settori sia il mantenimento dei precedenti.
I costi esclusi dai numeri di efficienza
In un confronto di addestramento, uno studente multi-agente raggiunge il 68,3% di vittorie con 28,8 milioni di token supervisionati. Il maggiore studente a singolo agente raggiunge il 64% con 42 milioni. È un risultato migliore con il 31% in meno di token supervisionati, non la dimostrazione di un taglio del 31% al costo totale di sviluppo.
Prima della selezione, i team generavano in media circa 2,4 volte più token. I giudici esterni preferivano i loro lavori nell’85,1% dei confronti con output individuali. Fra dieci coppie con tracce di lunghezza simile, i team vincevano ancora l’80%. Coordinamento e selezione sembrano quindi utili, ma il confronto non isola la delega: anche workflow e istruzioni di verifica erano diversi.
Il punteggio per token misura l’output produttivo, non l’intera pipeline. Ricerca dei flussi, esecuzioni ripetute, confronti, generazione dei dati e valutazioni consumano ulteriore calcolo. I totali supervisionati escludono token di input e vari costi a monte. MASS sostiene dunque la tesi di esempi selezionati più densi; l’efficienza complessiva richiede una contabilità più completa.
Contratti informativi, non semplici personaggi
La ricerca modifica ruoli, istruzioni, contratti e passaggi di comunicazione. Un contratto stabilisce quali prove o prodotti restituire; un passaggio definisce quando trasmettere informazioni o rinviarle a verifica. È più concreto che assegnare a varie copie i personaggi di ricercatore, critico o redattore.
In un esempio finanziario, gli agenti coprono preparazione dei dati, costruzione delle caratteristiche, modellazione, backtest, audit, riconciliazione e rapporto. L’agente dei dati deve dichiarare se informazioni future sono filtrate nelle decisioni storiche. Il requisito affronta un errore reale: un backtest eccellente può avere semplicemente usato dati allora indisponibili.
L’analisi testuale di Sakana trova una crescente concentrazione dell’informazione specifica del compito nei contratti e nell’ordine delle comunicazioni, anziché nei ruoli e nelle istruzioni generali. Il campione comprende solo otto o nove attività, secondo il confronto, e le stime di informazione mutua descrivono testi dei workflow, non ogni messaggio. È un indizio sul meccanismo, non una prova causale generale.
I precedenti studi sul dibattito multi-agente analizzavano miglioramenti tramite risposte e critiche scambiate. MASS trasferisce nei pesi i comportamenti collettivi selezionati: le tracce dell’orchestratore insegnano scomposizione e coordinamento, quelle dei sottoagenti compiti delimitati. Una base di conoscenza tecnica ricercabile mostra il valore organizzativo di prove e decisioni ispezionabili, ma non è una validazione indipendente di MASS.
Ottimizzatore e giudice condividono i limiti
Un modello in tre ruoli riduce la dipendenza da un insegnante sempre più forte, ma genera errori correlati. L’esecutore può fraintendere, il valutatore premiare il fraintendimento e il successore apprenderlo con maggiore sicurezza. Campionamento casuale e specializzazione creano variazione, non storie di addestramento indipendenti né giudizi sicuramente autonomi.
La presentazione del progetto Sakana identifica i punti ciechi comuni come problema di sicurezza. L’accordo fra giudici interni ed esterni sale dal 73% al 93% su tre generazioni. È un segnale incoraggiante per queste attività, non una prova di correttezza: i giudici possono condividere presupposti o preferire rapporti curati, ignorando errori che richiedono esperimenti reali.
La forza dell’ottimizzatore costituisce un altro vincolo. Mantenendo Qwen di base come esecutore, GPT-5.5 solo come valutatore porta miglioramenti limitati. Come valutatore e ottimizzatore trova workflow vincenti per tutte le 12 attività entro cinque iterazioni. Il ciclo omogeneo arriva a 11 su 12, ma richiede fino a 13 iterazioni. Una buona critica non basta se l’ottimizzatore non la converte in un processo migliore.
La ricerca è inoltre instabile: a iterazioni forti possono seguire brusche regressioni. Le critiche della comunità citate nel testo originale contestavano il termine ricorsivo e l’arresto dopo due cicli. La lettura prudente è ricerca iterativa di workflow e messa a punto supervisionata entro limiti umani, non riscrittura autonoma senza vincoli o prova di progresso indefinito.
La supervisione deve progredire con le capacità
La ricerca senza una regola automatica di successo è particolarmente vulnerabile all’autoconferma. Un rapporto coerente può contenere errori concettuali, omettere prove contrarie o implementare l’obiettivo sbagliato in codice funzionante. Il consenso dei modelli non decide da solo novità scientifica, strategia, valori o sicurezza.
La ricerca OpenAI sulla monitorabilità rileva che le tracce di ragionamento possono rivelare più di azioni e risposte finali, ma il monitoraggio resta incompleto e dipende da agente e controllore. Le ricche traiettorie MASS offrono opportunità di ispezione e nascondigli. Ottimizzare il ragionamento visibile può premiare spiegazioni convincenti senza correggere il comportamento.
Anche la discussione di Anthropic sull’auto-miglioramento ricorsivo sottolinea supervisione, validazione e verifica. Controlli indipendenti includono modelli esterni, esperti, test eseguibili, pipeline affidabili, valutazioni avversariali e validazione reale successiva. Nessuno copre ogni errore; più modelli concordi possono condividere la stessa distorsione.
Le prove decisive saranno altri cicli, trasferimento senza perdita delle capacità e recupero da un punto cieco comune introdotto appositamente. Non basta che giudici esterni scoprano un errore: il ciclo deve cambiare il workflow e non addestrarsi sulle tracce difettose. Per ora MASS dimostra l’utilità di apprendimento concentrato da team di ricerca delimitati e ricchi di prove. Non dimostra miglioramento ricorsivo illimitato e non giustifica eliminare il controllo umano dalle decisioni importanti.