
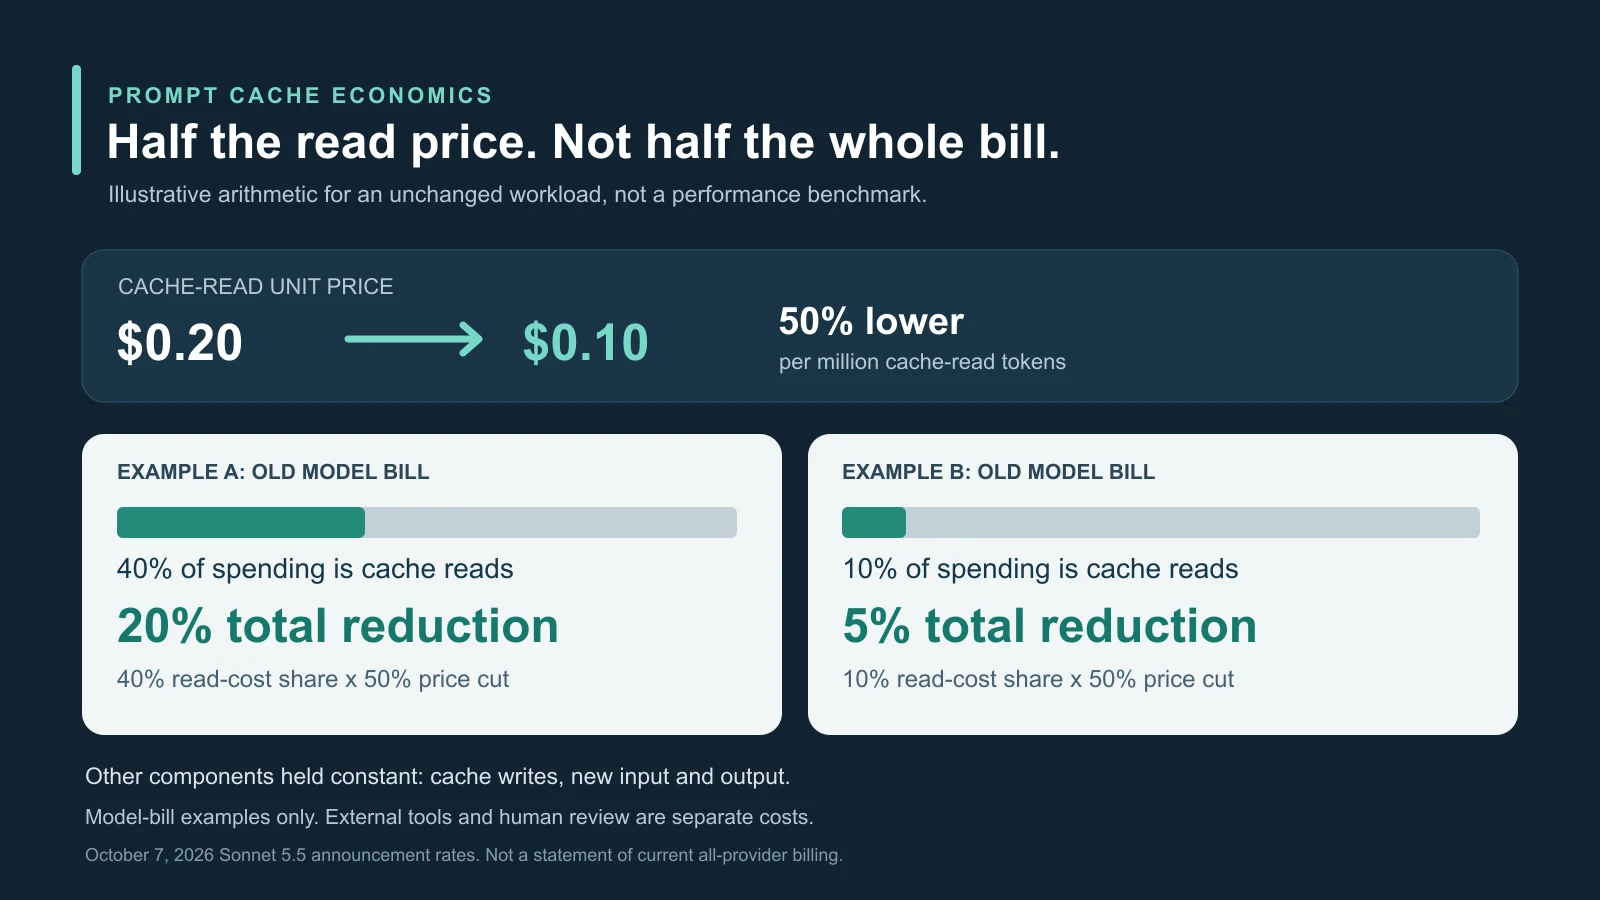
Entscheidend an Anthropics Preisankündigung ist nicht nur die Senkung um 50 Prozent. Es ist der Anteil, den Cache-Lesevorgänge an der bisherigen Agentenrechnung hatten. Eine halbierte Komponente kann lange Abläufe deutlich verbilligen, während kurze Gespräche oder ausgabelastige Aufgaben kaum profitieren.
Am 7. Oktober 2026 senkte Anthropic zusammen mit dem Start von Claude Haiku 5.5 die Cache-Lesegebühr für Sonnet 5.5 von 0,20 auf 0,10 Dollar je Million Tokens. Die meisten agentischen Arbeiten würden ungefähr 20 Prozent günstiger. Reguläre Eingabe und Ausgabe blieben unverändert. Ein konkreter Stückpreis und eine workloadabhängige Schätzung sind unterschiedliche Aussagen.
Was sich an der Preisliste geändert hat
Die bei der Ankündigung beschriebene Sonnet-Preisliste nennt 2 Dollar je Million Standard-Eingabetokens und 10 Dollar für Ausgabe. Ein Cache-Treffer kostet damit 5 statt 10 Prozent gewöhnlicher Eingabe. Generierte Ausgabe bleibt pro Token hundertmal so teuer wie der neue Cache-Lesepreis.
Das Erstellen des Caches kostet separat. Anthropic nennt 2,50 Dollar je Million für fünf Minuten und 4 Dollar für eine Stunde Speicherzeit. Beides liegt über normaler Eingabe, weil wiederverwendbare Inhalte zunächst gespeichert werden. Niedrige Lesepreise lohnen sich erst bei genügend Folgeaufrufen.
Coding-Agenten wiederholen Repository-Anweisungen, Tool-Schemas, Programmierregeln und ausgewählte Dateien. Recherche kann Richtlinienhandbücher oder Dokumentpakete, Support kann Produktkataloge und Eskalationsregeln wiederverwenden. Veränderte Nachrichten und Arbeitszustände müssen nicht den gesamten stabilen Präfix ersetzen.
Im vereinfachten Ausgangsbeispiel ergeben 100.000 stabile Tokens über 100 Anfragen ohne Caching zehn Millionen normale Eingabetokens. Bei wirksamer Wiederverwendung schreibt die erste Anfrage den Präfix, spätere lesen den Großteil. Halbiert werden diese Lesevorgänge, nicht Schreiben, neue Eingaben, Ausgaben oder andere Abläufe.
Die Änderung folgte weniger als zwei Wochen auf den Sonnet-5.5-Start am 28. September. Damals kosteten Lesevorgänge 0,20 Dollar; Anthropic betonte bereits weniger Tokens als Sonnet 5, bis zu 30 Prozent niedrigere Aufgabenkosten und über 30 Prozent schnellere Ausgabe. Das sind Unternehmensangaben für bestimmte Arbeiten und Konfigurationen, keine garantierten Rabatte für jede Anfrage.
Der Schritt verstärkt damit die Betrachtung ganzer Aufgaben: Dauerhafte Agenten bezahlen wiederholt für ihren Betriebskontext statt nur für eine isolierte Chatantwort. Ob diese Wiederholung sinnvoll organisiert ist, bleibt eine eigene Frage.
Die Rechnung hinter ungefähr 20 Prozent
Entfielen zuvor 40 Prozent der Modellrechnung auf Cache-Lesen, senkt eine Halbierung die Gesamtsumme um 20 Prozent. Bei nur 10 Prozent Leseanteil sinken die Modellkosten um 5 Prozent. Das illustriert Beziehungen und misst keinen bestimmten Kunden.
Anthropic hat die detaillierte Kundenverteilung hinter „den meisten agentischen Arbeiten“ nicht veröffentlicht. Coding, Recherche, Browser und Support haben unterschiedliche Tokenprofile. Rund 20 Prozent sind deshalb als modellierter oder beobachteter Unternehmensmix zu verstehen, nicht als automatische Senkung aller Betriebskosten.
Ein Cache-Treffer braucht passende, zulässige Inhalte innerhalb seiner Laufzeit. Er ist kein dauerhaftes Modellgedächtnis. Ähnlicher Text ist nicht zwingend derselbe Präfix: frühe Anweisungen, Zeitstempel, Tool-Definitionen oder die Reihenfolge abgerufener Dokumente können Wiederverwendung unterbrechen.
Die Prompt-Anordnung zählt deshalb. Anthropic empfiehlt statische Anweisungen und Tools am Anfang und häufig wechselnde Inhalte später. Ein hundertfach verwendeter Präfix kann den Schreibaufschlag ausgleichen; ein einmaliger erzielt keine späteren Leseeinsparungen.
Ablaufzeiten schaffen einen weiteren Kompromiss. Fünf Minuten passen zu dichten Schleifen, können aber während langer Freigaben verstreichen. Die teurere Stunde kann insgesamt günstiger sein, wenn sie genügend Neuschreibvorgänge verhindert. Der einzelne Schreibpreis entscheidet nicht allein.
Getrennte Erstellungs- und Lesezähler helfen bei der Erklärung schwacher Ergebnisse. Ein niedriges Lese-Schreib-Verhältnis kann kurze Laufzeiten, veränderte Präfixe, Modellrouting oder nie erneut genutztes Material anzeigen. Nur theoretische Prompt-Größen zu optimieren verwechselt mögliche mit tatsächlich abgerechneter Wiederverwendung.
Kontextauswahl bleibt unabhängig davon wichtig. Eine durchsuchbare technische Wissensbasis wie ein Agent benötigen relevante, geordnete Informationen. Irrelevanten Kontext zu cachen verbilligt seine Wiederholung, macht ihn aber nicht hilfreich. Unklarheiten können weiterhin zusätzliche Ausgabe und Korrekturen verursachen.
Gleiche Listenpreise schaffen keine gleichen Aufgaben
Der Ausgangsvergleich nennt zum Ankündigungszeitpunkt für Sonnet 5.5 und OpenAIs GPT-6.1 Sol dieselben 2 Dollar Standardinput, 0,10 Dollar Cache-Input und 10 Dollar Ausgabe je Million Tokens. Der zuvor sichtbare zweifache Unterschied beim Cache-Input verschwindet.
Der ursprüngliche Vergleich nennt für beide außerdem 2,50 Dollar Schreiben für die Grundlaufzeit. Das ist die dortige Tabellenangabe, kein Beleg identischer Cache-Erstellungsabrechnung oder Implementierung. Endpunktspezifische Schreibregeln und Eignung dürfen nicht aus nebeneinanderstehenden Zahlen abgeleitet werden.
Der Ausgangsbericht beschreibt die GPT-6.1-Sol-Dokumentation mit 1,05 Millionen Kontexttokens und mehreren Reasoning-Einstellungen sowie expliziten oder impliziten Cache-Grenzen, Mindestlängen und Nutzungsberichten. Anthropic verwendet eigene Kontrollen, Laufzeiten, Grenzen und Zähler. Gleiche Lesepreise sichern keine gleichen Trefferquoten nach einer Migration.
Eine Aufgabe kann bei einem Modell acht, beim anderen 15 Aufrufe brauchen. Mehr Reasoning-Ausgabe, zusätzliche Tools oder wiederholte Fehlpatches verändern die Rechnung. Das sind Beispiele, keine gemessenen direkten Vergleiche.
Anthropic berichtet 70,6 Prozent bei Terminal-Bench 4.0 für mehrstufige professionelle Kommandozeilenaufgaben und nennt weniger Tokens sowie über 30 Prozent höhere Geschwindigkeit als Sonnet 5. Einstellungen, Harness, Prompts und Tools beeinflussen Ergebnisse; Produktionsaufgaben können anders verteilt sein.
OpenAIs Einführung beschreibt ebenfalls einen Effizienzanspruch: GPT-6.1 Sol nähere sich GPT-6 Astra bei niedrigeren Standardpreisen. Eine Forschungsumgebung garantiert kein identisches API-Verhalten. Keine Benchmark-Suite bestimmt einen universellen Sieger.
Weniger sequenzielle Schritte verkürzen Wartezeit und geben Rechenkapazität frei, was interaktiv wichtiger als kleine Preisunterschiede sein kann. Ein günstiger Erstversuch ist aber nicht wirtschaftlich, wenn Menschen Fehler finden, beschädigte Arbeit wiederherstellen und neu starten müssen. Relevant ist das akzeptierte Ergebnis.
Unveränderte Kosten können den Rabatt überwiegen
Neue Eingabe, Ausgabe und Cache-Schreiben fallen nicht unter diese Senkung. Lange Denkverläufe, ausführliche Erklärungen und wiederholte Korrekturen können Modellkosten dominieren, weil Ausgabe viel teurer als Cache-Kontext ist.
Die Orchestrierung umfasst zusätzlich Suche, Browser, Datenbanken, Code-Ausführung und fremde APIs mit eigenen Gebühren. Menschliche Prüfung zählt gerade bei Softwareänderungen, regulierten Abläufen und Kundendaten. Eine günstigere Modellkomponente senkt diese Preise nicht und beseitigt keine Fehlerfolgen.
Routing schafft weitere Verschwendung. Laut Anthropic bleibt Opus 5.5 bei komplexen offenen Aufgaben mit anhaltendem Urteilsbedarf stärker. Routinearbeit zu Sonnet und schwierige Entscheidungen zu einem größeren Modell zu schicken kann helfen; wiederholte Fehlversuche vor Eskalation können aber die Cache-Ersparnis übersteigen.
Der gesamte Pfad muss deshalb Fehlversuche und Eskalationsaufrufe enthalten, nicht nur die erfolgreiche letzte Antwort. Ein Router kann pro Anfrage günstig und pro akzeptierter Aufgabe teuer sein.
Auch die Verteilung erlaubt keine universelle Rechnung. Sonnet läuft über Anthropic und Partner mit möglicherweise unterschiedlichen Preisen, Regionen und Funktionszeitpunkten. Die angekündigten 0,10 Dollar müssen am Produktionsendpunkt tatsächlich erscheinen; gleichzeitige Änderungen aller Marketplace-Regionen sind nicht anzunehmen.
Günstiger Cache macht auch nicht jede Migration sinnvoll. Anbieterspezifische Struktur, Laufzeit, Eignung und Berichte können App-Änderungen erfordern, bevor Trefferquoten vergleichbar sind. Qualität und Portabilität bleiben Beschaffungskriterien.
Von günstigeren Komponenten zu günstigeren Ergebnissen
Nützliche Belege verbinden Wochen an Lese-Tokens, Erstellungsfrequenz, ungecachter Eingabe, Ausgabe, Tool-Aufrufen, Latenz, Wiederholungen und Eskalationen mit Abschluss und menschlicher Akzeptanz. Modellkosten sind von externen Diensten und Arbeit zu unterscheiden.
Ein repräsentativer Vergleich braucht dieselben internen Aufgaben, Kontextpakete, Tools, Reasoning-Einstellungen, Wiederholungsregeln und Abnahmekriterien. Zusätzliche Fähigkeiten oder großzügigere Budgets für ein Modell verzerren die Wirtschaftlichkeit. Unabhängige Bewertungen sollten diese Bedingungen offenlegen, nicht Tokenpreise als Aufgabenkosten ausgeben.
Die nächsten Signale sind reale Endpunktrechnungen, Partnerübernahme und unabhängige Aufgabentests. Weitere Preissenkungen könnten günstige Wiederverwendung zur Basis machen; ausbleibende Reaktionen könnten Differenzierung durch Qualität, Infrastruktur oder Cache-Design anzeigen. Das sind Möglichkeiten, keine bereits feststehenden Folgen.
Anthropic hat eine wiederkehrende Gebühr reduziert, die für lange stabile Agentenpräfixe relevant ist. Die breitere Ersparnis bleibt bedingt. Fallen Cache-Kosten, aber nicht Kosten je akzeptiertem Ergebnis, liegt das Teure womöglich bei Ausgabe, wiederholtem Scheitern, externen Tools oder menschlicher Korrektur – nicht beim gerade verbilligten Kontext.
Quellen und weiterführende Informationen
Ursprüngliche Claude-Ankündigung; Haiku-Start und Cache-Preisankündigung; Sonnet-5.5-Start; Weiterführendes zu technischen Wissensbasen; Anthropic Prompt-Caching; GPT-6.1-Sol-Dokumentation; OpenAI-Einführung; OpenAI-Cache-Leitfaden.