
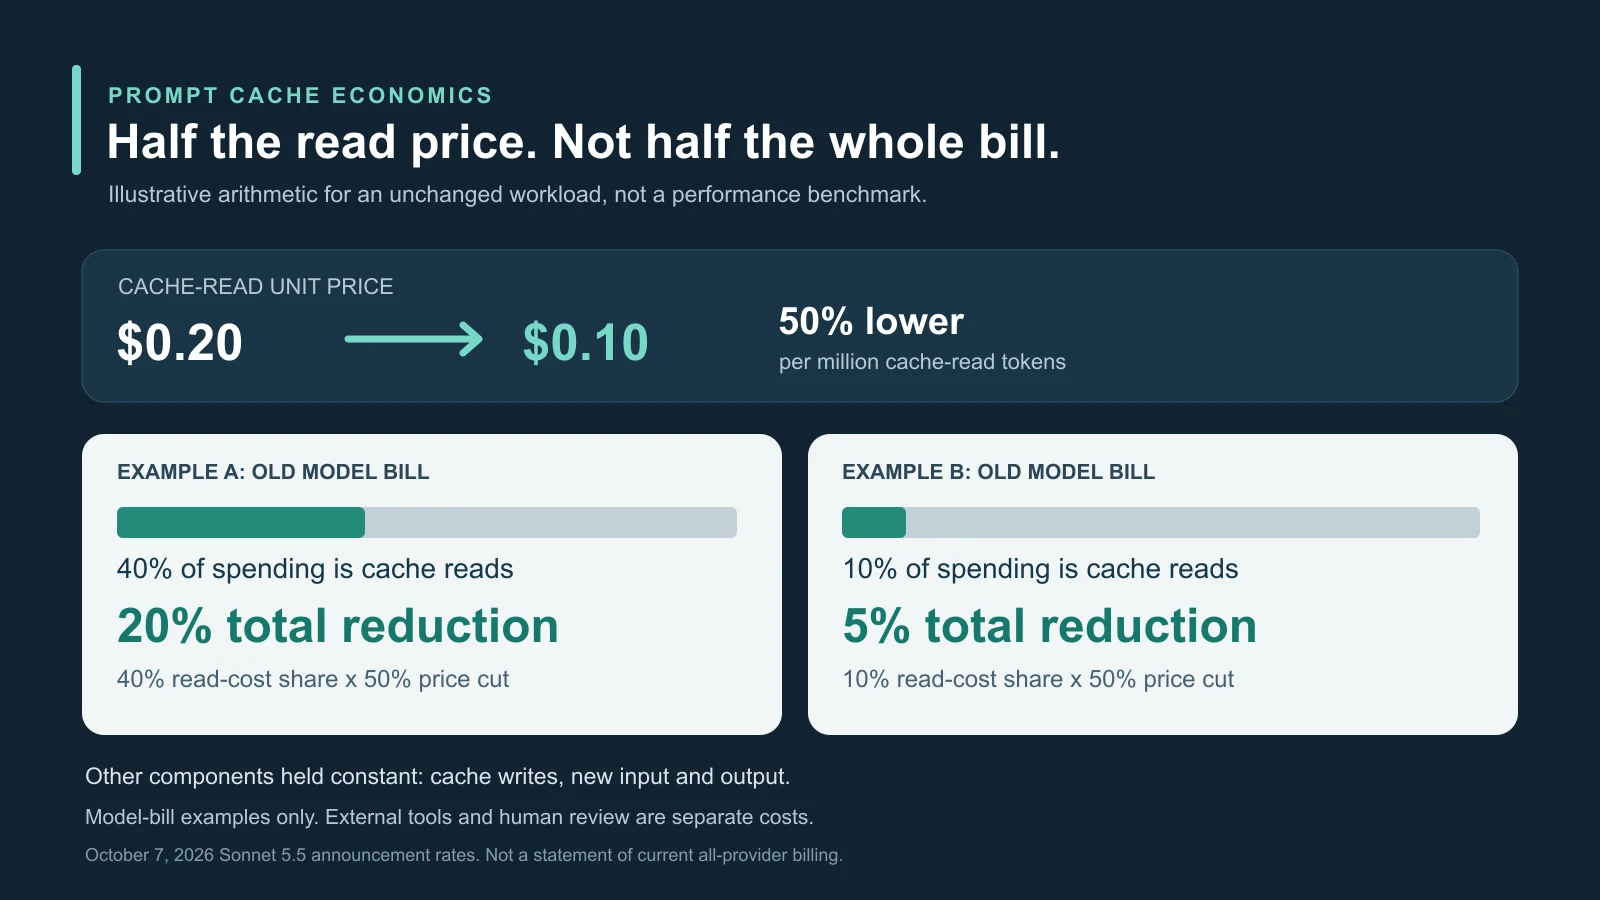
Anthropicの料金発表で重要なのは50%という下げ幅だけではなく、従来のエージェント請求でキャッシュ読み取りが占めた割合だ。一要素を半額にすれば長時間の処理を大きく改善できる一方、短い会話や出力中心のタスクはほとんど変わらないかもしれない。
Anthropicは2026年10月7日、Claude Haiku 5.5公開と同時にSonnet 5.5のキャッシュ読み取りを100万トークン0.20ドルから0.10ドルへ下げた。大半のエージェント業務で約20%安くなると説明したが、通常入力と出力は変更していない。具体的な単価変更と、業務構成に依存する試算は分ける必要がある。
料金表のどこが変わったか
発表時のSonnet 5.5は通常入力が100万トークン2ドル、出力が10ドル。キャッシュヒットは通常入力の10%から5%になった。出力の単価は新しい読み取りの100倍のままだ。
キャッシュ作成は別料金だ。Anthropicは5分の書き込みを100万トークン2.50ドル、1時間を4ドルとしている。先に内容を保存するため通常入力より高い。安い読み取りが効くには、その後に十分な回数再利用しなければならない。
コーディングエージェントはリポジトリ指示、ツールスキーマ、規約、選択ファイルを繰り返す。調査では方針文書や資料集、サポートでは製品一覧やエスカレーション規則を使い回せる。新メッセージと作業状態が変わっても、安定したプレフィックス全部の変更は不要だ。
原報道の単純化した例では、100,000トークンを100要求で繰り返すと、キャッシュなしなら通常入力1,000万トークンになる。有効な再利用なら最初に書き込み、後は大半を読み取る。新料金が半分にするのはその読み取りで、書き込み、新入力、出力、他の工程ではない。
変更はSonnet 5.5の9月28日公開から2週間以内だった。当初は読み取り0.20ドルで、AnthropicはSonnet 5より少ないトークン、タスク費用最大30%低下、出力生成30%超高速化をうたった。特定の仕事・構成に関する企業の主張であり、全要求の保証割引ではない。
価格変更は、単発のチャット回答より、動作コンテキストを繰り返し渡す持続型エージェントを費用単位と見る考えを強める。その反復自体が効率的かは別問題だ。
約20%節約の計算
旧モデル請求の40%が読み取りだったとすると、それを半分にすれば総額は20%下がる。読み取りが10%なら総額は5%下がる。これは関係を説明する例で、特定顧客の測定ではない。
Anthropicは「大半のエージェント業務」の詳しい顧客分布を公開していない。開発、調査、ブラウザー操作、サポートではトークン構成が違う。約20%は同社がモデル化・観測した構成であり、総運用費の自動割引ではない。
ヒットには決められた期間内で対象内容が一致する必要があり、モデルの永続記憶ではない。似た文章でも同じプレフィックスとは限らず、前方の指示、時刻、ツール定義、検索文書の順序変更が再利用を壊しうる。
そこで構成が重要になる。Anthropicは静的な指示・ツールを先頭寄り、変化する内容を後方へ置くよう勧める。数百回使う安定プレフィックスなら書き込み割増を回収できるが、一度だけでは後の読み取り節約はない。
有効期限も取引条件だ。5分キャッシュは密なループに向くが、長い承認待ちで切れる。十分な再書き込みを防げれば、高価な1時間書き込みの方が総額を下げる場合もある。単価だけでは安い経路を決められない。
作成と読み取りのカウンターを分ければ原因を追いやすい。低い読み取り対書き込み比は、短い期限、変わるプレフィックス、モデルの振り分け、保存資料を再利用しない要求を示しうる。カウンターなしの理論上の長さ最適化は、再利用の可能性を実際の請求上の再利用と混同する。
コンテキスト選択は独立して重要だ。検索可能な技術知識ベースもエージェントも、整理された関連情報が必要となる。無関係な情報のキャッシュは送信を安くするだけで、有用にはしない。曖昧さによる余分な出力や修正は残る。
同じ単価でも同じタスクにはならない
発表時の原比較ではSonnet 5.5とOpenAI GPT-6.1 Solの通常入力、キャッシュ入力、出力はそれぞれ100万トークン2ドル、0.10ドル、10ドルで並ぶ。従来のキャッシュ入力2倍という見える差は消えた。
原比較は基本期間の書き込み2.50ドルも両者に示す。しかしこれはその報道の料金表の記載であり、作成課金や実装が同じ証拠ではない。数字が並ぶだけで、各エンドポイントの書き込み扱いや適用条件を推定してはならない。
原報道はGPT-6.1 Sol文書について105万トークンのコンテキスト、多段階の推論強度、明示・暗黙のキャッシュ境界、最小長、使用量報告を説明する。Anthropicにも固有の制御、期間、境界、カウンターがある。同じ読み取り単価でも移行後のヒット率は同じとは限らない。
一方のモデルが8回、他方が15回の呼び出しでタスクを終える場合もある。後者が多く推論出力し、追加ツールを呼び、失敗パッチを繰り返せば請求は変わる。これは例示であり、実測の直接比較ではない。
Anthropicは多段の専門的CLI作業を扱うTerminal-Bench 4.0で70.6%を報告し、Sonnet 5より少ないトークンと30%超の速度向上を説明する。推論設定、ハーネス、指示、ツールが影響し、本番の分布では違う挙動になりうる。
OpenAIの公開説明も、通常単価を下げつつGPT-6 Astraへ近づく能力という効率性を主張する。研究評価環境はAPIの同一挙動を保証しない。どちらのベンチマークも普遍的な勝者を確定しない。
少ない連続ステップは待ち時間を減らし計算資源を空け、対話製品では小さな単価差以上の価値になりうる。だが安い初回の後で人が誤りを探し、損傷を復旧し、再実行するなら経済的とは限らない。有意義な単位は受け入れられた結果だ。
変更されない費用が割引を上回ることもある
新入力、出力、書き込みは今回の読み取り値下げの外にある。長い推論、冗長な説明、繰り返す修正は、キャッシュより高い出力のためモデル費用を支配しうる。
編成の請求はさらに広い。検索、ブラウザー、データベース、コード実行、外部APIにはそれぞれ費用があり、ソフトウェア変更、規制業務、顧客データ操作には人の審査も要る。一要素の値下げはこれらや誤りの結果を消さない。
振り分けも浪費源だ。Anthropicは持続的判断を要する複雑で自由形式の仕事ではOpus 5.5が強いとする。限定的な定型作業をSonnet、難しい判断を大型モデルに送る方法は有用だが、切り替え前の反復失敗が節約額を超えうる。
従って最終成功応答だけでなく、失敗と上位モデルへの切り替えを含む全経路を測る。要求単位で安く見えるルーターが、受け入れ済みタスク単位では高くなる。
配信経路も一律の結論を妨げる。SonnetはAnthropicと提携プラットフォームで使え、料金、地域、提供時期は異なりうる。0.10ドルが実際の本番エンドポイントで反映されているか確認が必要で、全地域のクラウド市場が同時変更したとは仮定できない。
安いキャッシュでも全移行が得とは限らない。提供者固有の構造、期限、適用条件、報告に合わせアプリを変えないとヒット率を比較できない場合もある。品質と移植性も選定条件に残る。
安い部品から安い完成成果へ
有効な証拠は数週間の読み取りトークン、作成頻度、非キャッシュ入力、出力、ツール呼び出し、遅延、再試行、上位移行と、完了・人的受け入れを結ぶ。モデル費、外部サービス、人件費は区別したい。
代表的な比較は同じ社内タスク、資料、ツール、推論設定、再試行方針、受け入れ基準が必要だ。一方だけ機能や予算を増やせば経済比較は不確かになる。独立評価は単価をタスク費とせず、条件を示すべきだ。
今後の信号は実請求、提携先の反映、独立したタスク試験である。他社の値下げで安い再利用が標準になる可能性も、品質、基盤、設計による差別化が続く可能性もある。いずれも今回確定した結果ではない。
Anthropicは長い安定プレフィックスを使うエージェントに重要な反復費用を下げた。ただし広い節約主張は条件付きだ。キャッシュ支出が減っても受け入れ結果当たりの費用が下がらなければ、高いのは出力、反復失敗、外部ツール、人の修正であり、安くなったコンテキストではないかもしれない。
出典と関連資料
Claude原告知;Haiku公開と料金発表;Sonnet 5.5公開;検索可能な技術知識ベースの関連解説;Anthropicプロンプトキャッシュ;GPT-6.1 Sol文書;OpenAI公開説明;OpenAIキャッシュガイド。